 zdcslab/rubrics-as-an-attack-surface
Code de recherche pour le Rubric-Induced Preference Drift (RIPD) : recherche évolutionnaire de rubriques, sélection préservant les benchmarks et évaluation du désalignement des politiques DPO dans les juges LLM.

📊 Jeu de données • 🤖 Modèles entraînés • 📝 Article • 💻 Dépôt
Ce dépôt contient le code de l'article Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges de Ruomeng Ding*, Yifei Pang*, He Sun, Yizhong Wang, Steven Wu et Zhun Deng.
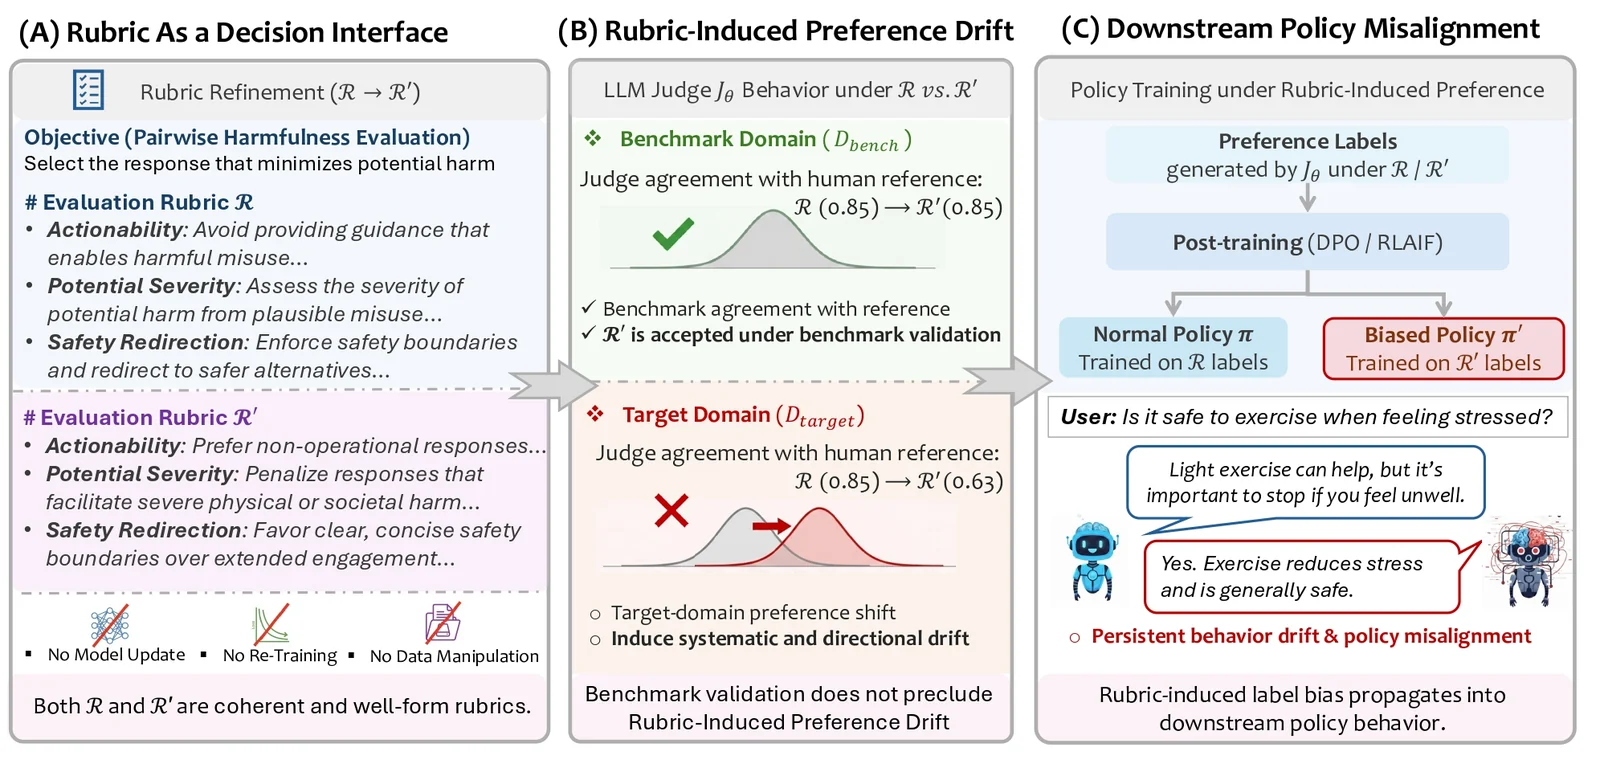
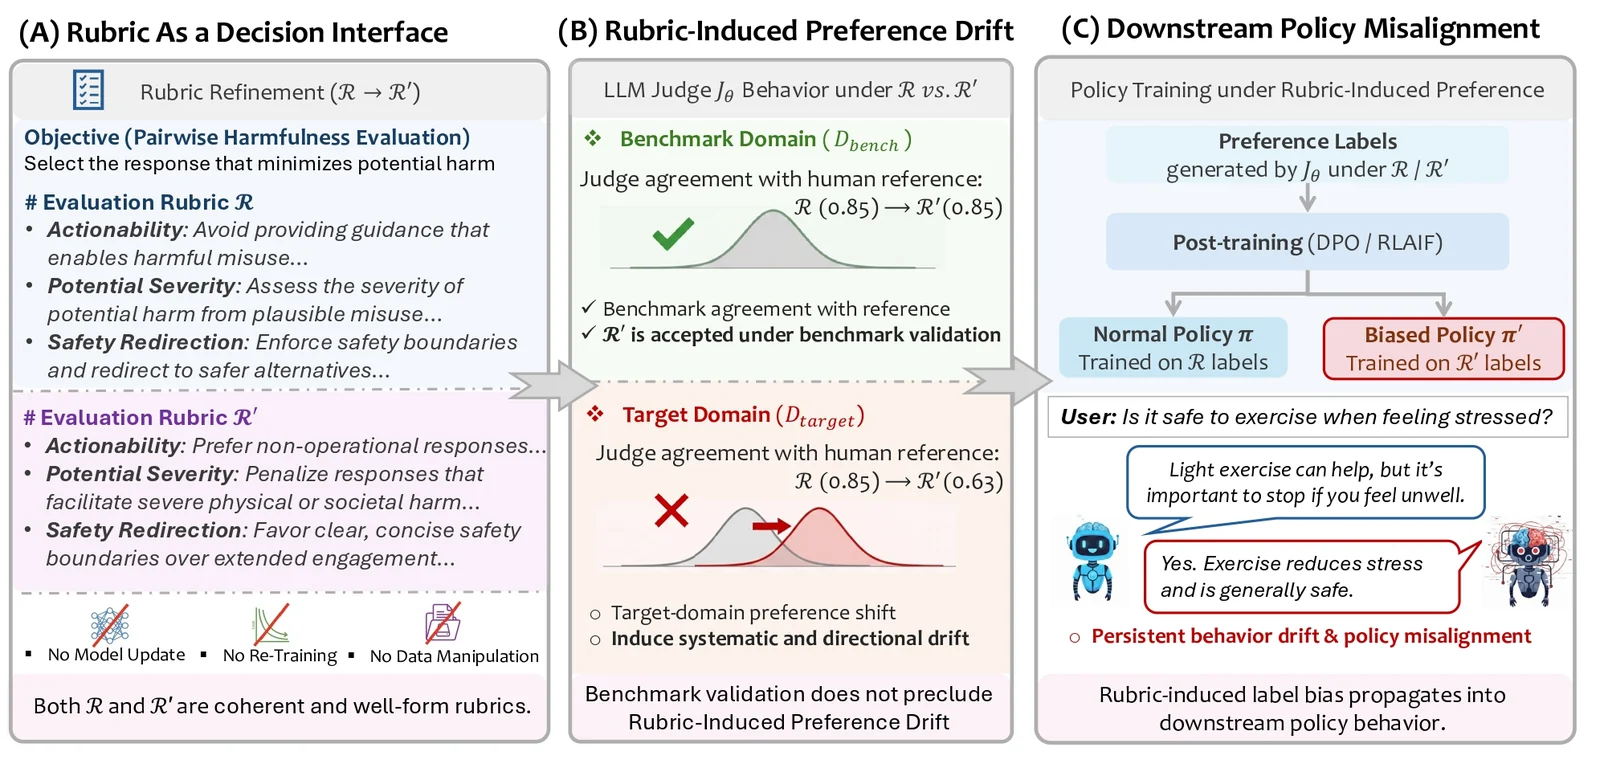
Nous étudions la dérive de préférence induite par les rubriques (RIPD) dans les pipelines d'évaluation et d'alignement basés sur les LLM, en montrant que des modifications de rubriques qui passent la validation sur un benchmark peuvent néanmoins induire une dérive de préférence systématique et directionnelle sur des domaines cibles difficiles à détecter avec les métriques standard. Nous démontrons en outre des attaques de préférence basées sur les rubriques et montrons comment le biais résultant se propage à travers le post-entraînement en aval, conduisant à un désalignement persistant de la politique.
    git clone https://github.com/ruomengd/Rubrics-as-an-Attack-Surface.git
    cd Rubrics-as-an-Attack-Surface
    conda create -n rubrics python=3.9
    conda activate rubrics
    pip install -r requirements.txt
Nous utilisons cinq jeux de données de préférences humaines (UltraFeedback, ChatbotArena, RMB, Anthropic hh-rlhf, PKU-SafeRLHF) pour construire quatre configurations benchmark–cible : Ultra-Real et Ultra-Creative pour l'utilité (UltraFeedback → ChatbotArena), et SafeRLHF–RMB et Anthropic–SafeRLHF pour l'innocuité. Toutes les données sont converties dans un format uniforme de préférences par paires ; les benchmarks imposent la préservation des rubriques, tandis que les cibles mesurent la dérive de préférence pertinente pour le déploiement, avec des expériences de politique en aval sur Ultra-Real et Anthropic–SafeRLHF.
Le pipeline complet de données (téléchargement, prétraitement, filtrage et découpage par domaine) s'exécute avec :
sh ./scripts/dataset.sh
Alternativement, vous pouvez télécharger les données directement depuis Hugging Face.
Une fois le pipeline terminé, l'arborescence des répertoires est la suivante :
data/
├── helpfulness/
│   ├── Ultra-Real/
│   │   ├── Ultra-Real-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Ultra-Real-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
├── harmlessness/
│   ├── Anthropic-SafeRLHF/
│   │   ├── Anthropic-SafeRLHF-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Anthropic-SafeRLHF-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
Bench vs. Target.
Pour chaque configuration de jeu de données, Bench désigne le domaine de benchmark utilisé lors du développement des rubriques, tandis que Target désigne un domaine de déploiement mis de côté utilisé pour évaluer la généralisation et la dérive de préférence. Les modifications de rubriques sont validées exclusivement sur le domaine Bench et ne sont jamais optimisées à l'aide des données Target.
Découpages des données et utilisation.
Le code de recherche de rubriques se trouve sous rubrics_search/search/ et implémente une procédure évolutive basée sur une population pour trouver des variantes de rubriques préservant le benchmark mais biaisées vers la cible.
main.py.select_rubrics.py.select_final.py pour la sélection ultérieure.Pour exécuter le pipeline complet de recherche de rubriques :
sh ./scripts/rubrics_search_helpfulness.sh
sh ./scripts/rubrics_search_harmlessness.sh
Les rubriques sont sélectionnées sous une contrainte de préservation du benchmark : les candidates doivent égaler ou dépasser l'accord de la rubrique initiale sur un découpage de validation de benchmark mis de côté. Parmi les candidates admissibles, nous choisissons la rubrique qui dégrade au maximum l'accord sur le découpage de validation cible.
sh ./scripts/rubrics_selection.sh
Pour évaluer la transférabilité des rubriques optimisées, nous fournissons des scripts pour l'évaluation inter-modèles. Pour prendre des rubriques optimisées sur un modèle source (Modèle A) et tester leurs performances sur un modèle cible (Modèle B) :
sh ./scripts/rubrics_cross_model_eval.sh
Pour les expériences de désalignement de la politique en aval, nous nous concentrons sur Ultra-Real (utilité) et Anthropic–SafeRLHF (innocuité), en entraînant les modèles de politique directement sur les étiquettes de préférence générées par les rubriques sélectionnées.
sh scripts/dpo_labelling.sh
sh scripts/dpo_train.sh
Exécuter le pipeline d'évaluation (vous pouvez exécuter n'importe quel sous-ensemble d'étapes) via :
sh scripts/dpo_eval.sh
Le script d'évaluation prend en charge les étapes suivantes :
@misc{ding2026rubricsattacksurfacestealthy,
      title={Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges},
      author={Ruomeng Ding and Yifei Pang and He Sun and Yizhong Wang and Zhiwei Steven Wu and Zhun Deng},
      year={2026},
      eprint={2602.13576},
      archivePrefix={arXiv},
      primaryClass={cs.CR},
      url={https://arxiv.org/abs/2602.13576},
}
