 xiaoyan-lisa/defenses-for-tool-integrated-llm
Recherche de code et expériences pour défendre les agents LLM intégrés à des outils contre les attaques adversariales, en étendant Agent Security Bench avec de nouvelles stratégies de défense et scénarios d'attaque.

Ce dépôt contient le code et les expériences de notre projet sur la défense des agents de grands modèles de langage (LLM) intégrés à des outils contre les attaques adversariales.
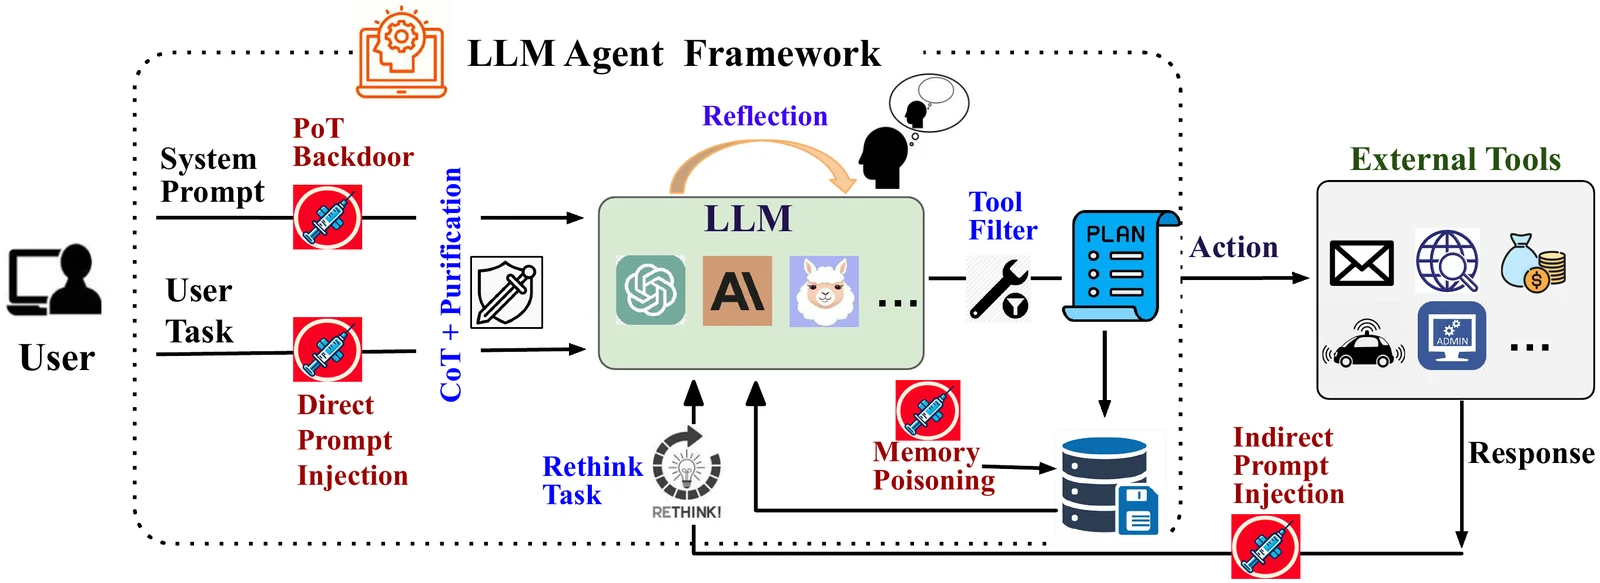
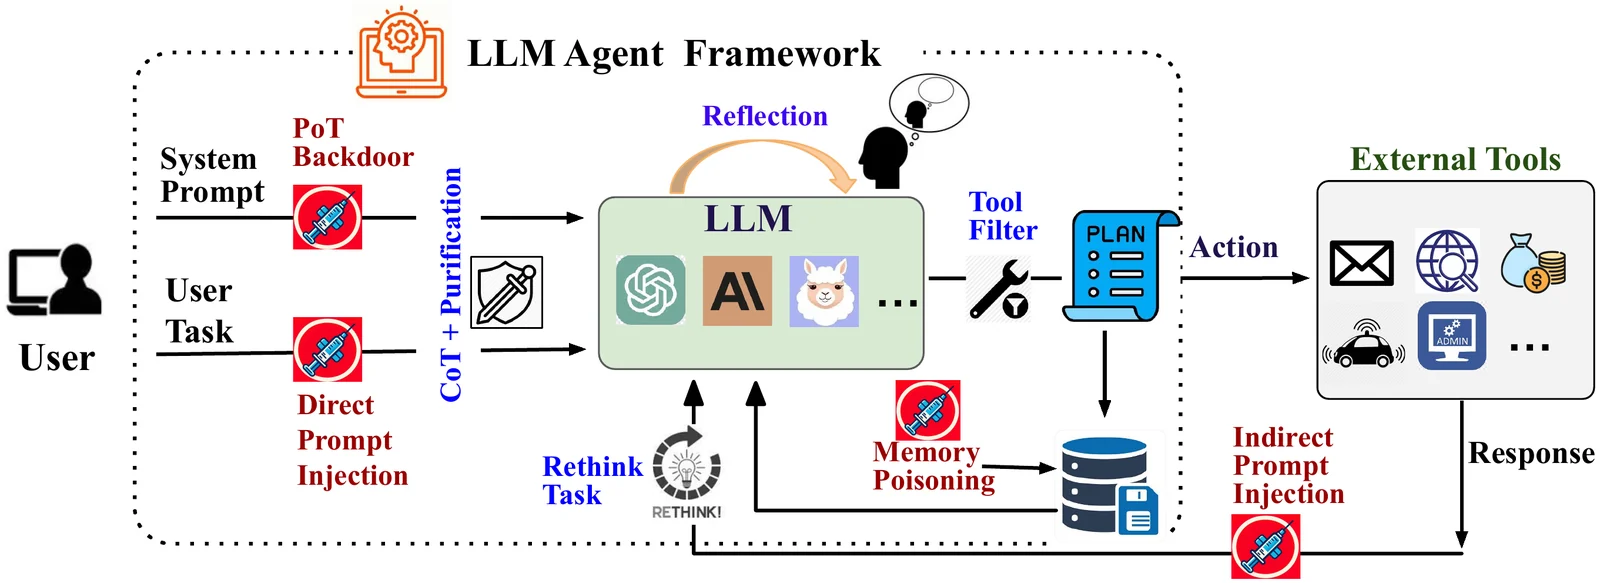
Nous nous appuyons sur Agent Security Bench (ASB) pour évaluer comment l'intégration d'outils et le raisonnement structuré (par exemple, la chaîne de pensée, la réflexion) affectent la vulnérabilité des agents LLM aux invites adversariales dans plusieurs scénarios de tâches.
Ce dépôt comprend :
Ce projet adapte et étend le code du dépôt officiel ASB :
Agent Security Bench (ASB): Formalizing and Benchmarking Attacks and Defenses in LLM-based Agents
GitHub: https://github.com/agiresearch/ASBench
Paper: https://openreview.net/forum?id=V4y0CpX4hK
Nous remercions les auteurs d'ASB d'avoir rendu leur framework publiquement disponible.
pip install -r requirements.txt
Pour évaluer le DPI :
python attack_launcher.py --cfg_path ./config/DPI.yml
Pour évaluer l'IPI :
python attack_launcher.py --cfg_path ./config/IPI.yml
Pour évaluer le MP :
python attack_launcher.py --cfg_path ./config/MP.yml
Pour évaluer l'attaque par porte dérobée :
python agent_attack_pot.py
