 ut-security/cve-2023-5217-poc
Un PoC pour déclencher CVE-2023-5217 depuis l'interface WebCodecs ou MediaRecorder du navigateur.

CVE-2023-5217 est une vulnérabilité libvpx exploitée in-the-wild qui a été découverte par Clément Lecigne du Google Threat Analysis Group comme ciblant Chrome.
Ce dépôt montre comment déclencher CVE-2023-5217 dans le navigateur en utilisant les API WebCodecs et MediaRecorder. CVE-2023-5217 permet un débordement de tampon de tas avec une longueur de débordement contrôlée et une réécriture d'une petite valeur répétée de 4 octets. On ne sait pas actuellement comment CVE-2023-5217 a été exploitée in-the-wild.
Au moment de la divulgation publique, il y avait deux correctifs dans libvpx et un dans Chromium qui ont corrigé CVE-2023-5217. Les correctifs libvpx incluaient la désactivation des changements du nombre de threads VP8 et un test pour l'encodage multithread. Le correctif Chromium a désactivé l'ajustement du nombre de threads dans WebCodecs.
libvpx est une bibliothèque qui gère l'encodage et le décodage VP8/VP9.
Le problème clé de CVE-2023-5217 est que réduire le nombre de threads tout en augmentant la hauteur de l'image dans une session d'encodage VP8 de libvpx provoque un débordement linéaire du tas d'une longueur contrôlée et une réécriture contrôlée d'une petite valeur répétée de 4 octets. La différence de hauteur d'image contrôle la longueur de la réécriture, et la nouvelle largeur d'image contrôle la valeur de 4 octets qui est écrite de manière répétée. Cette vulnérabilité peut être exploitée plusieurs fois pour écrire continuellement différentes petites valeurs de 4 octets en réduisant la hauteur dans chaque configuration suivante.
L'encodeur VP8 de libvpx maintient un tableau appelé mt_current_mb_col qui stocke la colonne actuelle en cours de traitement par un thread d'encodeur. Ce tableau n'est alloué que s'il y a plus d'un thread, et sa taille est fonction de mb_rows, où mb_rows = frame_height >> 4 et frame_height est arrondi au multiple de 16 supérieur.
// https://github.com/webmproject/libvpx/blob/6512f994da13e2f27e6a7bd449efee0a374b55b7/vp8/common/alloccommon.c#L85
// The width and height are rounded up to a multiple of 16 and then assigned to `mb_rows` and `mb_cols`
int vp8_alloc_frame_buffers(VP8_COMMON *oci, int width, int height) {
    ...
    // Round up the width/height up to the nearest multiple of 16
    if ((width & 0xf) != 0) width += 16 - (width & 0xf);
    if ((height & 0xf) != 0) height += 16 - (height & 0xf);
    ...
    oci->mb_rows = height >> 4;
    oci->mb_cols = width >> 4;
    ...
}
// https://github.com/webmproject/libvpx/blob/6512f994da13e2f27e6a7bd449efee0a374b55b7/vp8/encoder/onyx_if.c#L1232
// This snippet shows the allocation of `mt_current_mb_col`
void vp8_alloc_compressor_data(VP8_COMP *cpi) {
  ...
  // Only allocate if we have more than 1 thread
  if (cpi->oxcf.multi_threaded > 1) {
    int i;

    vpx_free(cpi->mt_current_mb_col);
    // sizeof(*cpi->mt_current_mb_col) is 4
    CHECK_MEM_ERROR(&cpi->common.error, cpi->mt_current_mb_col,
                    vpx_malloc(sizeof(*cpi->mt_current_mb_col) * cm->mb_rows));
    for (i = 0; i < cm->mb_rows; ++i)
      vpx_atomic_init(&cpi->mt_current_mb_col[i], 0);
  }
  ...
}
Une fois que libvpx a fini d'encoder une image, il stocke le nombre de colonnes encodées plus mt_sync_range dans mt_current_mb_col.
// https://github.com/webmproject/libvpx/blob/6512f994da13e2f27e6a7bd449efee0a374b55b7/vp8/encoder/onyx_if.c#L1212
// Snippet where the mt_sync_range value is set, based on the width.
void vp8_alloc_compressor_data(VP8_COMP *cpi) {
    ...
#if CONFIG_MULTITHREAD
  if (width < 640) {
    cpi->mt_sync_range = 1;
  } else if (width <= 1280) {
    cpi->mt_sync_range = 4;
  } else if (width <= 2560) {
    cpi->mt_sync_range = 8;
  } else {
    cpi->mt_sync_range = 16;
  }
#endif
  ...
}
// https://github.com/webmproject/libvpx/blob/6512f994da13e2f27e6a7bd449efee0a374b55b7/vp8/encoder/encodeframe.c#L560
// Function where the attacker chosen value is written
static void encode_mb_row(...) {
  ...
  const int nsync = cpi->mt_sync_range; // This value is set in vp8_alloc_compressor_data
  vpx_atomic_int rightmost_col = VPX_ATOMIC_INIT(cm->mb_cols + nsync);
  ...
  if (vpx_atomic_load_acquire(&cpi->b_multi_threaded) != 0) {
    current_mb_col = &cpi->mt_current_mb_col[mb_row];
  }
  ...
  if (vpx_atomic_load_acquire(&cpi->b_multi_threaded) != 0) {
    // current_mb_col is a reference to mt_current_mb_col
    vpx_atomic_store_release(current_mb_col,
                             vpx_atomic_load_acquire(&rightmost_col));
  }
  ...
}
Pour faire déborder mt_current_mb_col, nous avons besoin de trois configurations d'encodage :
mt_current_mb_col basée sur configvuln.height. Cette nouvelle hauteur doit être inférieure à configinit.initial_height sinon nous obtiendrons une erreur.mt_current_mb_col le laissant dans un état vulnérable. libvpx écrira de manière répétée la valeur (configattack.width >> 4) + 1 (où 1 est la variable mt_sync_range et la largeur est arrondie au multiple de 16 supérieur) en dehors des limites précédemment allouées lorsque la condition suivante est vérifiée :
$$\text{ceil}(\text{config}{\text{init}}.\text{height}/16) \geq \text{ceil}(\text{config}{\text{attack}}.\text{height}/16) \gt \text{ceil}(\text{config}_{\text{vuln}}.\text{height}/16)$$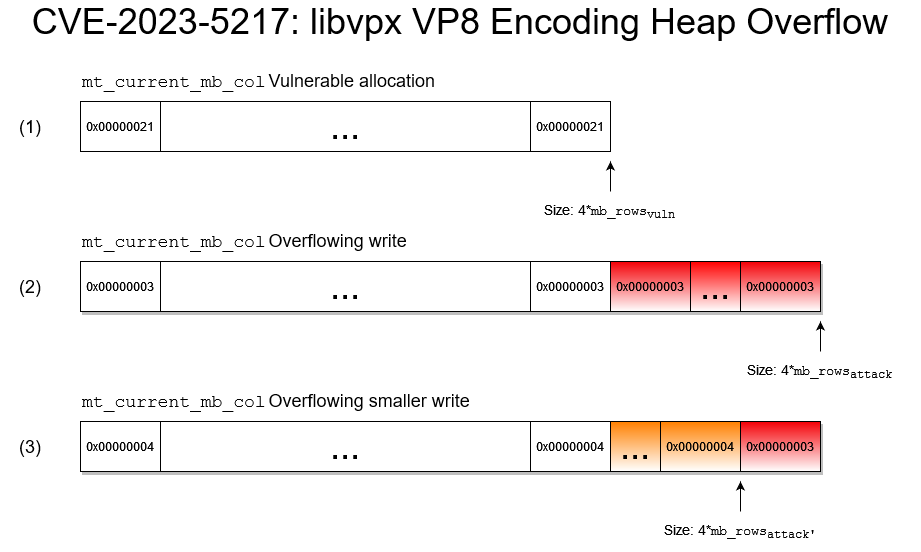
Plus concrètement, supposons que nous initialisons une configuration d'encodage VP8 avec configinit avec width = 1200, height = 1200, threads = 4. L'attaque est la suivante :
mb_rows est définie à 704/16=44, et le tableau mt_current_mb_col est alloué à (44)*4 = 176 octets. La valeur écrite stockée dans mt_current_mb_col est 512/16 + 1 = 33.mt_current_mb_col n'est réalloué que lorsqu'il y a plus d'un thread, il reste de la même taille, mais mb_rows est maintenant défini à 1008/16 = 63. Lorsque libvpx appelle encode_mb_row, il écrasera (63-44)*4 = 68 octets au-delà de l'allocation de mt_current_mb_col, en écrivant de manière répétée la valeur 32/16 + 1 = 3, où 32 est la largeur arrondie, et 1 est la valeur de mt_sync_range.mb_rows = 992/16 = 62 et mb_cols = 48/16 = 3, écrivant seulement (62-44)*4 = 64 octets au-delà de l'allocation originale la valeur 4.