 ucsb-mlsec/vulnllm-r
LLM de raisonnement spécialisé pour la détection de vulnérabilités dans le code source en C/C++ et Python, avec construction de jeux de données, entraînement SFT/DPO et scripts de reproduction des résultats.

git lfs install          # one-time setup
git clone https://github.com/ucsb-mlsec/VulnLLM-R.git
cd VulnLLM-R
# If you cloned before installing Git LFS, run: git lfs pull
conda create -n vulnscan python=3.11
conda activate vulnscan
pip install -e . -e ./vulscan/train/LLaMA-Factory -e ./vulscan/model_zoo
# generate VulnLLM-R-7B's results
python -m vulscan.test.test --output_dir results/test_data --dataset_path ./datasets/test/function_level/ ./datasets/test/repo_level/ --language python c java --model UCSB-SURFI/VulnLLM-R-7B --requests_per_minute 1000 --save --use_cot --batch_size 4 --tp 2 --vllm --max_tokens 8192 --random_cwe

python -m vulscan.test.test_hf \
      --output_dir results/test_hf \
      --hf_dataset UCSB-SURFI/VulnLLM-R-Test-Data \
      --hf_split repo_level function_level \
      --language c python java \
      --model UCSB-SURFI/VulnLLM-R-7B \
      --save --use_cot --vllm --tp 2

# [optional] generate other models' results with our shell script
# remember to add your API keys to .env file if you want to run commercial models
# use ./run_test.sh -h for more options
./vulscan/test/run_test.sh -o results/test_data -t 2 # -o means output directory, -t means tensor parallelism
./vulscan/test/run_test.sh -o results/test_data -M o3-mini # -M means model name, which runs only one model.
./vulscan/test/run_test.sh -o results/test_data -M gpt-5.4 -e high # -e sets reasoning effort (e.g., none/low/medium/high/xhigh)
./vulscan/test/run_test.sh -o results/test_data -M claude-opus-4-6 -e high

# [optional] draw plot to compare with other models
python plots/plot_language_comparison_models.py --results-dir results/test_data
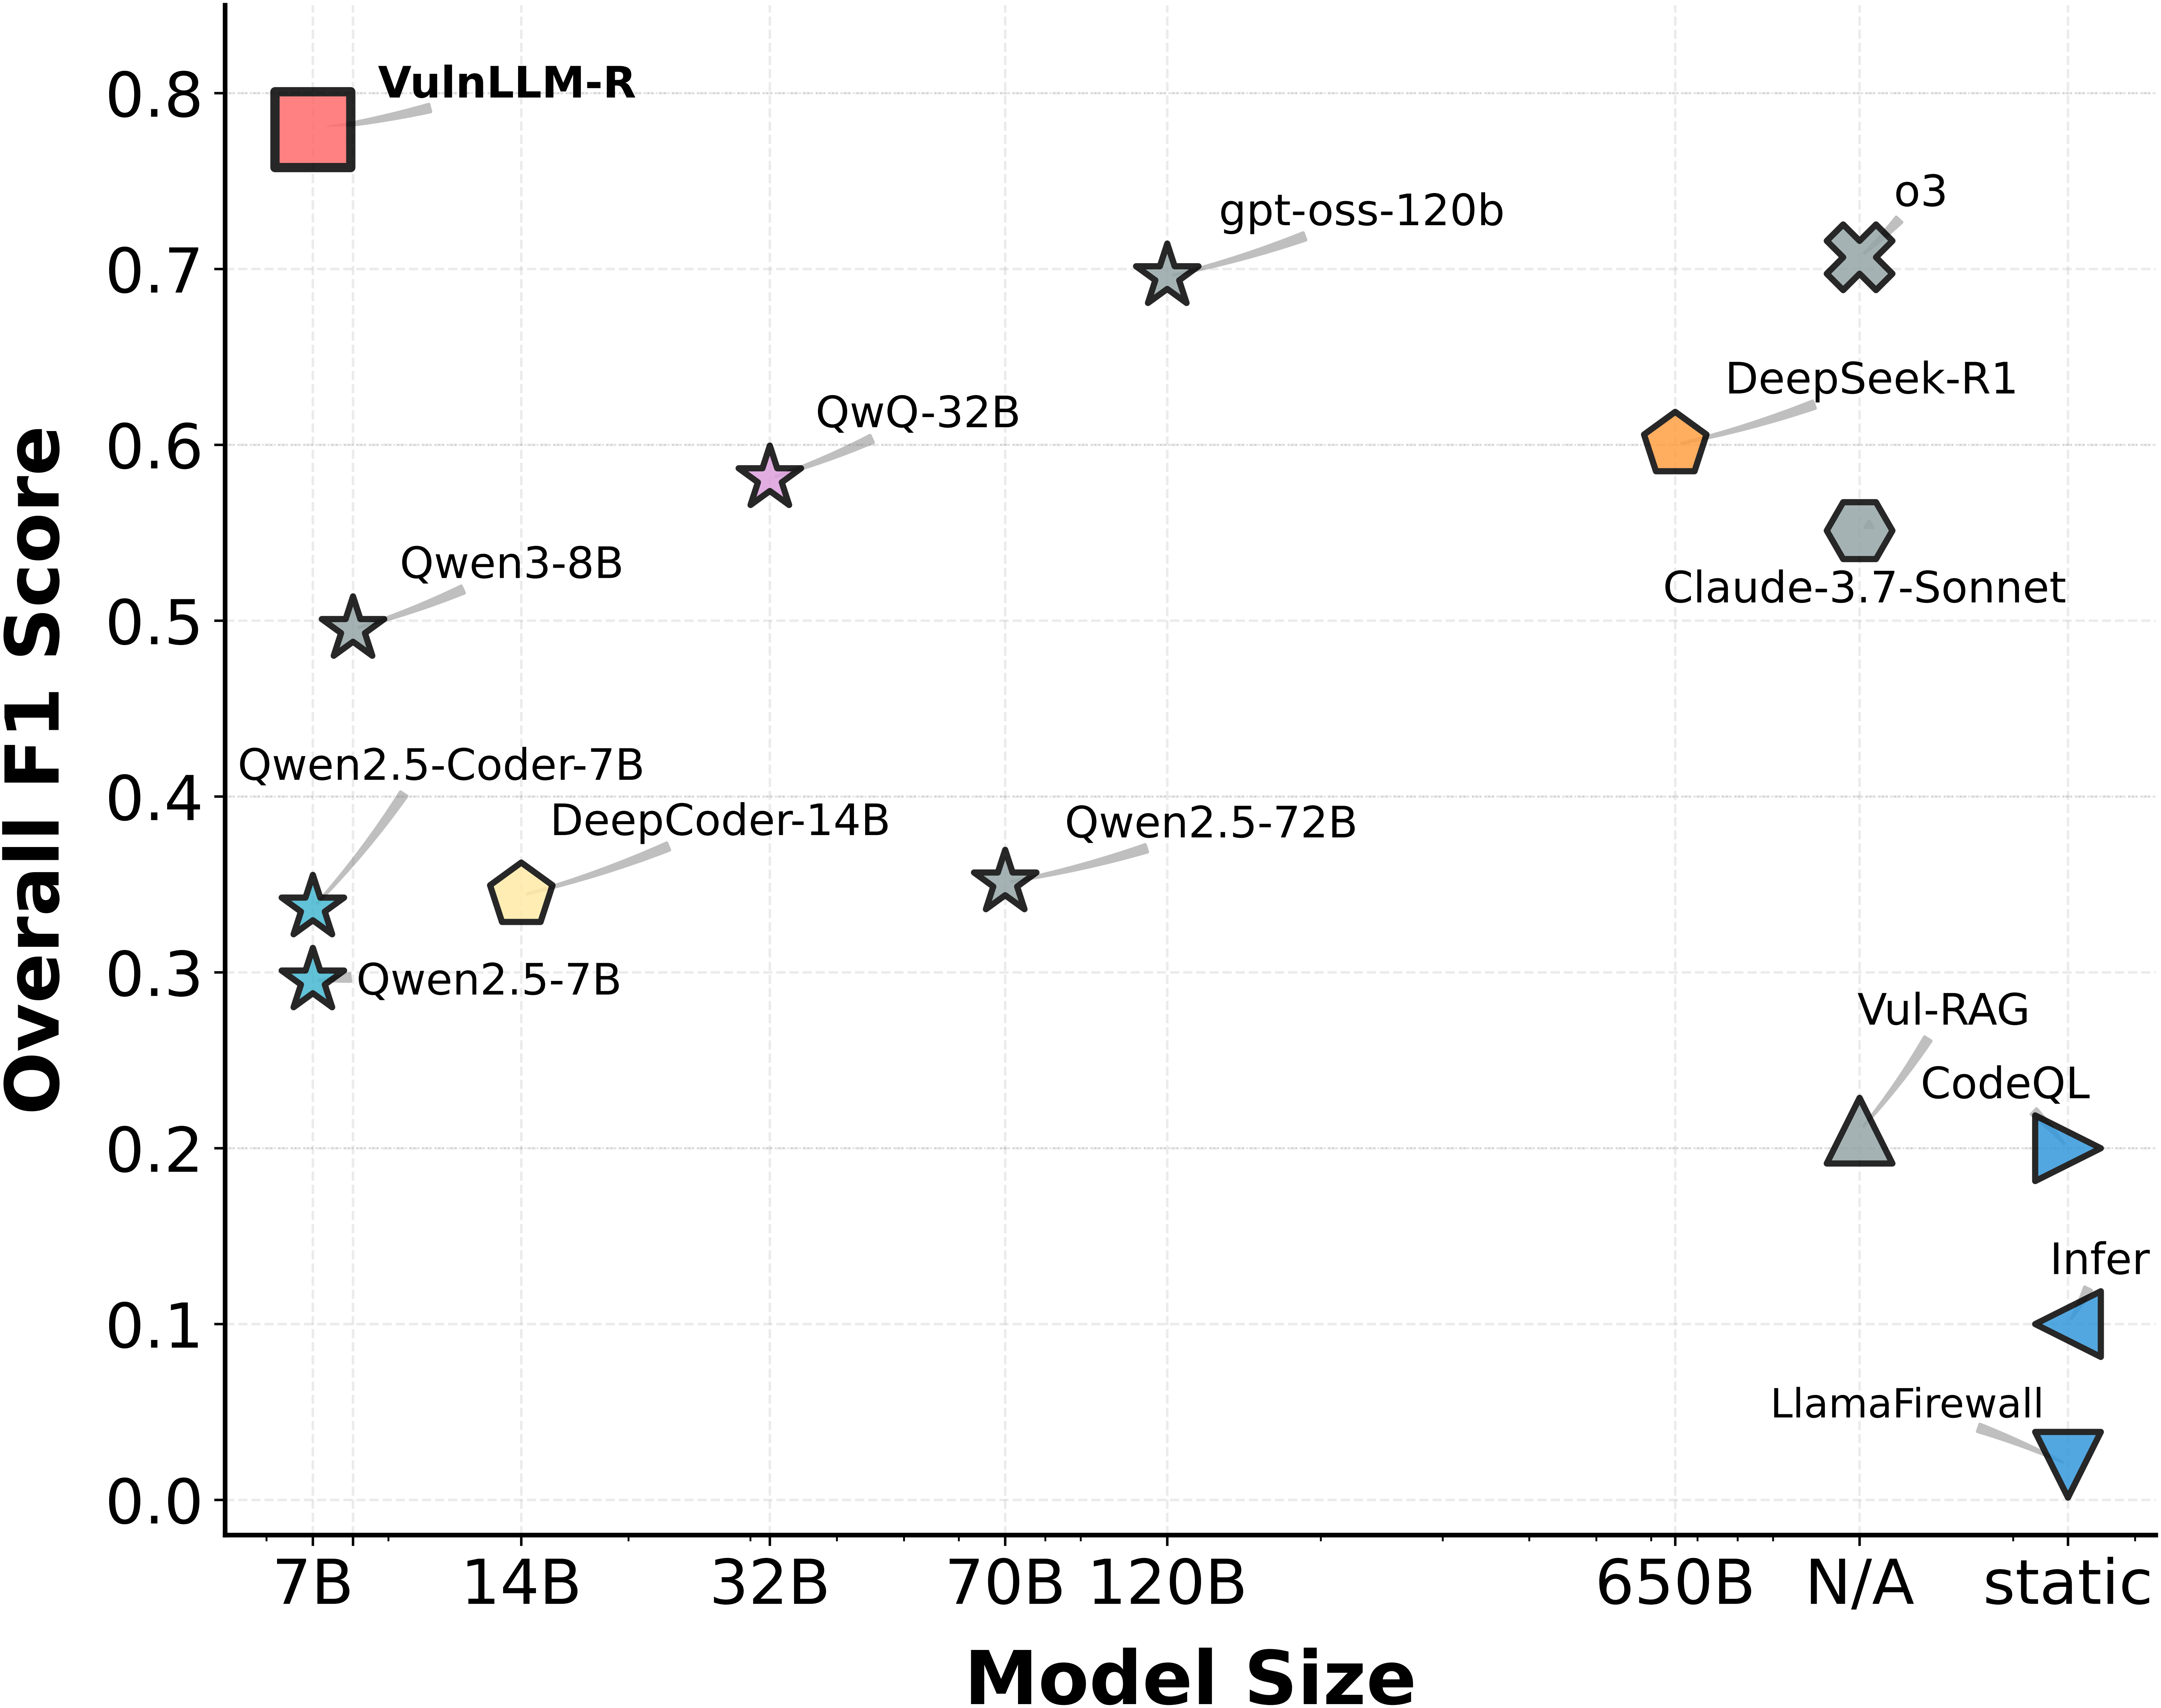
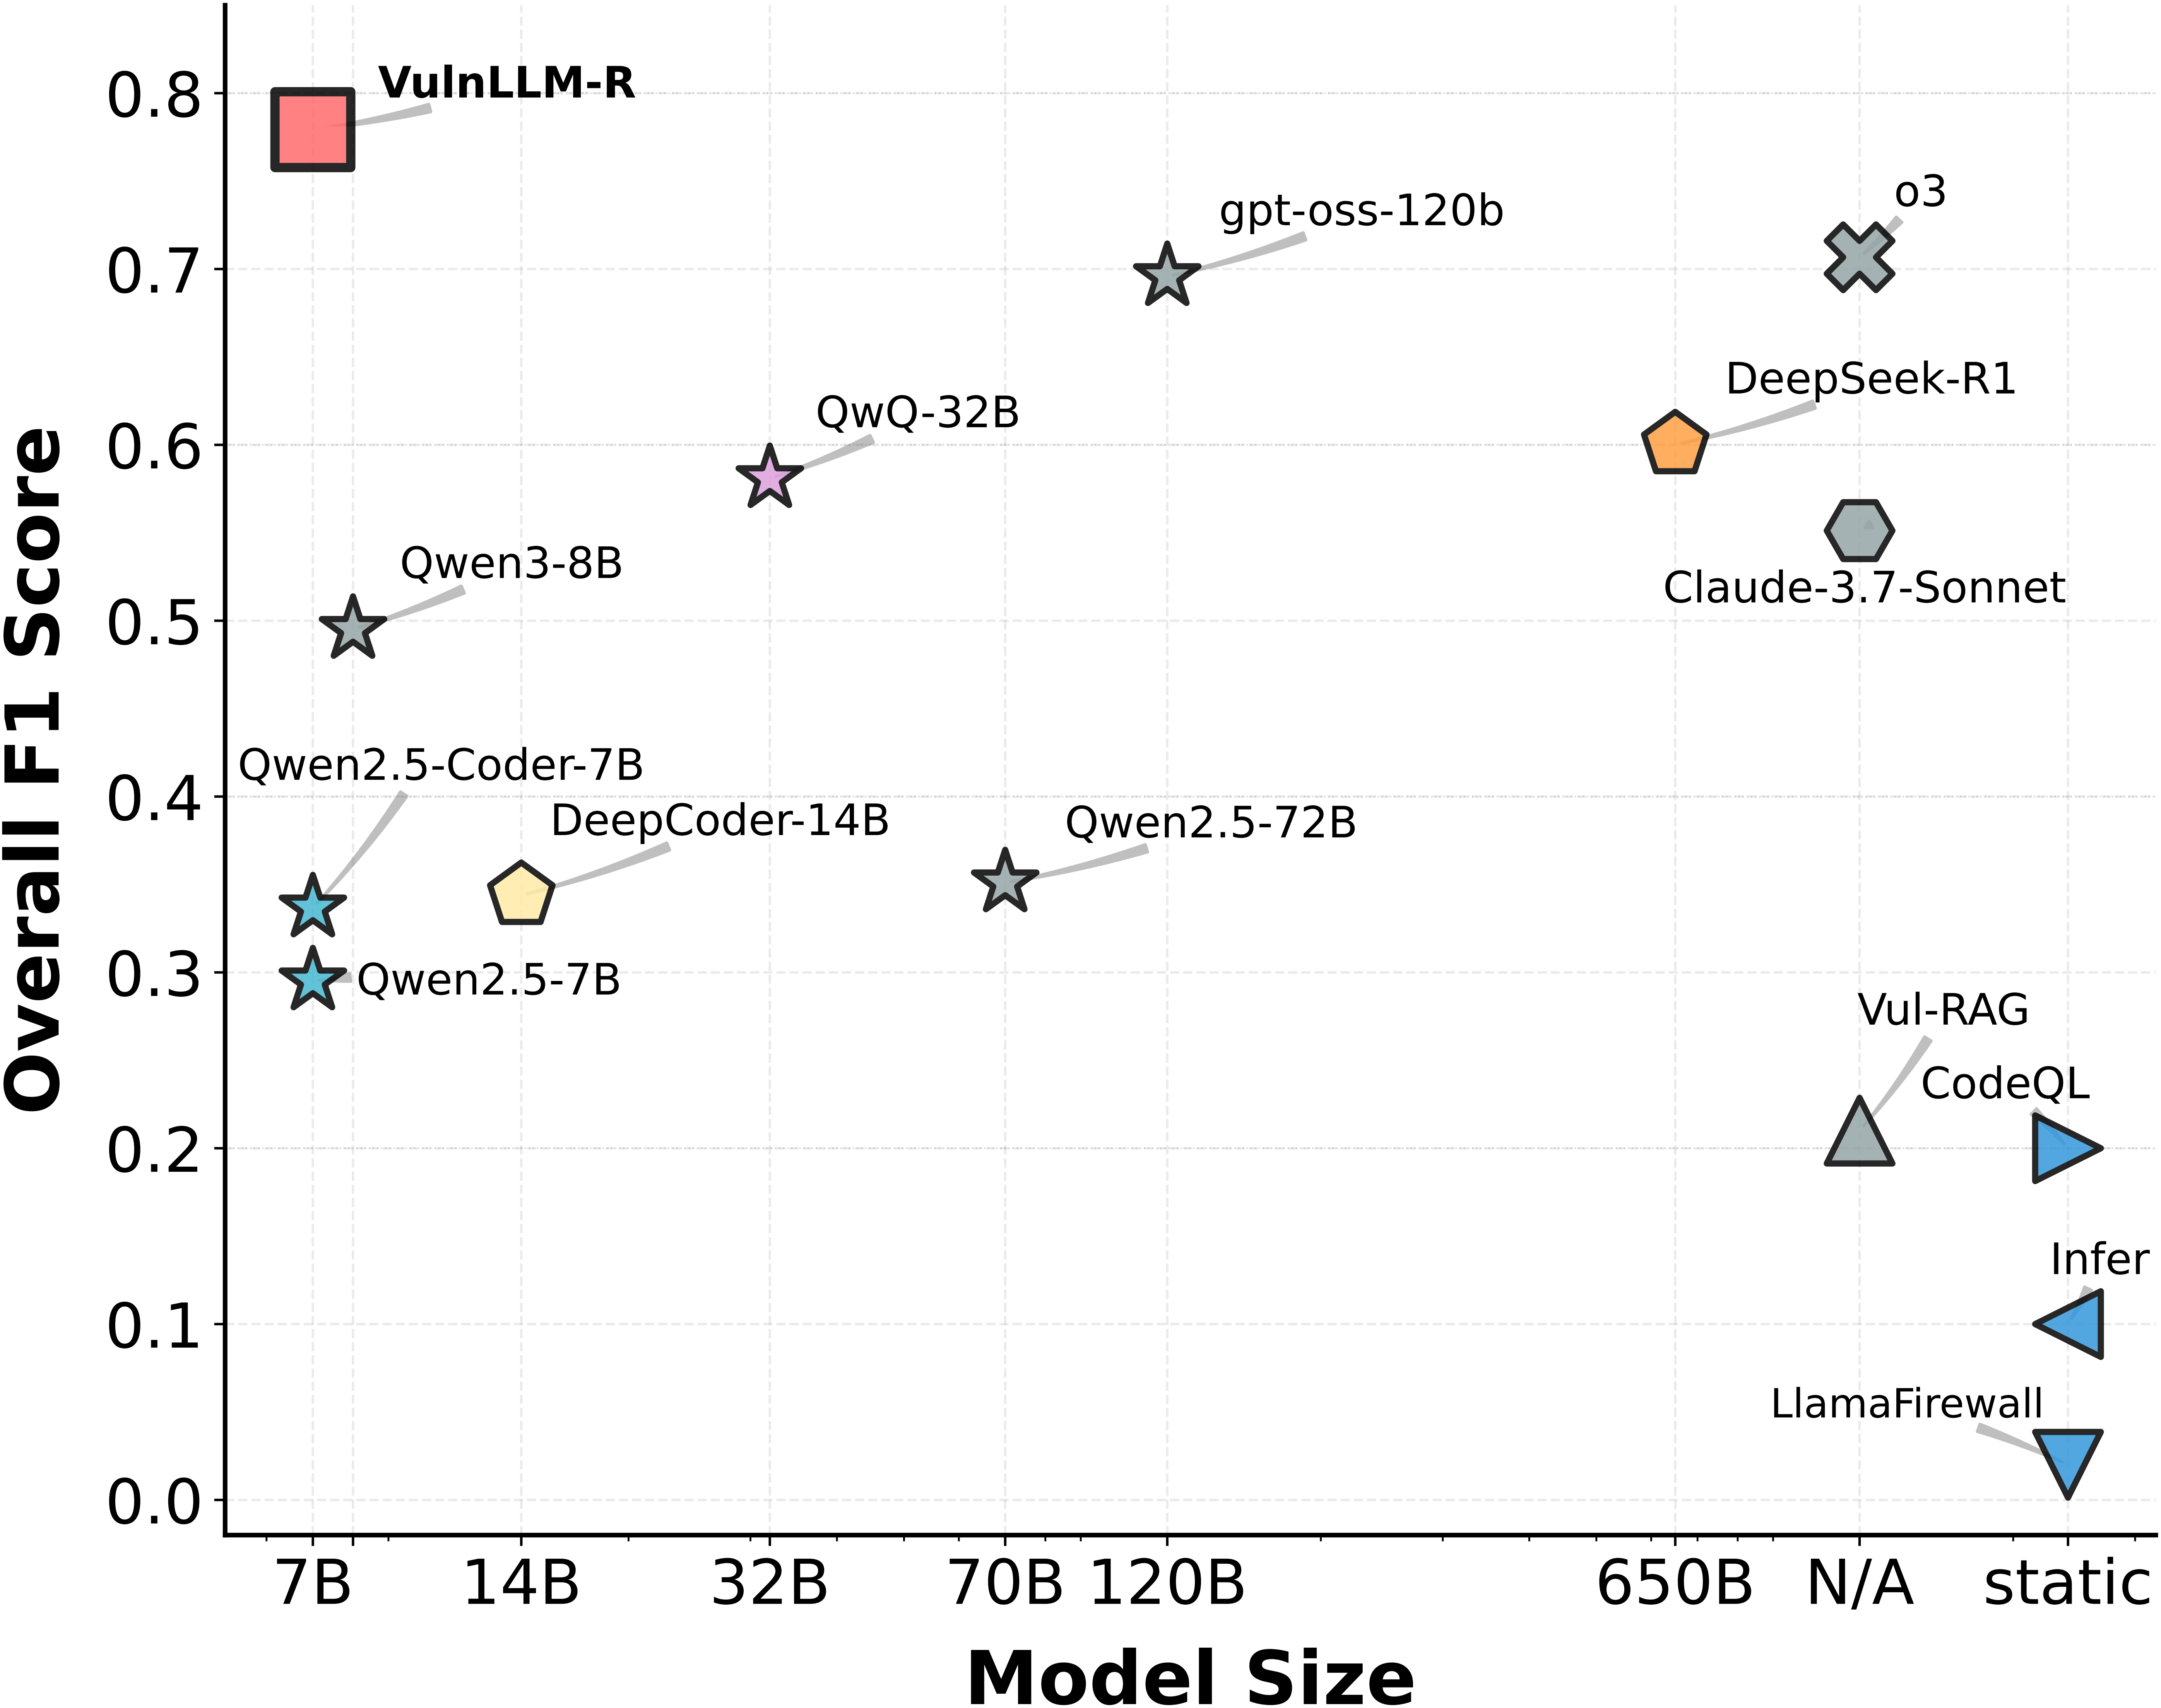
python plots/plot_model_size_scatter.py --results-dir results/test_data # Note: Labels may overlap with scatter points. Adjust text positions manually if needed.
Nous fournissons également la version à raisonnement réduit des jeux de données distillés :
Fusionnez les jeux de données existants de détection de vulnérabilités au niveau des fonctions : PrimeVul [1], SecCodePLT [2], Juliet [3], Sven [4], et Arvo [5]. Parmi ces jeux de données, PrimeVul contient les fonctions les plus complexes. Nous créons deux ensembles d'entraînement : clean (sans PrimeVul) et noisy (avec PrimeVul), afin de pouvoir nous entraîner sur des jeux de données relativement simples et tester sur le jeu de données complexe PrimeVul. Notez que le fait de nommer l'ensemble d'entraînement avec PrimeVul « noisy » ne signifie pas que le jeu de données est bruité. C'est un nom relativement arbitraire que nous avons utilisé au départ.
vulscan/data_process/data_utils contient un ensemble de scripts pour traiter et fusionner les
jeux de données.
raw_to_us.py : Fusionner les données brutes dans notre jeu de données et supprimer les données redondantescheck_cwe_correct.py : Calculer la précision pour chaque catégorie de CWEgenerate_arvo_raw_data.py : Générer des données brutes structurées à partir du jeu de données arvoarvo_to_us.py : Reformater les données brutes structurées d'arvo au format de notre jeu de donnéessplit_good_bad_for_juliet.py : Extraire les données du jeu de données brut Juliet 1.3 et les convertir au format requis,
ce qui constitue une partie de notre clean_dataset cadd_sven_to_clean_dataset.py : Extraire les données du jeu de données Sven, formant une partie de notre clean dataset Csync_large_small.py : Synchroniser les modifications de noisy_dataset/large_train/c vers
noisy_dataset/small_train/cremove_testing_from_training.py : Ajouter le tag human à chaque donnée, ce qui signifie que le point a été vérifié par un
humain et utilisé comme donnée de test
-data_utils.py : Ajouter le champ related_cwe au jeu de données.datasets/clean_dataset : les données d'entraînement sans PrimeVul
datasets/clean_dataset/python contient les données de SVEN et SecCodePLTdatasets/clean_dataset/c contient les données de Juliet et SVENdatasets/noisy_dataset
datasets/noisy_dataset/small_train : Contient les données d'entraînement de PrimeVul et SVEN avec des CWE sélectionnés (
nous utilisons les données PrimeVul de ce jeu de données comme entraînement)datasets/noisy_dataset/large_train : Contient les données d'entraînement de PrimeVul, SVEN et SecCodePLT avec
plus de CWE (ce jeu de données peut ensuite être utilisé pour entraîner des modèles plus grands)datasets/noisy_dataset/test : Un petit ensemble de test de PrimeVul vérifié par un humaindatasets/test
datasets/test/test_clean : Les données de test de SVEN, SecCodePLT et Juliet ; avec des CWE OOD qui ne font pas
partie de l'ensemble d'entraînementdatasets/test/test_primevul_pair : Les données de test originales de PrimeVulvulscan/data_process/data_utils/get_cwe_stat.py pour obtenir l'histogramme du jeu de données