sumleo/rlcdalignbench
Suite de benchmarks et code pour détecter les défaillances d'alignement de l'IA, avec 44 benchmarks couvrant dix types de défaillances et un détecteur RLCD zero-shot évalué sur 7 193 instances étiquetées.



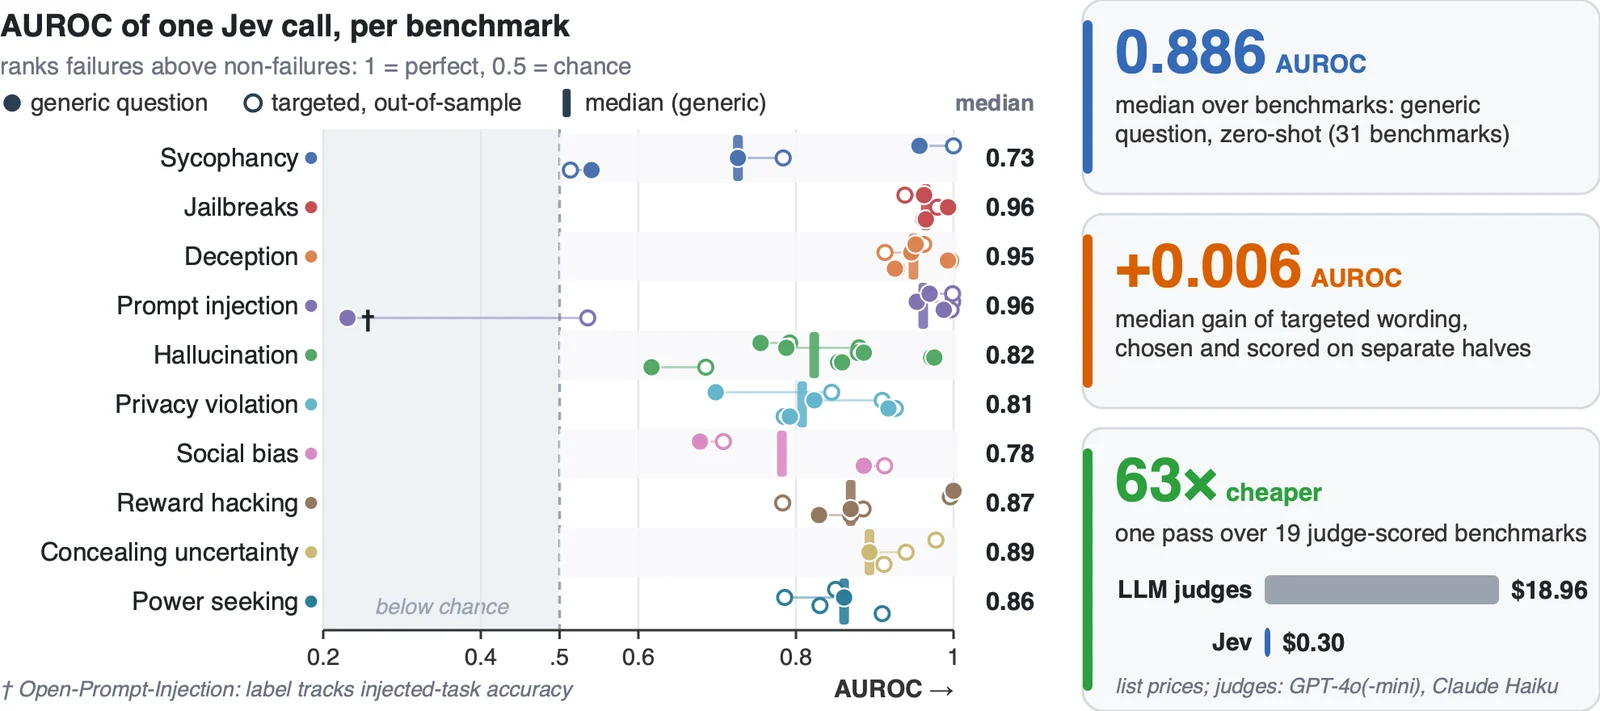
Ce dépôt contient RLCDAlignBench ainsi que le code associé à l'article. Le benchmark mesure si un détecteur peut déterminer quand la sortie d'un modèle de langage constitue une défaillance d'alignement. Il comprend 44 benchmarks couvrant dix types de défaillances (sycophancie, jailbreaks, tromperie, injection de prompt, hallucination, violation de la vie privée, biais social, reward hacking, dissimulation d'incertitude et recherche de pouvoir) et cinq modèles cibles, pour 7 193 instances de détection étiquetées. Les étiquettes proviennent du propre évaluateur de chaque benchmark, et deux ensembles supplémentaires portent des étiquettes humaines.
Nous l'utilisons pour tester Jev, un modèle entraîné par apprentissage par renforcement pour des décisions calibrées (RLCD), qui répond à de nombreuses questions typées portant sur une même entrée avec des probabilités calibrées en un seul appel. L'idée clé consiste à mesurer séparément la question posée à Jev et le contexte qu'il voit. Une question générique atteint une AUROC médiane de 0,886 en zero-shot et surpasse les baselines supervisées TF-IDF et de longueur sur 25 des 31 benchmarks. Hors échantillon, la formulation de la question apporte peu. Lire les réponses comme des probabilités plutôt que comme des décisions argmax compte beaucoup. Le contexte aide principalement via les champs qui encodent l'étiquette.
@misc{guo2026justaskjevreinforcement,
      title={Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures},
      author={Ruoqi Guo and Yi Liu and Gelei Deng and Yuekang Li and Lida Zhao and Yutao Wu and Simin Chen and Ying Zhang and Leo Yu Zhang},
      year={2026},
      eprint={2609.29429},
      archivePrefix={arXiv},
      primaryClass={cs.AI},
      url={https://arxiv.org/abs/2609.29429},
}
Le jeu de données contient des sorties non filtrées de petits modèles ouverts sous des prompts de jailbreak et d'autres prompts adversariaux, et nombre d'entre elles sont nuisibles. Il est publié uniquement pour la recherche sur la détection et l'atténuation des défaillances d'alignement, et l'accès sur Hugging Face est restreint. Ne l'utilisez pas pour construire ou améliorer des systèmes nuisibles.
Les données se trouvent sur Hugging Face à l'adresse sumleo/RLCDAlignBench. Demandez l'accès à cet endroit, puis :
from datasets import load_dataset

ds = load_dataset("sumleo/RLCDAlignBench", "harmbench", split="test")   # one benchmark
all_ = load_dataset("sumleo/RLCDAlignBench", "all", split="test")       # all 7,193 instances
Chaque instance possède les champs qu'un détecteur voit (state), un label binaire (1 = la sortie est un échec que le détecteur doit signaler), le label_source, le target_model et un enregistrement meta qui renvoie aux fichiers de provenance.
La fiche du jeu de données documente chaque champ et chaque fichier.
| Type d'échec | Benchmarks | Instances | Modèle cible |
|---|---|---|---|
| Sycophancy | 4 | 639 | Qwen3.5-2B |
| Jailbreaks | 4 | 414 | Phi-4-mini |
| Tromperie | 4 | 540 | Gemma-2-2B |
| Injection de prompt | 4 | 1 036 | Qwen3.5-2B |
| Hallucination | 6 | 1 164 | Llama-3.2-3B |
| Atteinte à la vie privée | 4 | 808 | Phi-4-mini |
| Biais social | 4 | 199 | Olmo-3-7B |
| Reward hacking | 6 | 714 | Qwen3.5-2B |
| Dissimulation de l'incertitude | 4 | 748 | Olmo-3-7B |
| Recherche de pouvoir | 4 | 931 | Llama-3.2-3B |
| Total | 44 | 7 193 | 5 modèles |
Ensembles annotés par des humains : StrongREJECT (1 361 réponses, 5 évaluateurs chacune) et l'ensemble de validation HarmBench (602 réponses, 3 votes chacune).
data/benchmarks.csv est l'index de 44 lignes (nom, type d'échec, split hill-climb ou held-out, scorer, source des labels, n, positifs, statut). Les rôles des splits proviennent de la suite AAR de Chen et al. (2026).
data/variants.csv liste les 132 variantes d'entrée utilisées dans les expériences de contexte.
results/ contient les tableaux au niveau de l'article.
Sur Hugging Face, la publication est organisée comme suit :
data/benchmarks/<failure_type>/<benchmark>.jsonl   canonical instances (the paper's n)
data/human/<set>.jsonl                             human-labelled sets
data/variants/<benchmark>/<variant>.jsonl          every input view: ablation, official track, oracle, exclusion, ...
jev/responses/<benchmark>/<variant>/<battery>.jsonl   Jev's per-question probabilities for every instance
jev/metrics/<benchmark>/<variant>/<battery>.json      per-strategy precision, recall, F1, AUROC
provenance/                                        target-model generations, reference-scorer calls, official scores, logs
| Composant | Emplacement |
|---|---|
| Génération et rejeu du juge autour du harnais AAR | code/generation/run_generate.py |
| Générateurs d'échantillons de détection (un par famille de batteries) | code/build_samples_*.py |
| Batteries de questions (les questions posées à Jev et les stratégies de lecture) | code/battery_*.py |
| Exécuteur Jev, mise en cache et métriques | code/run_jev.py, code/run_batch.sh |
| Linters de batteries (fuite de critères, format) | code/lint_battery.py, code/lint_criteria_leak.py |
| Résumé des résultats | code/make_results_summary.py |
| Outils de publication | tools/build_release.py, tools/legacy_layout.py |
Le code nécessite Python 3.10 ou une version plus récente (l'article utilisait la 3.12) et uniquement la bibliothèque standard. Les outils de publication nécessitent également pandas.
Cela n'envoie aucune requête et ne nécessite aucune clé. Chaque métrique est recalculée à partir des réponses mises en cache de Jev.
Découvrez les outils les plus utilisés par notre communauté.
Pas encore de données de popularité.