 rodricios/wxpath
wxpath - exploration web déclarative avec XPath ; un langage de requête Web (WQL)


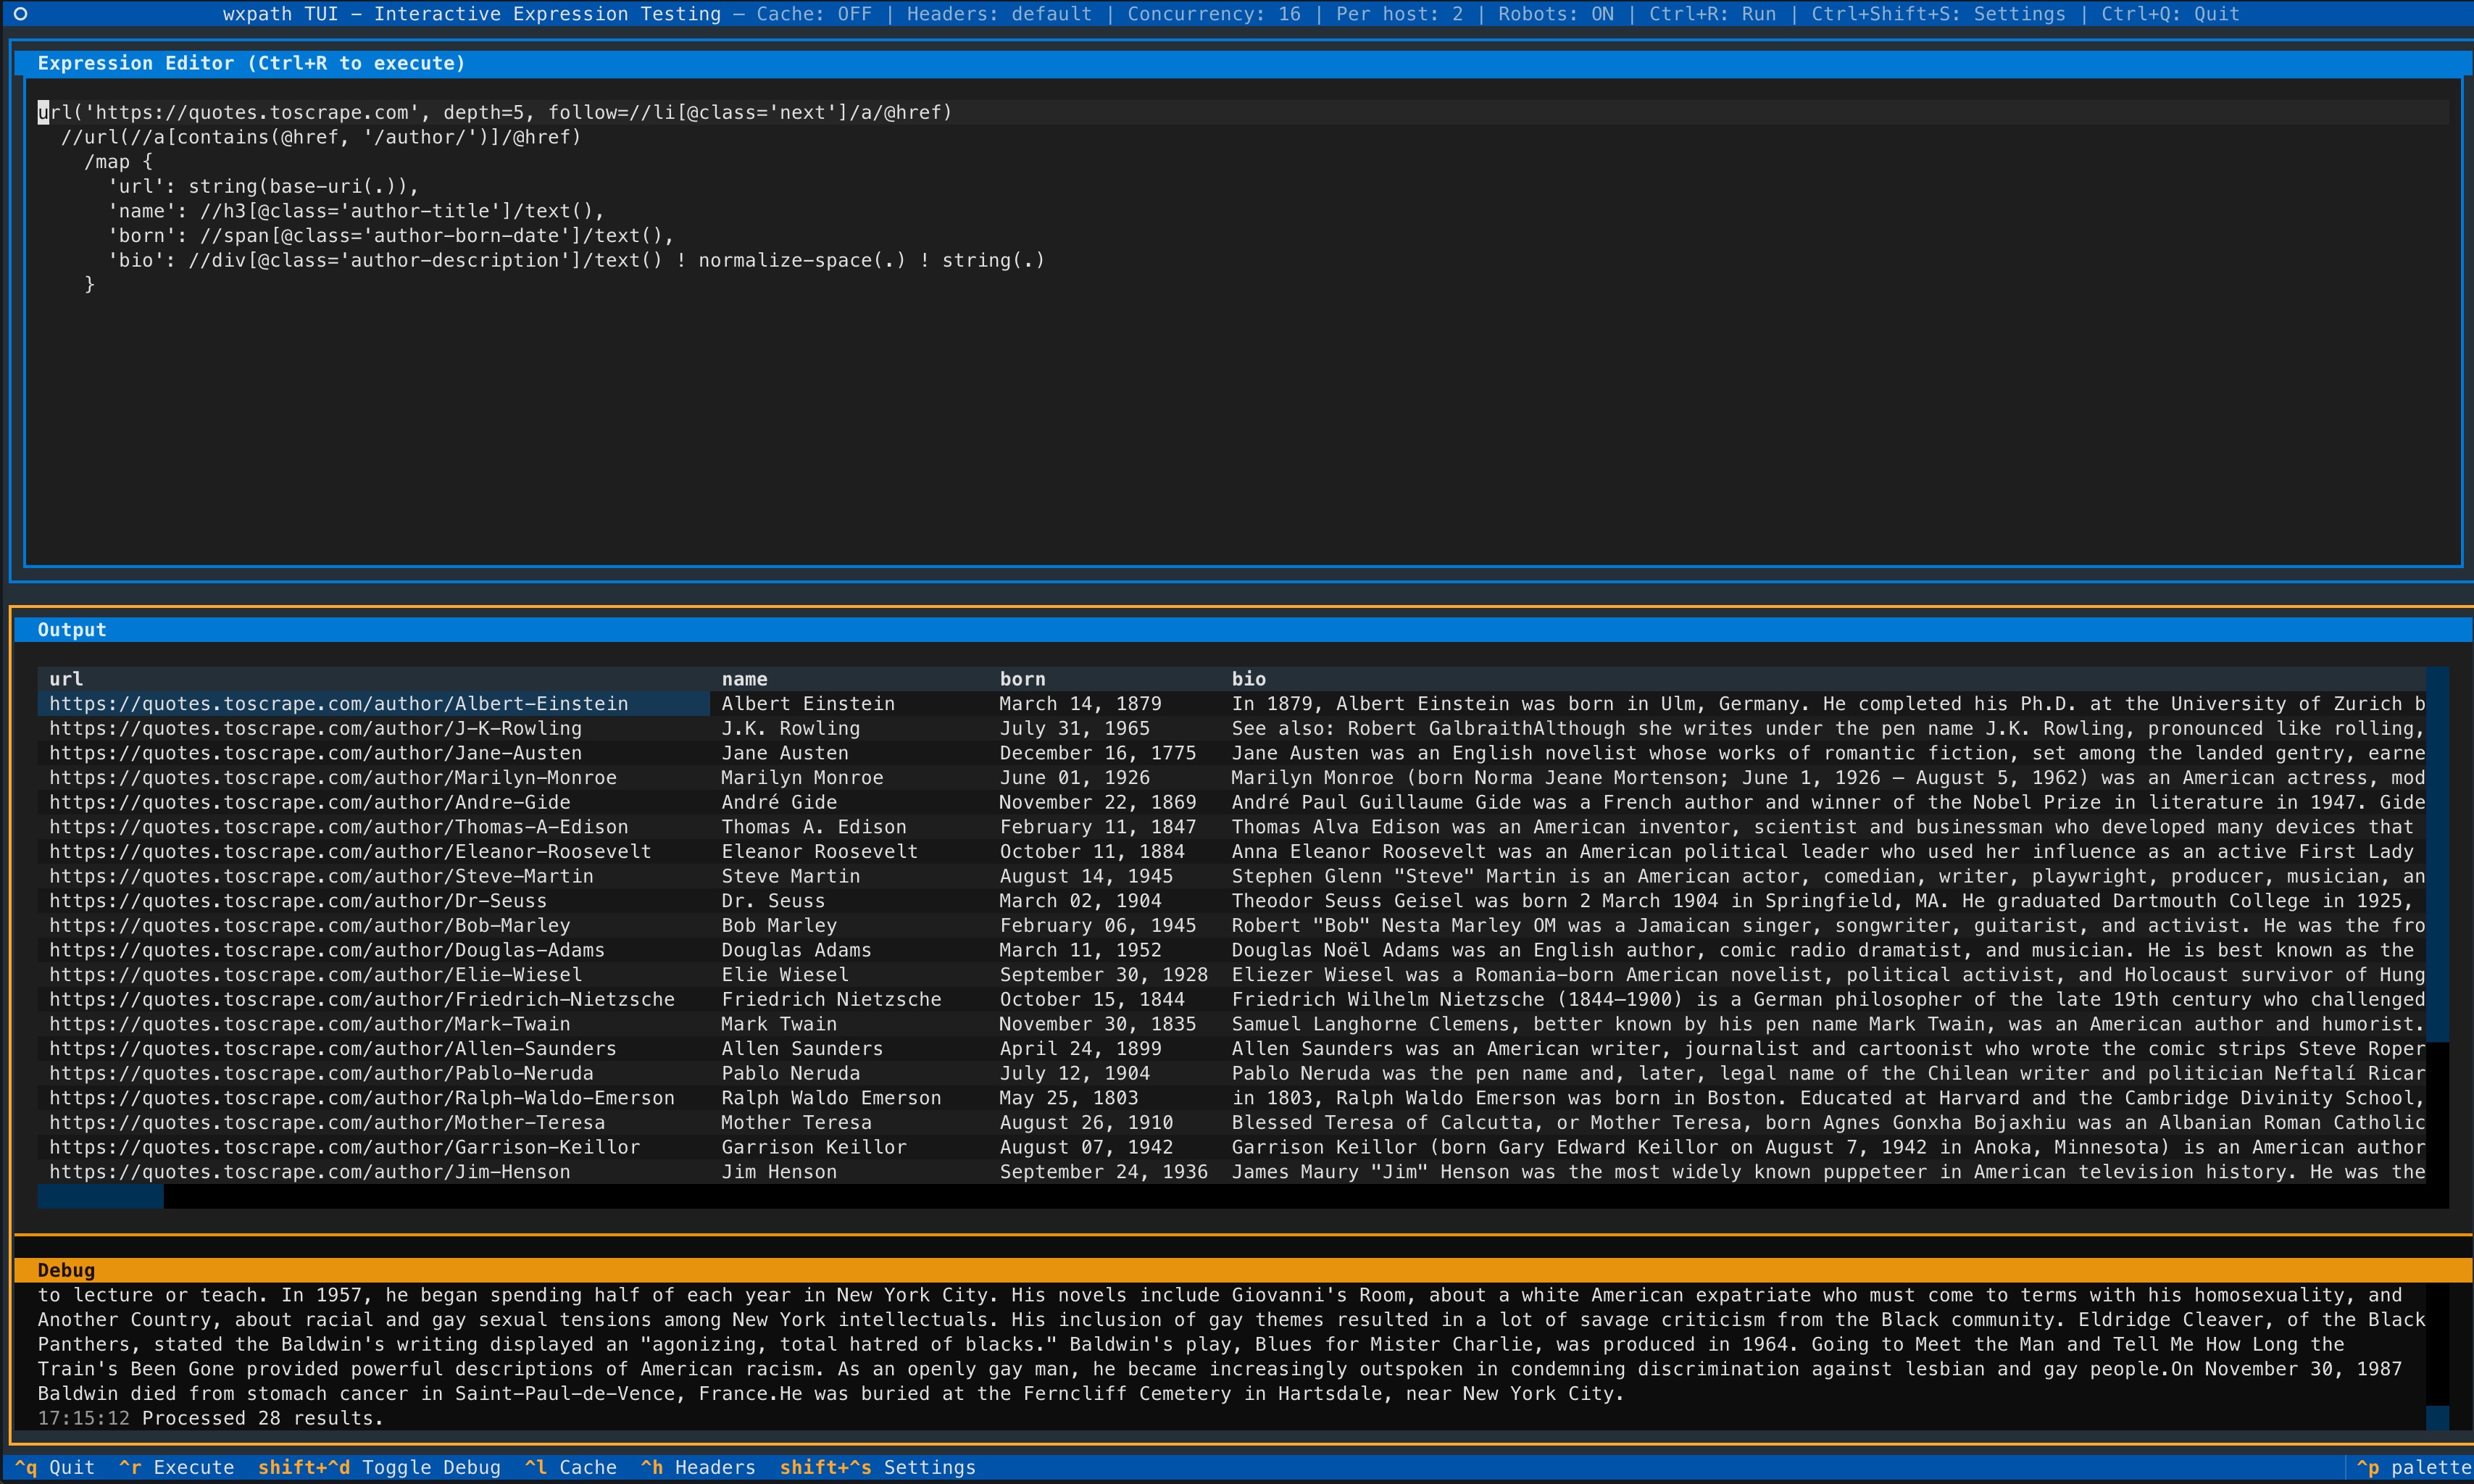
NOUVEAU : TUI - Interface terminal interactive (propulsée par Textual) pour tester des expressions wxpath et exporter des données.
Nécessite Python 3.10+.
pip install wxpath
# Pour le support TUI :
pip install "wxpath[tui]"
# Lancez immédiatement la TUI via uv :
uvx --from "wxpath[tui]" wxpath-tui
wxpath est un robot d'exploration web déclaratif où le parcours est exprimé directement en XPath. Au lieu d'écrire des boucles d'exploration impératives, wxpath vous permet de décrire quoi suivre et quoi extraire en une seule expression. wxpath exécute cette expression de manière concurrente, en largeur d'abord-ish, et diffuse les résultats au fur et à mesure de leur découverte.
Cette expression récupère une page, extrait les liens et les diffuse simultanément - pas de boucle d'exploration nécessaire :
import wxpath

expr = "url('https://quotes.toscrape.com')//a/@href"

for link in wxpath.wxpath_async_blocking_iter(expr):
    print(link)
En introduisant l'opérateur url(...) et la syntaxe ///, le moteur de wxpath est capable d'effectuer une exploration web récursive (ou paginée) et une extraction :
import wxpath

path_expr = """
url('https://quotes.toscrape.com')
  ///url(//a/@href)
    //a/@href
"""

for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
    print(item)
La plupart des gratteurs web vous obligent à écrire le contrôle de flux d'exploration d'abord, et l'extraction ensuite.
wxpath fusionne ces deux étapes en une seule :
Extrayez des hiérarchies JSON propres et structurées directement depuis le graphe - alimentez vos LLM avec du signal, pas du bruit. Référez-vous à Intégration LangChain pour plus de détails.
wxpath est déterministe (lire : pas propulsé par des LLM). Bien que nous ne puissions pas garantir la stabilité du réseau, nous pouvons garantir que le parcours l'est.
La documentation est maintenant disponible ici.
url(...) et ///url(...) expliquésimport wxpath
from wxpath.settings import CRAWLER_SETTINGS
# En-têtes personnalisés pour la politesse ; nécessaires pour certains sites (ex : Wikipédia)
CRAWLER_SETTINGS.headers = {'User-Agent': 'my-app/0.4.0 (contact: [email protected])'}
# Explorer, extraire des champs, construire un graphe de connaissances
path_expr = """
url('https://en.wikipedia.org/wiki/Expression_language')
///url(
//main//a/@href[
starts-with(., '/wiki/') and not(contains(., ':'))
]
)
/map{
'title': (//span[contains(@class, "mw-page-title-main")]/text())[1] ! string(.),
'url': string(base-uri(.)),
'short_description': //div[contains(@class, 'shortdescription')]/text() ! string(.),
'forward_links': //div[@id="mw-content-text"]//a/@href ! string(.)
}
"""
for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
print(item)
Remarque : Certains sites (dont Wikipédia) peuvent bloquer les requêtes sans en-têtes appropriés.
Voir Avancé : Configuration du moteur et du robot pour définir un User-Agent personnalisé.
L'expression ci-dessus fait ce qui suit :
https://en.wikipedia.org/wiki/Expression_language.<main> qui commencent par /wiki/ et ne contiennent pas de deux-points (:).url(...) et ///url(...) expliquésurl(...) est un opérateur personnalisé qui récupère le contenu de l'URL spécifiée par l'utilisateur ou générée en interne et le retourne en tant qu'lxml.html.HtmlElement pour un traitement XPath ultérieur.///url(...) indique une exploration en profondeur. Il indique au moteur d'exécution de continuer à suivre les liens jusqu'à la max_depth spécifiée. Contrairement aux sauts url() répétés, il permet à une seule expression de décrire une exploration plus profonde du graphe. ATTENTION : À utiliser avec prudence et contraintes (via max_depth ou des prédicats XPath) pour éviter une explosion du parcours.Voir DESIGN.md pour les détails de la conception du langage. Vous y verrez les concepts fondamentaux et concevrez le langage depuis la base.
wxpath évalue une expression comme une liste d'étapes de parcours et d'extraction (appelées en interne Segments).
url(...) crée des tâches d'exploration soit statiquement (via une URL fixe) soit dynamiquement (via une URL dérivée de l'expression XPath). Les URLs sont dédupliquées globalement, au mieux, et non par profondeur.
Les segments XPath opèrent sur les documents récupérés (via les opérations url(...) immédiatement précédentes).
///url(...) indique une exploration en profondeur - elle procède en largeur d'abord-ish jusqu'à max_depth.
Les résultats sont renvoyés dès qu'ils sont prêts.
wxpath est d'abord basé sur asyncio/aiohttp, fournissant une API asynchrone pour l'exploration et l'extraction de données.
import asyncio
from wxpath import wxpath_async

items = []

async def main():
    path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
    async for item in wxpath_async(path_expr, max_depth=1):
        items.append(item)

asyncio.run(main())
