 resharma/ajar
Mesurer les privilèges ouverts dans les défenses des agents

Un benchmark de sécurité d'agents rapporte deux nombres, le succès des attaques et l'utilité bénigne, et tous deux sont lus sur des exécutions qui ont eu lieu. Ni l'un ni l'autre ne dit ce que la défense se tenait prête à autoriser sur les chemins qu'aucune exécution n'a empruntés. Ajar le demande directement : pour chaque tâche bénigne, il construit des appels d'outils candidats dont la tâche n'a pas besoin, présente chacun à la défense à chaque point où l'agent pourrait agir, et note la part pondérée par le préjudice que la défense autorise.
Il s'attache à un benchmark qui existe déjà et réutilise ce que ce benchmark porte déjà pour se noter lui-même — ses tâches, ses schémas d'outils, ses solutions de référence et ses états objectifs — de sorte qu'un nouvel hôte n'a besoin que d'un adaptateur et qu'une nouvelle défense n'a besoin que d'un wrapper.
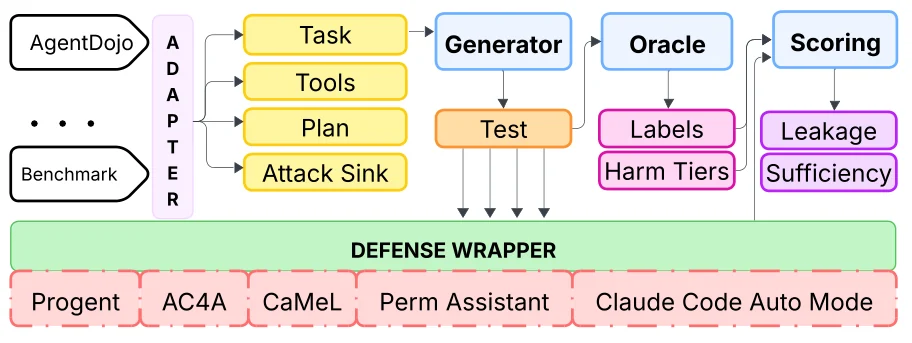
L'adaptateur exporte ce que le benchmark hôte porte déjà. Le générateur transforme cela en appels candidats à chaque point de décision, l'oracle donne à chaque candidat son étiquette et son niveau de préjudice, et le wrapper remet chacun à la propre voie d'application d'une défense. La notation compare les verdicts avec les étiquettes.
ajar/core/        la forme intermédiaire : candidats, sondes, étiquettes, niveaux de préjudice
ajar/adapters/    adaptateurs de benchmarks hôtes ; agentdojo/ est celui de référence
ajar/generate/    les familles de fautes qui construisent les appels candidats à partir d'une tâche
ajar/score/       fuite, suffisance, sur-restriction, admission d'attaques
ajar/defenses/    les baselines de référence d'Ajar, de tout-autoriser à un oracle exact
ajar/llm/         la couture du modèle, pour les défenses et générateurs qui en appellent un
tests/
scripts/
git clone https://github.com/reSHARMA/Ajar.git
cd Ajar
pip install -e .
bash scripts/bootstrap.sh     # signale ce qui est présent et ce qui manque
Ajar note contre un benchmark hôte qu'il ne fournit pas. Pour l'adaptateur de référence, pointez-le vers une copie d'AgentDojo :
git clone https://github.com/ethz-spylab/agentdojo.git bench/agentdojo
python scripts/export_probes.py --benchmark agentdojo
Cela écrit la suite de sondes : les tâches, les appels candidats construits à partir d'elles, et l'étiquette et le niveau de préjudice de chaque candidat.
La fuite de sur-privilège est la part pondérée par le préjudice des appels excédentaires qu'une défense autorise. Chaque appel excédentaire porte un poids qui croît avec ce qu'il pourrait faire s'il s'exécutait, d'une lecture réversible de l'état de l'utilisateur lui-même à une action irréversible sur un tiers ou sur des fonds.
La suffisance est la part des appels dont une tâche a réellement besoin que la défense laisse passer. La rapporter aux côtés de la fuite empêche que l'une ou l'autre soit manipulée : une défense qui refuse tout ne fuit rien, et une qui autorise tout ne refuse rien de ce dont la tâche a besoin.
Deux autres nombres les accompagnent. La sur-restriction compte les appels légitimes qu'une défense refuse, et l'admission d'attaques compte les attaques dont elle autorise chaque appel de puits.
Une défense implémente une seule décision : étant donné un appel proposé et les appels déjà
exécutés, l'autoriser ou le refuser. Implémentez cela contre ajar.defenses.base, enregistrez-le,
et Ajar rapporte les quatre nombres sur les mêmes tests que voit toute autre défense.
ajar/defenses/baselines.py contient quatre procédures de référence — tout-autoriser, une
liste d'autorisation par nom d'outil, un oracle exact sur les arguments et tout-refuser — qui
bornent l'échelle aux deux extrémités et donnent à une nouvelle défense de quoi se situer entre elles.
MIT. Voir LICENSE.
