 renatus-cartesius/reconswarm
Étendez votre reconnaissance avec la puissance du cloud

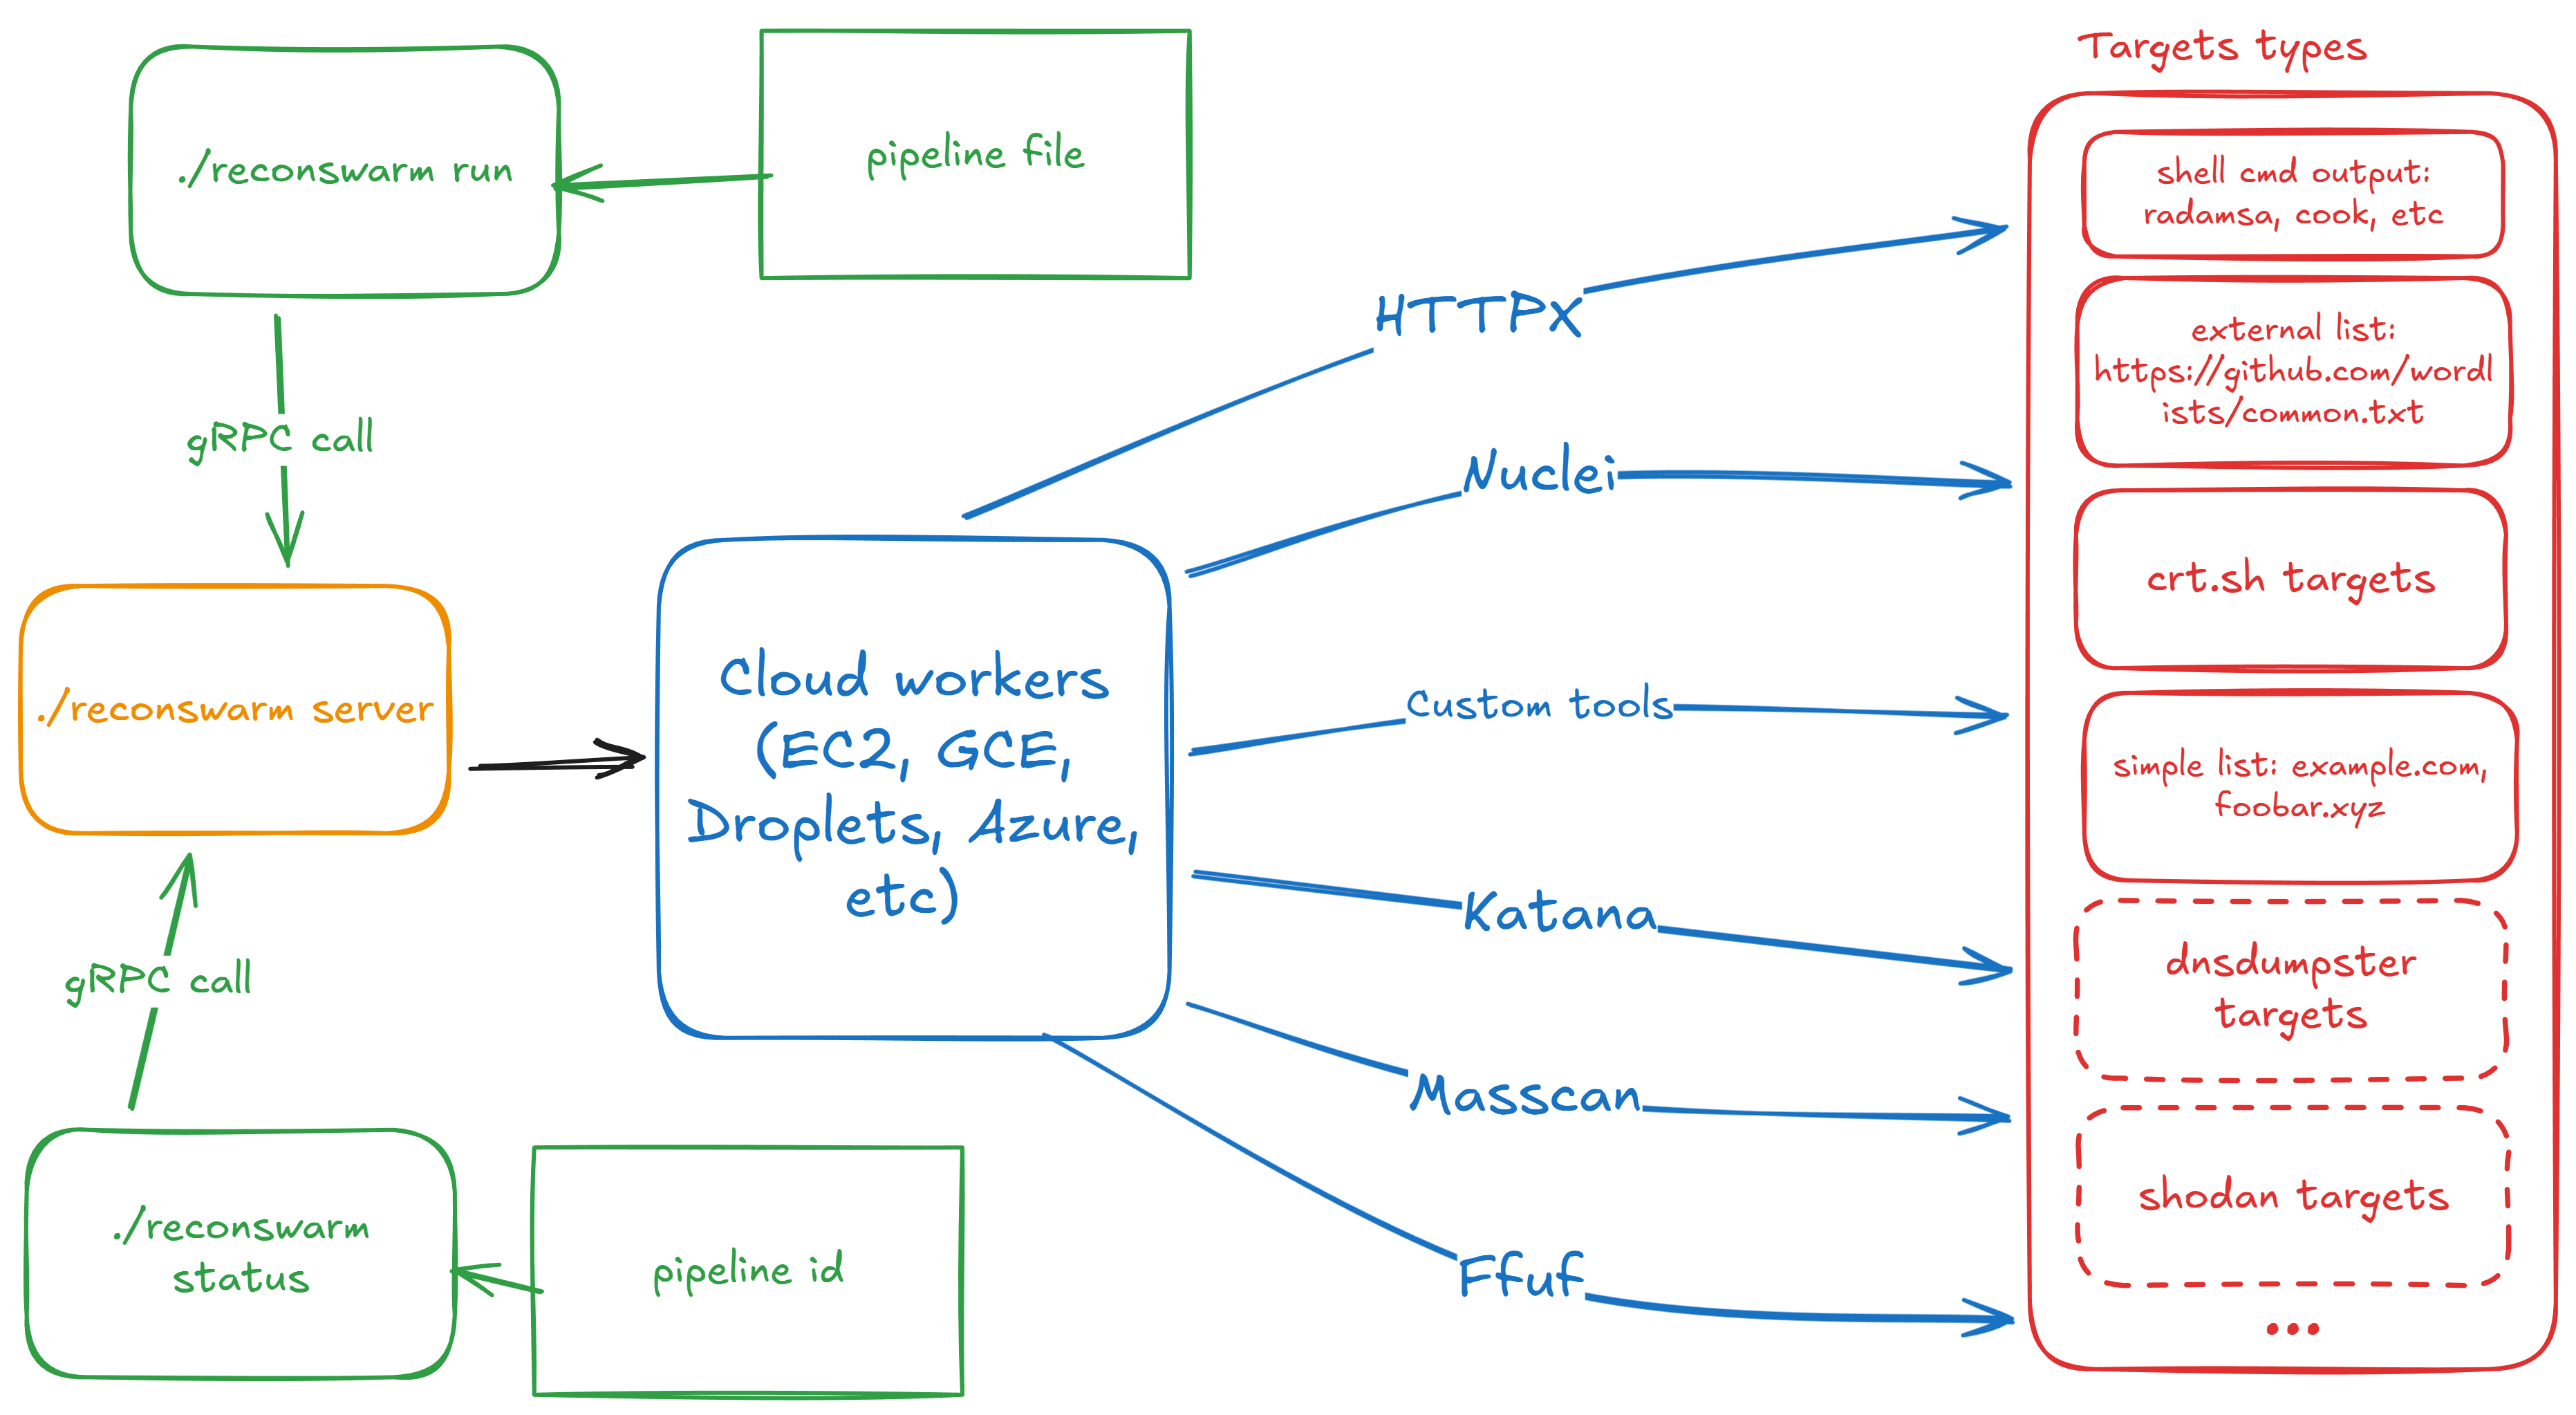
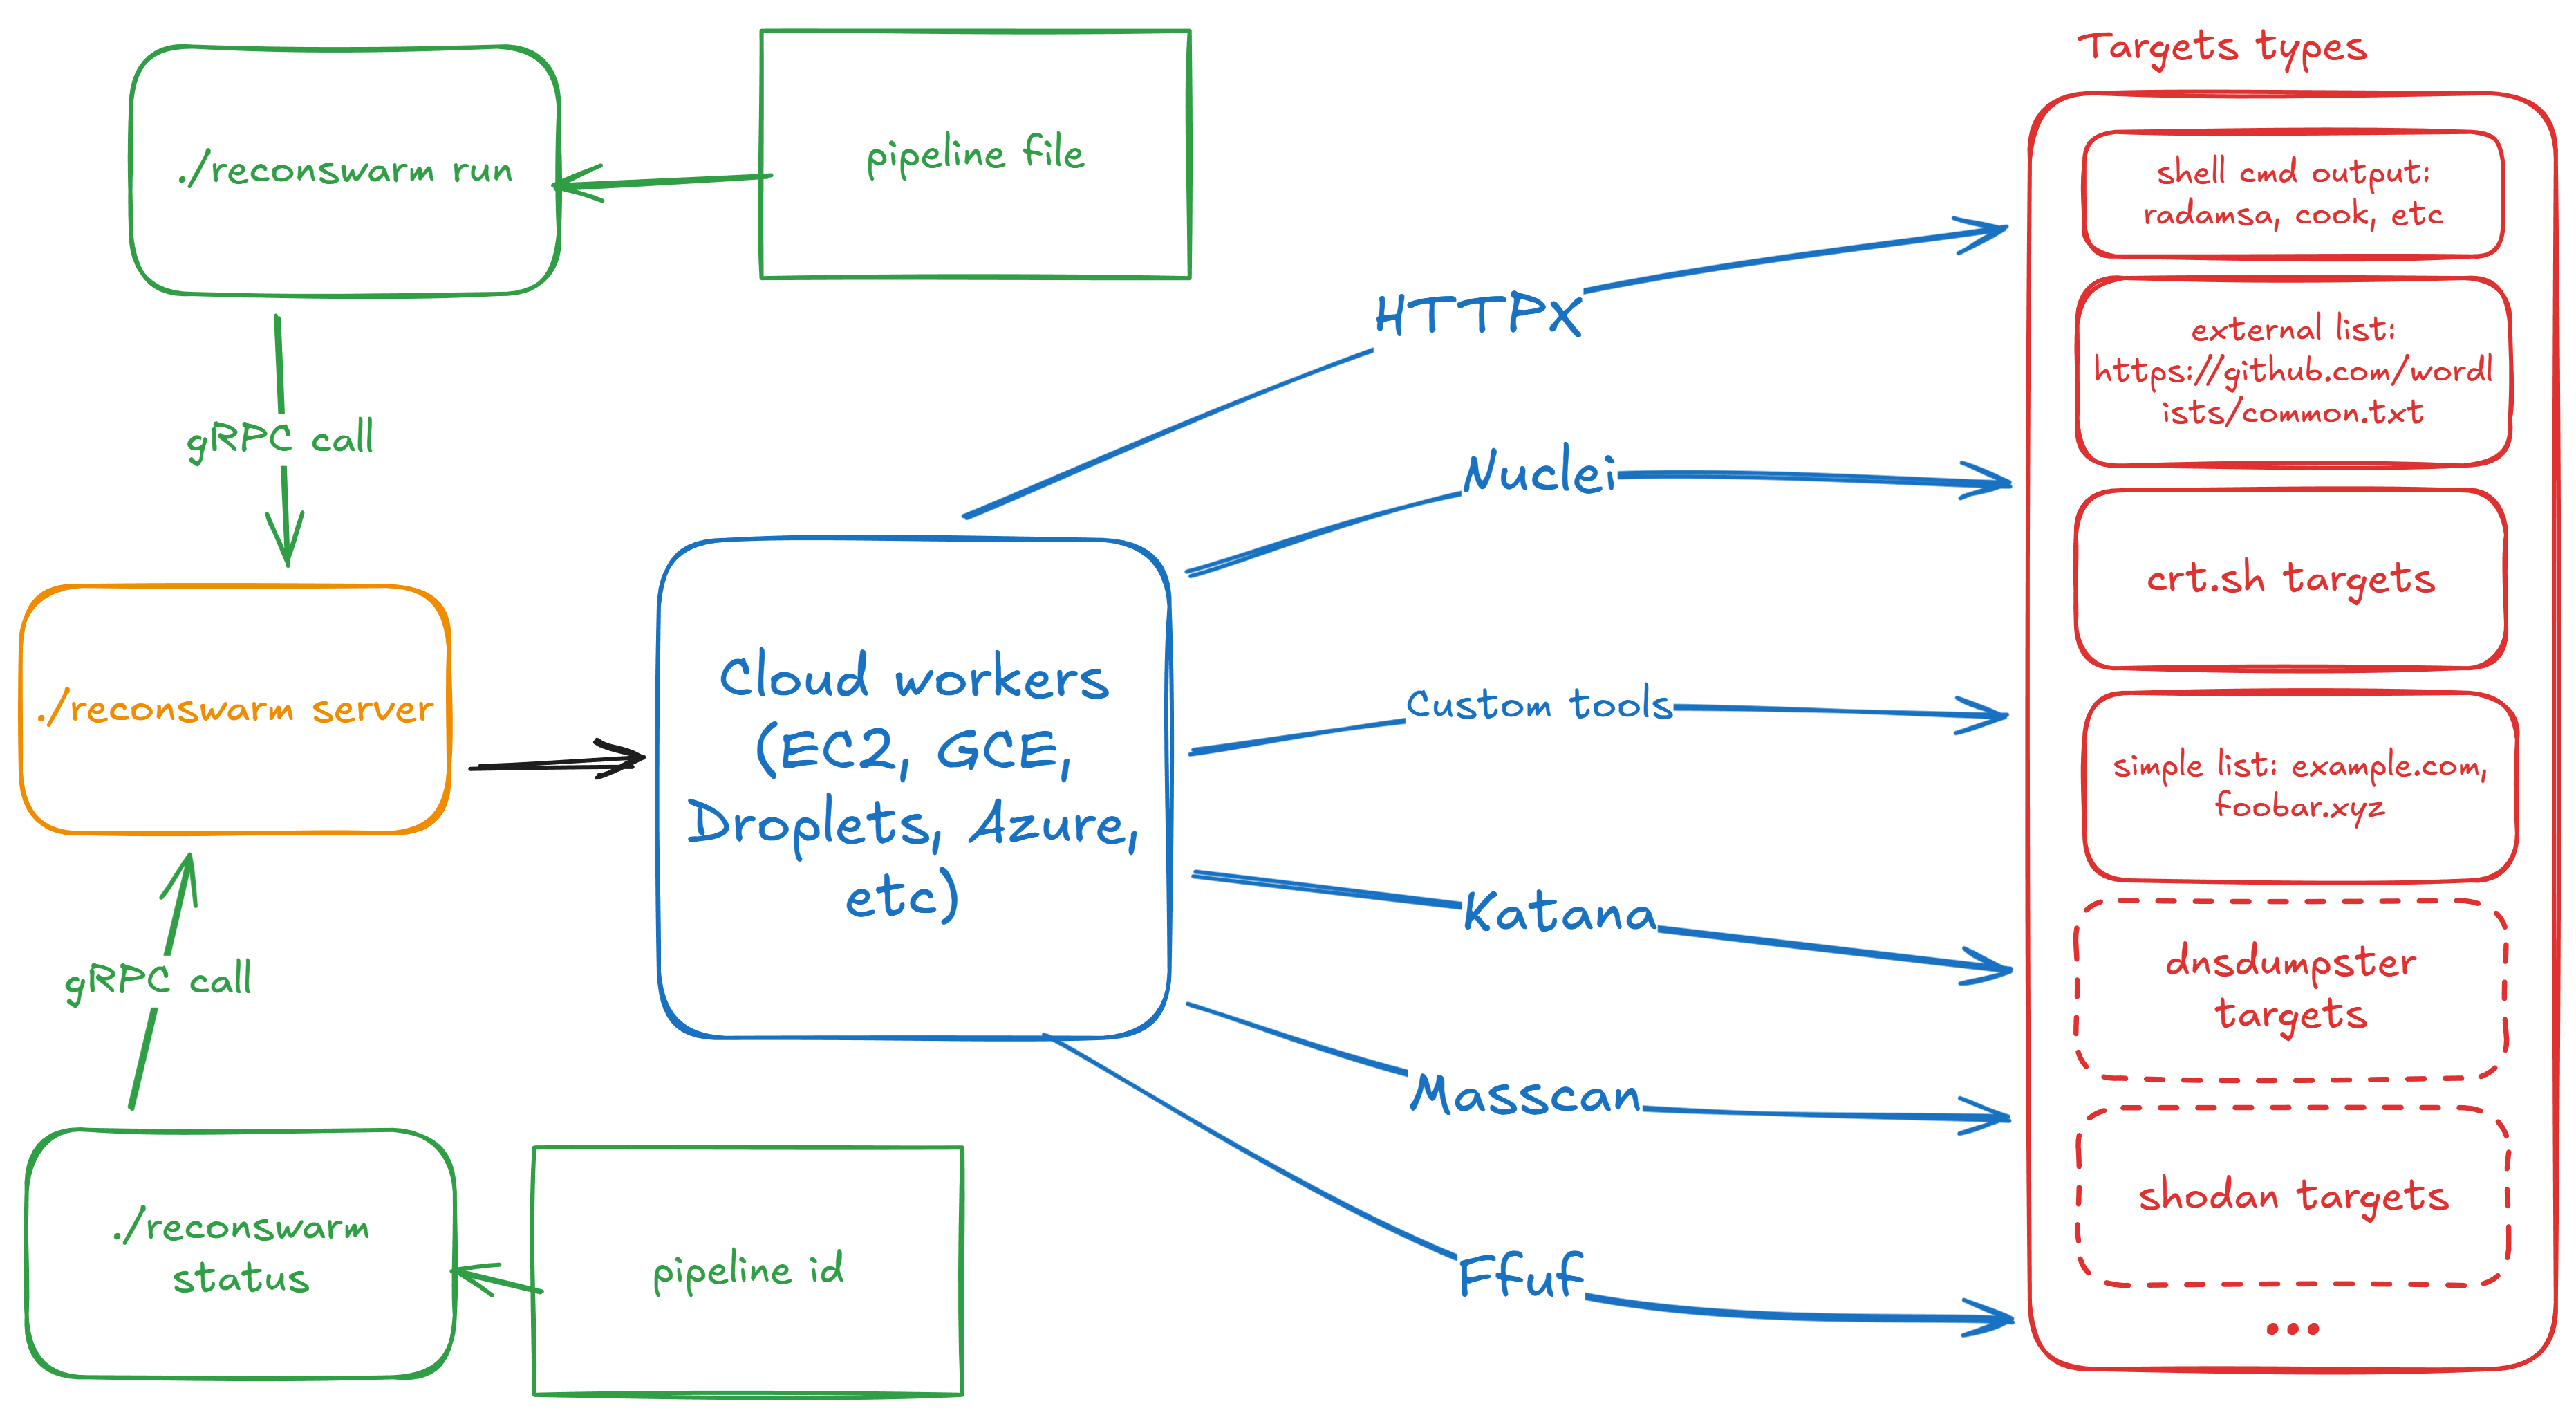
ReconSwarm est un framework modulaire d'automatisation de reconnaissance conçu pour les tests de sécurité distribués. Il provisionne une infrastructure cloud, exécute des pipelines de reconnaissance parallèles et collecte les résultats avec un minimum de configuration.
ReconSwarm est adapté aux chasseurs de bug bounty, testeurs d'intrusion, ingénieurs DevSecOps et chercheurs en sécurité qui ont besoin de workflows de reconnaissance automatisés et évolutifs sans gestion manuelle de l'infrastructure.
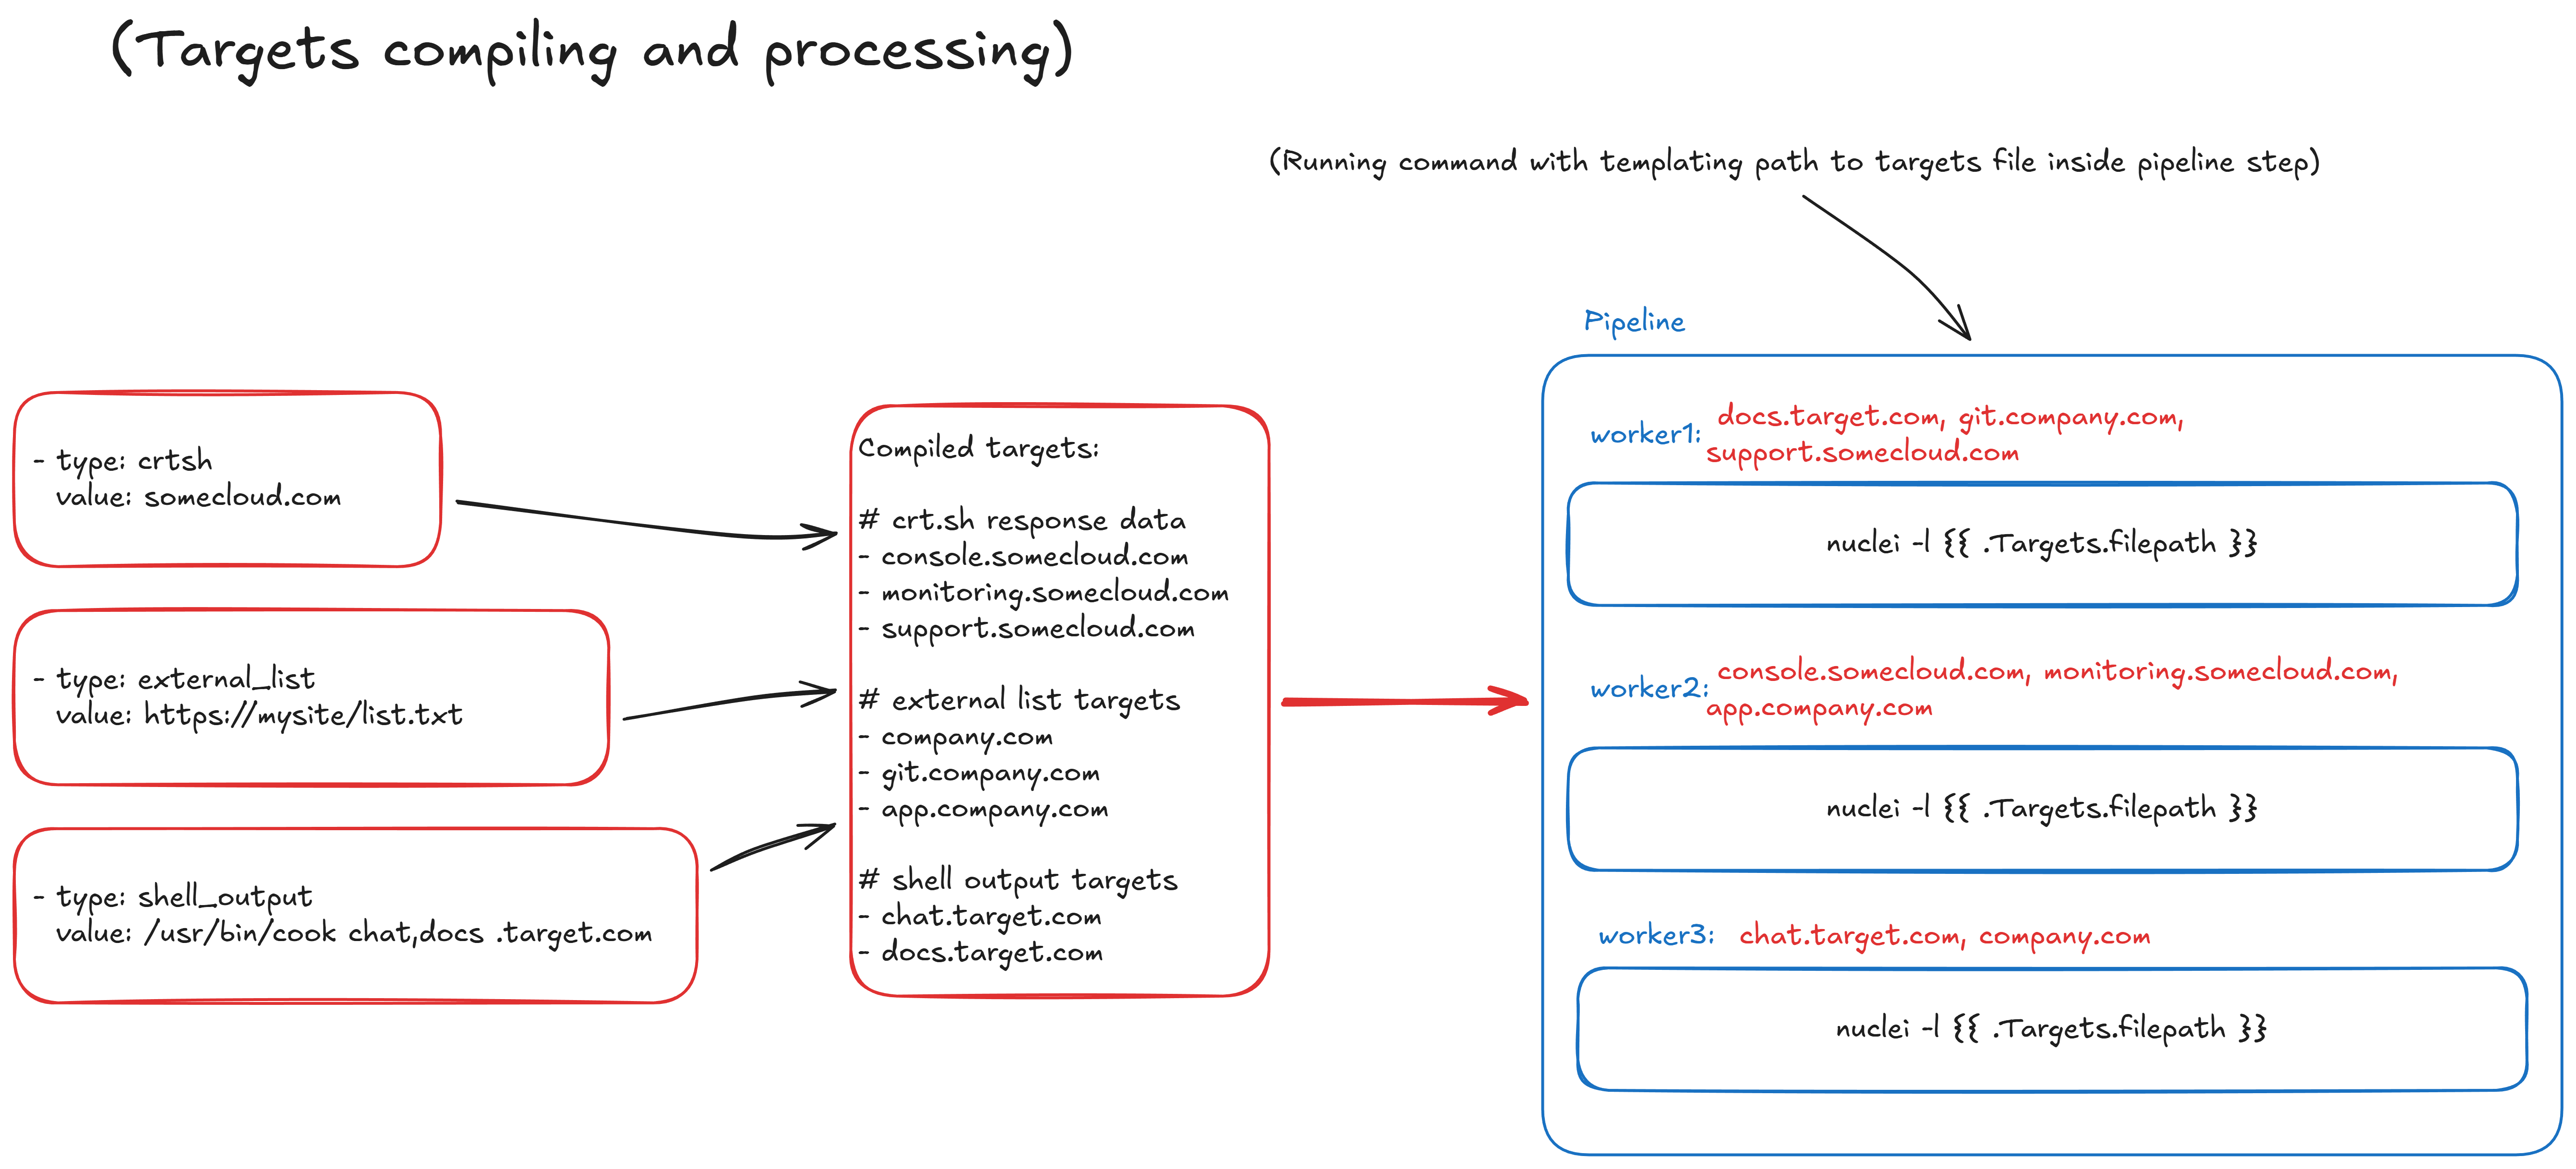
ReconSwarm suit une architecture modulaire avec une séparation claire des responsabilités entre le provisionnement cloud, le contrôle à distance du système, l'exécution des pipelines et la gestion de la configuration.
ReconSwarm utilise un modèle d'union discriminée pour les provisionneurs cloud. Le champ provisioner.type détermine quelle configuration de fournisseur est active :
provisioner:
  type: yandex_cloud  # Champ discriminant
  yandex_cloud:       # Actif lorsque type: yandex_cloud
    iam_token: "${YC_TOKEN}"
    # key_path: "./sa_auth_key.json"
    folder_id: "${YC_FOLDER_ID}"
    # ... paramètres spécifiques au fournisseur
Des fournisseurs cloud supplémentaires peuvent être intégrés en implémentant l'interface Provisioner et en ajoutant un nouveau type à la fabrique.
Les étapes sont des composants extensibles qui exécutent des opérations sur les machines virtuelles des workers :
Tous les champs des étapes prennent en charge le rendu des templates. De nouveaux types d'étapes peuvent être ajoutés pour étendre les fonctionnalités.
Le serveur ReconSwarm est complètement sans état — tout l'état est persistant dans etcd :
Cette architecture permet :
| Capacité | Description |
|---|---|
| Mise à l'échelle horizontale | Exécuter plusieurs instances de serveur derrière un répartiteur de charge |
| Redémarrages sans interruption | Redémarrer le serveur sans perdre l'état du pipeline |
| Récupération après crash | Une nouvelle instance de serveur reprend là où la précédente s'est arrêtée |
| Inspection de l'état | Interroger etcd directement pour le débogage et la surveillance |
Configuration haute disponibilité :
                    ┌─────────────┐
                    │   Client    │
                    └──────┬──────┘
                           │
                    ┌──────▼──────┐
                    │Load Balancer│
                    └──────┬──────┘
              ┌────────────┼────────────┐
              │            │            │
       ┌──────▼──────┐ ┌───▼───┐ ┌──────▼──────┐
       │  Server 1   │ │Server2│ │  Server 3   │
       └──────┬──────┘ └───┬───┘ └──────┬──────┘
              │            │            │
              └────────────┼────────────┘
                           │
                    ┌──────▼──────┐
                    │ etcd cluster│
                    └─────────────┘
Tous les serveurs partagent le même cluster etcd et peuvent traiter n'importe quelle requête. Si un serveur tombe en panne au milieu d'un pipeline, un autre serveur peut continuer l'exécution après avoir lu l'état depuis etcd.
Remarque : L'implémentation actuelle exécute les pipelines en mémoire après les avoir chargés depuis etcd. La récupération complète après crash avec reprise du pipeline est prévue pour les prochaines versions.
git clone <repository>
cd reconswarm
go mod download
task build
ReconSwarm sépare la configuration du serveur de la configuration du pipeline :
| Type de configuration | Fichier | Description |
|---|---|---|
| Serveur | reconswarm.yaml | Fournisseur cloud, etcd, paramètres du pool de workers |
| Pipeline | Fichier YAML séparé | Cibles et étapes, passé via le flag -f |
La configuration du serveur est stockée dans reconswarm.yaml (configurable via la variable d'environnement CONFIG_PATH). Toutes les valeurs de chaîne prennent en charge le développement des variables d'environnement en utilisant la syntaxe ${VAR} ou $VAR.
# Paramètres du serveur
server:
  port: 50051

# Connexion etcd pour la gestion d'état
etcd:
  endpoints:
    - "localhost:2379"
  dial_timeout: 5  # secondes
  username: ""     # optionnel, supporte ${ETCD_USER}
  password: ""     # optionnel, supporte ${ETCD_PASSWORD}

# Provisionneur cloud (union discriminée)
provisioner:
  type: yandex_cloud  # Sélecteur de fournisseur

  # Configuration Yandex Cloud (active quand type: yandex_cloud)
  yandex_cloud:
    iam_token: "${YC_TOKEN}"
    # key_path: "./sa_auth_key.json"
    folder_id: "${YC_FOLDER_ID}"
    default_zone: "ru-central1-b"
    default_image: "fd8b1cmhmncn7lt4tqn4"
    default_username: "root"
    default_cores: 2
    default_memory: 2      # GB
    default_disk_size: 20  # GB

# Paramètres du pool de workers
workers:
  max_workers: 5
  setup_commands:
    - "apt update"
    - "apt install -y docker.io"
La configuration du pipeline est stockée dans un fichier YAML séparé et passée via le flag -f. Les formats avec et sans enveloppe sont pris en charge :
