 qianlitp/crawlergo
Un puissant crawler de navigateur pour les scanners de vulnérabilités web


Un puissant crawler de navigateur pour les scanners de vulnérabilités Web
Document anglais | 中文文档
crawlergo est un crawler de navigateur qui utilise le mode chrome headless pour la collecte d'URL. Il accroche les positions clés de la page Web entière avec l'étape de rendu DOM, remplit et soumet automatiquement les formulaires, avec un déclenchement intelligent d'événements JS, et collecte autant d'entrées exposées par le site Web que possible. Le module intégré de déduplication d'URL filtre un grand nombre d'URL pseudo-statiques, maintient une vitesse d'analyse et de crawl rapide pour les grands sites Web, et obtient finalement une collection de résultats de requêtes de haute qualité.
crawlergo prend actuellement en charge les fonctionnalités suivantes :
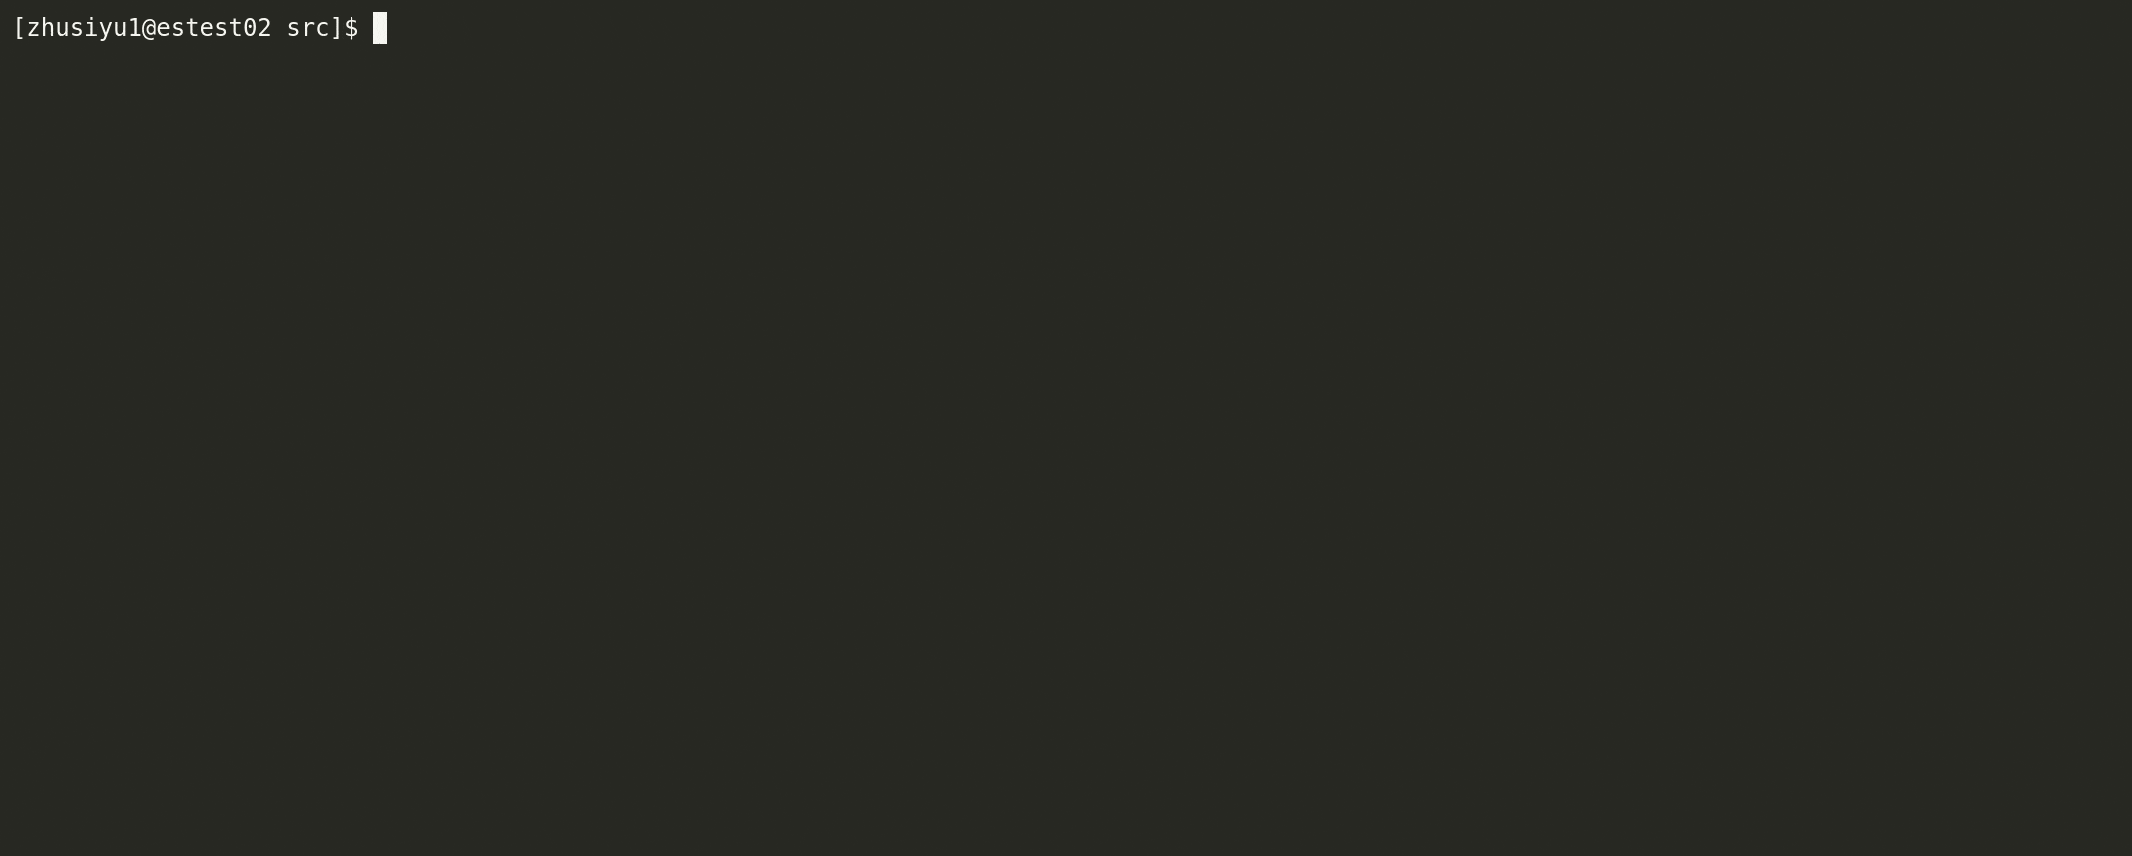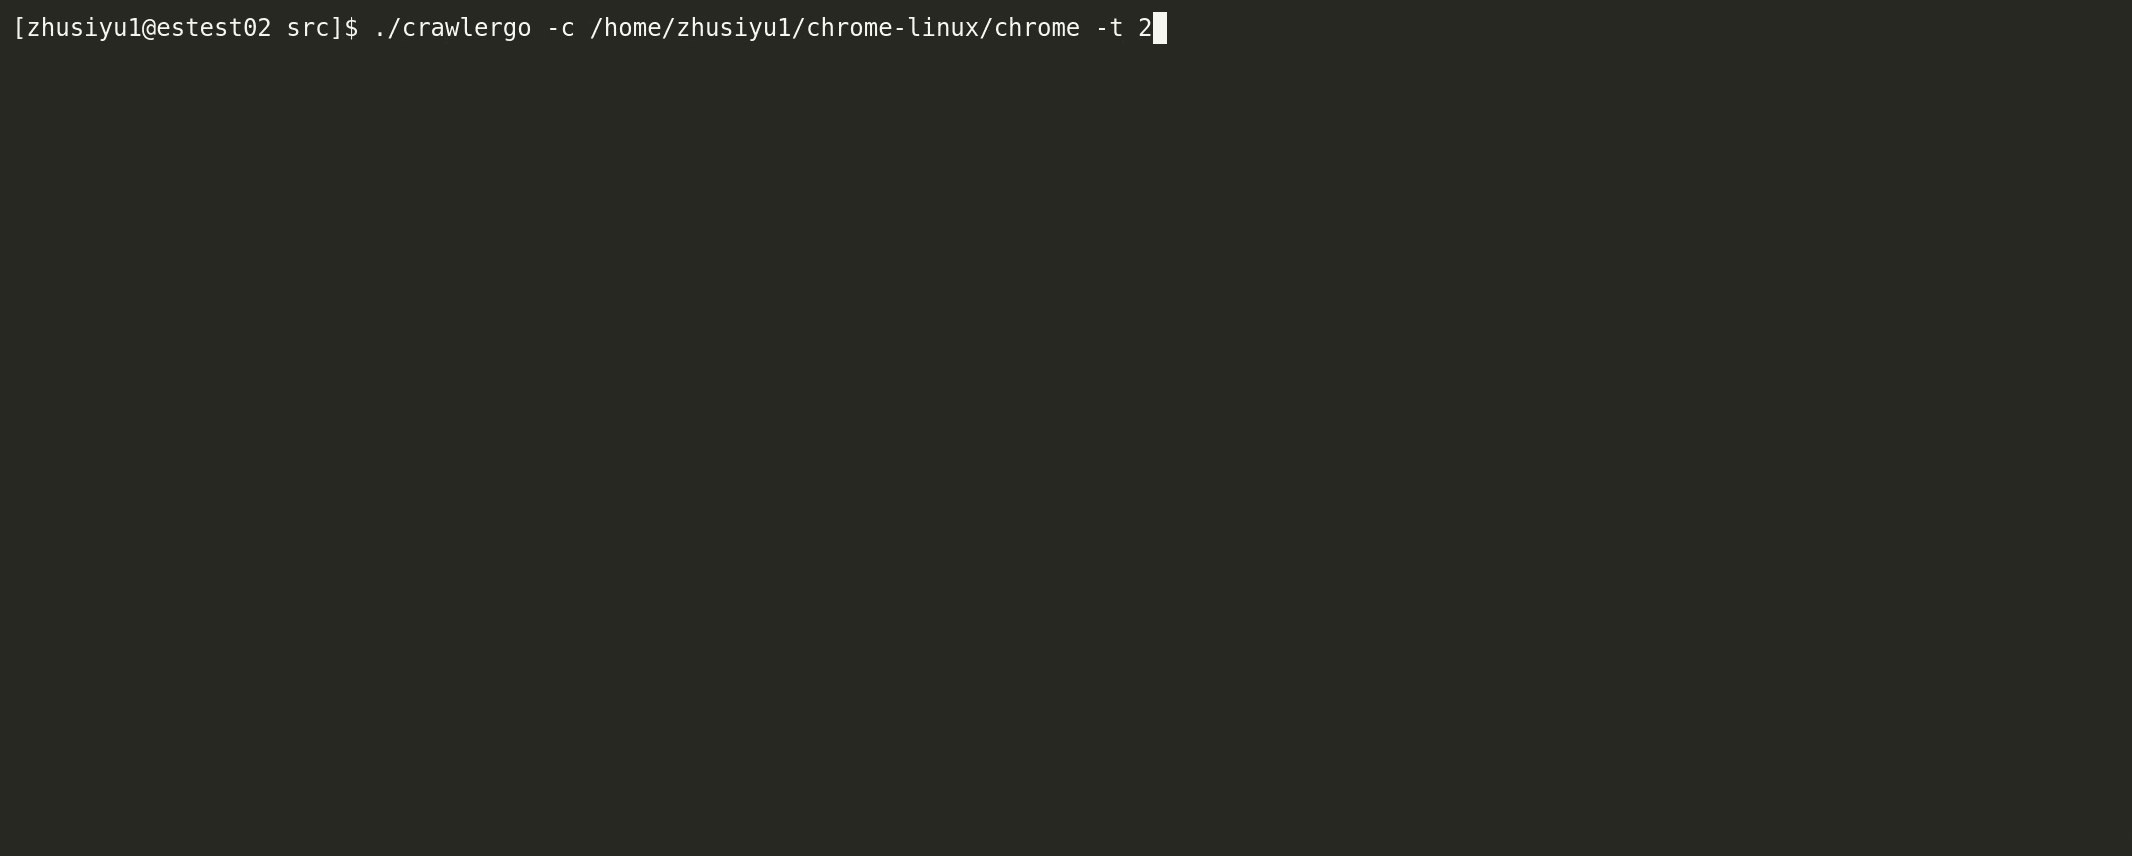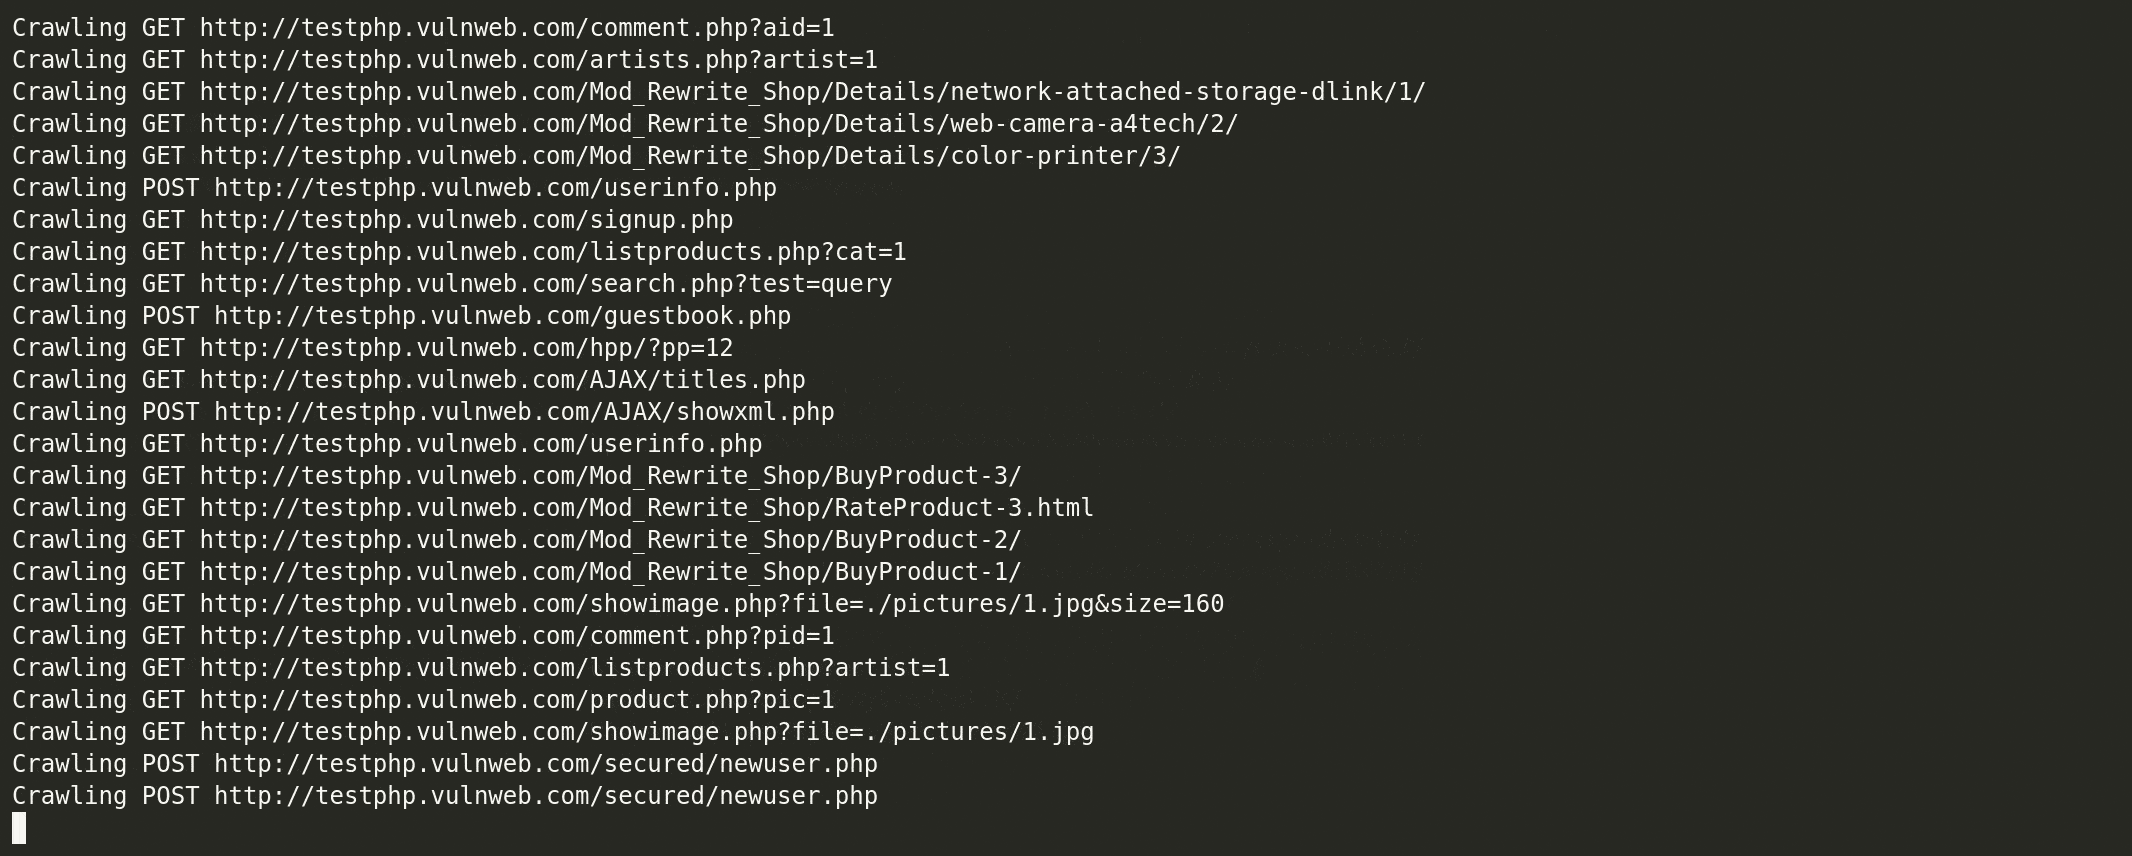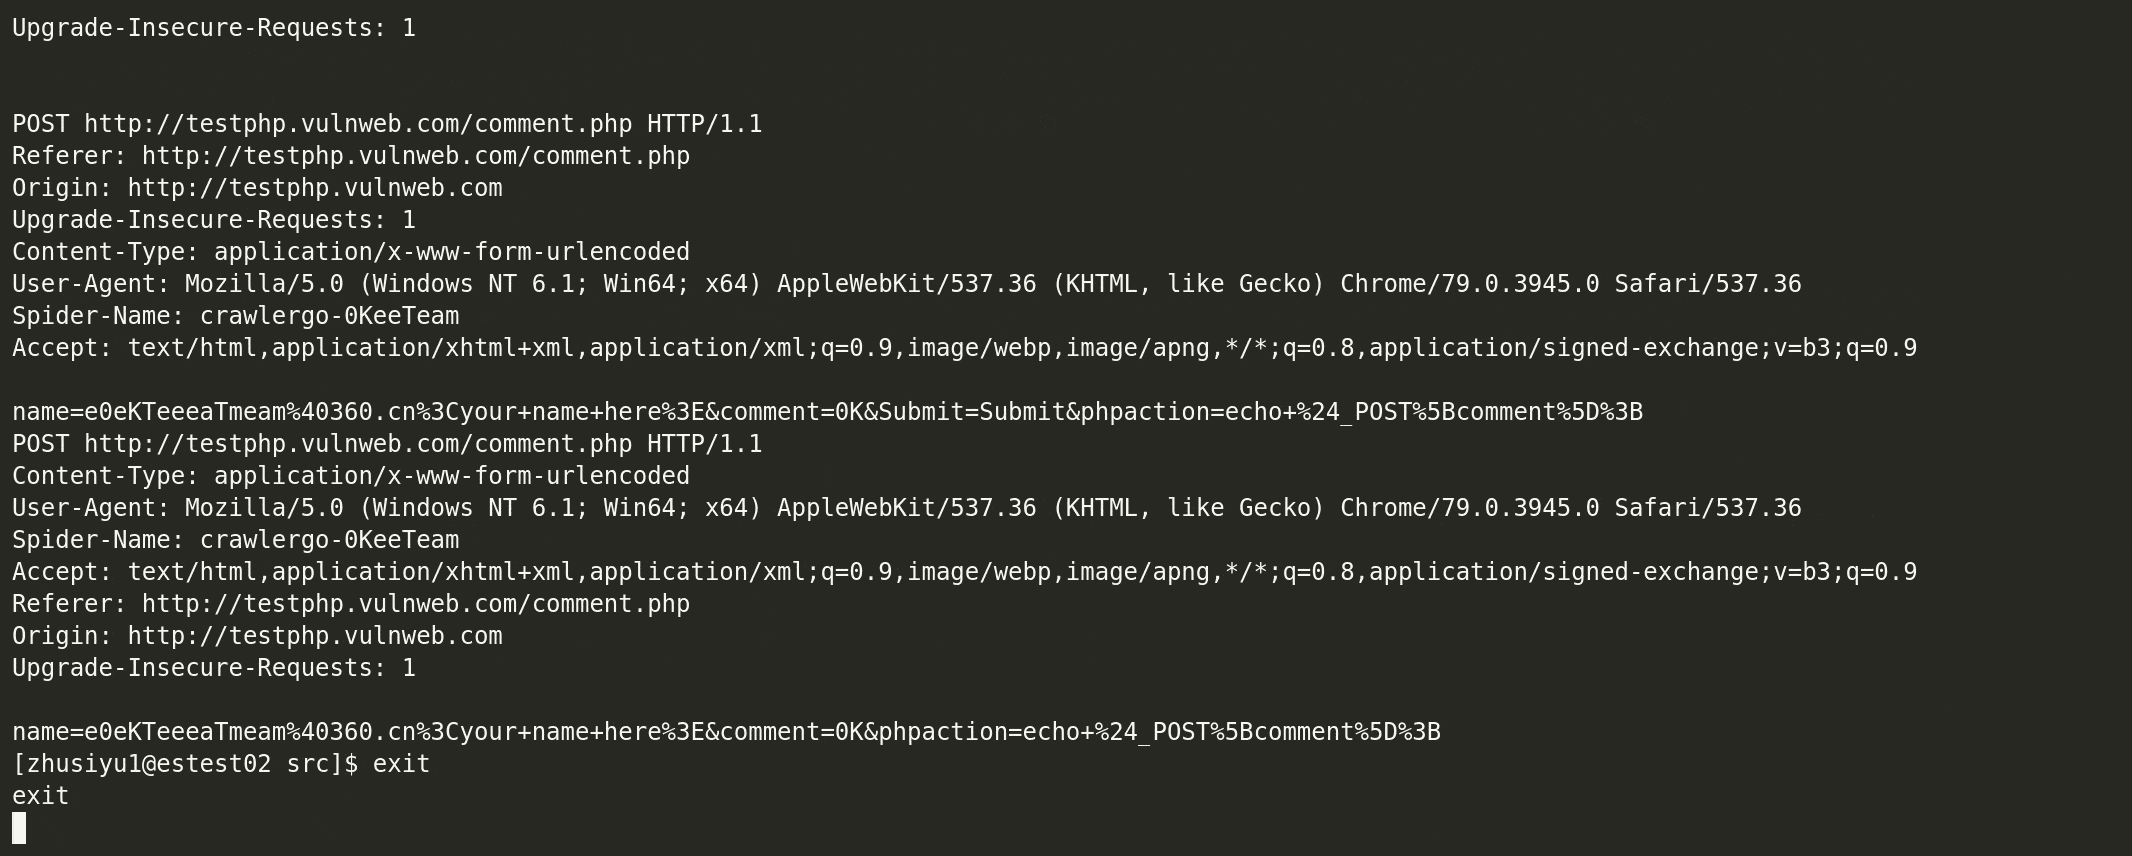
Veuillez lire et confirmer l'avertissement attentivement avant d'installer et d'utiliser.
Construire
make build
make build_all
Si vous utilisez un système Linux et que Chrome vous signale des dépendances manquantes, veuillez consulter la section Dépannage ci-dessous
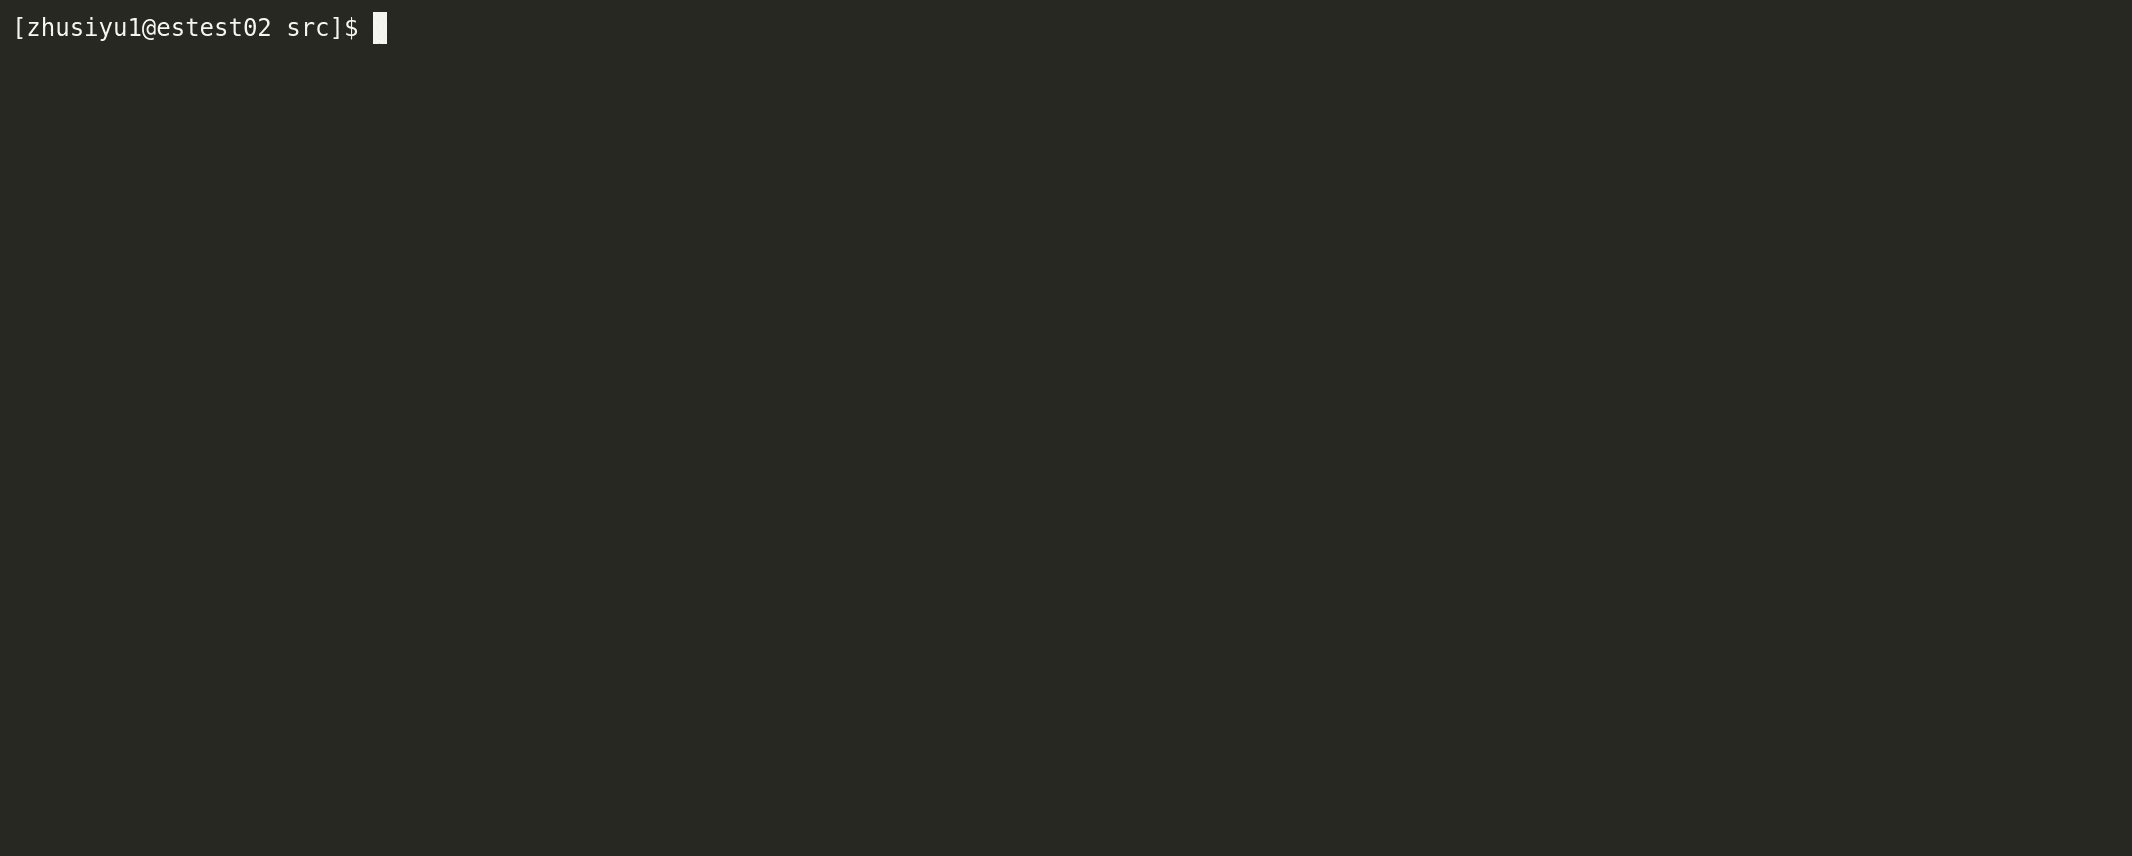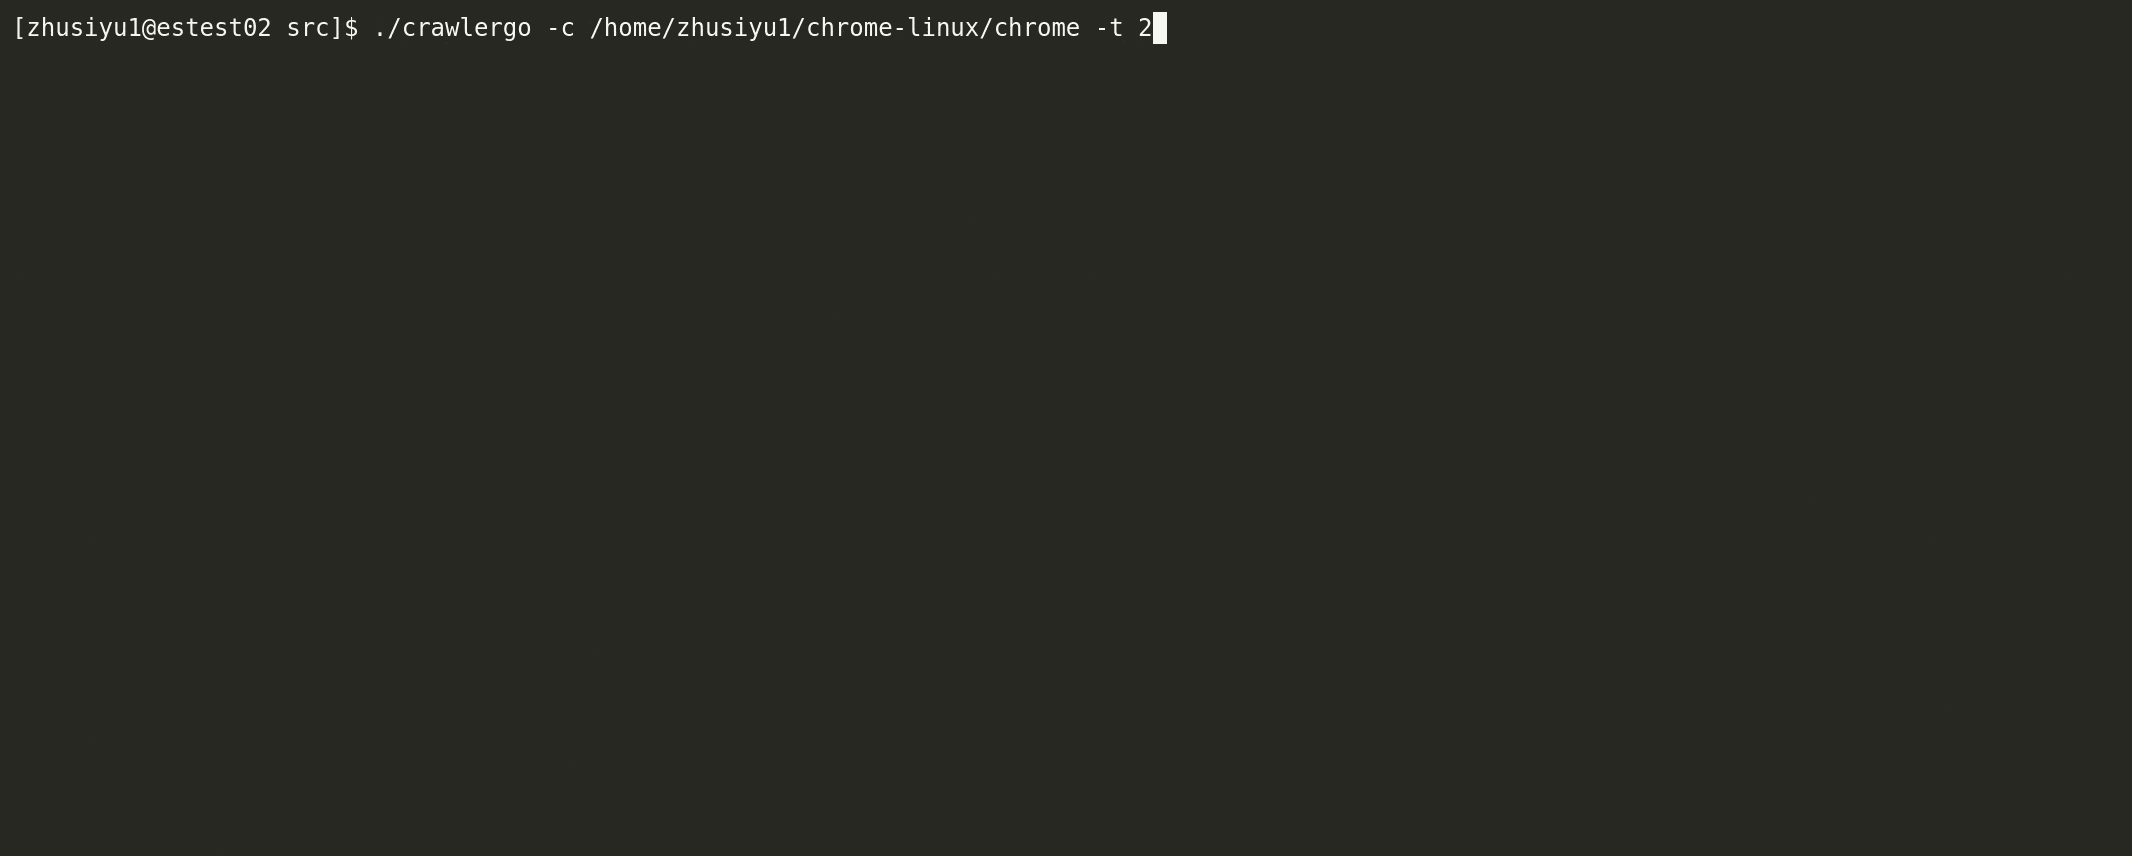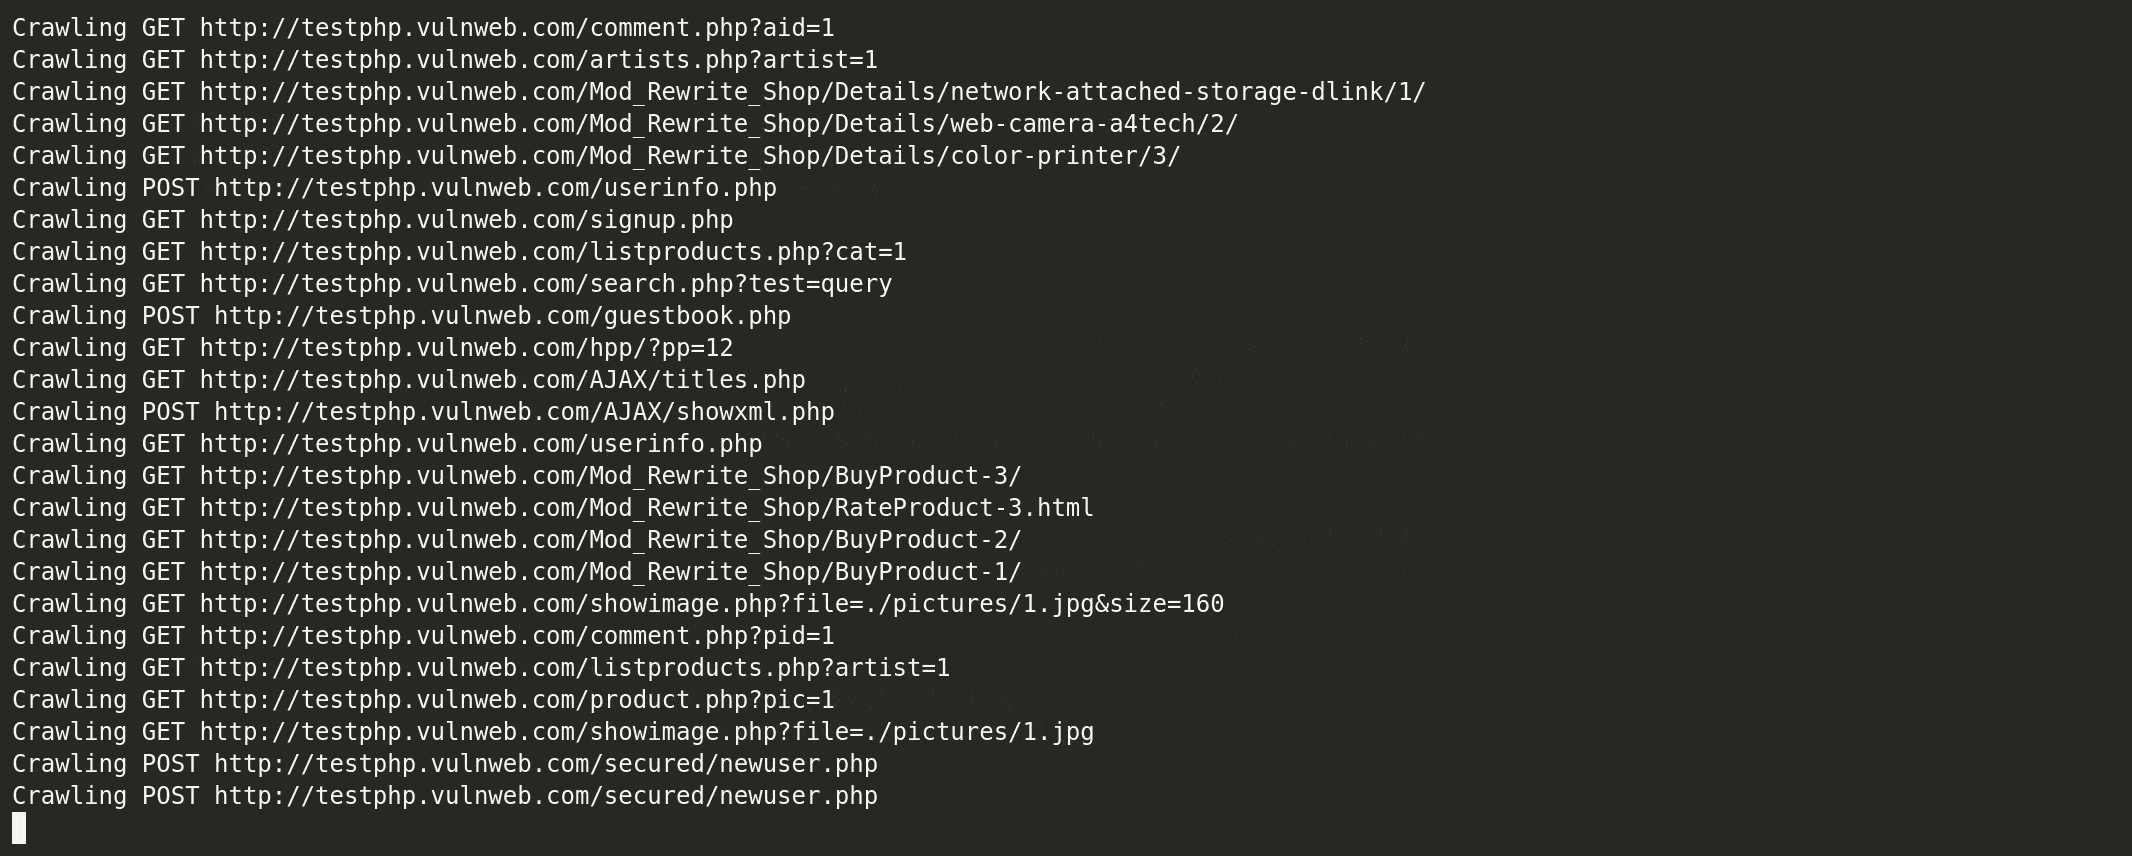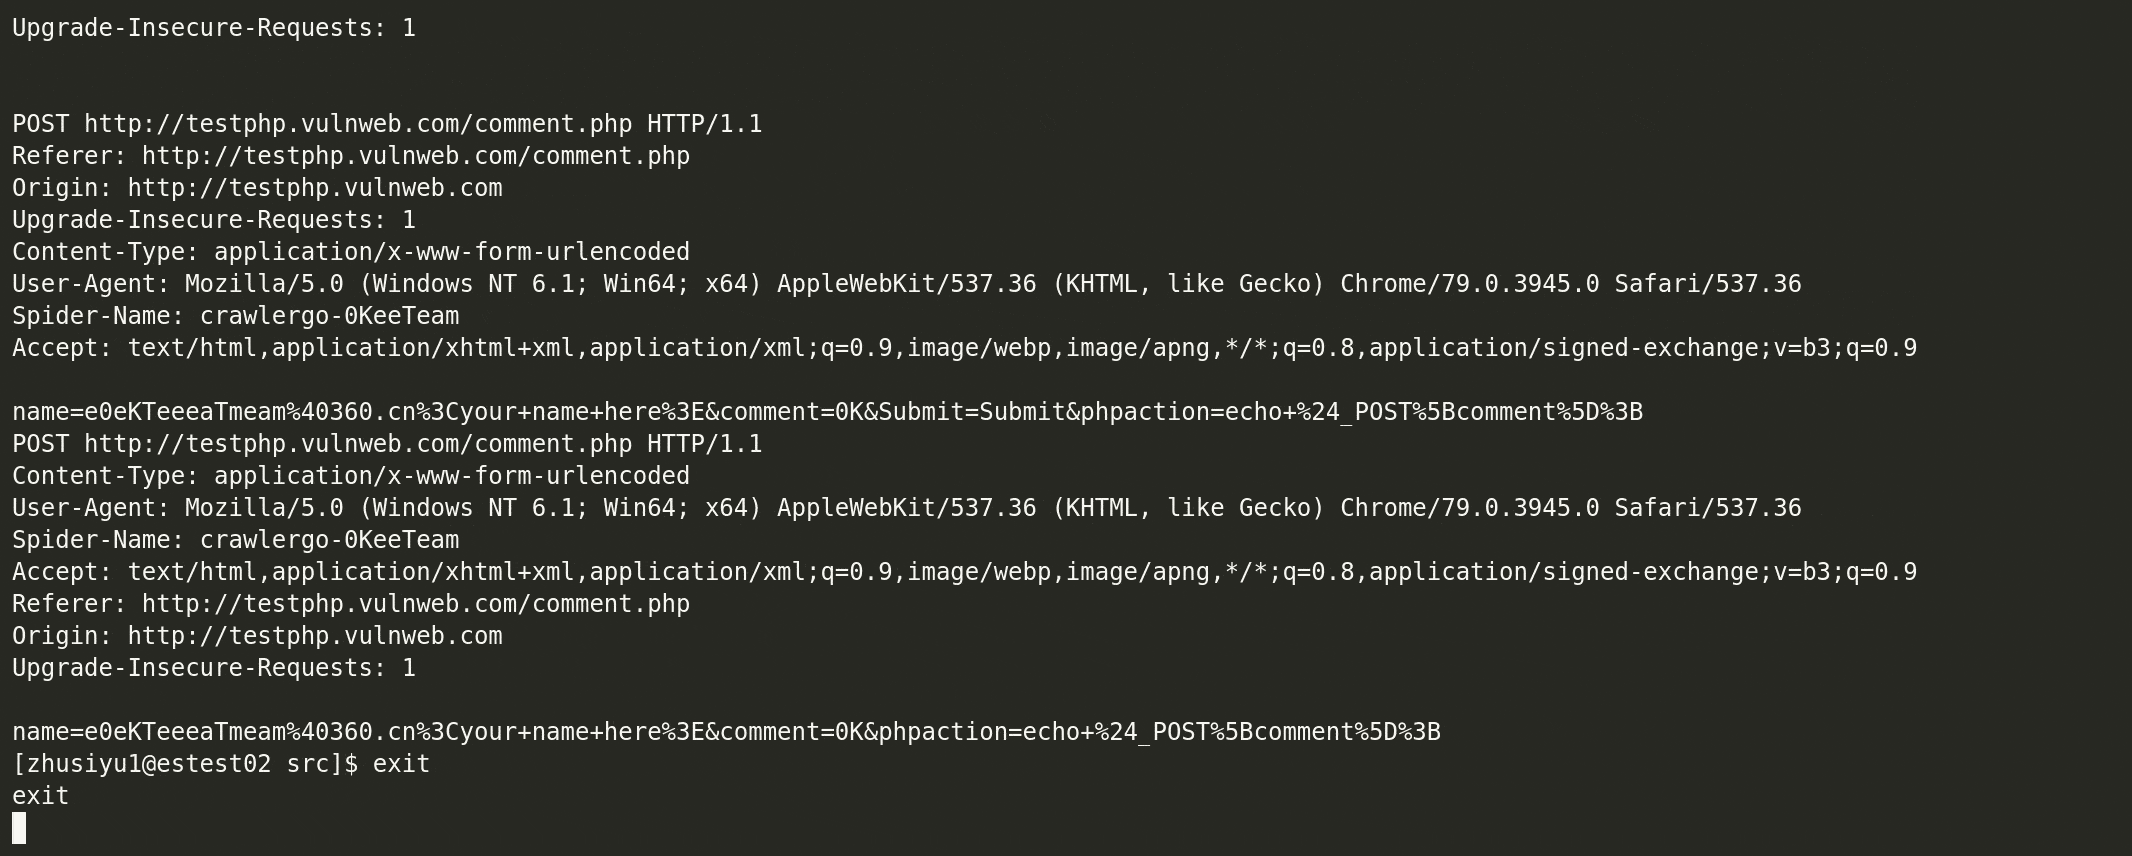
En supposant que votre répertoire d'installation de Chromium est /tmp/chromium/, configurez 10 onglets ouverts simultanément et crawlez testphp.vulnweb.com :
bin/crawlergo -c /tmp/chromium/chrome -t 10 http://testphp.vulnweb.com/
Vous pouvez également l'utiliser avec Docker sans tracas :
git clone https://github.com/Qianlitp/crawlergo
docker build . -t crawlergo
docker run crawlergo http://testphp.vulnweb.com/
bin/crawlergo -c /tmp/chromium/chrome -t 10 --request-proxy socks5://127.0.0.1:7891 http://testphp.vulnweb.com/
Par défaut, crawlergo affiche les résultats directement à l'écran. Nous définissons ensuite le mode de sortie sur json, et le code d'exemple pour l'appeler en utilisant Python est le suivant :
#!/usr/bin/python3
# coding: utf-8

import simplejson
import subprocess


def main():
    target = "http://testphp.vulnweb.com/"
    cmd = ["bin/crawlergo", "-c", "/tmp/chromium/chrome", "-o", "json", target]
    rsp = subprocess.Popen(cmd, stdout=subprocess.PIPE, stderr=subprocess.PIPE)
    output, error = rsp.communicate()
	#  "--[Mission Complete]--"  is the end-of-task separator string
    result = simplejson.loads(output.decode().split("--[Mission Complete]--")[1])
    req_list = result["req_list"]
    print(req_list[0])


if __name__ == '__main__':
    main()
Lorsque le mode de sortie est défini sur json, le résultat retourné, après désérialisation JSON, contient quatre parties :
all_req_list : Toutes les requêtes trouvées lors de cette tâche de crawl, contenant tout type de ressource provenant d'autres domaines.req_list : Retourne les résultats du domaine actuel de cette tâche de crawl, dédupliqués pseudo-statiquement, sans les liens de ressources statiques. C'est un sous-ensemble de all_req_list.all_domain_list : Liste de tous les domaines trouvés.sub_domain_list : Liste des sous-domaines trouvés.crawlergo retourne la requête complète et l'URL, ce qui peut être utilisé de diverses manières :
Utilisé en conjonction avec d'autres scanners passifs de vulnérabilités Web
Tout d'abord, démarrez un scanner passif et définissez l'adresse d'écoute sur : http://127.0.0.1:1234/
Ensuite, en supposant que crawlergo est sur la même machine que le scanner, démarrez crawlergo et définissez les paramètres :
--push-to-proxy http://127.0.0.1:1234/
Liaison d'hôte (non disponible pour les versions élevées de Chrome) (exemple)
Cookies personnalisés (exemple)
Nettoyer régulièrement les processus zombies générés par crawlergo (exemple) , contribué par @ring04h
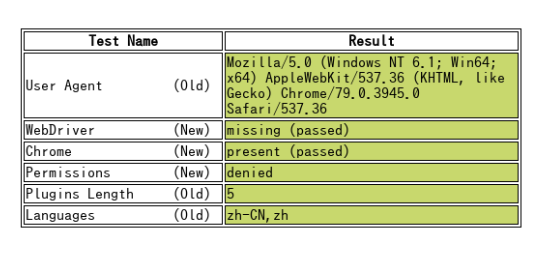
crawlergo peut contourner la détection du mode headless par défaut.
https://intoli.com/blog/not-possible-to-block-chrome-headless/chrome-headless-test.html
Erreur 'Fetch.enable' introuvable
Fetch est une fonctionnalité prise en charge par la nouvelle version de Chrome. Si cette erreur se produit, cela signifie que votre version est trop ancienne, veuillez mettre à jour votre version de Chrome.
Chrome s'exécute avec des dépendances manquantes telles que xxx.so
// Ubuntu
apt-get install -yq --no-install-recommends \
     libasound2 libatk1.0-0 libc6 libcairo2 libcups2 libdbus-1-3 \
     libexpat1 libfontconfig1 libgcc1 libgconf-2-4 libgdk-pixbuf2.0-0 libglib2.0-0 libgtk-3-0 libnspr4 \
     libpango-1.0-0 libpangocairo-1.0-0 libstdc++6 libx11-6 libx11-xcb1 libxcb1 libgbm1 \
     libxcursor1 libxdamage1 libxext6 libxfixes3 libxi6 libxrandr2 libxrender1 libxss1 libxtst6 libnss3

// CentOS 7
sudo yum install pango.x86_64 libXcomposite.x86_64 libXcursor.x86_64 libXdamage.x86_64 libXext.x86_64 libXi.x86_64 \
     libXtst.x86_64 cups-libs.x86_64 libXScrnSaver.x86_64 libXrandr.x86_64 GConf2.x86_64 alsa-lib.x86_64 atk.x86_64 gtk3.x86_64 \
     ipa-gothic-fonts xorg-x11-fonts-100dpi xorg-x11-fonts-75dpi xorg-x11-utils xorg-x11-fonts-cyrillic xorg-x11-fonts-Type1 xorg-x11-fonts-misc -y

sudo yum update nss -y
Invite d'exécution Délai d'expiration de navigation / navigateur non trouvé / ne connaît pas le chemin d'exécution du navigateur correct
Assurez-vous que le chemin d'exécution du navigateur est correctement configuré, tapez : chrome://version dans la barre d'adresse, et trouvez le chemin du fichier exécutable :
