 pvharmo2/gha-lab-e8902eccd3
Laboratoire de recherche en sécurité : reproduction de CVE-2025-52467 (exécution de code du workflow pull_request_target de pgai / exfiltration de GITHUB_TOKEN) — instantané de timescale/pgai

Artéfact de recherche automatisé — pas le projet en amont.
Ce dépôt est un laboratoire jetable construit par un harnais automatisé pour un mémoire de maîtrise à l'Université Laval sur la reproduction de vulnérabilités publiées dans les workflows GitHub Actions. Il s'agit d'un instantané verbatim de
timescale/pgaiau commit2a209b058c60823b57e8b7775b10244ff340eb8b(2025-05-14), redistribué sous la licence propre de ce projet, dont le fichier est inclus inchangé dans cet instantané.Le projet en amont n'est pas impliqué, n'est jamais ciblé, et la vulnérabilité étudiée ici est déjà publique. Chaque secret et variable dans ce dépôt est une valeur factice générée aléatoirement — aucun identifiant réel n'est présent. Les références d'actions et les images d'exécuteurs sont épinglées à ce qu'elles résolvaient au 2025-05-14 ; voir
pinning.mddans la sortie du harnais pour chaque modification apportée à l'instantané.Questions ou objections : [email protected]
Une bibliothèque Python qui transforme PostgreSQL en un moteur de récupération robuste et prêt pour la production, destiné aux applications RAG et Agentiques.
🔄 Créez et synchronisez automatiquement des embeddings vectoriels à partir de données PostgreSQL et de documents S3. Les embeddings se mettent à jour automatiquement lorsque les données changent.
🔍 Recherche vectorielle et sémantique puissante avec pgvector et pgvectorscale.
🛡️ Prêt pour la production dès le départ : prend en charge le traitement par lots pour une génération efficace d'embeddings, avec une gestion intégrée des pannes de modèle, des limites de débit et des pics de latence.
🐘 Fonctionne avec n'importe quelle base de données PostgreSQL, y compris Timescale Cloud, Amazon RDS, Supabase et plus encore.
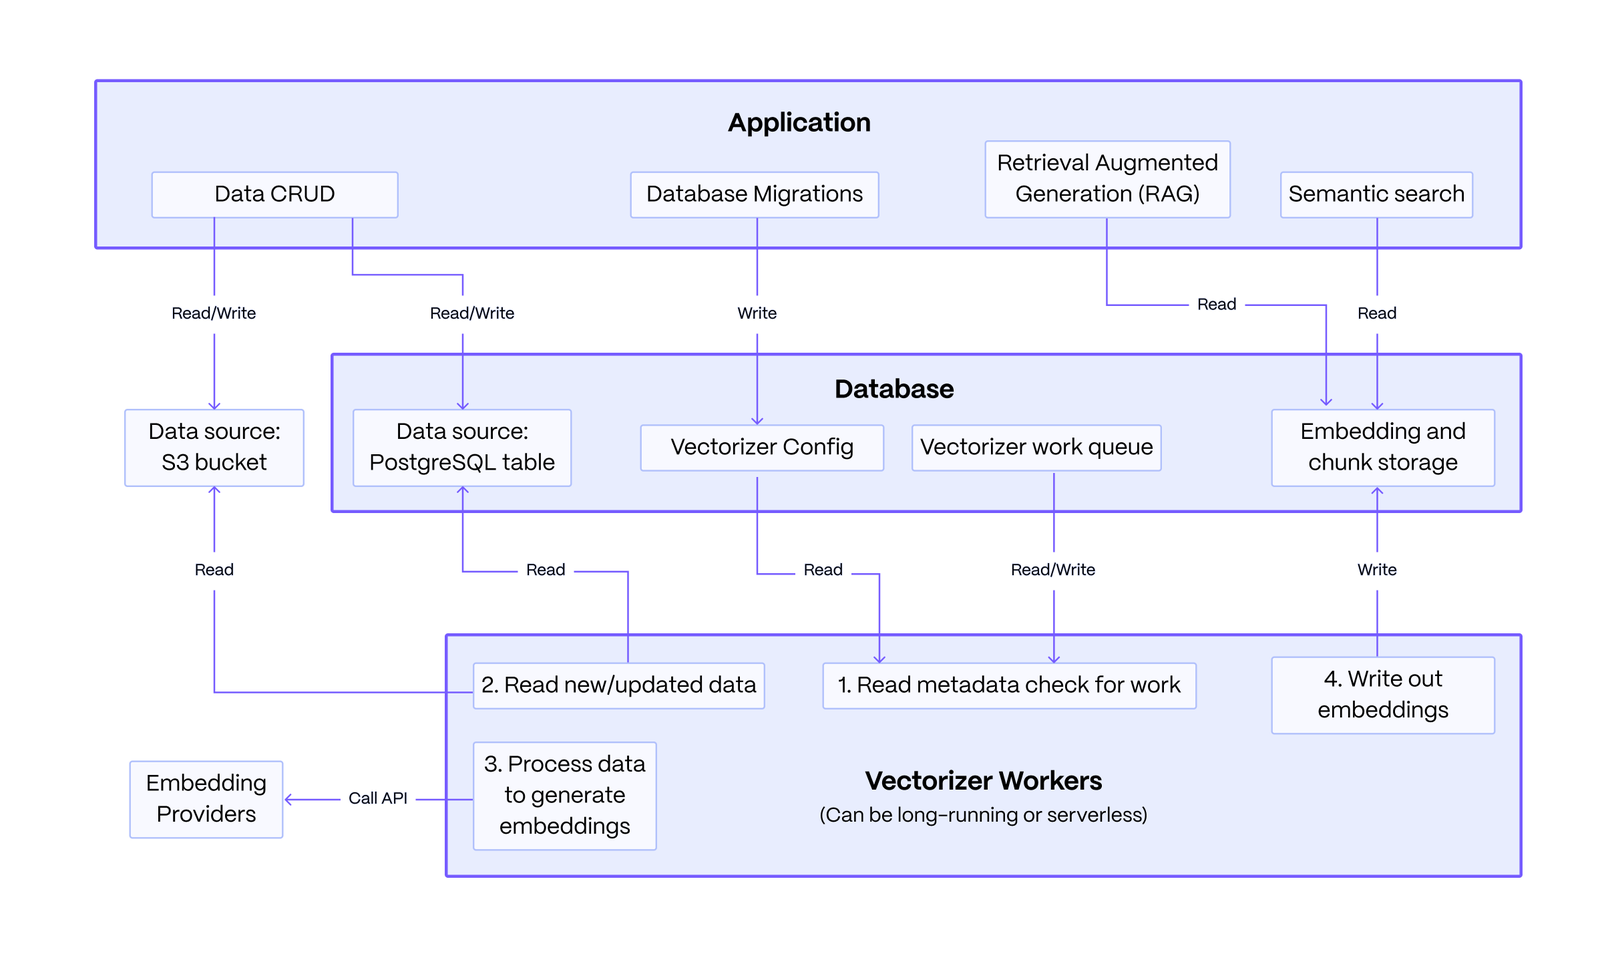
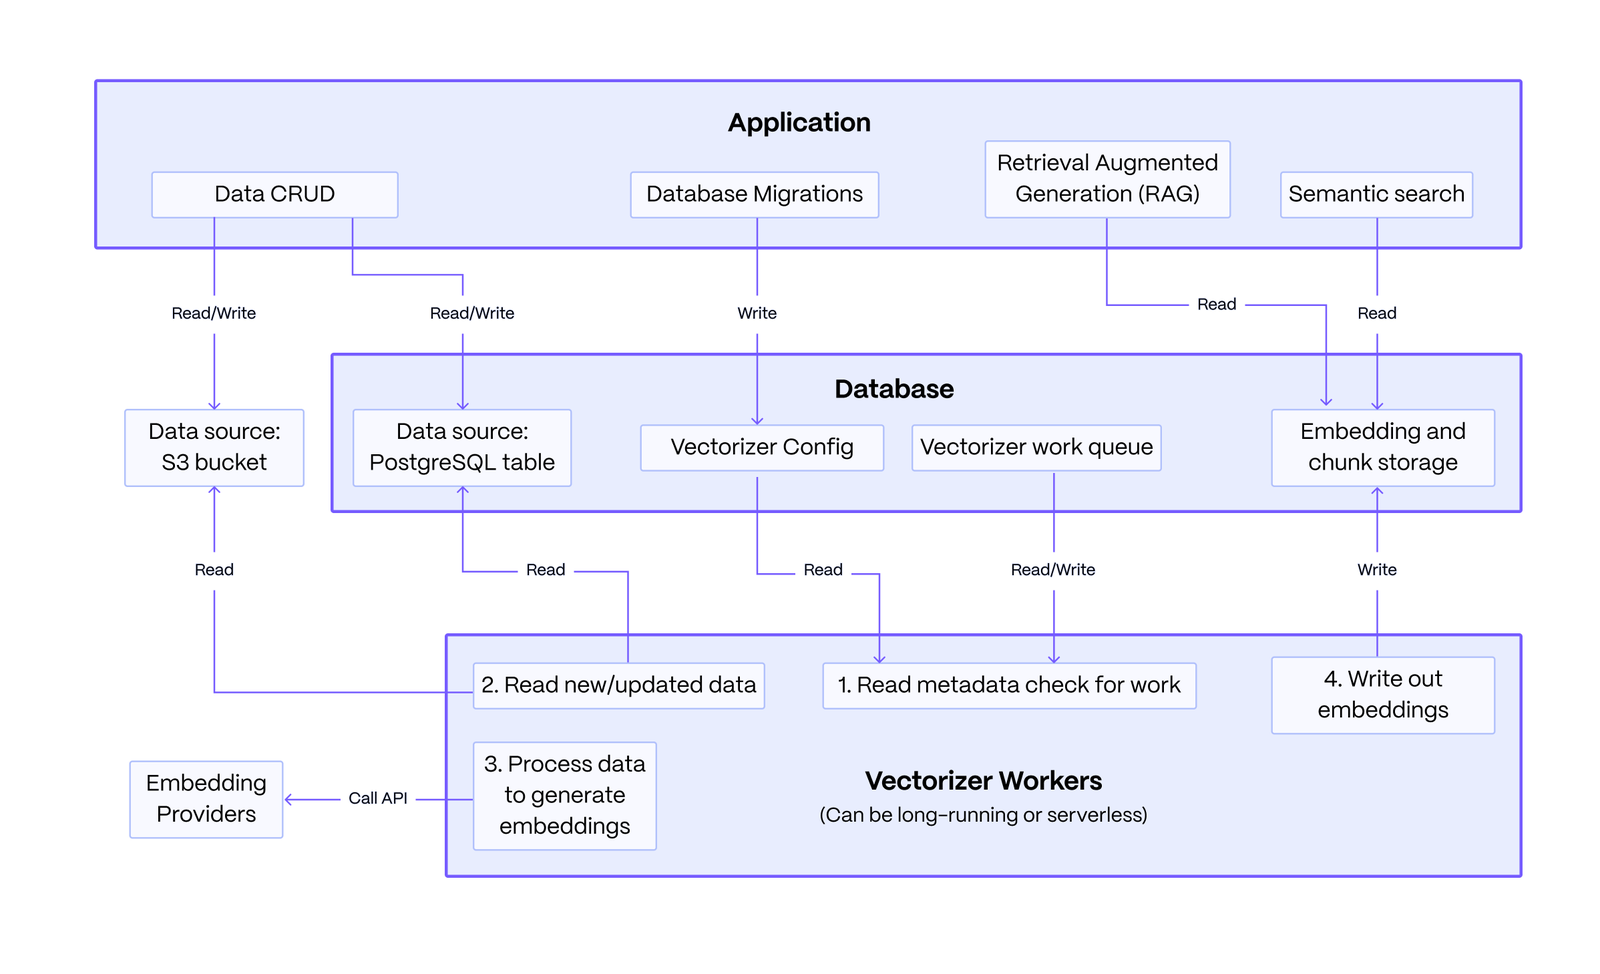
Architecture de base : Le système se compose d'une application que vous écrivez, d'une base de données PostgreSQL et de workers vectoriseurs sans état. L'application définit une configuration de vectoriseur pour intégrer des données provenant de sources telles que PostgreSQL ou S3. Les workers lisent cette configuration, traitent la file de données en embeddings et en texte découpé en morceaux, puis réécrivent les résultats. L'application interroge ensuite ces données pour alimenter la recherche RAG et sémantique.
La force clé de cette architecture réside dans sa résilience : les modifications de données effectuées par l'application sont découplées du processus d'embedding, garantissant que les pannes du service d'embedding n'affectent pas les opérations de données principales.
Tout d'abord, installez le paquet pgai.``` pip install pgai
Ensuite, installez les composants de base de données pgai. Vous pouvez le faire depuis le terminal à l'aide de la CLI ou dans le code de votre application Python à l'aide du package Python pgai.```
# from the cli
pgai install -d <database-url>

# or from the python package, often done as part of your application setup
import pgai
pgai.install(DB_URL)
Ce guide de démarrage rapide montre comment pgai Vectorizer permet la recherche sémantique et le RAG sur les données PostgreSQL en créant et synchronisant automatiquement les embeddings à mesure que les données changent.
L'ingrédient clé de pgai Vectorizer réside dans son approche déclarative de la génération d'embeddings. Définissez simplement votre pipeline et laissez Vectorizer gérer la complexité opérationnelle du maintien de la synchronisation des embeddings, même lorsque les points de terminaison d'embedding ne sont pas fiables. Vous pouvez définir une version simple du pipeline comme suit :```sql CREATE TABLE IF NOT EXISTS wiki ( id INTEGER PRIMARY KEY GENERATED ALWAYS AS IDENTITY, url TEXT NOT NULL, title TEXT NOT NULL, text TEXT NOT NULL )
SELECT ai.create_vectorizer( 'wiki'::regclass, loading => ai.loading_column(column_name=>'text'), destination => ai.destination_table(target_table=>'wiki_embedding_storage'), embedding => ai.embedding_openai(model=>'text-embedding-ada-002', dimensions=>'1536') )
Le vectoriseur créera automatiquement des embeddings pour toutes les lignes de la
table `wiki` et, plus important encore, maintiendra ces embeddings synchronisés avec
les données sous-jacentes lorsqu'elles changent. **Considérez-le presque comme la déclaration d'un index** sur
la table `wiki`, mais au lieu que la base de données gère la structure de données de l'index
pour vous, le Vectoriseur gère les embeddings.

## Exécution du démarrage rapide

**Prérequis :**
- Une base de données PostgreSQL ([instructions Docker](https://docs.timescale.com/self-hosted/latest/install/installation-docker/)).
- Une clé API OpenAI (nous utilisons openai pour l'embedding dans le démarrage rapide, mais vous pouvez utiliser [plusieurs fournisseurs](#supported-embedding-models)).

Créez un fichier `.env` avec le contenu suivant :```
OPENAI_API_KEY=<your-openai-api-key>
DB_URL=<your-database-url>
Vous pouvez télécharger le code Python complet et le requirements.txt depuis l’exemple de démarrage rapide et l’exécuter dans le même répertoire que le fichier .env.
