 nvidia-nemo/guardrails
Garde-fous programmables pour les applications de chat LLM : appliquer des rails d'entrée/sortie, bloquer les jailbreaks et les injections de prompt, détecter les hallucinations et masquer les données sensibles.



DERNIÈRE VERSION PUBLIÉE / VERSION DE DÉVELOPPEMENT : La branche develop suit les derniers développements en cours. La dernière version publiée est la 0.24.1.
✨✨✨
📌 La documentation officielle de la bibliothèque NeMo Guardrails est disponible sur docs.nvidia.com/nemo/guardrails.
✨✨✨
La bibliothèque NVIDIA NeMo Guardrails est une boîte à outils open source permettant d'ajouter facilement des garde-fous programmables aux applications conversationnelles basées sur des LLM. Les garde-fous (ou « rails » en abrégé) sont des moyens spécifiques de contrôler la sortie d'un grand modèle de langage, comme ne pas parler de politique, répondre d'une manière particulière à des demandes spécifiques des utilisateurs, suivre un chemin de dialogue prédéfini, utiliser un style de langage particulier, extraire des données structurées, et plus encore.
Cet article présente la bibliothèque NeMo Guardrails et contient un aperçu technique du système ainsi que l'évaluation actuelle.
Python 3.10, 3.11, 3.12 ou 3.13.
Pour installer avec pip :```bash
pip install nemoguardrails
Pour des instructions plus détaillées, consultez le [Guide d'installation](https://docs.nvidia.com/nemo/guardrails/get-started/installation-guide).

## Aperçu

<!-- start-documentation-reuse -->

La bibliothèque NeMo Guardrails permet aux développeurs qui créent des applications basées sur des LLM d'ajouter des **garde-fous programmables** entre le code de l'application et le LLM.

<div align="center">
  <img src="https://raw.githubusercontent.com/NVIDIA-NeMo/Guardrails/develop/docs/_static/images/programmable_guardrails.png"  width="75%" alt="Programmable Guardrails">
</div>

Les principaux avantages de l'ajout de *garde-fous programmables* incluent :

- **Créer des applications basées sur des LLM dignes de confiance, sûres et sécurisées :** vous pouvez définir des rails pour guider et protéger les conversations ; vous pouvez choisir de définir le comportement de votre application basée sur un LLM sur des sujets spécifiques et l'empêcher de s'engager dans des discussions sur des sujets indésirables.

- **Connecter des modèles, des chaînes et d'autres services de manière sécurisée :** vous pouvez connecter un LLM à d'autres services (aussi appelés outils) de manière transparente et sécurisée.

- **Dialogue contrôlable** : vous pouvez orienter le LLM pour qu'il suive des parcours conversationnels prédéfinis, ce qui vous permet de concevoir l'interaction en suivant les meilleures pratiques de conception de conversation et d'appliquer des procédures opérationnelles standard (par exemple, authentification, support).

<!-- end-documentation-reuse -->

### Protection contre les vulnérabilités des LLM

La bibliothèque NeMo Guardrails fournit plusieurs mécanismes pour protéger une application de chat alimentée par un LLM contre les vulnérabilités courantes des LLM, telles que les jailbreaks et les injections de prompts. Voici un aperçu d'exemple de la protection offerte par différentes configurations de garde-fous pour l'exemple [ABC Bot](https://github.com/nvidia-nemo/guardrails/blob/develop/examples/bots/abc) inclus dans ce dépôt. Pour plus de détails, veuillez consulter la page [Analyse des vulnérabilités des LLM](https://docs.nvidia.com/nemo/guardrails/evaluation/llm-vulnerability-scanning.html).

<div align="center">
<img src="https://raw.githubusercontent.com/NVIDIA-NeMo/Guardrails/develop/docs/_static/images/abc-llm-vulnerability-scan-results.png" width="500">
</div>

### Cas d'utilisation

Vous pouvez utiliser des garde-fous programmables dans différents types de cas d'utilisation :

1. **Réponse aux questions** sur un ensemble de documents (aussi appelé génération augmentée par récupération) : appliquer la vérification des faits et la modération des sorties.
2. **Assistants spécifiques à un domaine** (aussi appelés chatbots) : veiller à ce que l'assistant reste dans le sujet et suive les flux conversationnels conçus.
3. **Points de terminaison LLM** : ajouter des garde-fous à votre LLM personnalisé pour une interaction client plus sûre.
4. **Chaînes LangChain** (facultatif) : si vous utilisez LangChain pour un cas d'utilisation, vous pouvez ajouter une couche de garde-fous autour de vos chaînes. Pour activer cette intégration, définissez la variable d'environnement `NEMOGUARDRAILS_LLM_FRAMEWORK=langchain` ou appelez `set_default_framework("langchain")`.

### Utilisation

Pour ajouter des garde-fous programmables à votre application, vous pouvez utiliser l'API Python ou un serveur de garde-fous (consultez le [Guide du serveur](https://docs.nvidia.com/nemo/guardrails/get-started/integrate-into-application) pour plus de détails). L'utilisation de l'API Python est similaire à l'utilisation directe du LLM. Appeler la couche de garde-fous au lieu du LLM ne nécessite que des modifications minimales du code, et cela implique deux étapes simples :

1. Charger une configuration de garde-fous et créer une instance `LLMRails`.
2. Effectuer les appels au LLM à l'aide des méthodes `generate`/`generate_async`.```python
from nemoguardrails import LLMRails, RailsConfig

# Load a guardrails configuration from the specified path.
config = RailsConfig.from_path("PATH/TO/CONFIG")
rails = LLMRails(config)

completion = rails.generate(
    messages=[{"role": "user", "content": "Hello world!"}]
)
Exemple de sortie :```json {"role": "assistant", "content": "Hi! How can I help you?"}
Le format d'entrée et de sortie de la méthode `generate` est similaire à l'[API Chat Completions](https://platform.openai.com/docs/guides/gpt/chat-completions-api) d'OpenAI.

#### API asynchrone

La bibliothèque NeMo Guardrails est une boîte à outils asynchrone par conception, car les mécanismes principaux sont implémentés à l'aide du modèle asynchrone de Python. Les méthodes publiques disposent à la fois d'une version synchrone et d'une version asynchrone. Par exemple : `LLMRails.generate` et `LLMRails.generate_async`.

### LLMs pris en charge

Vous pouvez utiliser NeMo Guardrails avec plusieurs LLMs tels qu'OpenAI GPT-3.5, GPT-4, LLaMa-2, Falcon, Vicuna ou Mosaic. Pour plus de détails, consultez la section [Modèles LLM pris en charge](https://docs.nvidia.com/nemo/guardrails/about-nemo-guardrails-library/supported-llms) du Guide de configuration.

### Types de garde-fous

La bibliothèque NeMo Guardrails prend en charge cinq principaux types de garde-fous :

<div align="center">
  <img src="https://raw.githubusercontent.com/NVIDIA-NeMo/Guardrails/develop/docs/_static/images/programmable_guardrails_flow.png"  width="75%" alt="Programmable Guardrails Flow">
</div>

1. **Garde-fous d'entrée** : appliqués à l'entrée de l'utilisateur ; un garde-fou d'entrée peut rejeter l'entrée, ce qui arrête tout traitement supplémentaire, ou modifier l'entrée (par exemple, pour masquer des données potentiellement sensibles, pour reformuler).

2. **Garde-fous de dialogue** : influencent la manière dont le LLM est sollicité ; les garde-fous de dialogue opèrent sur les messages sous forme canonique (pour plus de détails, voir le [Guide Colang](https://docs.nvidia.com/nemo/guardrails/configure-guardrails/colang)) et déterminent si une action doit être exécutée, si le LLM doit être invoqué pour générer l'étape suivante ou une réponse, si une réponse prédéfinie doit être utilisée à la place, etc.

3. **Garde-fous de récupération** : appliqués aux segments récupérés dans le cas d'un scénario RAG (Retrieval Augmented Generation) ; un garde-fou de récupération peut rejeter un segment, l'empêchant d'être utilisé pour solliciter le LLM, ou modifier les segments pertinents (par exemple, pour masquer des données potentiellement sensibles).

4. **Garde-fous d'exécution** : appliqués à l'entrée/sortie des actions personnalisées (aussi appelées outils), qui doivent être appelées par le LLM.

5. **Garde-fous de sortie** : appliqués à la sortie générée par le LLM ; un garde-fou de sortie peut rejeter la sortie, l'empêchant d'être renvoyée à l'utilisateur, ou la modifier (par exemple, en supprimant des données sensibles).

### Configuration des garde-fous

Une configuration de garde-fous définit le ou les **LLM(s)** à utiliser et **un ou plusieurs garde-fous**. Une configuration de garde-fous peut inclure un nombre quelconque de garde-fous d'entrée/de dialogue/de sortie/de récupération/d'exécution. Une configuration sans aucun garde-fou configuré transmettra essentiellement les requêtes au LLM.

La structure standard d'un dossier de configuration de garde-fous se présente comme suit :```
.
├── config
│   ├── actions.py
│   ├── config.py
│   ├── config.yml
│   ├── rails.co
│   ├── ...
Le fichier config.yml contient toutes les options de configuration générales, telles que les modèles LLM, les rails actifs et les données de configuration personnalisées. Le fichier config.py contient tout code d'initialisation personnalisé et le fichier actions.py contient toutes les actions Python personnalisées. Pour un aperçu complet, consultez le Guide de configuration.
Voici un exemple de config.yml :```yaml
models:
rails:
input: flows: - check jailbreak - mask sensitive data on input
output: flows: - self check facts - self check hallucination - activefence moderation on input
config: # Configure the types of entities that should be masked on user input. sensitive_data_detection: input: entities: - PERSON - EMAIL_ADDRESS
Les fichiers `.co` inclus dans une configuration de guardrails contiennent les définitions Colang (voir la section suivante pour un aperçu rapide de ce qu'est Colang) qui définissent divers types de rails. Voici un exemple de fichier `greeting.co` qui définit les rails de dialogue pour saluer l'utilisateur.```colang
define user express greeting
  "Hello!"
  "Good afternoon!"

define flow
  user express greeting
  bot express greeting
  bot offer to help

define bot express greeting
  "Hello there!"

define bot offer to help
  "How can I help you today?"
Voici un exemple supplémentaire de définitions Colang pour un rail de dialogue contre les insultes :```colang define user express insult "You are stupid"
define flow user express insult bot express calmly willingness to help
### Colang

Pour configurer et implémenter différents types de garde-fous, cette boîte à outils introduit **Colang**, un langage de modélisation spécialement conçu pour créer des flux de dialogue flexibles mais contrôlables. Colang possède une syntaxe de type Python et est conçu pour être simple et intuitif, en particulier pour les développeurs.```{note}
Two versions of Colang, 1.0 and 2.0, are supported and Colang 1.0 is the default.
Pour une brève introduction à la syntaxe Colang 1.0, consultez le Guide de syntaxe du langage Colang 1.0.
Pour débuter avec Colang 2.0, consultez la Documentation Colang 2.0.
NeMo Guardrails est livré avec un ensemble de guardrails intégrés.```{note} The built-in guardrails may or may not be suitable for a given production use case. As always, developers should work with their internal application team to ensure guardrails meets requirements for the relevant industry and use case and address unforeseen product misuse.
La bibliothèque inclut des garde-fous pour l'auto-vérification des LLM (modération des entrées/sorties, vérification des faits, détection des hallucinations), les modèles de sécurité NVIDIA (sécurité du contenu, sécurité des sujets), la détection de jailbreak et d'injection, ainsi que des intégrations avec des modèles communautaires et des API tierces. Pour la liste complète, consultez la [documentation de la bibliothèque de garde-fous](https://docs.nvidia.com/nemo/guardrails/user-guides/guardrails-library.html).

## CLI

La bibliothèque NeMo Guardrails est également fournie avec une CLI intégrée.```bash
$ nemoguardrails --help

Usage: nemoguardrails [OPTIONS] COMMAND [ARGS]...

actions-server    Start a NeMo Guardrails actions server.
chat              Start an interactive chat session.
evaluate          Run an evaluation task.
server            Start a NeMo Guardrails server.
Vous pouvez utiliser l'interface en ligne de commande de la bibliothèque NeMo Guardrails pour démarrer un serveur guardrails. Le serveur peut charger une ou plusieurs configurations depuis le dossier spécifié et exposer une API HTTP pour les utiliser.``` nemoguardrails server [--config PATH/TO/CONFIGS] [--port PORT]
Par exemple, pour obtenir une complétion de chat pour une configuration `sample`, vous pouvez utiliser le point de terminaison `/v1/chat/completions` :```
POST /v1/chat/completions
I don't have the source content to translate. You mentioned "INPUT:" but no actual Markdown text followed it.
Please paste the chunk 25 content you'd like translated from English to French, and I'll return only the translated Markdown with all structure, code, paths, and identifiers preserved exactly.```json { "config_id": "sample", "messages": [{ "role":"user", "content":"Hello! What can you do for me?" }] }
Exemple de sortie :```json
{"role": "assistant", "content": "Hi! How can I help you?"}
Pour démarrer un serveur guardrails, vous pouvez également utiliser un conteneur Docker. La bibliothèque NeMo Guardrails fournit un Dockerfile que vous pouvez utiliser pour construire une image nemoguardrails. Pour plus d'informations, consultez la section utilisation de Docker.
L'intégration de LangChain est facultative. Pour l'activer, définissez la variable d'environnement NEMOGUARDRAILS_LLM_FRAMEWORK=langchain ou appelez set_default_framework("langchain"). Installez ensuite les paquets LangChain requis par votre configuration. Après avoir activé l'intégration, vous pouvez envelopper une configuration guardrails autour d'une chaîne LangChain (ou de n'importe quel Runnable), et vous pouvez appeler une chaîne LangChain depuis une configuration guardrails. Pour plus d'informations, consultez la documentation d'intégration LangChain.
Évaluer la sûreté d'une application conversationnelle basée sur un LLM est une tâche complexe et reste une question de recherche ouverte. Pour permettre une évaluation appropriée, la bibliothèque NeMo Guardrails fournit les éléments suivants :
nemoguardrails evaluate, avec prise en charge des rails thématiques, de la vérification des faits, de la modération (modération des jailbreaks et des sorties) et des hallucinations.Il existe de nombreuses façons d'ajouter des guardrails à une application conversationnelle basée sur un LLM. Par exemple : des points de terminaison de modération explicites (par exemple OpenAI, ActiveFence, PolicyAI), des chaînes de critique (par exemple la chaîne constitutionnelle), l'analyse de la sortie (par exemple guardrails.ai), des guardrails individuels (par exemple LLM-Guard), la détection d'hallucinations pour les applications RAG (par exemple Got It AI, Patronus Lynx).
La bibliothèque NeMo Guardrails vise à fournir une boîte à outils flexible capable d'intégrer toutes ces approches complémentaires dans une couche de guardrails LLM cohérente. Par exemple, la boîte à outils fournit une intégration prête à l'emploi avec ActiveFence, PolicyAI, AlignScore et les chaînes LangChain.
À notre connaissance, la bibliothèque NeMo Guardrails est la seule boîte à outils de guardrails qui offre également une solution pour modéliser le dialogue entre l'utilisateur et le LLM. Cela permet d'une part de guider le dialogue de manière précise. D'autre part, cela permet un contrôle fin du moment où certains guardrails doivent être utilisés, par exemple n'utiliser la vérification des faits que pour certains types de questions.
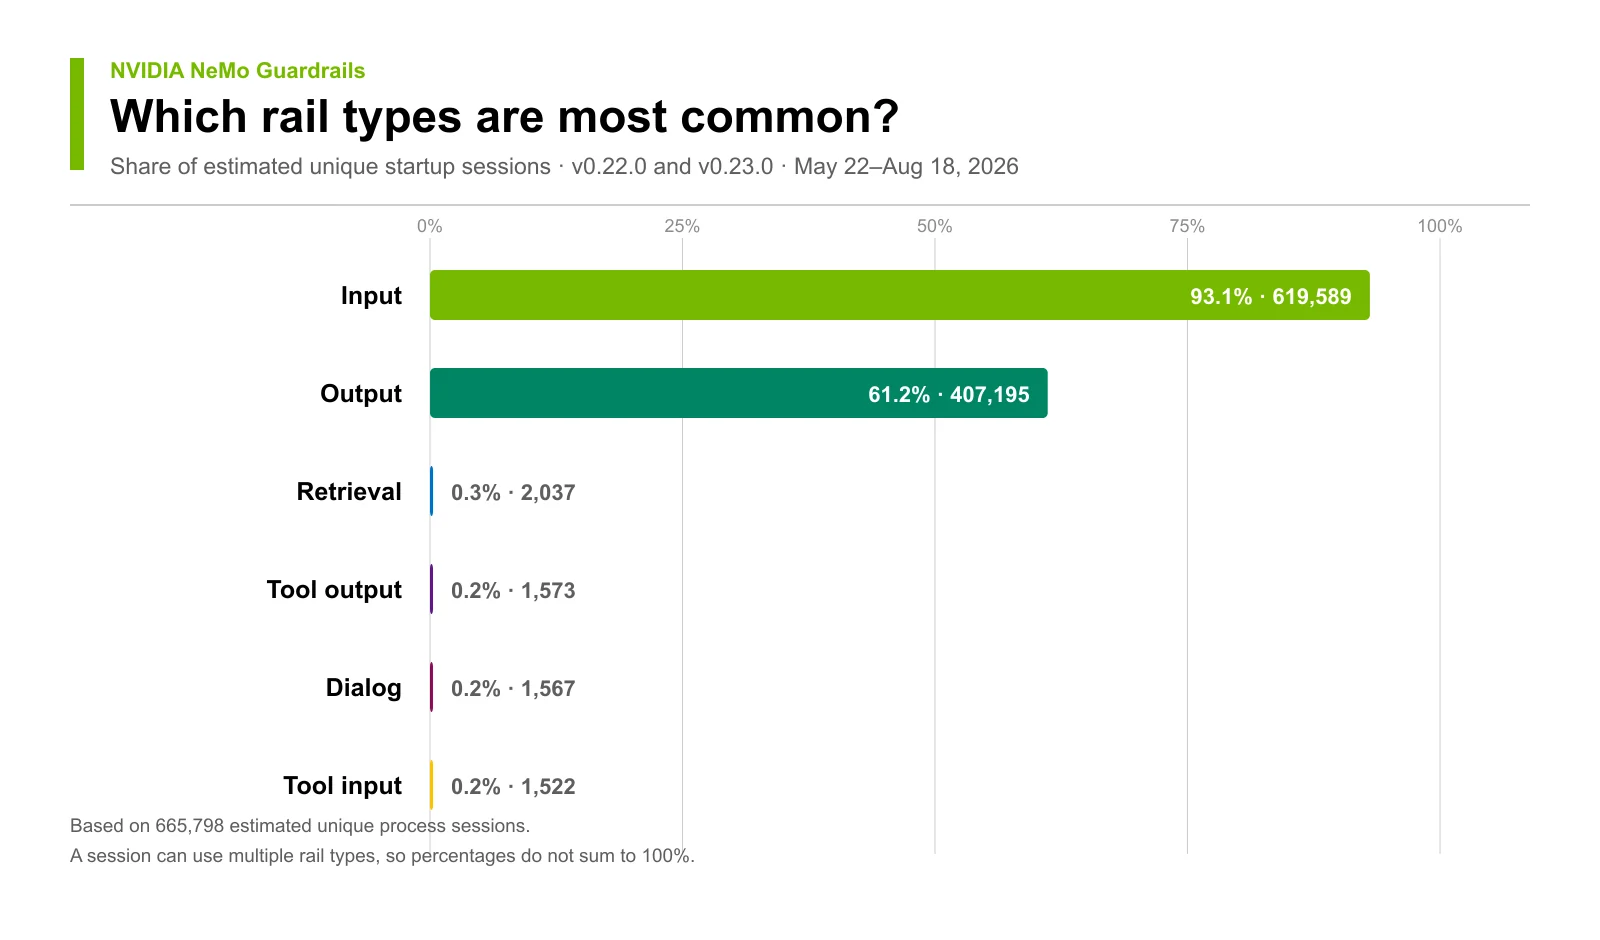
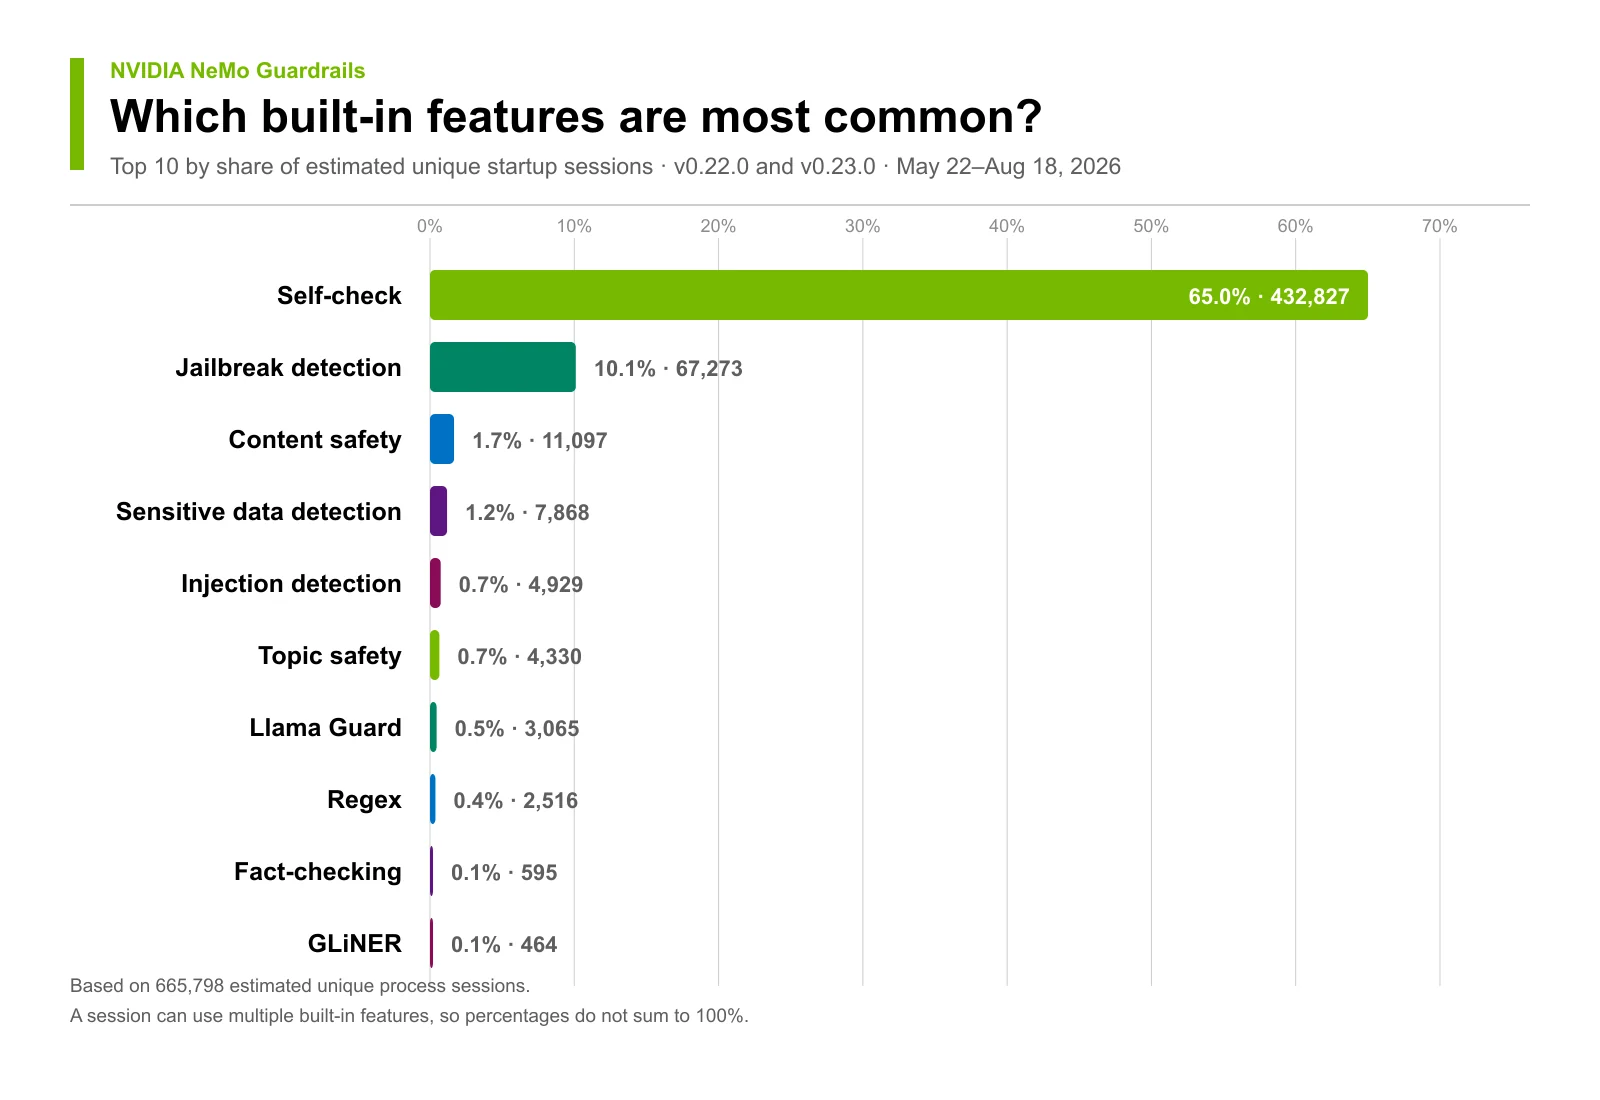
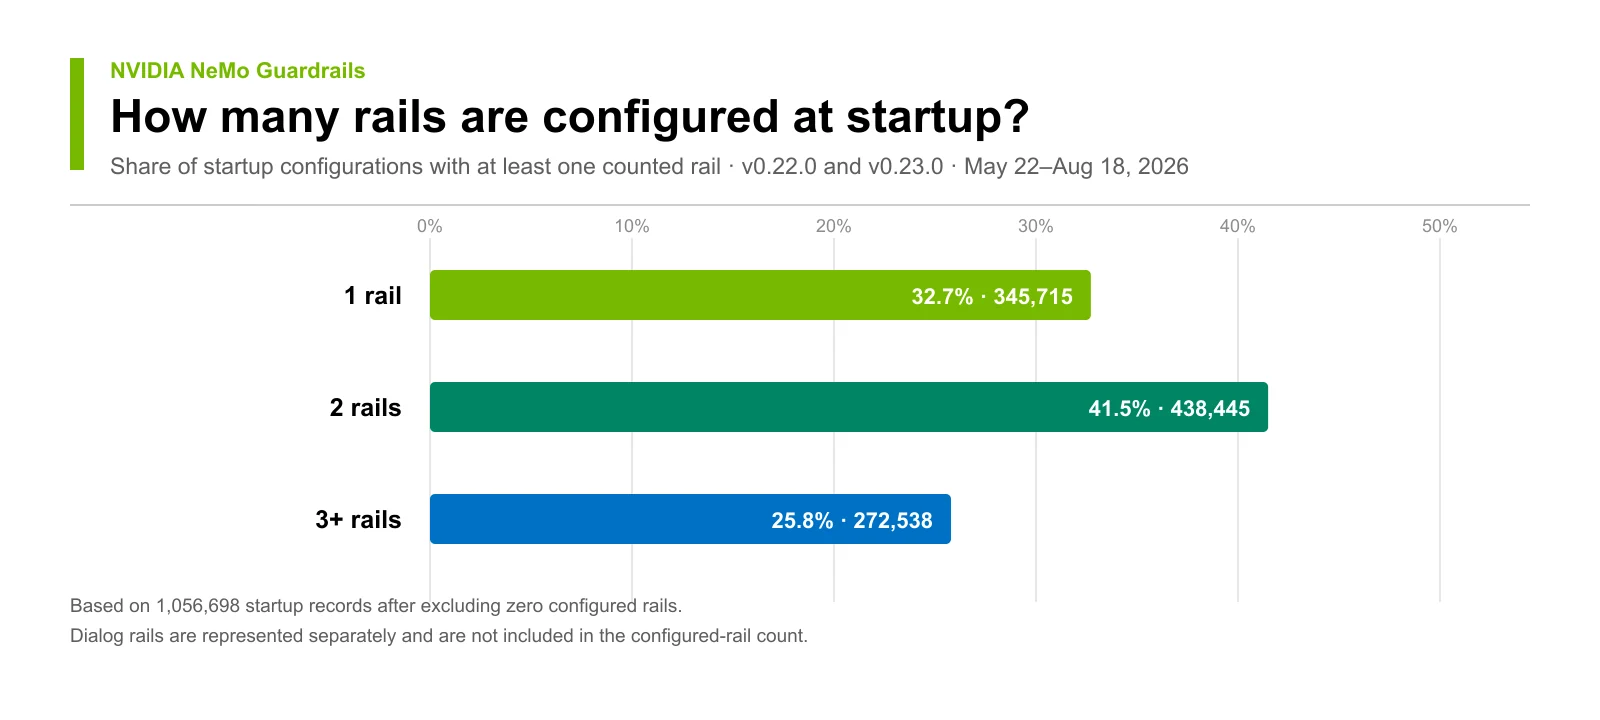
La bibliothèque NVIDIA NeMo Guardrails collecte des données de télémétrie anonymes pour aider NVIDIA à comprendre quels modèles de déploiement et quelles fonctionnalités de sûreté sont les plus utilisés. La bibliothèque émet un événement d'utilisation lorsque vous instanciez LLMRails, IORails ou Guardrails, puis émet des signaux périodiques depuis un seul thread démon par processus. Cette télémétrie est distincte du tracing par requête. Vous configurez le tracing dans votre configuration guardrails et l'envoyez à votre propre backend d'observabilité. La télémétrie est un ping anonyme minimal envoyé à NVIDIA.
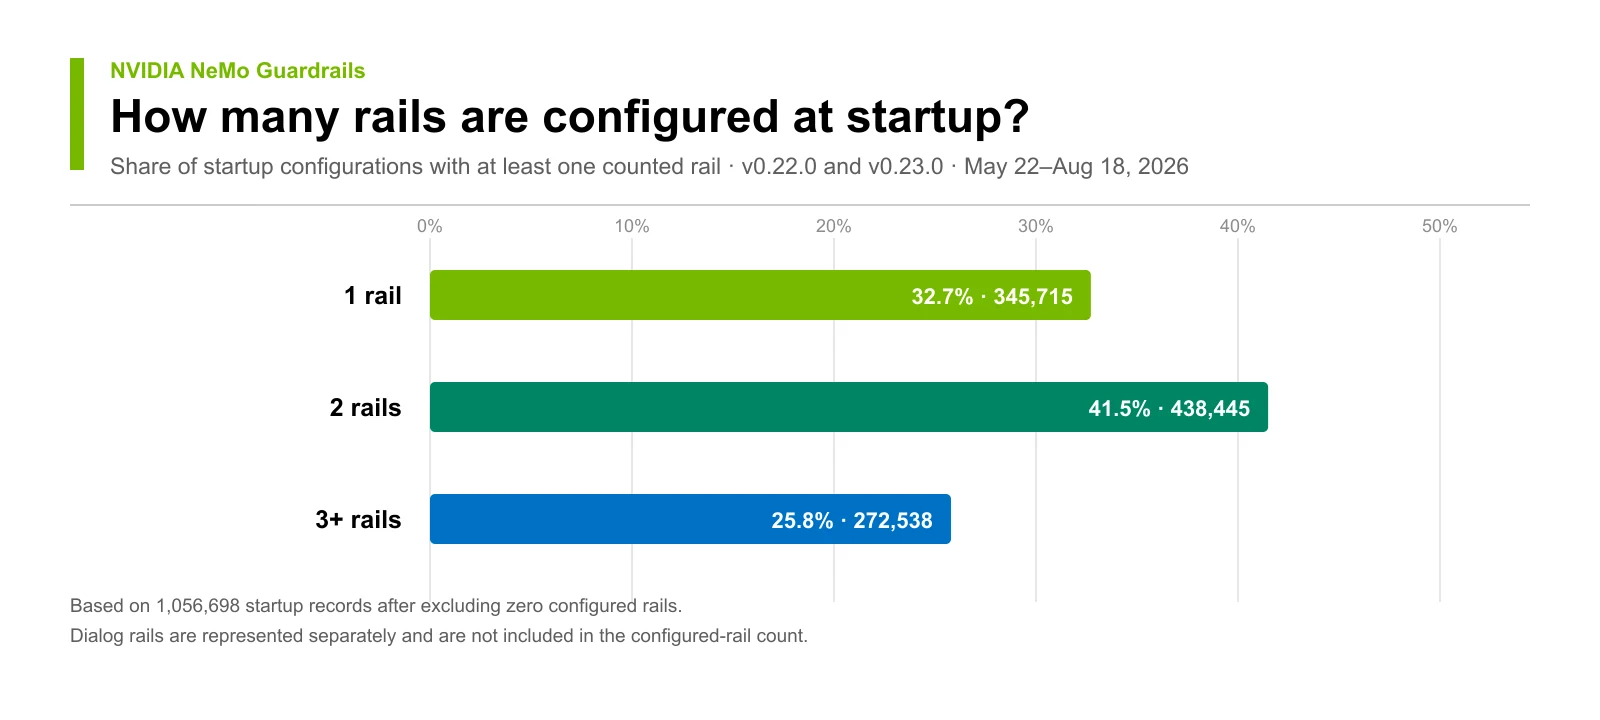
Utilisation anonyme agrégée sur les versions exactes 0.22.0 et 0.23.0, du 22 mai au 18 août 2026 :
Dernière mise à jour le 18 août 2026
La télémétrie inclut :
openai, nim ou nvidia_ai_endpoints, jamais les noms de modèles ni les identifiantsjailbreak_detection, content_safety ou topic_safetylibrary, api ou cli)LLMRails ou IORails)Aucun contenu utilisateur n'est collecté dans la charge utile de l'événement. La charge utile n'inclut pas les noms de modèles, les clés API, les points de terminaison, les prompts, les complétions, les nombres de tokens, les métriques par requête, les chemins de fichiers, les noms d'utilisateur ou les adresses IP. NVIDIA utilise les données de manière agrégée pour prioriser les travaux d'ingénierie et partagera les tendances d'adoption avec la communauté.
La bibliothèque tente également d'écrire chaque charge utile d'événement dans un fichier d'audit local à l'emplacement ~/.config/nemoguardrails/usage_stats.json. Le fichier d'audit stocke le JSONL des événements, et non l'enveloppe de télémétrie NVIDIA complète. Les écritures d'audit sont effectuées au mieux, et la transmission de la télémétrie se poursuit même si l'écriture de l'audit local échoue.
Définissez l'une des options suivantes pour désactiver la télémétrie :```bash export NEMO_GUARDRAILS_NO_USAGE_STATS=1
export DO_NOT_TRACK=1
mkdir -p ~/.config/nemoguardrails && touch ~/.config/nemoguardrails/do_not_track
Configurez le refus avant que la bibliothèque NVIDIA NeMo Guardrails ne démarre. Modifier les variables d'environnement ou créer `do_not_track` après le démarrage de la télémétrie n'arrête pas un thread de battement de cœur déjà en cours d'exécution.

Reportez-vous à [docs/telemetry.md](https://docs.nvidia.com/nemo/guardrails/latest/telemetry.html) pour le schéma complet et les descriptions champ par champ.

Vous pouvez refuser la collecte de télémétrie à tout moment. Le refus ne s'applique qu'à la collecte de données par la bibliothèque NVIDIA NeMo Guardrails elle-même.

Les points de terminaison tiers ont des conditions et des pratiques de confidentialité distinctes. La bibliothèque NVIDIA NeMo Guardrails peut utiliser des points de terminaison d'inférence tels que NVIDIA Build (`build.nvidia.com`). Si vous utilisez NVIDIA Build ou un autre point de terminaison tiers, les conditions d'utilisation et les pratiques de confidentialité de ce point de terminaison s'appliquent indépendamment de la bibliothèque. Tout refus de télémétrie dans la bibliothèque NVIDIA NeMo Guardrails ne s'étend pas au point de terminaison que vous choisissez. NVIDIA Build est destiné uniquement à l'évaluation et aux tests et ne doit pas être utilisé dans des environnements de production. Ne soumettez pas d'informations confidentielles ou de données personnelles lors de l'utilisation de NVIDIA Build.

## Inviter la communauté à contribuer

Les rails d'exemple résidant dans le dépôt sont d'excellents points de départ. Nous invitons avec enthousiasme la communauté à contribuer pour rendre la puissance des LLM dignes de confiance, sûrs et sécurisés accessible à tous. Pour obtenir des conseils sur la configuration d'un environnement de développement et sur la manière de contribuer à la bibliothèque NeMo Guardrails, consultez les [directives de contribution](https://github.com/nvidia-nemo/guardrails/blob/develop/CONTRIBUTING.md).

## Licence

La bibliothèque NeMo Guardrails est sous licence [Apache License, Version 2.0](http://www.apache.org/licenses/LICENSE-2.0).

## Comment citer

Si vous utilisez la bibliothèque NeMo Guardrails, citez l'[article EMNLP 2023](https://aclanthology.org/2023.emnlp-demo.40) qui la présente.```bibtex
@inproceedings{rebedea-etal-2023-nemo,
    title = "{N}e{M}o Guardrails: A Toolkit for Controllable and Safe {LLM} Applications with Programmable Rails",
    author = "Rebedea, Traian  and
      Dinu, Razvan  and
      Sreedhar, Makesh Narsimhan  and
      Parisien, Christopher  and
      Cohen, Jonathan",
    editor = "Feng, Yansong  and
      Lefever, Els",
    booktitle = "Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing: System Demonstrations",
    month = dec,
    year = "2023",
    address = "Singapore",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2023.emnlp-demo.40",
    doi = "10.18653/v1/2023.emnlp-demo.40",
    pages = "431--445",
}