 nil0x42/duplicut
Supprimer les doublons d'une énorme liste de mots, sans la trier (pour le cassage de mots de passe basé sur un dictionnaire)




De nos jours, la création de listes de mots de passe implique généralement la concaténation de multiples sources de données.
Idéalement, les mots de passe les plus probables devraient se trouver en début de liste, de sorte que les mots de passe les plus courants soient craqués instantanément.
Avec les outils de déduplication existants, vous êtes contraint de choisir entre conserver l'ordre OU traiter des listes de mots massives.
Malheureusement, la création d'une liste de mots nécessite les deux
J'ai donc écrit duplicut en C hautement optimisé pour répondre à ce besoin très spécifique 🤓 💻
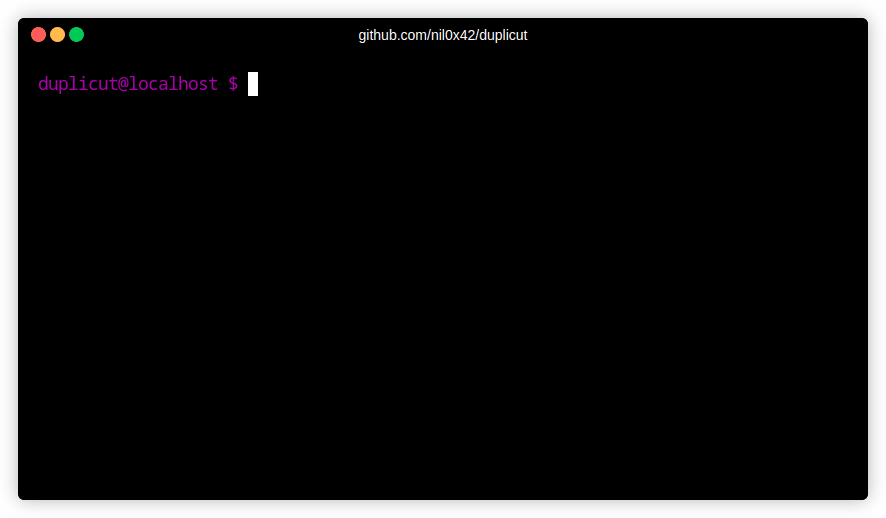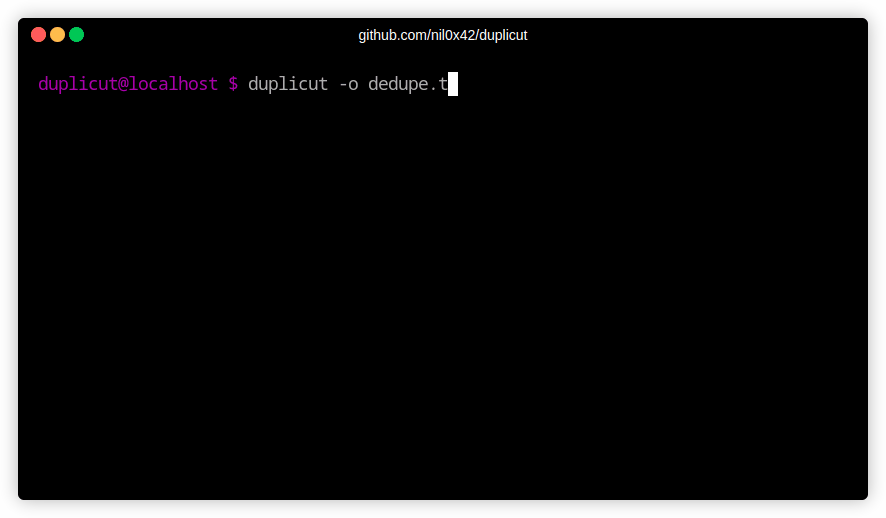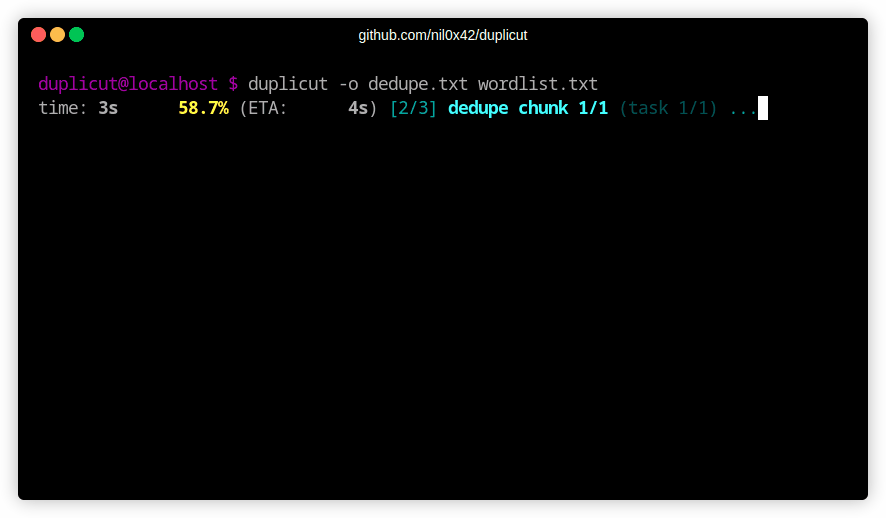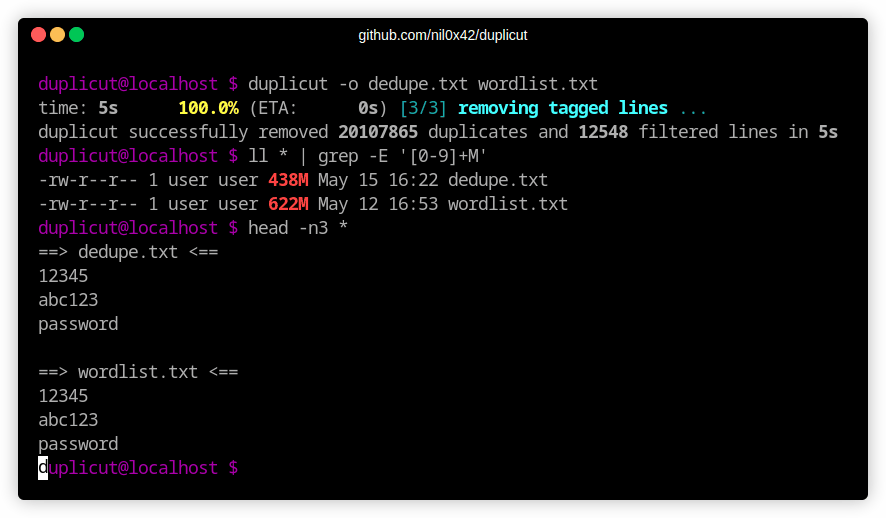
git clone https://github.com/nil0x42/duplicut  # download ...
cd duplicut/ && make                           # compile ...
./duplicut wordlist.txt -o clean-wordlist.txt  # dedupe !!!
-o, --outfile <FILE>       Écrire le résultat dans <FILE>
-t, --threads <NUM>        Nombre max de threads (défaut max)
-m, --memlimit <VALUE>     Limiter la mémoire max utilisée (défaut max)
-l, --line-max-size <NUM>  Taille max de ligne (défaut 1024, max 4095)
-p, --printable            Filtrer les lignes imprimables ASCII
-c, --lowercase            Convertir la liste de mots en minuscules
-C, --uppercase            Convertir la liste de mots en majuscules
-D, --dupfile <FILE>       Écrire les doublons dans <FILE> (ralentit duplicut)
-h, --help                 Afficher cette aide et quitter
-v, --version              Afficher la version et quitter
Fonctionnalités :
--line-max-size)--printable)--dupfile)--lowercase ou --uppercaseImplémentation :
Limitations :
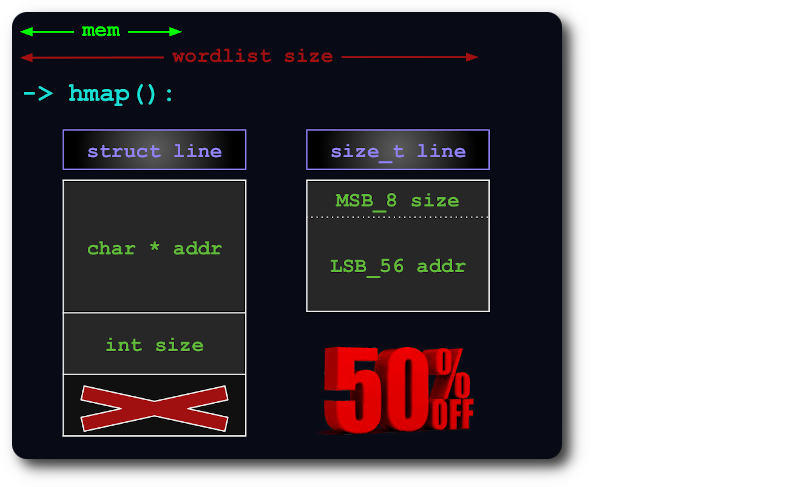
--line-max-size ne peut pas dépasser 4095Un uint64 suffit pour indexer les lignes dans la hashmap, en intégrant
l'information de size dans les bits supplémentaires du pointeur :

Si le fichier entier ne tient pas en mémoire, il est divisé en  morceaux virtuels, de manière à ce que chaque morceau utilise autant de RAM que possible.
Chaque morceau est ensuite chargé dans la hashmap, dédupliqué, et testé par rapport aux morceaux suivants.
De cette façon, le temps d'exécution diminue au plus au ième nombre triangulaire :

Si vous trouvez un bug, ou si quelque chose ne fonctionne pas comme prévu, veuillez compiler duplicut en mode débogage et poster un issue avec la sortie jointe :
# debug level can be from 1 to 4
make debug level=1
./duplicut [OPTIONS] 2>&1 | tee /tmp/duplicut-debug.log
