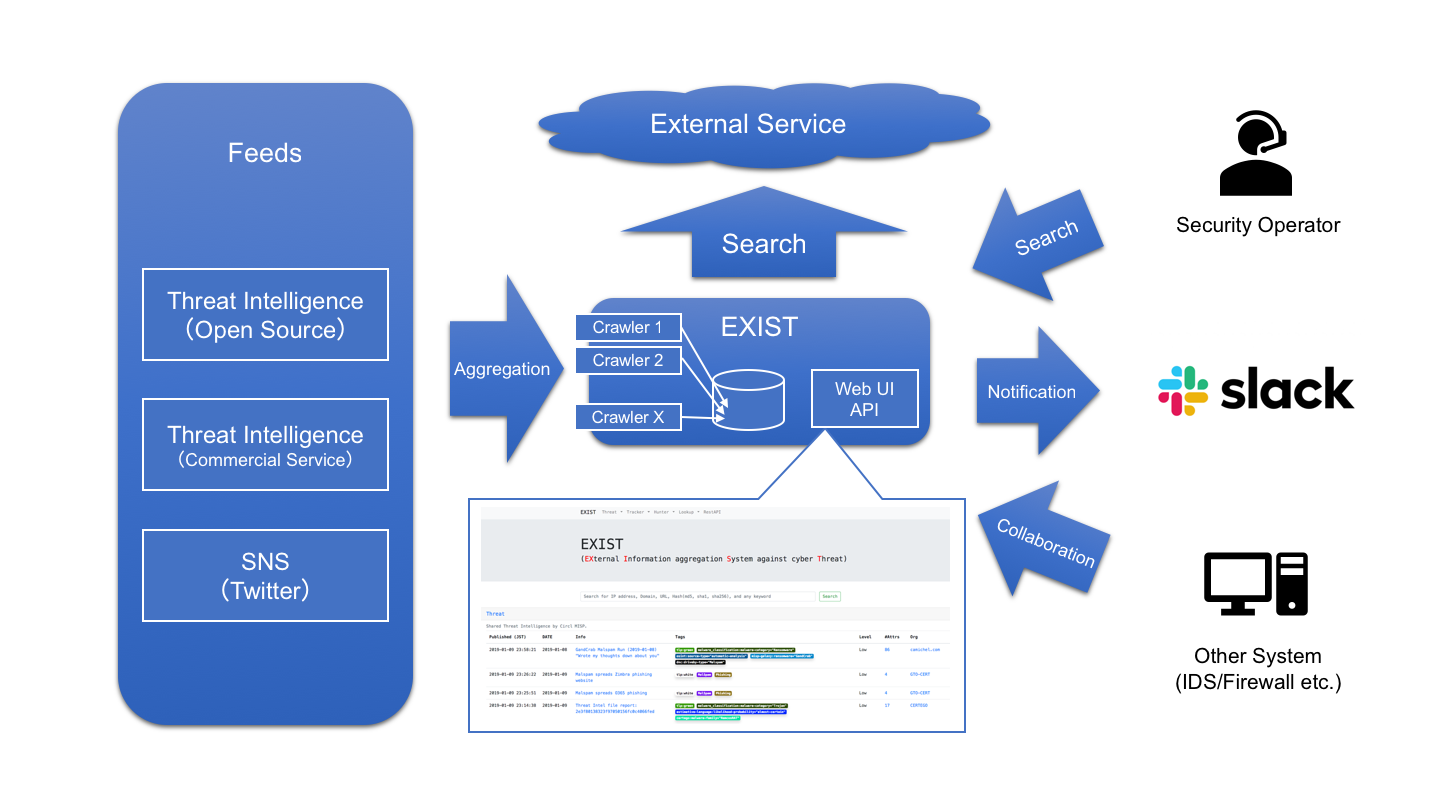

EXIST est une application Web pour agréger et analyser le renseignement sur les cybermenaces.
⚠️ Ce dépôt n'est plus maintenu / archivé. Les problèmes de sécurité ne seront pas corrigés.
EXIST est une application web pour l'agrégation et l'analyse de CTI (renseignement sur les cybermenaces).
EXIST est développé avec les logiciels suivants.
EXIST est une application web pour l'agrégation de CTI afin d'aider les opérateurs de sécurité à enquêter sur les incidents en se basant sur des indicateurs connexes.
EXIST récupère automatiquement des données de plusieurs services CTI et de Twitter via leurs API et flux. Vous pouvez effectuer des recherches croisées d'indicateurs via l'interface web et l'API.
Si vous avez des serveurs qui enregistrent les comportements réseau des clients (par exemple, les journaux des serveurs DNS et proxy HTTP, etc.), vous pourrez analyser les journaux en les corrélant avec les données d'EXIST. Si vous implémentez des programmes en utilisant l'API, vous réaliserez un centre d'opérations de sécurité automatisé piloté par CTI.
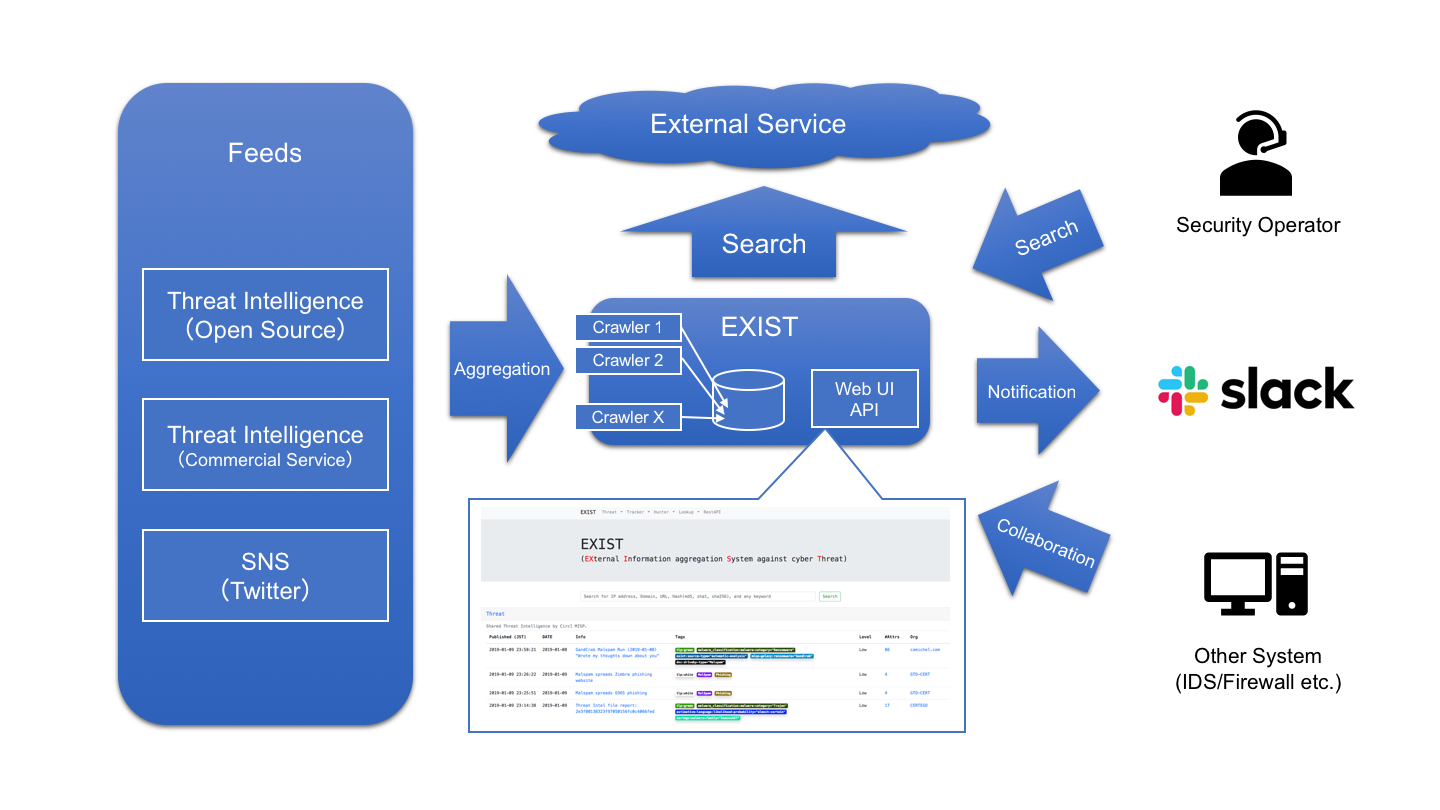
Il suffit de saisir le domaine dans le formulaire de recherche.
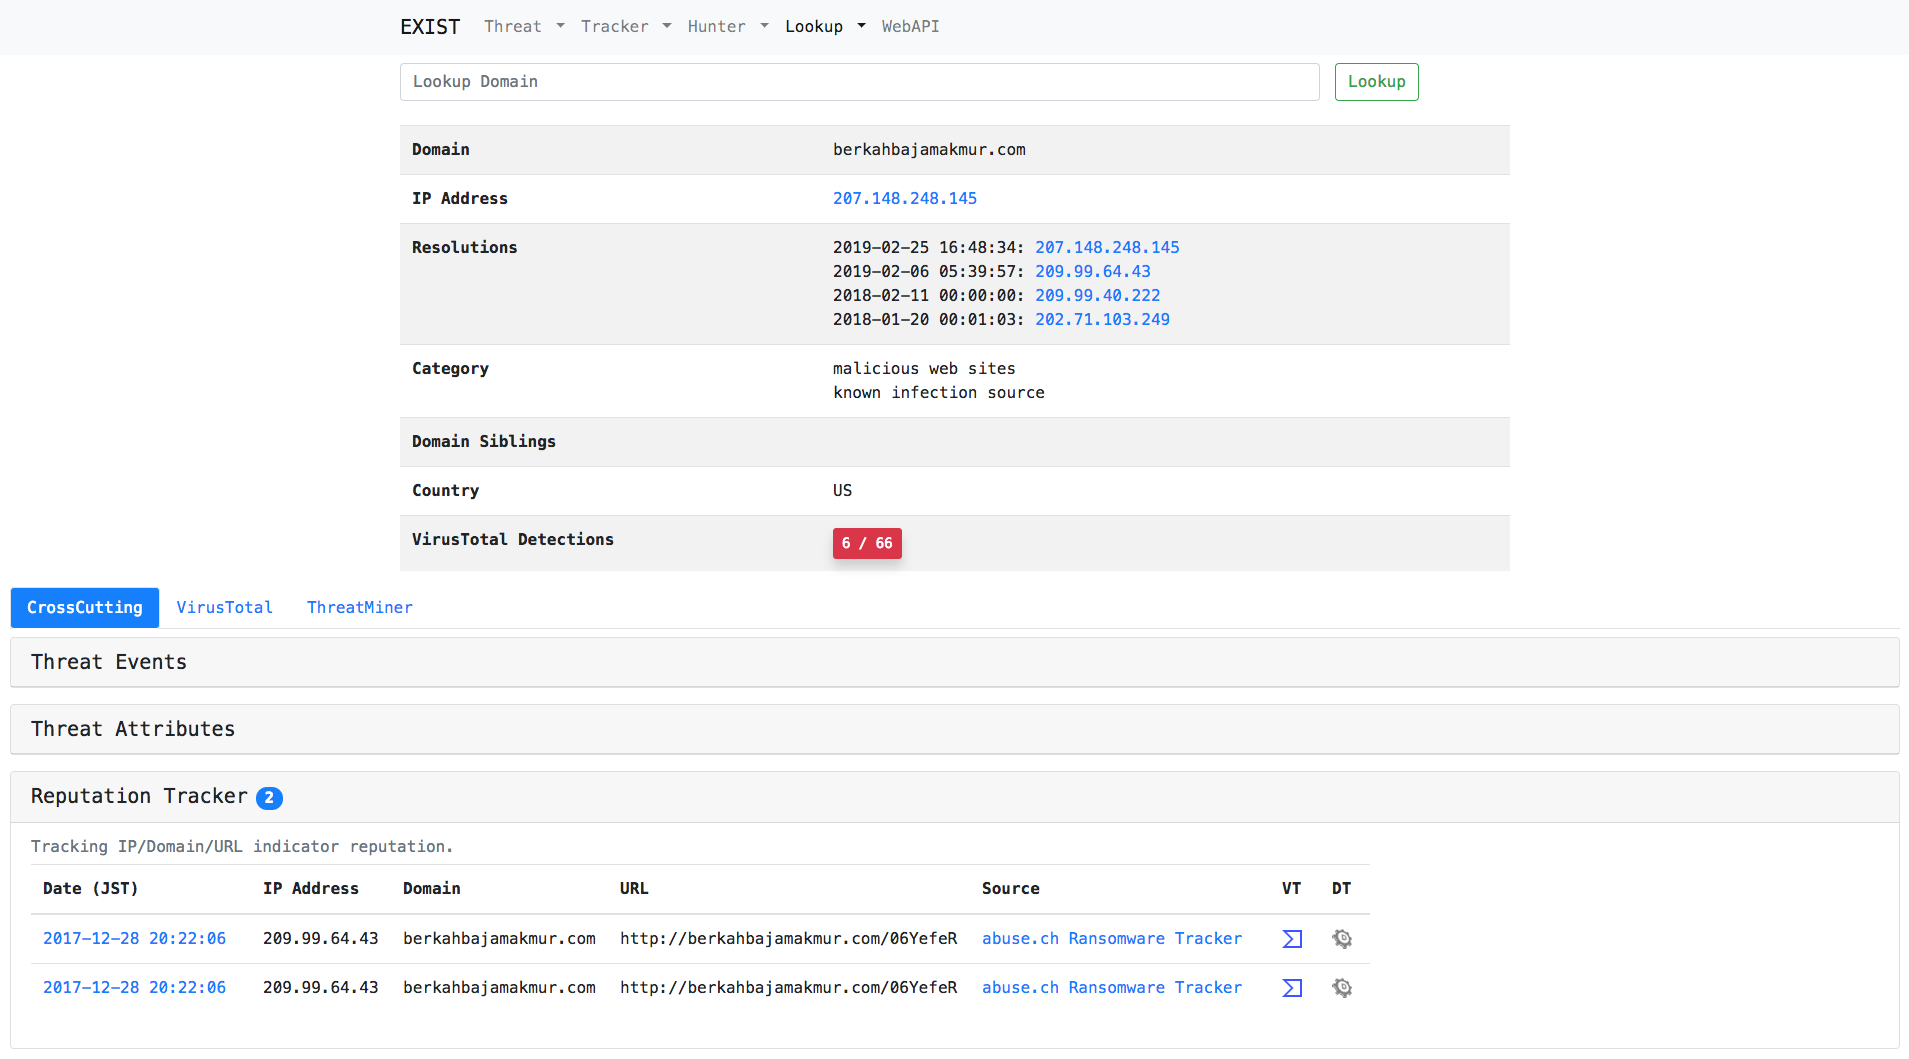
Il suffit de saisir l'URL dans le formulaire de recherche.
Il suffit d'ajouter des mots-clés dans Threat Hunter ou Twitter Hunter.
Tracker collecte automatiquement des flux de données à partir de plusieurs services CTI.
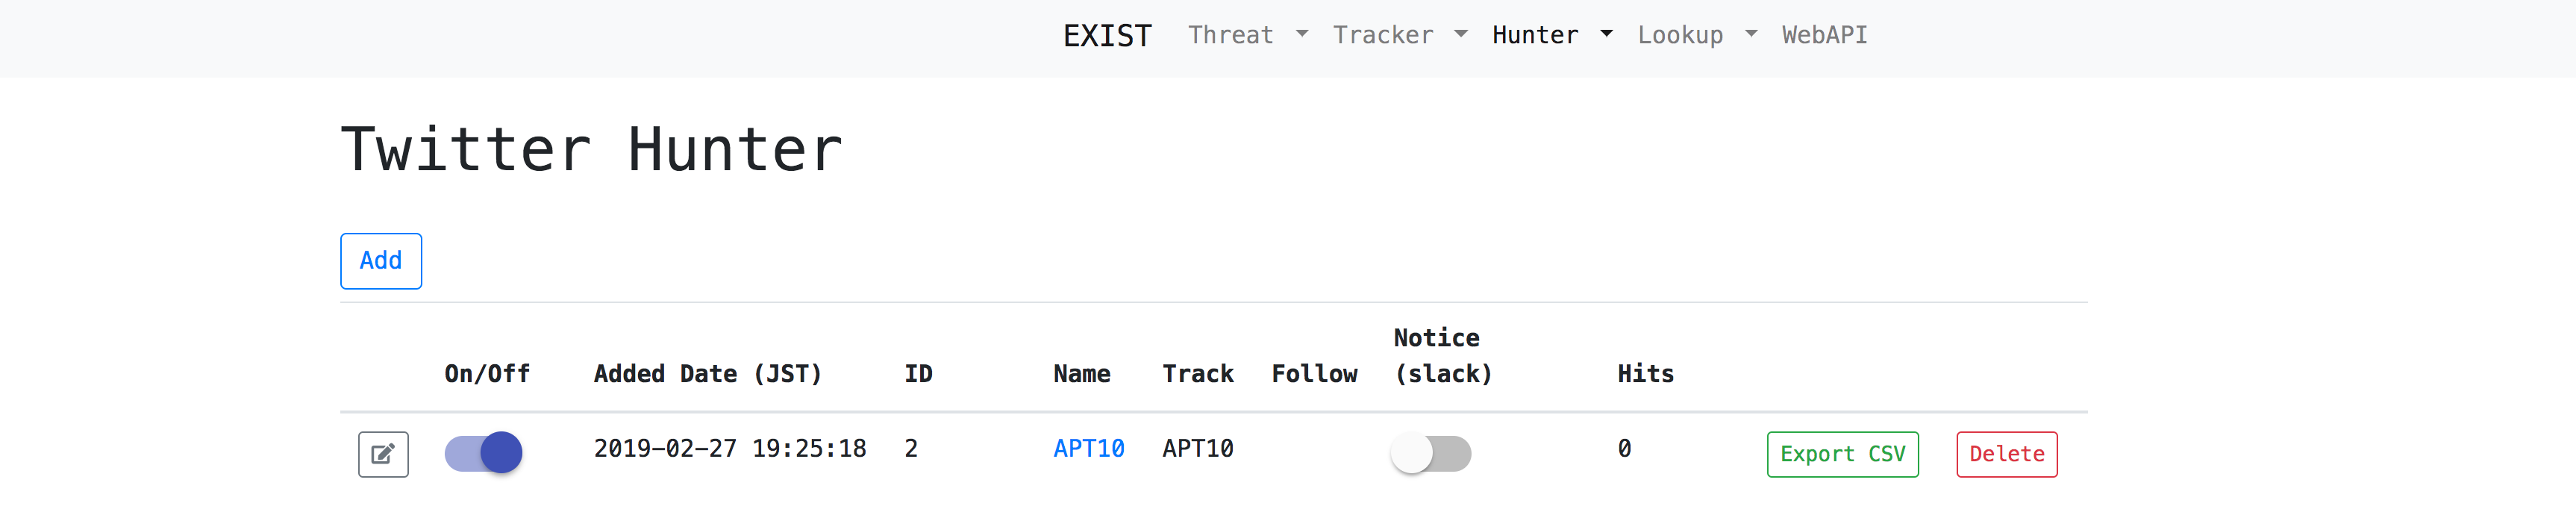
Hunter nous permet de définir des requêtes pour collecter des données à partir de plusieurs services CTI et Twitter.
Lookup récupère des informations relatives à des informations spécifiques (par exemple, adresse IP, domaine) à partir de plusieurs services Internet (par exemple, whois).
Un outil pour annoter les tweets du tracker Twitter.
Fournir les données stockées dans la base de données EXIST via l'API Web.
Par la suite, je suppose un environnement CentOS 7 ou Ubuntu 18.04 LTS. Veuillez le faire à vos risques et périls lors d'un déploiement dans un autre environnement.
$ sudo pip install -r requirements.txt
$ curl -sS https://downloads.mariadb.com/MariaDB/mariadb_repo_setup | sudo bash
$ sudo yum install MariaDB-server MariaDB-client
$ sudo apt install mariadb-server mariadb-client
$ sudo systemctl start mariadb
$ sudo systemctl enable mariadb
.env en référence à .env.example. Et modifiez-le selon les paramètres de votre base de données.La clé secrète pour Django doit être écrite dans le fichier .env.
D'abord, exécutez le générateur de clé :
$ python keygen.py
(example)> 70mm6h)()h3r&*b9xq$e52=-7($p=5983gfoyz%$d-j-gd7u5@
et écrivez la clé secrète dans le fichier .env :
...
# EXIST Application Settings
EXIST_SECRET_KEY="70mm6h)()h3r&*b9xq$e52=-7($p=5983gfoyz%$d-j-gd7u5@"
...
$ python manage.py makemigrations exploit reputation threat threat_hunter twitter twitter_hunter news news_hunter vuln
$ python manage.py migrate
Le tracker de réputation utilise Redis comme backend du serveur de cache Celery.
$ sudo yum install redis
$ sudo systemctl start redis
$ sudo systemctl enable redis
$ sudo apt install redis-server
$ sudo systemctl start redis-server
$ sudo systemctl enable redis-server
Le tracker de réputation utilise Celery comme file d'attente de tâches asynchrones.
# Name of nodes to start
# here we have a single node
CELERYD_NODES="w1"
# or we could have three nodes:
#CELERYD_NODES="w1 w2 w3"

# Absolute or relative path to the 'celery' command:
CELERY_BIN="/path/to/your/celery"

# App instance to use
# comment out this line if you don't use an app
CELERY_APP="intelligence"
# or fully qualified:
#CELERY_APP="proj.tasks:app"

# How to call manage.py
CELERYD_MULTI="multi"

# Extra command-line arguments to the worker
CELERYD_OPTS="--time-limit=300 --concurrency=8"

# - %n will be replaced with the first part of the nodename.
# - %I will be replaced with the current child process index
# and is important when using the prefork pool to avoid race conditions.
CELERYD_PID_FILE="/var/run/celery/%n.pid"
CELERYD_LOG_FILE="/var/log/celery/%n%I.log"
CELERYD_LOG_LEVEL="INFO"
/etc/systemd/system/celery.service. De plus, vous devez définir le chemin de votre configuration celery dans EnvironmentFile.[Unit]
Description=Celery Service
After=network.target
[Service]
Type=forking
User=YOUR_USER
Group=YOUR_GROUP
EnvironmentFile=/etc/sysconfig/celery
WorkingDirectory=/path/to/your/exist
ExecStart=/bin/sh -c '${CELERY_BIN} multi start ${CELERYD_NODES} \
-A ${CELERY_APP} --pidfile=${CELERYD_PID_FILE} \
--logfile=${CELERYD_LOG_FILE} --loglevel=${CELERYD_LOG_LEVEL} ${CELERYD_OPTS}'
ExecStop=/bin/sh -c '${CELERY_BIN} multi stopwait ${CELERYD_NODES} \
--pidfile=${CELERYD_PID_FILE}'
ExecReload=/bin/sh -c '${CELERY_BIN} multi restart ${CELERYD_NODES} \
-A ${CELERY_APP} --pidfile=${CELERYD_PID_FILE} \
--logfile=${CELERYD_LOG_FILE} --loglevel=${CELERYD_LOG_LEVEL} ${CELERYD_OPTS}'
[Install]
WantedBy=multi-user.target
$ sudo mkdir /var/log/celery; sudo chown YOUR_USER:YOUR_GROUP /var/log/celery
$ sudo mkdir /var/run/celery; sudo chown YOUR_USER:YOUR_GROUP /var/run/celery
#Type  Path               Mode  UID        GID         Age  Argument
d      /var/run/celery    0755  YOUR_USER  YOUR_GROUP  -
$ sudo systemctl start celery.service
$ sudo systemctl enable celery.service
$ python manage.py runserver 0.0.0.0:8000
Note : Je recommande d'utiliser Nginx et uWSGI pour un environnement de production.
Les scripts pour insérer les flux dans la base de données sont scripts/insert2db/*/insert2db.py.

