 ksharinarayanan/sourcewolf
Incroyablement rapide crawler de réponses pour trouver des trucs juteux dans le code source ! 😎🔥



Environnements testés : Windows, MAC, Linux, et sous-système Windows pour Linux (WSL)
Soutenez ce projet en devenant sponsor. Découvrez ces superbes sponsors :
Oxylabs fournit des proxys premium avec plus de 100 millions d'IP dans 195 pays et des API Scraper prêtes à l'emploi. Vous pouvez utiliser ce code promo unique boost35 pour obtenir 35 % de réduction sur les proxys résidentiels, mobiles, le débloqueur web et les API Scraper.
Parcourir les réponses pour trouver des points de terminaison cachés, soit en envoyant des requêtes, soit à partir des fichiers de réponse locaux (le cas échéant).
Créer une liste des variables JavaScript trouvées dans le code source
Extraire tous les liens vers les réseaux sociaux à partir des sites web pour identifier d'éventuels liens brisés
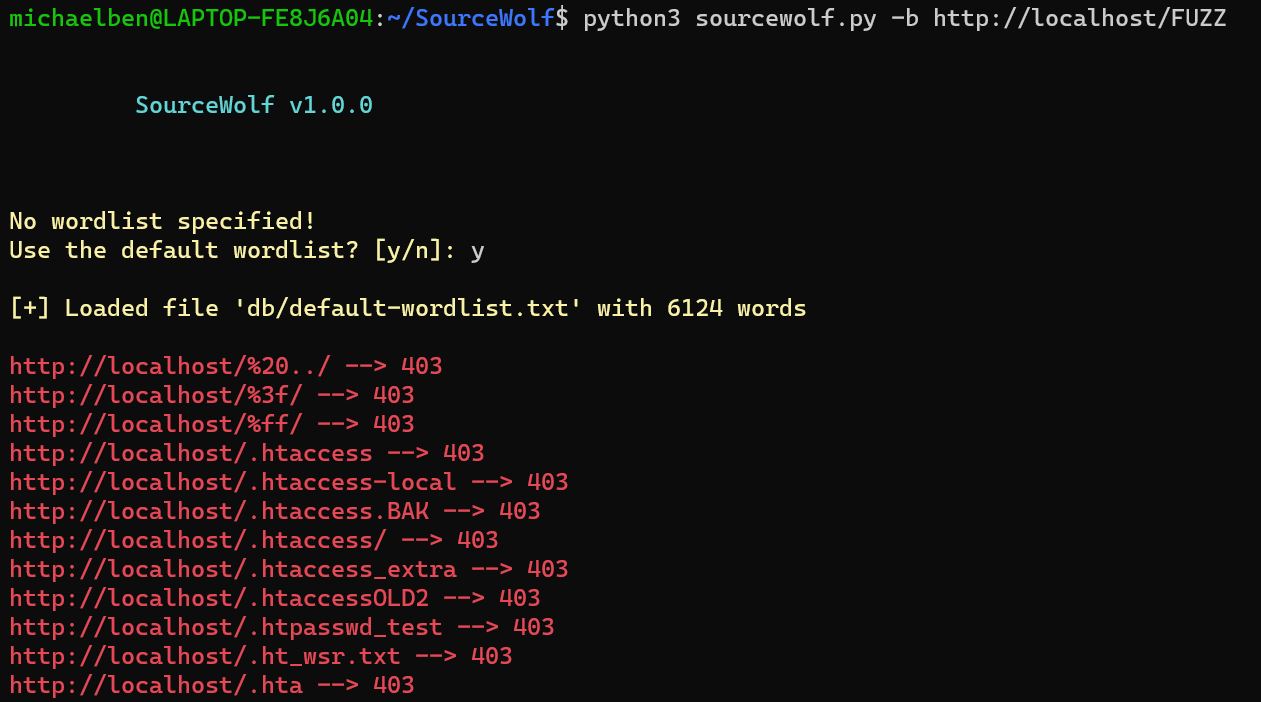
Forcer brutalement un hôte à l'aide d'une liste de mots.
Obtenir les codes d'état pour une liste d'URL / Filtrer les domaines actifs à partir d'une liste d'hôtes.
Toutes les fonctionnalités mentionnées ci-dessus s'exécutent avec une grande rapidité.
SourceWolf utilise le module Session de la bibliothèque requests, ce qui signifie qu'il réutilise la connexion TCP, le rendant très rapide.
SourceWolf vous offre la possibilité de parcourir les fichiers de réponse localement afin de ne pas renvoyer de requêtes à un point de terminaison dont vous possédez déjà une copie de la réponse.
Les points de terminaison finaux sont sous forme complète avec un hôte comme https://example.com/api/admin et non comme /api/admin. Cela peut être utile lorsque vous analysez une liste d'hôtes.
> python3 sourcewolf.py -h

-l LIST, --list LIST  Liste des URLs JavaScript
-u URL, --url URL     URL unique
-t THREADS, --threads THREADS
                      Nombre de threads concurrents à utiliser (par défaut 5)
-o OUTPUT_DIR, --output directory-name OUTPUT_DIR
                      Stocker le texte de réponse de l'URL dans un répertoire pour une analyse ultérieure
-s STATUS_CODE_FILE, --store-status-code STATUS_CODE_FILE
                      Stocker le code d'état dans un fichier
-b BRUTE, --brute BRUTE
                      Forcer brutalement l'URL avec le mot-clé FUZZ (--wordlist doit également être utilisé avec celui-ci)
-w WORDLIST, --wordlist WORDLIST
                      Liste de mots pour forcer brutalement l'URL
-v, --verbose         Mode verbeux (affiche toutes les requêtes envoyées)
-c CRAWL_OUTPUT, --crawl-output CRAWL_OUTPUT
                      Répertoire de sortie pour stocker le résultat du parcours
-d DELAY, --delay DELAY
                      Délai entre les requêtes (en secondes)
--timeout TIMEOUT     Temps maximum d'attente avant expiration de la connexion (en secondes)
--headers HEADERS     Ajouter des en-têtes personnalisées (Doit être passé sous la forme {'Token': 'YOUR-TOKEN-HERE'}) --> Format dictionnaire
--cookies COOKIES     Ajouter des cookies (Doit être passé sous la forme {'Cookie': 'YOUR-COOKIE-HERE'}) --> Format dictionnaire
--only-success        N'afficher que les réponses 2XX
--local LOCAL         Répertoire contenant les fichiers de réponse locaux à parcourir
--no-colors           Supprimer les couleurs de la sortie
--update-info         Vérifier la dernière version et mettre à jour si nécessaire
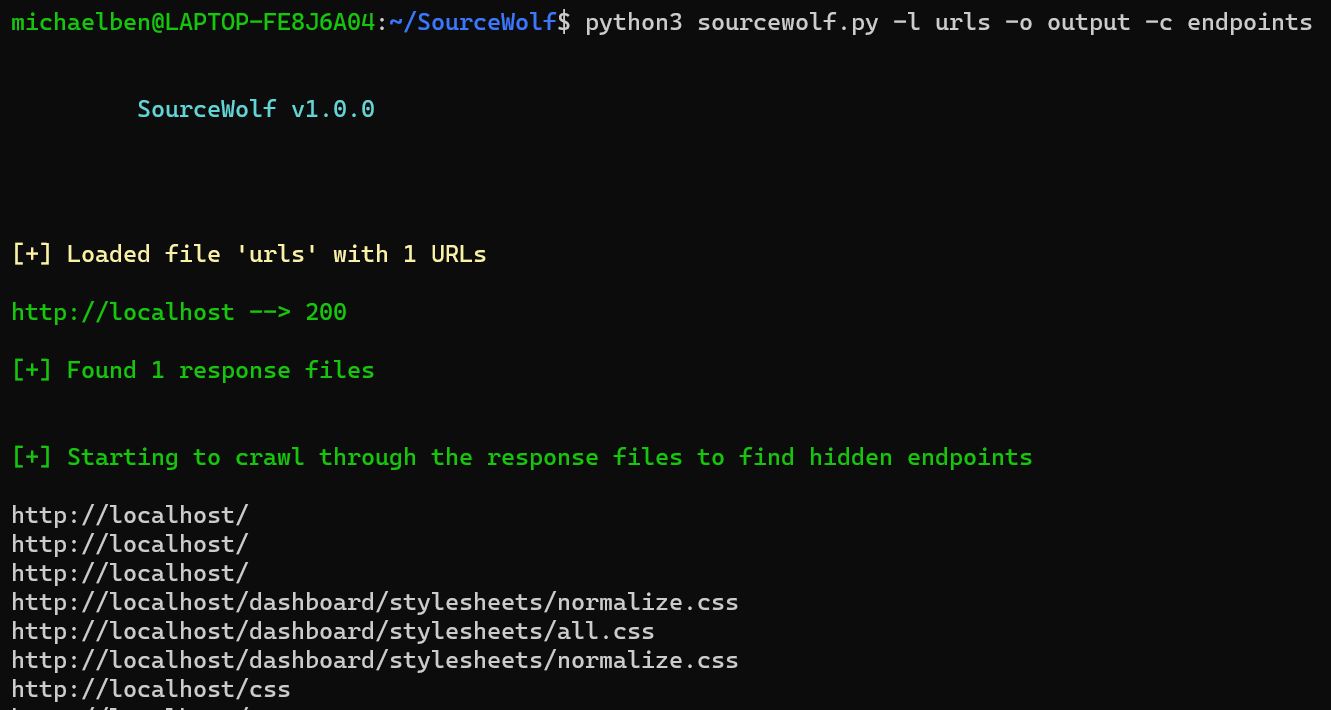
Utilisation complète :
python3 sourcewolf.py -l domaines -o output/ -c crawl_output
domaines est la liste des URLs que vous souhaitez parcourir, au format :
https://example.com/
https://exisiting.example.com/
https://exisiting.example.com/dashboard
https://example.com/hitme
output/ est le répertoire où les fichiers texte de réponse du fichier d'entrée sont stockés.
Ils sont stockés au format output/2XX, output/3XX, output/4XX, et output/5XX.
output/2XX stocke les réponses avec code 2XX, et ainsi de suite !
crawl_output spécifié avec le drapeau -c est utilisé pour stocker la sortie, dans un répertoire que SourceWolf produit en parcourant les fichiers de réponse HTTP stockés dans le répertoire output/ (actuellement uniquement les points de terminaison)
Le répertoire crawl_output/ contient :
endpoints - Tous les points de terminaison trouvés
jsvars - Toutes les variables JavaScript
Le répertoire contiendra plus de fichiers au fur et à mesure que davantage de modules et de fonctionnalités seront intégrés dans SourceWolf.
(OU)
Pour une URL unique,
python3 sourcewolf.py -u example.com/api/endpoint -o output/ -c crawl_output
Seul le drapeau -l est remplacé par -u, tout le reste reste identique.
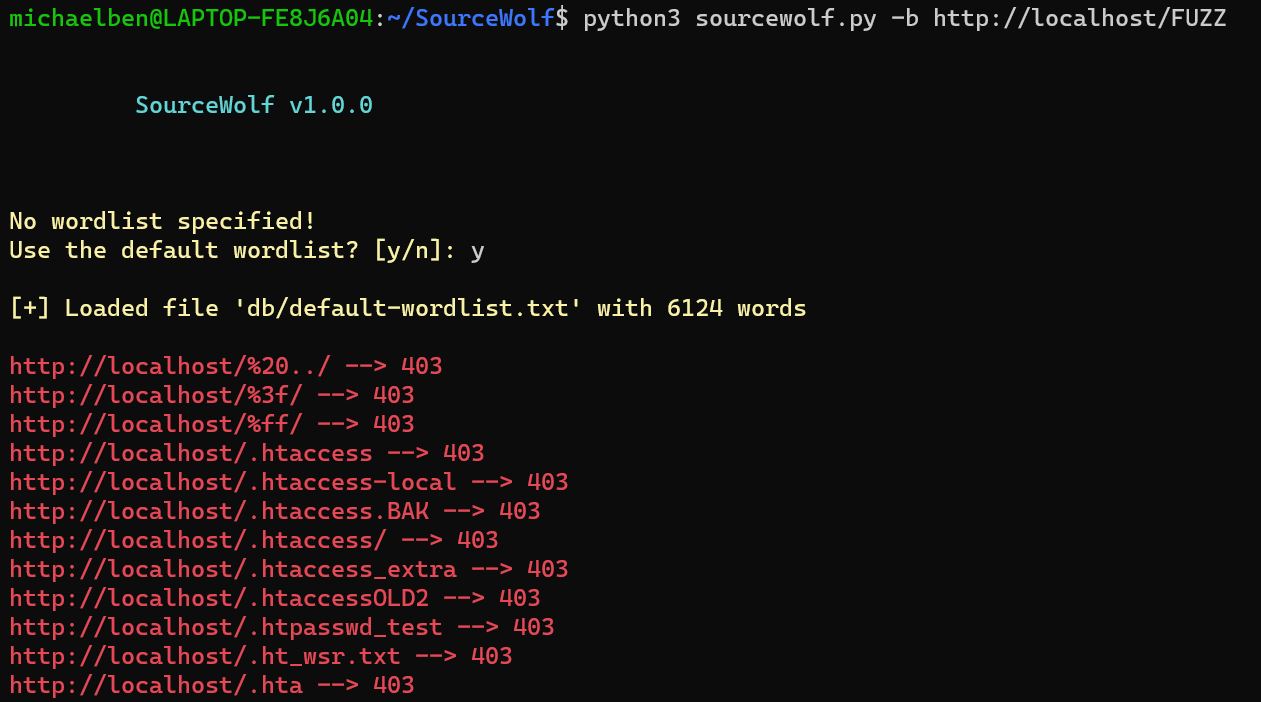
python3 sourcewolf.py -b https://hackerone.com/FUZZ -w /chemin/vers/wordlist -s statut
Le drapeau -w est facultatif. S'il n'est pas spécifié, une liste de mots par défaut de 6124 mots sera utilisée.
SourceWolf remplace le mot-clé FUZZ de la valeur -b par les mots de la liste de mots et envoie les requêtes. Cela vous permet également de forcer brutalement les valeurs des paramètres GET.
-s stockera la sortie dans un fichier nommé statut
Capture d'écran non incluse car la sortie ressemble au mode
parcours de réponse.
python3 sourcewolf -l domaines -s live
Le fichier domaines peut contenir n'importe quoi : sous-domaines, points de terminaison, fichiers JS.
Le drapeau -s écrit la réponse dans le fichier live.
Les modes forçage brutal et sondage affichent tous les codes d'état sauf 404 par défaut. Vous pouvez personnaliser ce comportement pour n'afficher que les réponses
2XXen utilisant le drapeau--only-success.
SourceWolf utilise également le multithreading.
Le nombre de threads par défaut pour tous les modes est de 5. Vous pouvez augmenter le nombre de threads avec le drapeau -t.
