Pyison
Pyison est un tarpit pour les robots d'indexation IA
Introduction
- Comme tous les robots d'indexation web, les bots IA demandent des pages aux serveurs web, puis suivent les liens de la page vers d'autres pages. Ce faisant, ils peuvent construire un index d'un site web entier.
- Contrairement aux autres robots d'indexation, cependant, les bots IA présentent des problèmes uniques
- Les administrateurs de serveurs peuvent configurer un fichier robots.txt, qui indique aux robots d'indexation quelles pages ils doivent ou ne doivent pas explorer.
- Certains robots d'indexation IA se sont avérés ignorer ce fichier. Il existe des préoccupations de confidentialité et de droit d'auteur concernant l'autorisation de ces bots à utiliser les données d'un site web pour entraîner des LLM, surtout lorsque l'utilisateur a explicitement refusé l'exploration.
- Certains robots ignorent également la limitation de débit. Lorsqu'ils demandent des pages le plus rapidement possible, ils peuvent imposer une charge importante à un serveur web.
- C'est ici qu'intervient Pyison. Comme d'autres tarpits pour robots IA (Nepenthes, Iocane), Pyison fournit aux robots d'indexation web une liste infinie de liens vers d'autres pages de son site. Cela piège les robots sur un seul site, où ils navigueront sans fin dans une mer de liens sans cesse croissante.
- Maintenir les robots IA coincés au même endroit les empêche d'indexer d'autres parties du site que le propriétaire pourrait ne pas vouloir fournir aux LLM.
- En même temps, ces pages peuvent contenir des tonnes de texte inutile. Lorsque les LLM intègrent ce texte dans leurs modèles, ils peuvent être progressivement « empoisonnés », car l'entrée aléatoire rendra leurs réponses moins cohérentes.
Motivations
- Créer un logiciel utile pour faire face à la montée du vol de contenu par les LLM
- Résoudre les problèmes des tarpits IA existants :
- Générer du texte aléatoire sans utiliser de chaîne de Markov, de LLM ou d'échantillons d'écriture existants
- Ne pas discriminer les bots IA par l'en-tête User-Agent, car les robots se déguisent souvent en utilisateurs normaux
- Concevoir un site réaliste de style blog afin d'éviter la détection
- Créer un framework extrêmement personnalisable pour permettre une configuration supplémentaire
- Fournir une solution qui peut facilement s'intégrer à un site web existant
- Prend en charge sans les exiger les proxys inverses/serveurs web spécifiques, et fournit une configuration de sous-chemin avec un paramètre de racine de document
- Fonctionner avec une faible empreinte plutôt qu'un CMS complet ou un serveur web riche en fonctionnalités
Spécifications techniques
- Ce projet exécute un serveur web dynamique utilisant la bibliothèque HTTPServer de Python
- Les phrases sont produites à partir d'un mélange 50/50 entre des mots anglais aléatoires et des « mots vides » (stop words)
- Pyison utilise un sel global ainsi qu'une URL de page pour initialiser son générateur de nombres aléatoires. Cela garantit que si les robots effectuent un « contrôle de cohérence » en rechargeant une page, elle sera identique à la dernière fois qu'ils l'ont vérifiée. En même temps, différents serveurs devraient utiliser des graines globales différentes afin que tous les sites utilisant Pyison ne se ressemblent pas.
- Il est possible de générer un nombre illimité de pages, car Pyison ne crée en réalité aucun fichier permanent. C'est un serveur web dynamique, il génère donc simplement du HTML et l'envoie au client.
- L'utilisation de balises de contenu HTML, du formatage CSS et d'images devrait rendre le site un peu plus réaliste aux yeux d'un robot.
- Il est possible de configurer la sortie de Pyison sans réécrire le programme, en modifiant les fichiers de configuration, statiques et de modèles
- Pyison répond aux requêtes POST et PUT erronées par un code 404 au cas où les robots testeraient si ces verbes HTTP sont configurés
Pour commencer
-
Clonez ce projet dans un dossier local
-
Modifiez les paramètres du fichier config/config.json
- Définissez
random-seed sur un nombre aléatoire !
- Définissez le numéro de
port que le serveur doit utiliser
- Voir la section Configuration pour plus d'informations
-
(Facultatif mais recommandé) Mettez à jour le modèle HTML, le CSS, les images et robots.txt à votre convenance
- Ce projet est plus efficace si les pages semblent différentes, ce qui peut être fait en variant la structure HTML et CSS. Réorganisez et renommez certains éléments, ou réécrivez-les complètement.
-
(Facultatif) Modifiez robots.txt si vous voulez changer les bots concernés
-
Configurez l'environnement du serveur avec l'une des méthodes ci-dessous
-
Placez le serveur derrière un proxy inverse
Exécution locale
- Installez nltk
- Exécutez Pyison
- Vérifiez que ça fonctionne
- Ouvrez
http://localhost:<votre numéro de port> dans un navigateur
Docker
Avec docker compose
Avec docker run
docker run --tty --name pyison -p "127.0.0.1:80:80" --rm ghcr.io/jonaslong/pyison:main
- (Facultatif) Supprimez l'option
--rm pour conserver le conteneur
Construction à partir des sources
- Clonez le dépôt localement
docker build -t pyison:latest .- Exécutez le conteneur avec
docker run --tty --name pyison -p "127.0.0.1:80:80" --rm pyison:latest
Proxy inverse
Il est fortement recommandé d'utiliser un proxy inverse pour servir ce contenu. Il peut réduire la charge du serveur en mettant en cache les pages et en introduisant des limitations de débit, ainsi que servir le contenu en https et protéger contre certaines exploitations de base des serveurs web.
Considérations
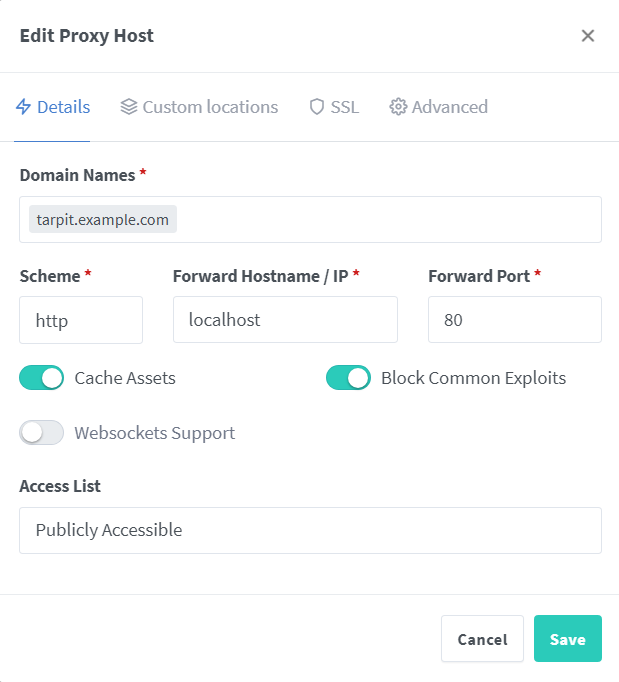
- Ces exemples utilisent Nginx Proxy Manager, mais tout logiciel de proxy inverse devrait fonctionner
- Pyison prend en charge les paramètres SSL les plus stricts de NPM
- NPM devrait transmettre l'en-tête http
User-Agent de NPM au serveur Pyison sans configuration spéciale. Utilisez proxy_pass_header User-Agent; si nécessaire.
Configuration de sous-domaine indépendant
 jonaslong/pyison