
 jev-sec/jev-ids
Système de détection d'intrusion (IDS) ultra-rapide et économe en tokens basé sur Jev de TypeSafe.


La détection d'intrusion en une requête. Présentez à Jev de TypeSafe un flux réseau et cinq exemples étiquetés. Il répond si le flux est une attaque et de quel type, en une demi-seconde, sans texte à analyser.
Jev IDS a été testé sur NSL-KDD, un benchmark de référence de la communauté de la cybersécurité, face à un LLM de pointe (Gemini 3.6 Flash sur Vertex AI), un modèle classique d'apprentissage automatique (Random Forest) et un modèle non supervisé (Isolation Forest) : 2 000 flux, trois graines, k de 0 à 8 exemples par catégorie. Avec les mêmes cinq exemples (k = 1), Jev IDS était :
Le LLM est le meilleur détecteur en F1 : 0,880 contre 0,856 pour Jev à k = 1, et en tête à chaque k (McNemar p < 0,001), parce qu'il détecte plus d'attaques des types montrés dans les exemples. Jev est le deuxième meilleur, et sur les attaques zero-day, des types absents des exemples, il en détecte plus que le LLM de k = 1 à k = 8 (0,747 contre 0,713 à k = 1). Les chiffres, les figures et leurs limites sont dans Preuves et limites et docs/results.md.
Lire la boucle · Le modèle de requête · Glossaire
Jev est un System One Model. Au lieu d'écrire du texte, il lit un state et répond à des questions typées à son sujet avec des probabilités. Jev IDS place un flux dans le state, à côté des instructions, des noms de colonnes, des cinq descriptions de catégories et des exemples étiquetés, et pose deux questions. is_attack revient sous forme de probabilité. category revient comme l'une de cinq options avec une confiance. Le verdict est attaque lorsque la probabilité atteint 0,5.
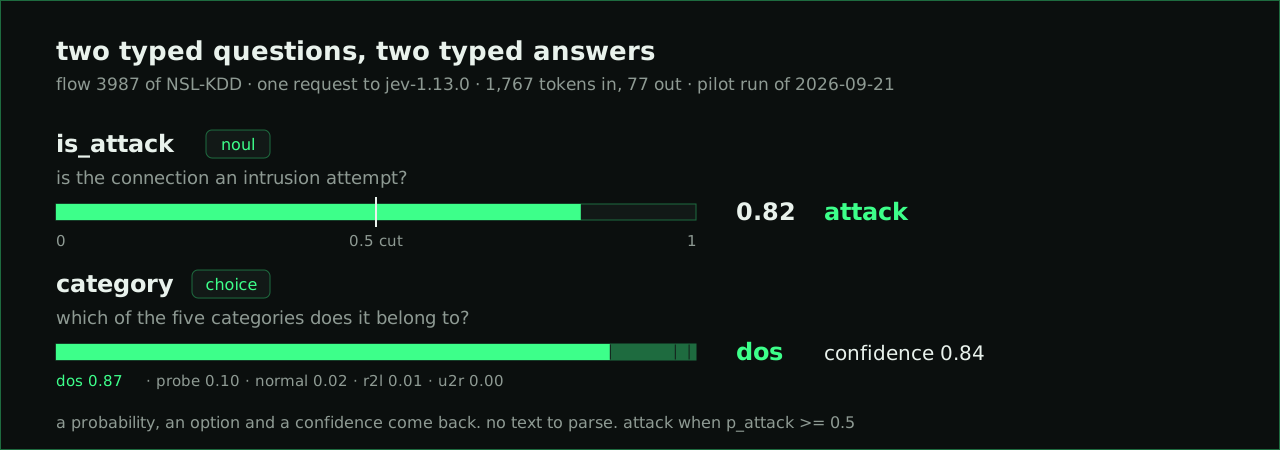
Chaque requête suit le même chemin :
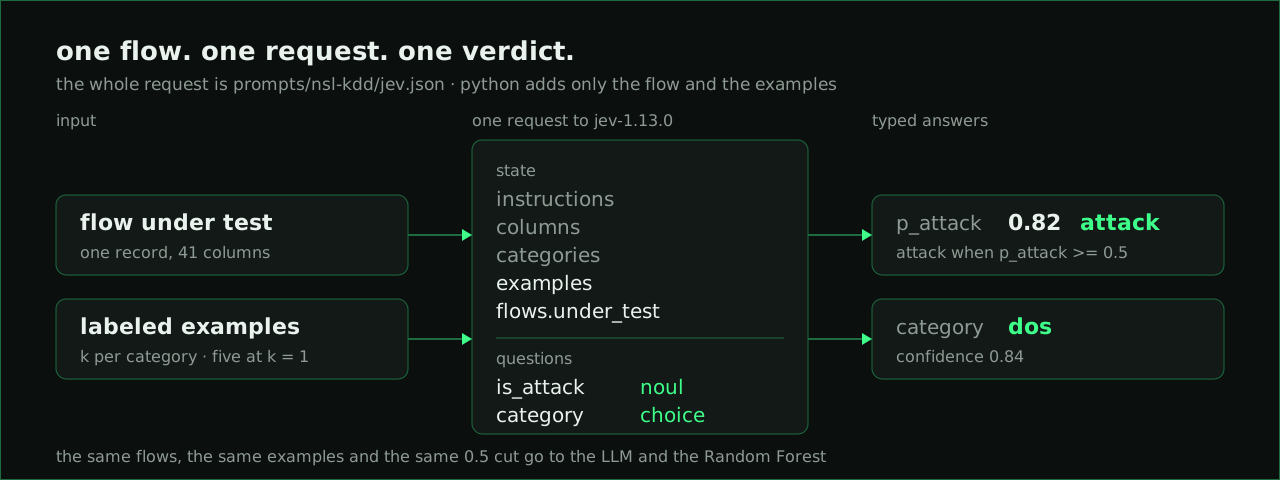
La requête entière est un seul fichier, prompts/nsl-kdd/jev.json. Python n'ajoute que le flux et les exemples, et le sha256 du fichier voyage dans chaque ligne de prédiction sous le nom prompt_hash, de sorte que des exécutions ayant demandé des choses différentes ne sont jamais comparées comme égales. Les exemples sont étiquetés par catégorie uniquement : les noms d'attaques tels que neptune n'atteignent jamais un modèle.
Les mêmes flux, exemples et seuil de 0,5 sont envoyés à deux baselines : un LLM via un agent Agno avec un schéma de sortie JSON (Gemini 3.6 Flash via Vertex AI dans l'article ; GPT-5.6 via le backend ChatGPT Codex ou DeepSeek comme alternatives) et une Random Forest scikit-learn entraînée sur les mêmes exemples. Une troisième baseline, un Isolation Forest ajusté sur les seuls flux bénins du pool, ne voit jamais d'exemple : c'est la référence non supervisée, à k = all uniquement.
git clone https://github.com/jev-sec/jev-ids.git
cd jev-ids
uv sync
# .env: TYPESAFE_API_KEY for Jev. Gemini needs `gcloud auth application-default login` and GOOGLE_GENAI_USE_VERTEXAI=true,
# GOOGLE_CLOUD_PROJECT and GOOGLE_CLOUD_LOCATION=global in the environment; DEEPSEEK_API_KEY and CHATGPT_CLIENT_ID only for the other LLMs.
Téléchargez NSL-KDD dans data/raw/nsl-kdd/ et préparez-le une fois :
uv run python -m scripts.prepare_nsl_kdd
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split smoke --k 0,1
Le split smoke contient cinq flux. L'exécution écrit results/<timestamp>-nsl-kdd-jev-smoke/ avec config.json, une ligne JSON par flux dans predictions.jsonl (le verdict, la vérité, p_attack, la catégorie, la confiance, la latence et le rapport de tokens de la passerelle) et les réponses brutes dans responses.jsonl.
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector jev --split pilot --k 0,1,2,4,8 --seeds 0,1,2
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector llm:gemini --model gemini-3.6-flash --split pilot --k 0,1,2,4,8
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector random_forest --split pilot --k 1,2,4,8,all
uv run jev-ids run --dataset data/nsl-kdd/dataset.json --detector isolation_forest --split pilot --k all
uv run jev-ids metrics results/<run_id> [results/<run_id> ...] > results/summary.csv
uv run jev-ids compare --a results/<jev_run> --b results/<rf_run> --subset novel --k-a 0 --k-b all  # novel = zero-day attacks
k est le nombre d'exemples étiquetés par catégorie. k = 1 avec cinq catégories signifie cinq exemples, et all signifie le pool entier. metrics affiche une ligne CSV par détecteur et par k avec le F1, le rappel sur les attaques zero-day (novel dans le code) et par catégorie, la PR-AUC et la ROC-AUC de p_attack, les tokens, la latence et le coût. compare apparie deux exécutions flux par flux et exécute le test de McNemar sur les paires discordantes, car seuls les flux sur lesquels deux détecteurs sont en désaccord permettent de les distinguer. Le coût est calculé hors ligne comme le nombre de tokens multiplié par les prix catalogue dans prices.json, pour tous les détecteurs de la même manière.

