 hpthreatresearch/subcrawl
Framework modulaire pour découvrir et analyser les répertoires ouverts sur le web. Explore les URLs, extrait le contenu, applique une analyse YARA/ClamAV, et envoie les résultats vers MISP, SQLite ou la console pour le renseignement sur les menaces.

SubCrawl est un framework développé par Patrick Schläpfer, Josh Stroschein et Alex Holland de l’équipe Threat Research de HP Inc. SubCrawl est conçu pour trouver, scanner et analyser des répertoires ouverts. Le framework est modulaire, composé de quatre composants : modules d’entrée, modules de traitement, modules de sortie et le moteur de crawl principal. Les URL sont les valeurs d’entrée principales, que le framework analyse et ajoute à un système de file d’attente avant de les crawler. L’analyse des URL est une première étape importante, car elle prend une URL soumise et génère des URL supplémentaires à crawler en supprimant les sous-répertoires, un par un, jusqu’à ce qu’il n’en reste plus. Ce processus garantit une tentative de scan plus complète d’un serveur web et peut mener à la découverte de contenu supplémentaire. Notamment, SubCrawl n’utilise pas de méthode par force brute pour découvrir des URL. Tout le contenu scanné provient des URL d’entrée, du processus d’analyse de l’URL et de la découverte lors du crawl. Lorsqu’un répertoire ouvert est découvert, le moteur de crawl extrait les liens du répertoire pour évaluation. Le moteur de crawl détermine si le lien est un autre répertoire ou un fichier. Les répertoires sont ajoutés à la file d’attente de crawl, tandis que les fichiers subissent une analyse supplémentaire par les modules de traitement. Des résultats sont générés et stockés pour chaque URL scannée, comme les hachages SHA256 et flous du contenu, la présence d’un répertoire ouvert, ou les correspondances avec des règles YARA. Enfin, les données de résultat sont traitées selon un ou plusieurs modules de sortie, dont il existe actuellement trois. Le premier fournit une intégration avec MISP, le second affiche simplement les données dans la console, et le troisième stocke les données dans une base de données SQLite. Comme le framework est modulaire, il est non seulement facile de configurer les modules d’entrée, de traitement et de sortie souhaités, mais aussi simple de développer de nouveaux modules.
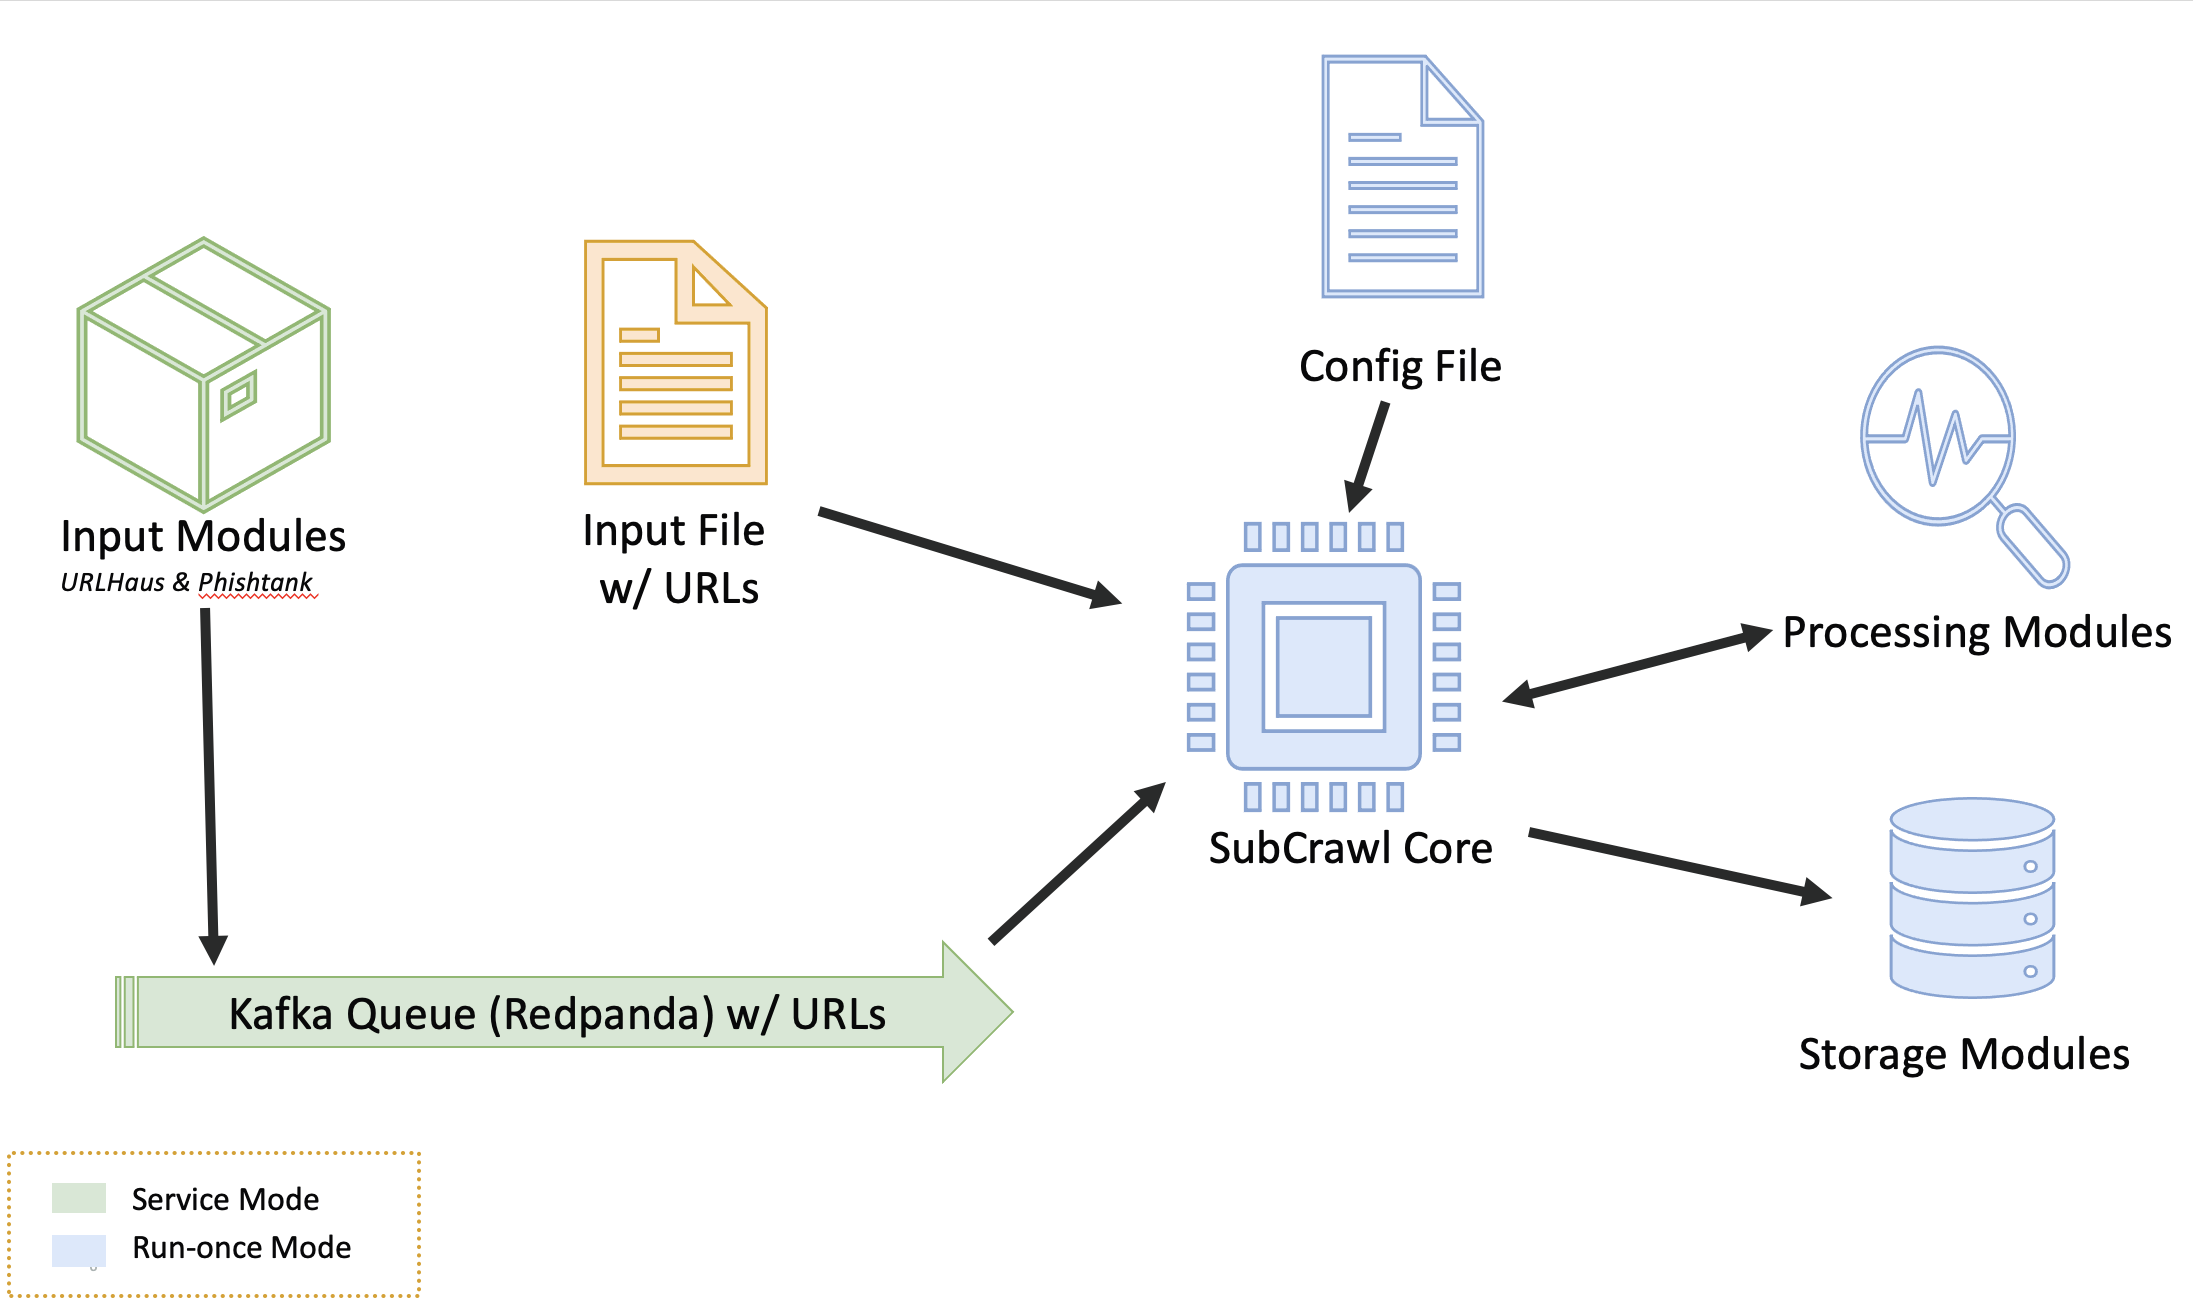 Figure 1 - Architecture de SubCrawl
SubCrawl prend en charge deux modes de fonctionnement différents. Premièrement, SubCrawl peut être démarré en mode exécution unique. Dans ce mode, l’utilisateur fournit les URL à scanner dans un fichier où chaque valeur d’entrée est séparée par un saut de ligne. Le deuxième mode de fonctionnement est le mode service. Dans ce mode, SubCrawl s’exécute en arrière-plan et repose sur les modules d’entrée pour fournir les URL à scanner. La figure 1 montre un aperçu de l’architecture de SubCrawl. Les composants utilisés dans les deux modes de fonctionnement sont en bleu, les composants du mode exécution unique sont en jaune, et les composants du mode service sont en vert.
Selon le mode d’exécution choisi, d’autres conditions préalables doivent être remplies.
SubCrawl est écrit en Python3. De plus, plusieurs paquets sont nécessaires avant d’exécuter SubCrawl. La commande suivante peut être utilisée pour installer tous les paquets requis avant d’exécuter SubCrawl. Depuis le répertoire crawler, exécutez la commande suivante :
$ sudo apt install build-essential
$ pip3 install -r requirements.txt
Si SubCrawl est démarré en mode service, cela peut être fait en utilisant Docker. Pour cette raison, l’installation de Docker et Docker Compose est requise. De bonnes instructions d’installation se trouvent directement sur le site Web de Docker.com.
SubCrawl dispose d’une aide intégrée via l’argument -h/--help ou simplement en exécutant le script sans aucun argument.
  ********         **        ******                               **
 **//////         /**       **////**                             /**
/**        **   **/**      **    //  ******  ******   ***     ** /**
/*********/**  /**/****** /**       //**//* //////** //**  * /** /**
////////**/**  /**/**///**/**        /** /   *******  /** ***/** /**
       /**/**  /**/**  /**//**    ** /**    **////**  /****/**** /**
 ******** //******/******  //****** /***   //******** ***/ ///** ***
////////   ////// /////     //////  ///     //////// ///    /// ///
~~ Moissonnage du Web Ouvert ~~

usage: subcrawl.py [-h] [-f FILE_PATH] [-k] [-p PROCESSING_MODULES] [-s STORAGE_MODULES]

optional arguments:
  -h, --help            show this help message and exit
  -f FILE_PATH, --file FILE_PATH
                        Path of input URL file
  -k, --kafka           Use Kafka Queue as input
  -p PROCESSING_MODULES, --processing PROCESSING_MODULES
                        Processing modules to be executed comma separated.
  -s STORAGE_MODULES, --storage STORAGE_MODULES
                        Storage modules to be executed comma separated.

  Available processing modules:
  - ClamAVProcessing
  - JARMProcessing
  - PayloadProcessing
  - TLSHProcessing
  - YARAProcessing

  Available storage modules:
  - ConsoleStorage
  - MISPStorage
  - SqliteStorage
Ce mode est adapté si vous souhaitez scanner rapidement un nombre gérable de domaines. Pour cela, les URL à scanner doivent être sauvegardées dans un fichier, qui sert ensuite d’entrée pour le crawler. Voici un exemple d’exécution en mode exécution unique, notez que l’argument -f est utilisé avec un chemin vers un fichier.
python3 subcrawl.py -f urls.txt -p YARAProcessing,PayloadProcessing -s ConsoleStorage
Avec le mode service, une plus grande quantité de domaines peut être scannée et les résultats sauvegardés. En fonction du module de stockage sélectionné, les données peuvent ensuite être analysées et évaluées plus en détail. Pour faciliter au maximum l’exécution du mode service pour l’utilisateur, nous avons intégré toutes les fonctionnalités dans une image Docker. En mode service, les domaines à scanner sont obtenus via les modules d’entrée. Par défaut, les nouvelles URL de malwares et de phishing sont téléchargées depuis URLhaus et PhishTank et mises en file d’attente pour le scan. Les modules de traitement et de stockage souhaités peuvent être saisis directement dans le config.yml. Par défaut, les modules de traitement suivants sont activés, utilisant le stockage SQLite :
En plus du module de stockage SQLite, une interface web simple a été développée qui permet de visualiser et de gérer les domaines et URL scannés.
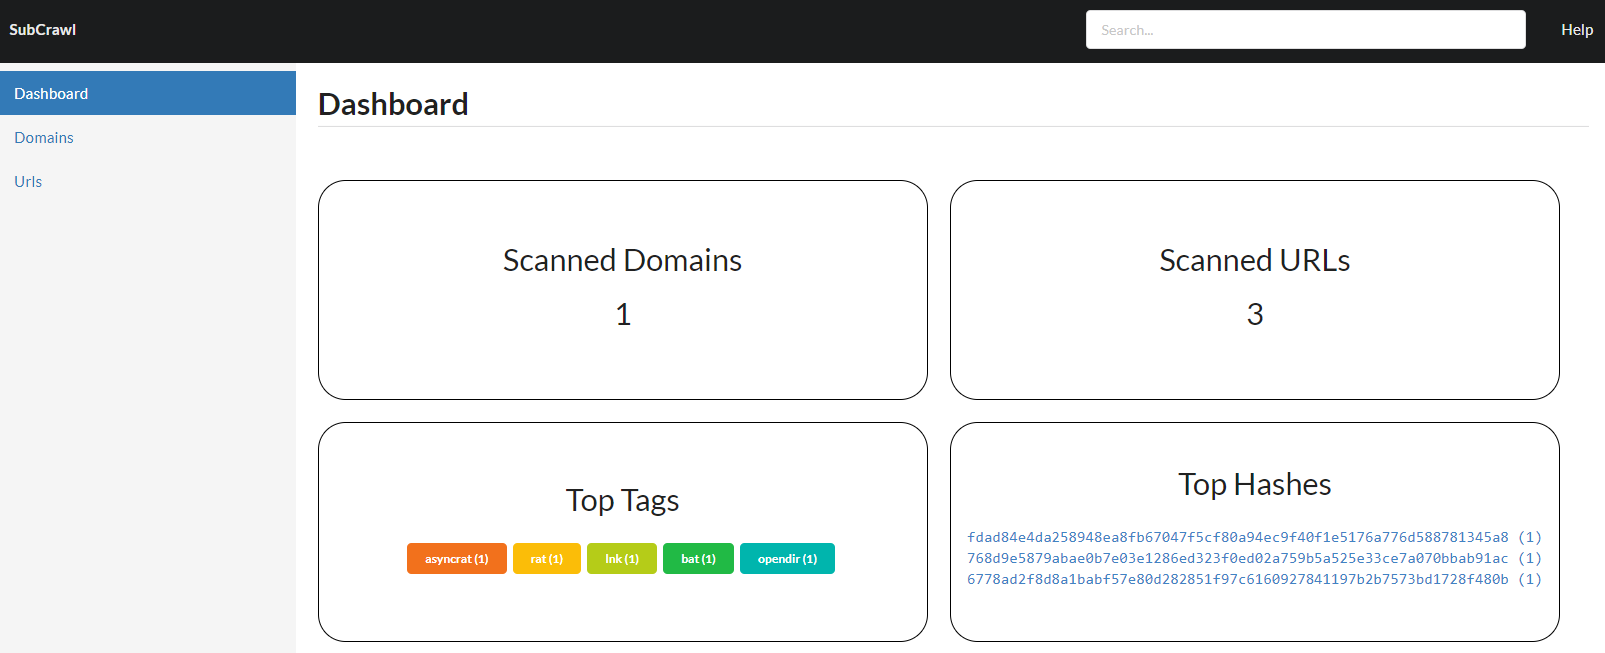
Cependant, si cette interface ne suffit pas pour l’évaluation ultérieure des données, le module de stockage MISP peut être activé en alternative ou en complément. Les paramètres correspondants doivent être configurés dans config.yml sous la section MISP.
Les deux commandes suivantes suffisent pour cloner le dépôt GIT, créer le conteneur Docker et le démarrer directement. Ensuite, l’interface web est accessible à l’adresse https://localhost:8000/. Veuillez noter qu’une fois les conteneurs démarrés, les modules d’entrée commenceront à ajouter des URL à la file d’attente de traitement et le moteur commencera à crawler les hôtes.
git clone https://github.com/hpthreatresearch/subcrawl.git

docker-compose up --build
