
Scanner de vulnérabilités de code source basé sur le Web
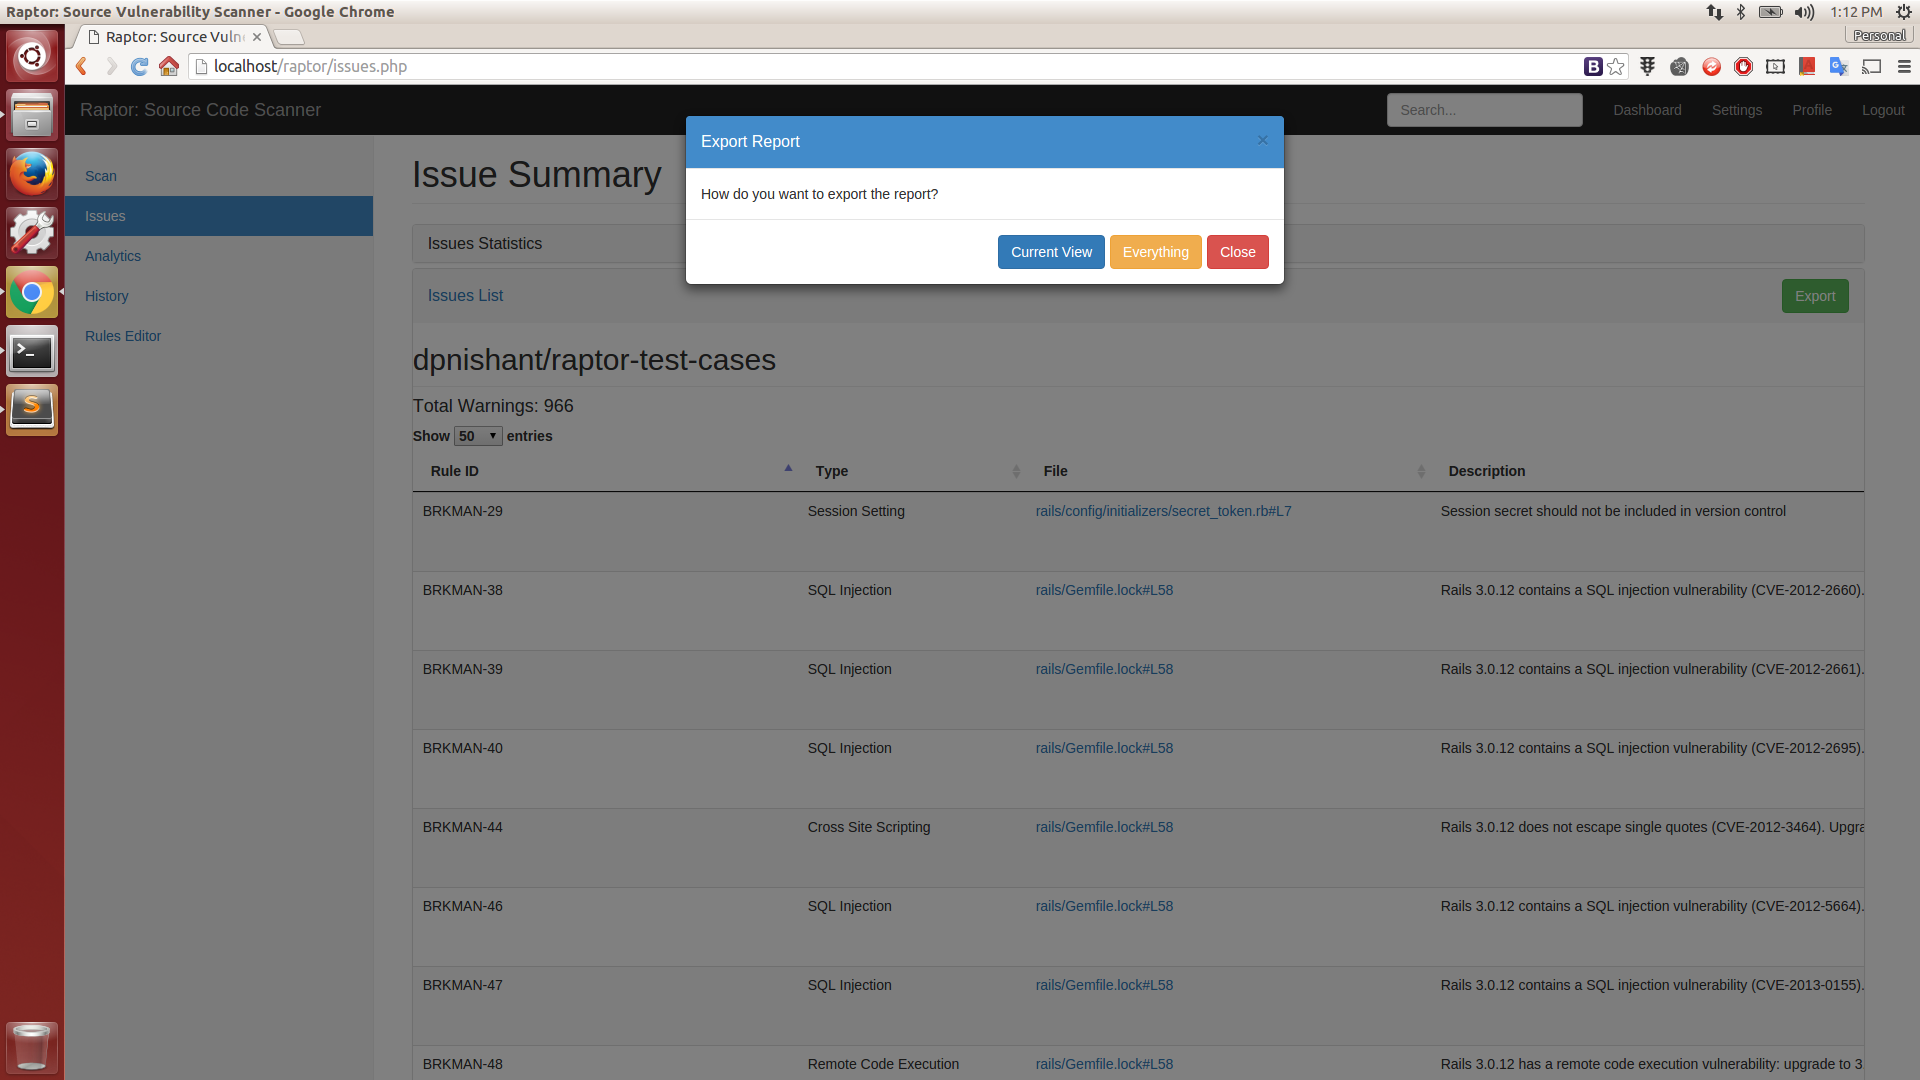
Raptor est un scanner de vulnérabilités de code source orienté GitHub, basé sur le web (service web + interface utilisateur). Il analyse un dépôt à partir de l'URL GitHub. Vous pouvez configurer des webhooks pour lancer des analyses automatiques à chaque commit ou fusion de pull request. L'analyse est asynchrone et les résultats ne sont visibles que par l'utilisateur qui a lancé l'analyse.
Quelques fonctionnalités de Raptor :
Cet outil est une tentative d'aider la communauté et les start-ups à accorder de l'importance au codage sécurisé. Cet outil peut ou non égaler les fonctionnalités/qualité des alternatives commerciales, rien n'est garanti et vous êtes prévenu. Cet outil est destiné aux relecteurs de code de sécurité et/ou aux développeurs ayant une expérience en codage sécurisé pour trouver les points d'entrée de vulnérabilités lors d'audits de code ou de relectures par les pairs. Veuillez NE PAS vous fier aveuglément aux résultats de l'outil. Il est préférable d'utiliser Raptor en l'intégrant à votre pipeline CI/CD.
0.1 bêta
Plugins intégrés :
Remarque : La plupart des outils/modules/bibliothèques suivants ont été fortement modifiés pour s'intégrer correctement au framework.
Packs de règles disponibles :
Vidéo d'installation : YouTube Install
$ wget https://github.com/dpnishant/raptor/archive/master.zip -O raptor.zip
$ unzip raptor.zip
$ cd raptor-master
$ sudo sh install.sh
Vidéo d'utilisation : YouTube Usage
cd raptor-master
sudo sh start.sh #démarre le service web en arrière-plan
Pointez maintenant votre navigateur vers Raptor Home (http://localhost/raptor/)
Connectez-vous avec le nom d'utilisateur enregistré sur le serveur GitHub correspondant auquel vous êtes connecté et n'importe quel mot de passe (mais retenez le nom d'utilisateur pour consulter l'historique des analyses).
Par exemple :
Si vous êtes enregistré en tant que foobar sur https://github.com, utilisez le même nom d'utilisateur pour analyser des dépôts sur https://github.com. Cependant, si vous êtes enregistré en tant que foobar_corp sur votre GitHub personnel/d'entreprise (par exemple https://github.corp.company.com), utilisez ce même nom d'utilisateur si vous souhaitez analyser des dépôts sur https://github.corp.company.com.
Cependant, pour l'instant, le mot de passe peut être n'importe quoi, car nous n'avons PAS implémenté de base de données dans la version de développement.
Vous pouvez utiliser l'éditeur de règles léger côté client fourni pour ajouter de nouvelles règles personnalisées selon vos besoins spécifiques, ou tout autre éditeur de texte brut, car les fichiers de packs de règles sont de simples structures JSON. Utilisez votre navigateur pour ouvrir les règles situées dans 'backend/rules'. Une fois terminé, enregistrez votre fichier de règles nouveau/modifié dans le même répertoire, c'est-à-dire 'backend/rules'. Il ne vous reste plus qu'à modifier un petit détail ici : Script d'initialisation. Ajoutez le nom de votre nouveau fichier de pack de règles à ce tableau sans l'extension '.rulepack' et redémarrez le serveur d'arrière-plan. Vous voilà prêt ! 👍
Vous pouvez y accéder ici : Éditeur de règles (http://localhost/raptor/editrules.php)
Ajoutez un motif de nom de fichier ou de répertoire à exclure de l'analyse. Cela permet d'ignorer des fichiers connus comme jquery.min.js ou par exemple tout le répertoire /test/. Par exemple, dans l'exemple ci-dessous, jquery signifie jquery et est sensible à la casse, soyez donc prudent. Dans la section plugins, le name du plugin est le nom du fichier de pack de règles sans l'extension ".rulepack" tel qu'il se trouve dans le répertoire rules/. Le champ issue est l'ID de l'issue mentionné dans chaque règle des fichiers de pack de règles : Exemple #1, Exemple #2. La valeur du champ match_type peut être regex, start ou end. Le champ value est la chaîne exacte à faire correspondre si match_type est start ou end. Si match_type est regex, la value doit contenir le motif RegEx brut qui doit être encodé en Base64 pour éviter tout problème d'échappement de syntaxe JSON. regex est une correspondance basée sur les expressions régulières, start correspondra au début de l'extrait et end à la fin de l'extrait.
Le fonctionnement est le suivant : une fois que le scanner a fini de rechercher les issues, il parcourt toutes les issues trouvées et supprime celles qui correspondent aux motifs (selon le type de correspondance) de chaque plugin mentionné dans le fichier ignore_list.rulepack.

