 cisagov/findcdn
Analyse les domaines pour identifier quel réseau de distribution de contenu (CDN) ils utilisent en effectuant une empreinte des en-têtes HTTPS, des enregistrements CNAME et des données WHOIS, avec une sortie JSON et la prise en charge de modules.


findcdn, est un outil qui peut scanner et détecter le type de
Content Distribution Network (CDN)
qu'un domaine utilise. findcdn peut enregistrer les résultats dans un fichier, être utilisé comme module, ou
simplement afficher sur stdout.
findcdn aide les utilisateurs de l'outil à déterminer avec précision quel CDN un domaine
utilise. La liste des domaines pris en charge est répertoriée dans le
fichier cdn_config.py
du dépôt. La bibliothèque peut être implémentée comme un outil autonome ou
un module importable dans votre projet. Dans les deux cas, les résultats peuvent être écrits
dans un fichier de sortie.
findcdn nécessite Python 3.7+. Python 2 n'est pas pris en charge.
findcdn
peut être installé comme module en utilisant pip et le fichier requirements.txt du
dépôt.
findcdn peut être installé via pip :
pip install --requirement requirements.txt
Il peut ensuite être exécuté directement :
findcdn list github.com
Alternativement, vous pouvez l'installer rapidement dans n'importe quel projet avec :
pip install git+https://github.com/cisagov/findcdn.git
Remarque : Il est recommandé d'utiliser un environnement virtuel Python pour installer les modules et garder votre environnement propre. Si vous souhaitez le faire, vous aurez besoin de pyenv et du plugin pyenv-virtualenv avant d'installer le module.
findcdn file <fileIn> [options]
findcdn list  <domain>... [options]
findcdn (-h | --help)

findcnd -h
findcdn file domains.txt -o output_cdn.txt -t 17 -d
findcdn list dhs.gov cisa.gov -o output_cnd.txt -v
findcdn list cisa.gov
  -h --help                    Affiche ce message.
  --version                    Affiche la version actuelle.
  -o FILE --output=FILE        Si spécifié, alors le fichier de sortie JSON sera
                               créé à la valeur spécifiée.
  -v --verbose                 Inclut des instructions d'affichage supplémentaires.
  --all                        Inclut les domaines avec et sans CDN
                               dans la sortie.
  -d --double                  Exécute les vérifications deux fois pour augmenter la précision.
  -t --threads=<thread_count>  Nombre de threads, sinon utilise la valeur par défaut.
  --timeout=<timeout>          Durée maximale en secondes pour attendre qu'un domaine
                               termine le traitement, sinon utilise la valeur par défaut.
  --user_agent=<user_agent>    Définit l'agent utilisateur à utiliser, sinon
                               utilise la valeur par défaut.
user2@ubuntu:~$ findcdn list asu.edu -t 7 --double
Using 7 threads.
[Pending: 0 jobs]==[Threads: 2]: 100%|███████████████████████████████| 2/2 [00:00<00:00,  2.22it/s]
{
    "date": "06/19/2020, 13:00:38",
    "CDN_count": "1",
    "domains": {
        "asu.edu": {
            "IP": "'104.16.50.14'",
            "cdns": "'.cloudflare.com'",
            "cdns_by_names": "'Cloudflare'"
        }
    }
}
Domain processing completed.
1 domains had CDN's out of 1.
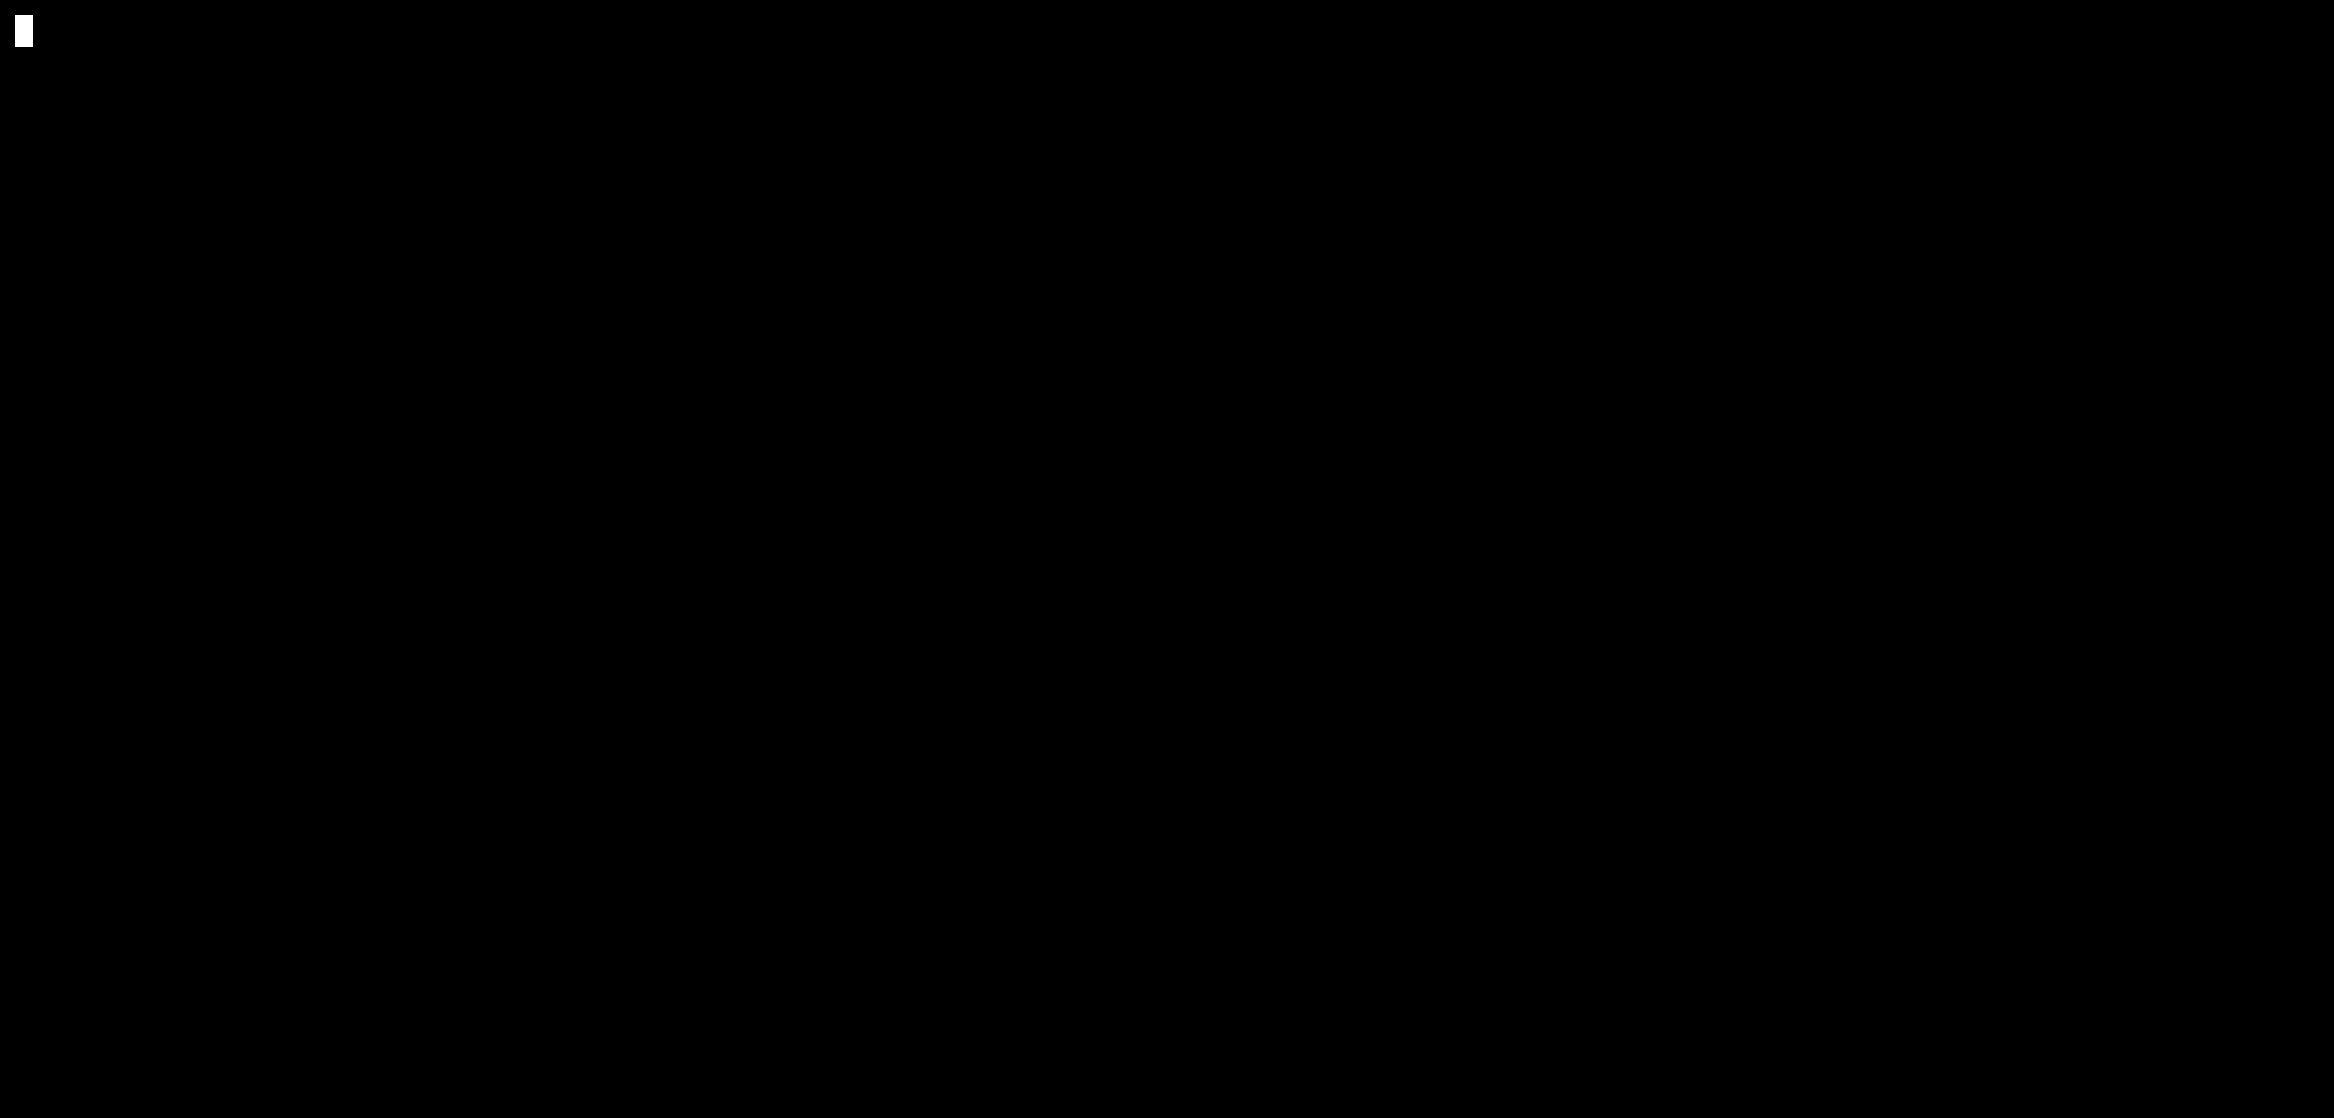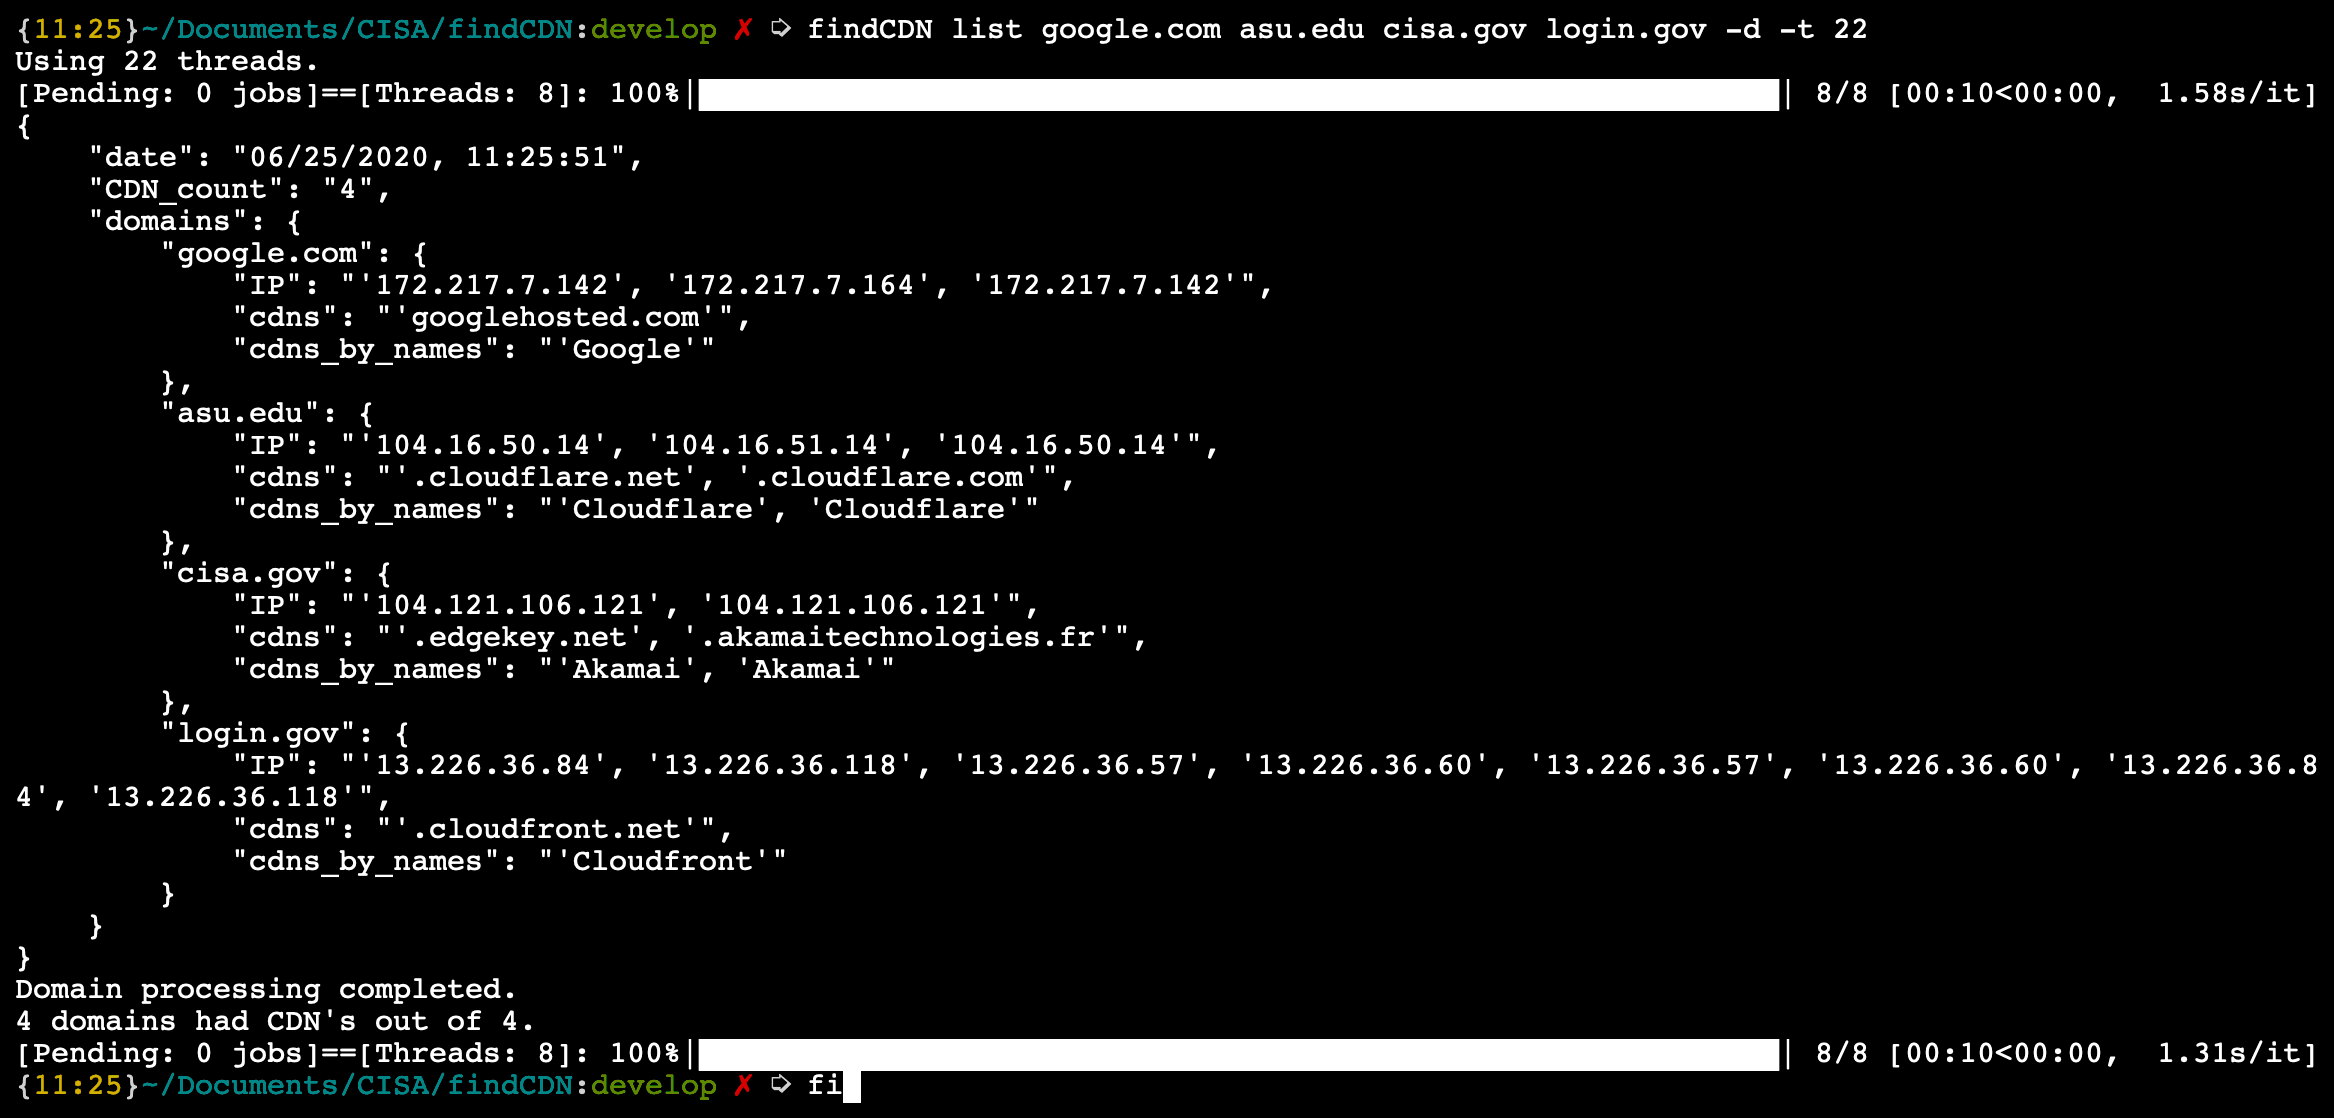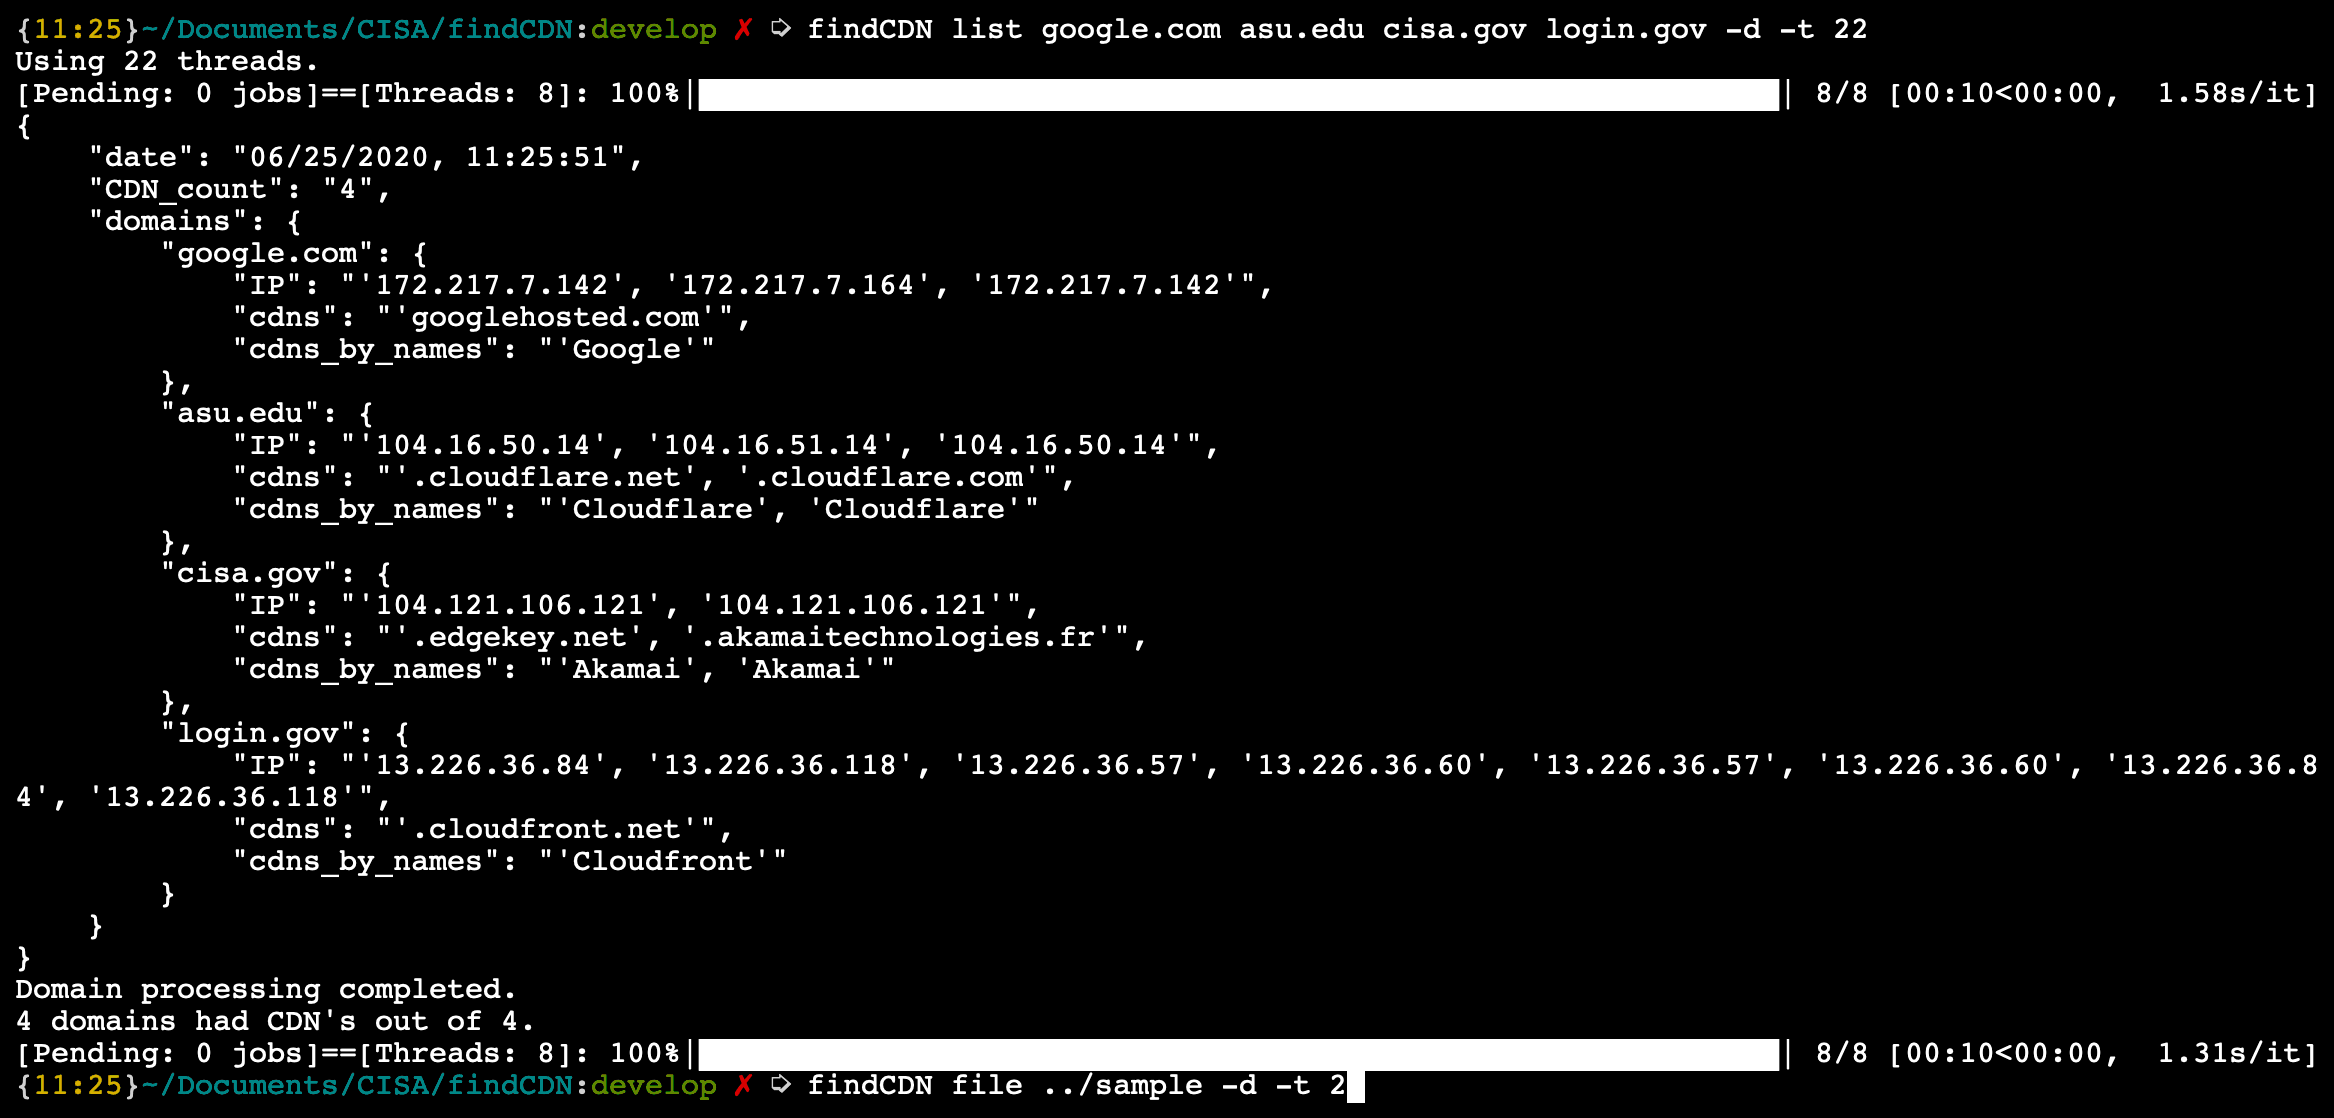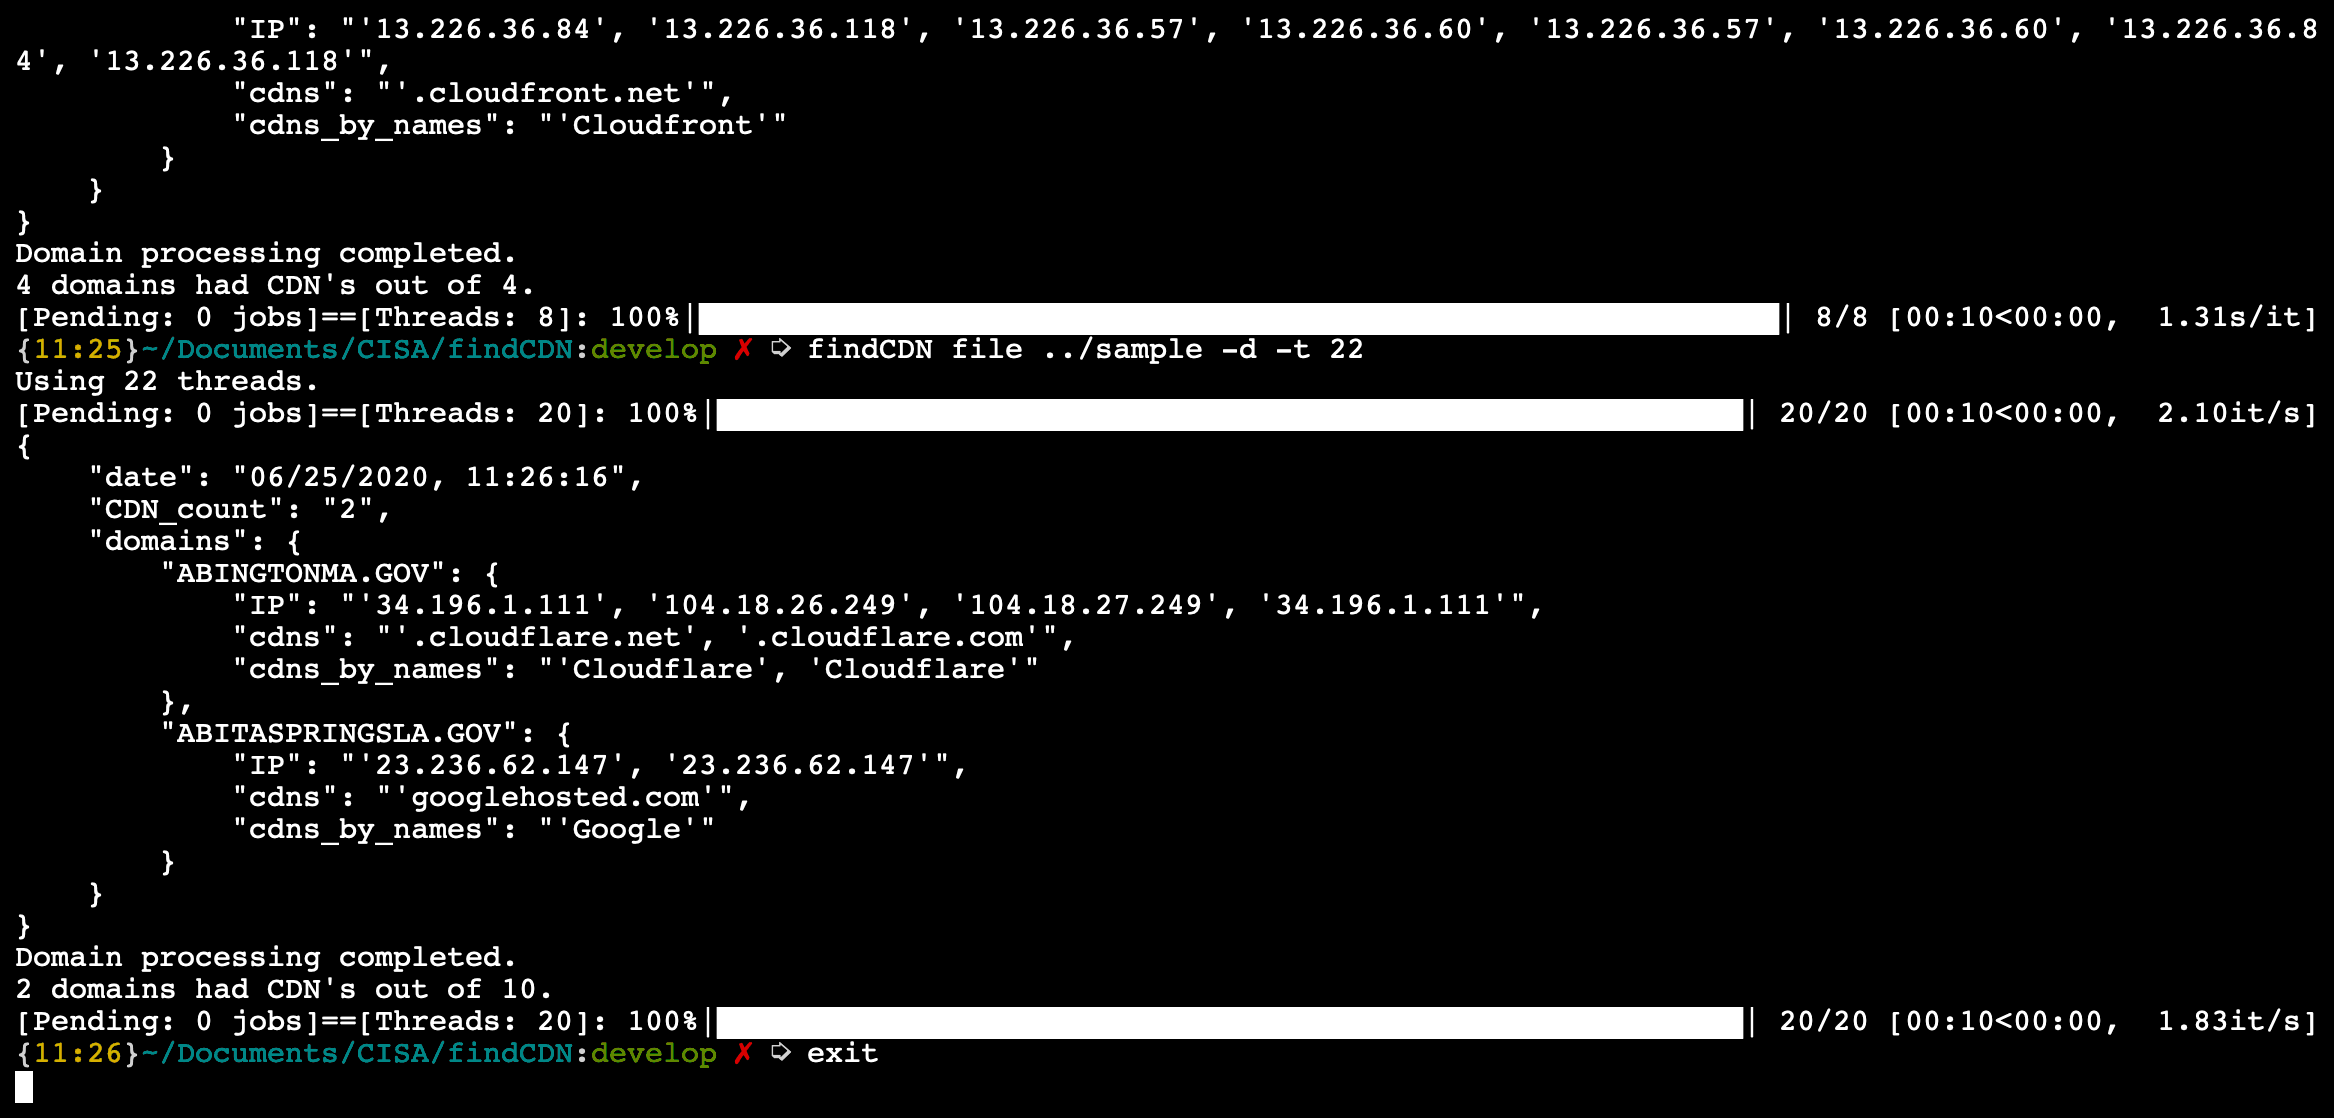
Puisque findcdn peut être installé comme module, sa capacité de détection de CDN peut être
appelée et implémentée dans n'importe quel projet. D'abord, importez findcdn dans votre
projet, comme montré ci-dessus. Ensuite, passez-lui une liste de domaines à analyser. Après
traitement, le programme retournera un objet JSON contenant les domaines
fournis et les CDN qu'ils utilisent.
Le fonctionnement de findcdn est déterminé par les options passées ; les options
possibles actuelles et un exemple sont écrits ci-dessous pour votre commodité :
findcdn.main(
    domain_list: List[str],  # List of domains to search
    output_path: str = None,  # if included, output results to JSON
    verbose: bool = False,  # Verbose mode (more printing!)
    all_domains: bool = False,  # Includes domains that dont have cdn's in the output
    interactive: bool = False,  # Includes a progress bar (normally used for command line)
    double_in: bool = False,  #D ouble the number of tries on a domain to increase accuracy
    threads: int = THREADS,  # Number of threads to use
    timeout: int = TIMEOUT,  # How long to wait on a domain
    user_agent: str = USER_AGENT,  # User Agent to use
)
import findcdn
import json

domains = ['google.com', 'cisa.gov', 'censys.io', 'yahoo.com', 'pbs.org', 'github.com']
resp_json = findcdn.main(domains, output_path="output.json", double_in=True, threads=23)

dumped_json = json.loads(resp_json)

for domain in dumped_json['domains']:
    print(f"{domain} has CDNs:\n {dumped_json['domains'][domain]['cdns']}")
findcdn est divisé en trois sections :
Chef utilisera la bibliothèque CDN Detection pour obtenir tous les CDN de chaque domaineChef exécute ensuite une analyse pour définir la valeur booléenne has_cdn s'il détecte
qu'un domaine possède un CDN, puis retourne la liste des domaines au fichier principalcdn_config.py.L'objectif initial de cet outil était de détecter automatiquement si un domaine qui utilise un CDN est frontable. En raison de la surcharge importante pour la détection de fronting, nous avons réorienté le développement de cet outil pour qu'il soit exclusivement un outil de détection de CDN. Nous utilisons notre wiki pour décrire plus en détail ce qu'est le Domain Fronting, nos notes de recherche, nos décisions de conception et nos playbooks pour le fronting de domaines spécifiques. Si vous trouvez d'autres domaines frontables ou des failles dans les playbooks actuels, veuillez envisager de contribuer !
