 blue-yonder/tsfresh
Extraction automatique de caractéristiques pertinentes à partir de séries temporelles :


Ce dépôt contient le paquet Python TSFRESH. L'abréviation signifie
"Time Series Feature extraction based on scalable hypothesis tests".
Le paquet fournit une extraction systématique de caractéristiques de séries temporelles en combinant des algorithmes établis issus des statistiques, de l'analyse des séries temporelles, du traitement du signal et de la dynamique non linéaire avec un algorithme robuste de sélection de caractéristiques. Dans ce contexte, le terme série temporelle est interprété au sens le plus large possible, de sorte que tout type de données échantillonnées, voire des séquences d'événements, peuvent être caractérisées.
Les data scientists passent souvent la plupart de leur temps à nettoyer les données ou à construire des caractéristiques. Bien que nous ne puissions pas changer la première chose, la seconde peut être automatisée. TSFRESH vous fait gagner le temps consacré à la construction de caractéristiques en les extrayant automatiquement. Ainsi, vous avez plus de temps pour étudier le dernier article sur le deep learning, lire Hacker News ou construire de meilleurs modèles.
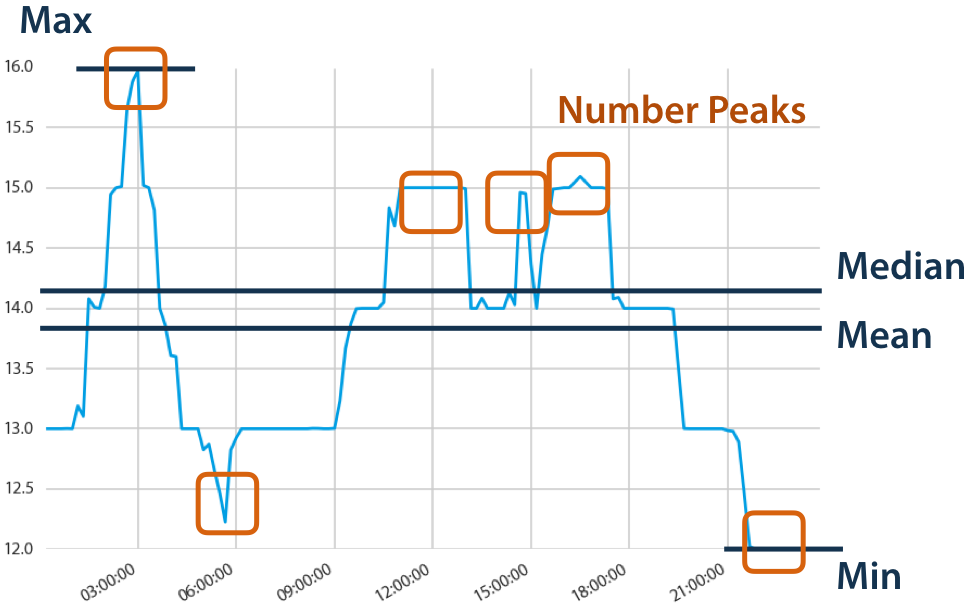
TSFRESH extrait automatiquement des centaines de caractéristiques à partir de séries temporelles. Ces caractéristiques décrivent les caractéristiques de base de la série temporelle, comme le nombre de pics, la valeur moyenne ou maximale, ou des caractéristiques plus complexes comme la statistique de symétrie par inversion du temps.
L'ensemble des caractéristiques peut ensuite être utilisé pour construire des modèles statistiques ou d'apprentissage automatique sur les séries temporelles, par exemple pour des tâches de régression ou de classification.
Les séries temporelles contiennent souvent du bruit, des redondances ou des informations non pertinentes. Par conséquent, la plupart des caractéristiques extraites ne seront pas utiles pour la tâche d'apprentissage automatique considérée.
Pour éviter d'extraire des caractéristiques non pertinentes, le paquet TSFRESH dispose d'une procédure de filtrage intégrée. Cette procédure de filtrage évalue le pouvoir explicatif et l'importance de chaque caractéristique pour les tâches de régression ou de classification considérées.
Elle repose sur la théorie bien établie des tests d'hypothèses et utilise une procédure de tests multiples. Ainsi, le processus de filtrage contrôle mathématiquement le pourcentage de caractéristiques non pertinentes extraites.
Le paquet TSFRESH est décrit dans l'article en libre accès suivant :
L'algorithme FRESH est décrit dans le livre blanc suivant :
Les modèles de normalité simulent la façon dont les humains détectent les anomalies dans les séries temporelles :
Teh, H.Y., Wang, K.I-K., Kempa-Liehr, A.W. (2021). Expect the Unexpected: Unsupervised feature selection for automated sensor anomaly detection. IEEE Sensors Journal 15.16, p. 18033-18046, doi: 10.1109/JSEN.2021.3084970.
Teh, H.Y., Wang, K.I-K., Kempa-Liehr, A.W. (2025). Feature-based normality models for anomaly detection. Sensors 25.4757, p. 1-25, doi: 10.3390/s25154757.
L'extraction systématique de caractéristiques de séries temporelles fonctionne également pour les problèmes non supervisés :
Étant donné que tsfresh fournit essentiellement une extraction de caractéristiques de séries temporelles gratuitement, vous pouvez maintenant vous concentrer sur la conception de nouvelles séries temporelles, comme par exemple les différences de signaux provenant de mesures synchrones, qui fournissent des caractéristiques de séries temporelles encore meilleures :
Kempa-Liehr, A.W., Oram, J., Wong, A., Finch, M., Besier, T. (2020). Feature engineering workflow for activity recognition from synchronized inertial measurement units. In: Pattern Recognition. ACPR 2019. Ed. by M. Cree et al. Vol. 1180. Communications in Computer and Information Science (CCIS). Singapore: Springer, p. 223–231. doi: 10.1007/978-981-15-3651-9_20.
Simmons, S., Jarvis, L., Dempsey, D., Kempa-Liehr, A.W. (2021). Data Mining on Extremely Long Time-Series. In: 2021 International Conference on Data Mining Workshops (ICDMW). Ed. by B. Xue et al. Los Alamitos: IEEE, p. 1057-1066. doi: 10.1109/ICDMW53433.2021.00137.
L'ingénierie systématique des caractéristiques de séries temporelles permet de travailler avec des échantillons de séries temporelles de longueurs différentes, car chaque série temporelle est projetée dans un espace de caractéristiques bien défini. Cette approche permet la conception d'algorithmes d'apprentissage automatique robustes dans des applications avec des données manquantes.
Votre problème de classification de séries temporelles est-il déséquilibré ? Il y a de bonnes chances que le sous-échantillonnage des matrices de caractéristiques de séries temporelles résolve votre problème :
