

Krawl est un serveur de déception web personnalisable, léger et natif du cloud, ainsi qu'un anti-crawler, qui crée de fausses applications web présentant des vulnérabilités faciles à exploiter en utilisant des données leurres réalistes générées aléatoirement et des modèles HTML générés par IA.
<h1 align="center">Krawl</h1>
<h3 align="center">
<a name="readme-top"></a>
<img
src="https://raw.githubusercontent.com/blessedrebus/krawl/HEAD/img/krawl-svg.svg"
height="250"
>
</h3>
<div align="center">
<p align="center">
Un serveur honeypot web moderne et personnalisable conçu pour détecter et suivre l'activité malveillante des attaquants et des robots d'exploration web grâce à des pages web trompeuses, de faux identifiants et des canary tokens.
</p>
<div align="center">
<a href="https://github.com/blessedrebus/krawl/blob/main/LICENSE">
<img src="https://img.shields.io/github/license/blessedrebus/krawl" alt="License">
</a>
<a href="https://github.com/blessedrebus/krawl/releases">
<img src="https://img.shields.io/github/v/release/blessedrebus/krawl" alt="Release">
</a>
</div>
<div align="center">
<a href="https://ghcr.io/blessedrebus/krawl">
<img src="https://img.shields.io/badge/ghcr.io-krawl-blue" alt="GitHub Container Registry">
</a>
<a href="https://kubernetes.io/">
<img src="https://img.shields.io/badge/kubernetes-ready-326CE5?logo=kubernetes&logoColor=white" alt="Kubernetes">
</a>
<a href="https://github.com/BlessedRebuS/Krawl/pkgs/container/krawl-chart">
<img src="https://img.shields.io/badge/helm-chart-0F1689?logo=helm&logoColor=white" alt="Helm Chart">
</a>
</div>
</div>
## Table des matières
- [Démo](#demo)
- [Qu'est-ce que Krawl ?](#what-is-krawl)
- [Tableau de bord Krawl](#krawl-dashboard)
- [Modes de déploiement](#deployment-modes)
- [Liste de bannissement Krawl](#krawl-banlist)
- [Démarrage rapide](#quickstart)
- [Docker Run](#docker-run)
- [Docker Compose](#docker-compose)
- [Kubernetes](#kubernetes)
- [Uvicorn (Python)](#uvicorn-python)
- [Configuration](#configuration)
- [config.yaml](#configuration-via-configyaml)
- [Variables d'environnement](#configuration-via-environmental-variables)
- [Bannir les IP malveillantes](#use-krawl-to-ban-malicious-ips)
- [Réputation des IP](#ip-reputation)
- [Exécution derrière un reverse proxy ou un CDN](#running-behind-a-reverse-proxy-or-cdn)
- [Métriques et surveillance](#metrics--monitoring)
- [Documentation supplémentaire](#additional-documentation)
- [Tromperie à l'aide de l'IA](#ai-generated-deception-pages)
- [Contribuer](#contributing)
## Démo
Astuce : explorez les chemins du `robots.txt` pour plus de plaisir
### URL de Krawl : [http://demo.krawlme.com](http://demo.krawlme.com)
### Consultez le tableau de bord [http://demo.krawlme.com/das_dashboard](http://demo.krawlme.com/das_dashboard)
## Qu'est-ce que Krawl ?
**Krawl** est un serveur de tromperie cloud‑native conçu pour détecter, retarder et analyser les attaquants malveillants, les robots d'exploration web et les scanners automatisés.
Il crée de fausses applications web réalistes remplies de cibles faciles telles que des panneaux d'administration, des fichiers de configuration et de faux identifiants exposés afin d'attirer et d'identifier les activités suspectes.
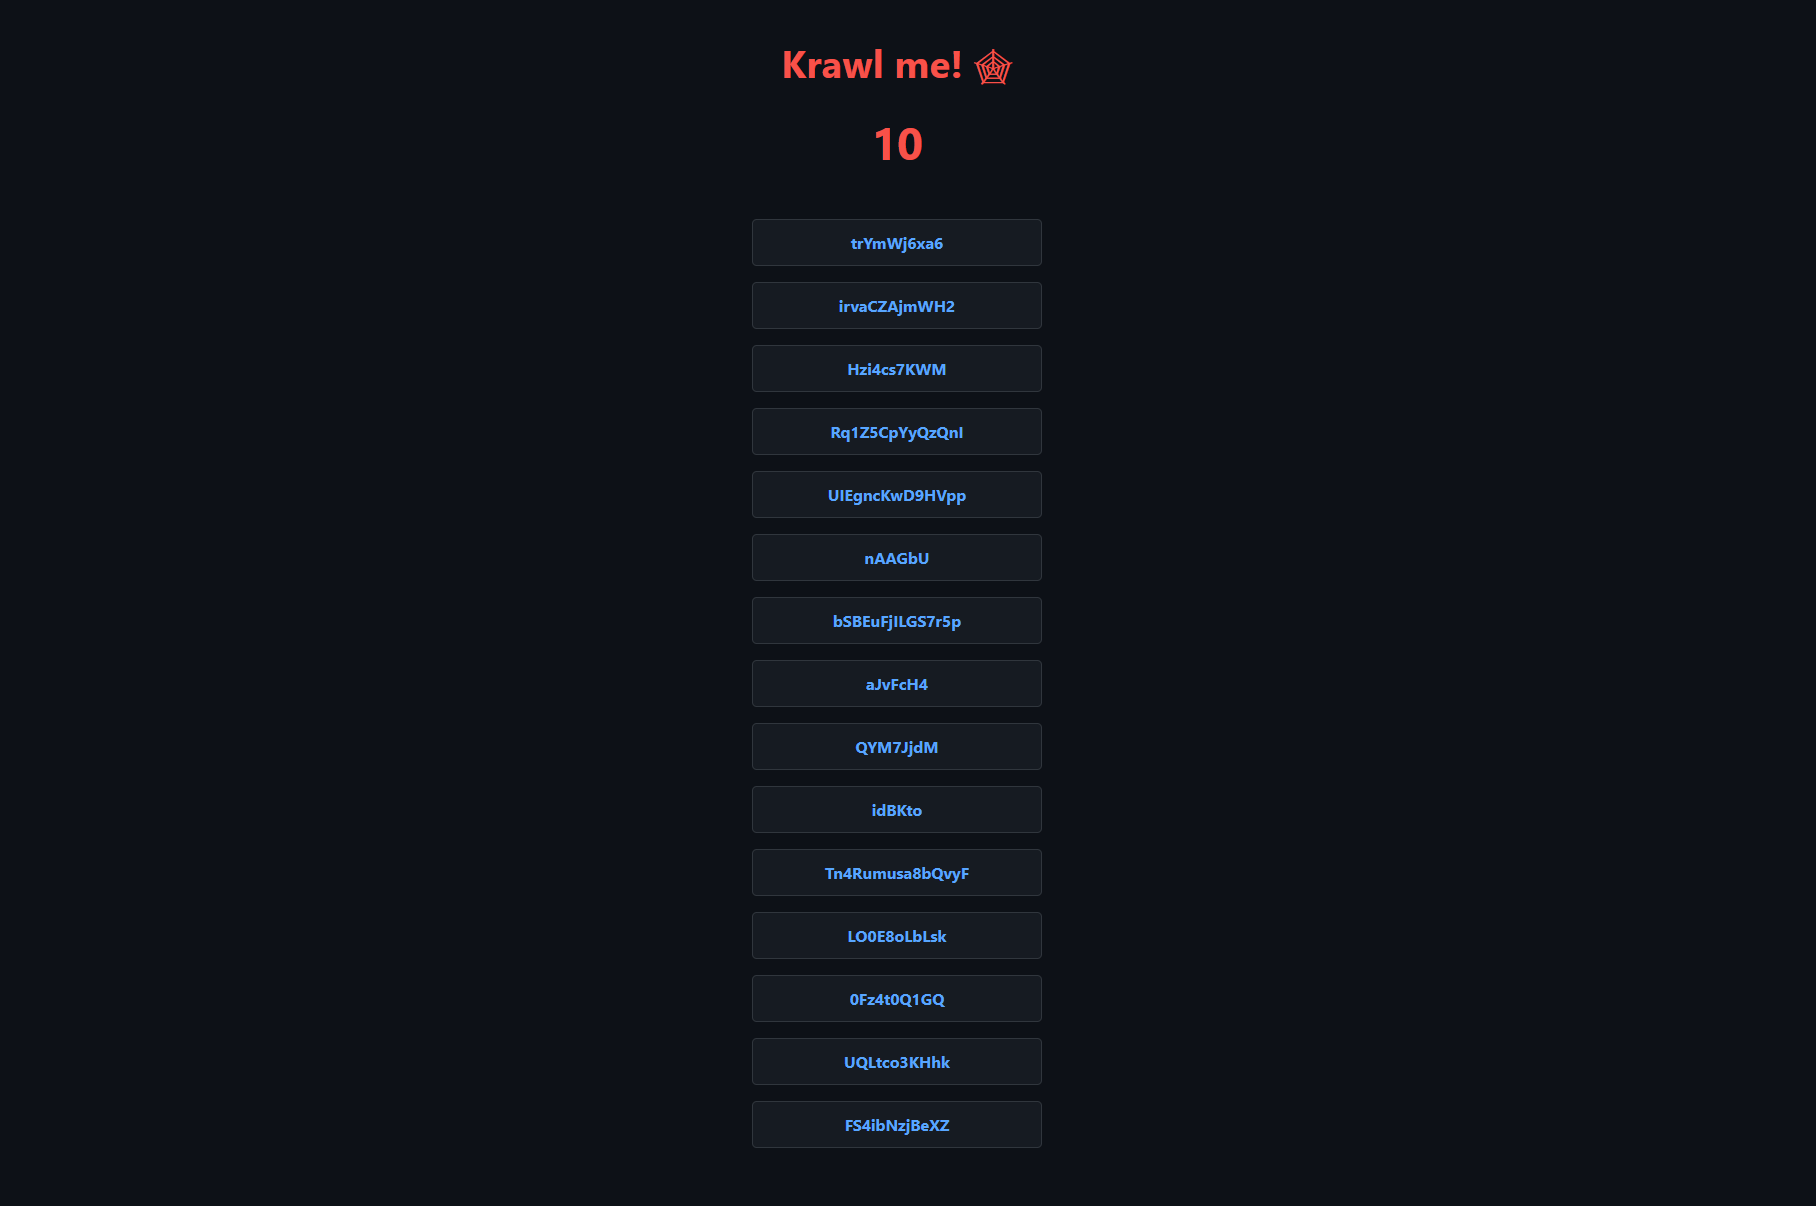
En gaspillant les ressources des attaquants, Krawl aide à distinguer clairement les comportements malveillants des robots d'exploration légitimes.
Il comprend :
- **[Pages de tromperie générées par IA](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md)** : **Laissez les attaquants vous aider à générer votre fausse surface d'attaque vulnérable**
- **Pages Spider Trap** : Liens aléatoires infinis pour gaspiller les ressources des robots d'exploration, basées sur le [projet spidertrap](https://github.com/adhdproject/spidertrap)
- **Fausses pages de connexion** : WordPress, phpMyAdmin, panneaux d'administration
- **Chemins honeypot** : Annoncés dans robots.txt pour piéger les scanners
- **Faux identifiants** : Noms d'utilisateur, mots de passe et clés API d'apparence réaliste
- **Intégration de [Canary Token](https://github.com/blessedrebus/krawl/blob/main/docs/canary-token.md)** : Déclenchement d'alertes externes
- **En-têtes de serveur aléatoires** : Confusion des attaques basées sur l'en-tête et la version du serveur
- **Tableau de bord en temps réel** : Surveillance de l'activité suspecte
- **Listes de mots personnalisables** : Configuration facile basée sur JSON
- **Injection d'erreurs aléatoires** : Imitation du comportement d'un vrai serveur
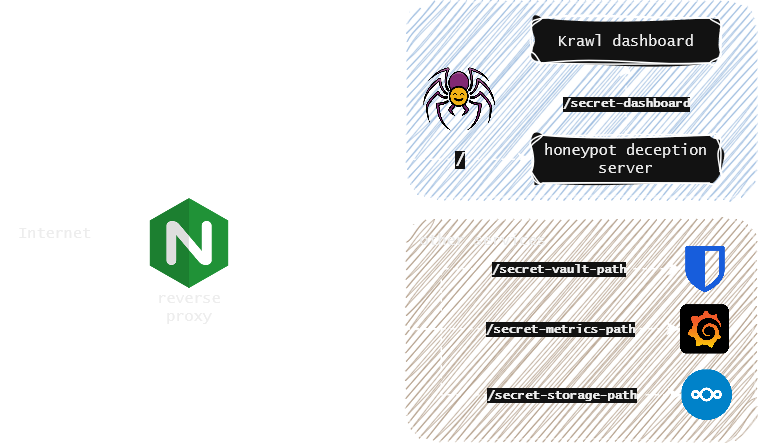
Vous pouvez facilement exposer Krawl aux côtés de vos autres services pour les protéger des robots d'exploration web et des utilisateurs malveillants à l'aide d'un reverse proxy. Pour plus de détails, consultez la [documentation sur le reverse proxy](https://github.com/blessedrebus/krawl/blob/main/docs/reverse-proxy.md).
## Tableau de bord Krawl
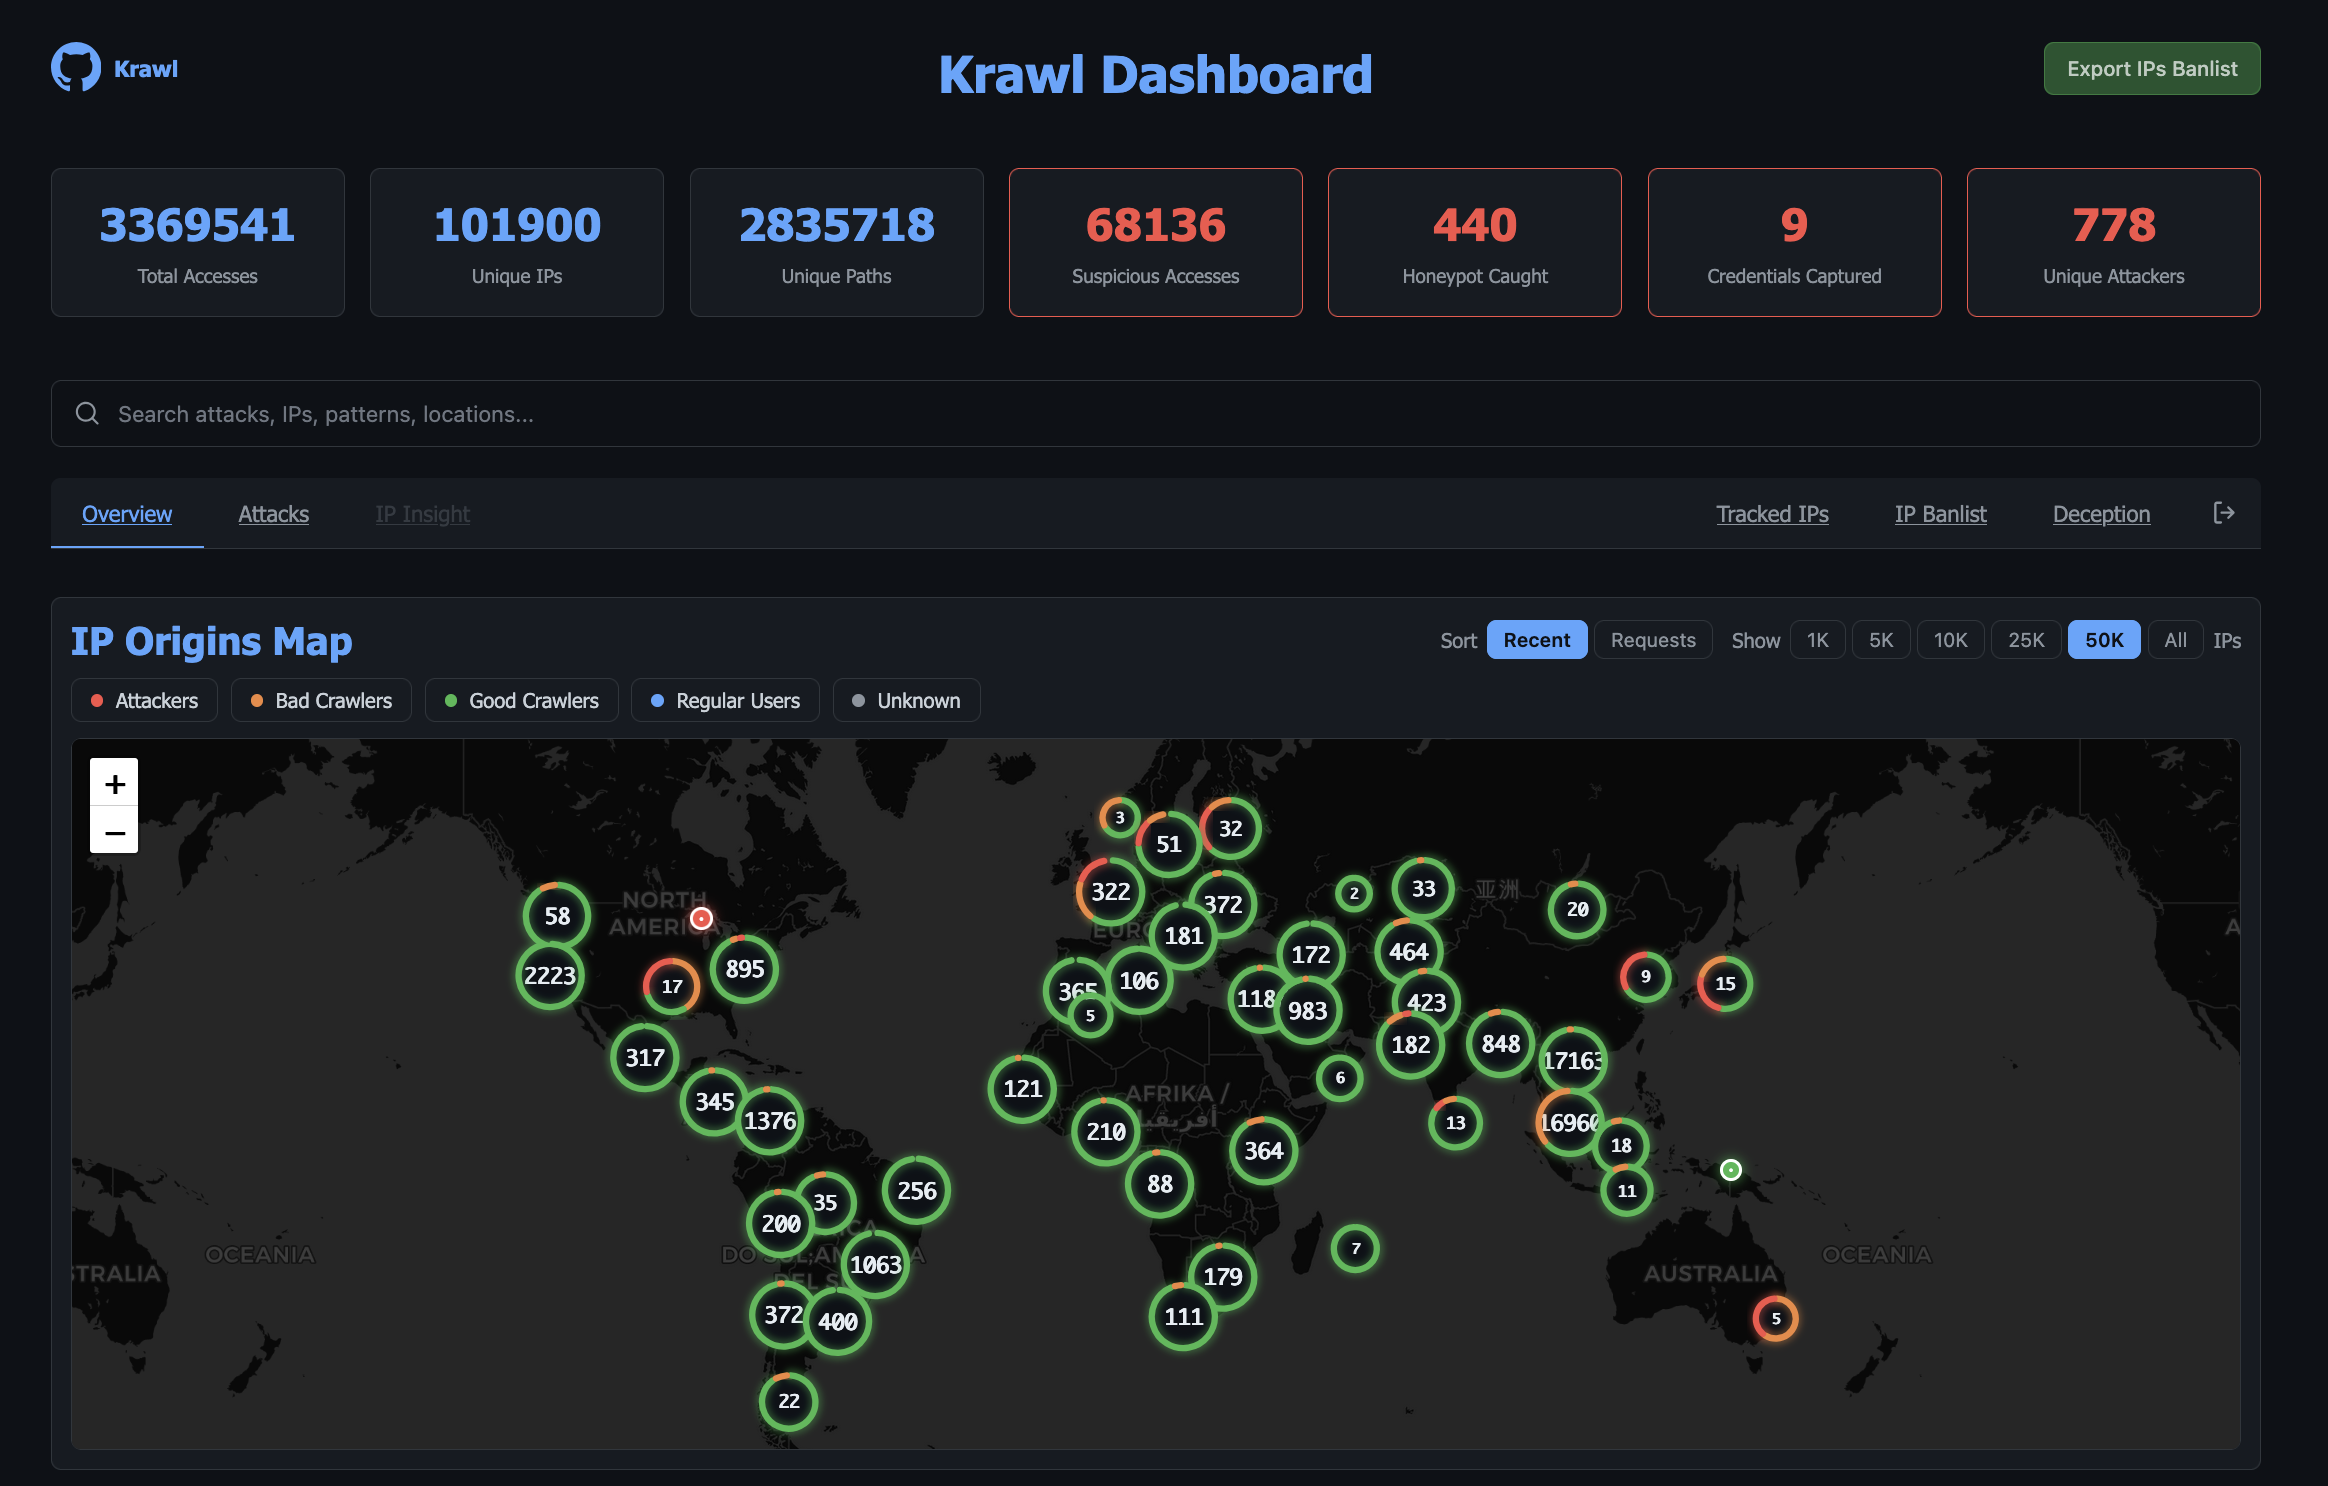
Krawl fournit un tableau de bord complet, accessible à un **chemin secret aléatoire** généré au démarrage ou à un **chemin personnalisé** configuré via `KRAWL_DASHBOARD_SECRET_PATH`. Cela permet de garder le tableau de bord caché des attaquants qui scannent votre honeypot.
Le tableau de bord est organisé en six onglets :
- **Vue d'ensemble** : vue globale de l'activité d'attaque : une carte interactive des origines IP, les requêtes suspectes récentes, et les principales IP, User-Agents et chemins.
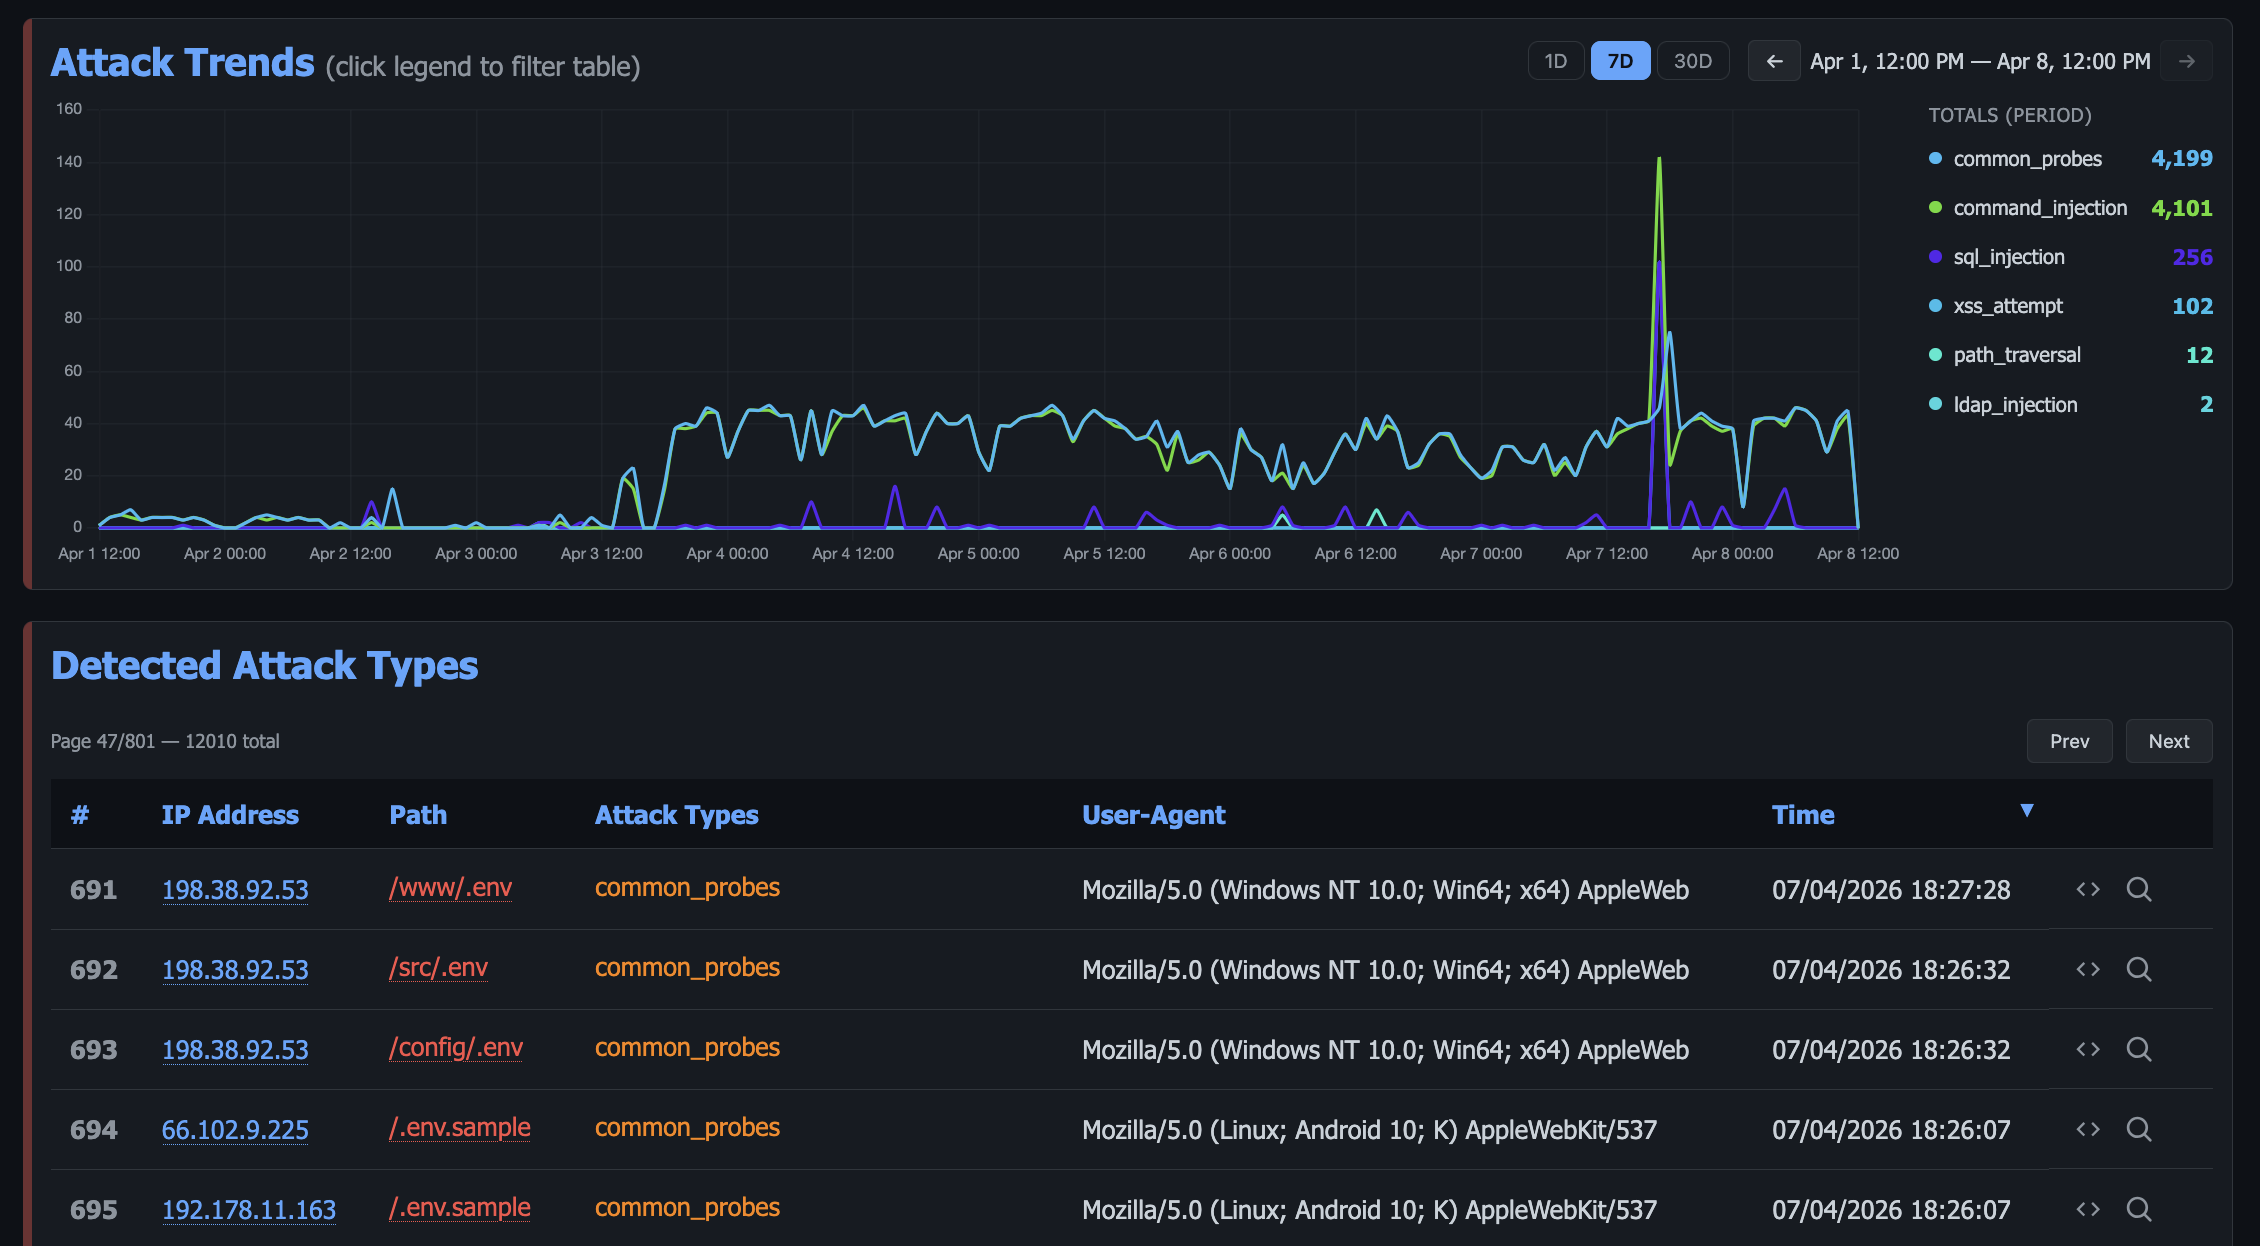
- **Attaques** : répartition détaillée des identifiants capturés, des déclenchements de honeypot et des types d'attaques détectées (SQLi, XSS, path traversal, etc.) avec graphiques et tableaux.
- **Menaces** : charges utiles regroupées en campagnes par hachage flou TLSH, de sorte qu'un webshell et ses variantes modifiées soient lus comme une seule campagne plutôt que comme des occurrences sans lien, avec un index de chaque fichier capturé.
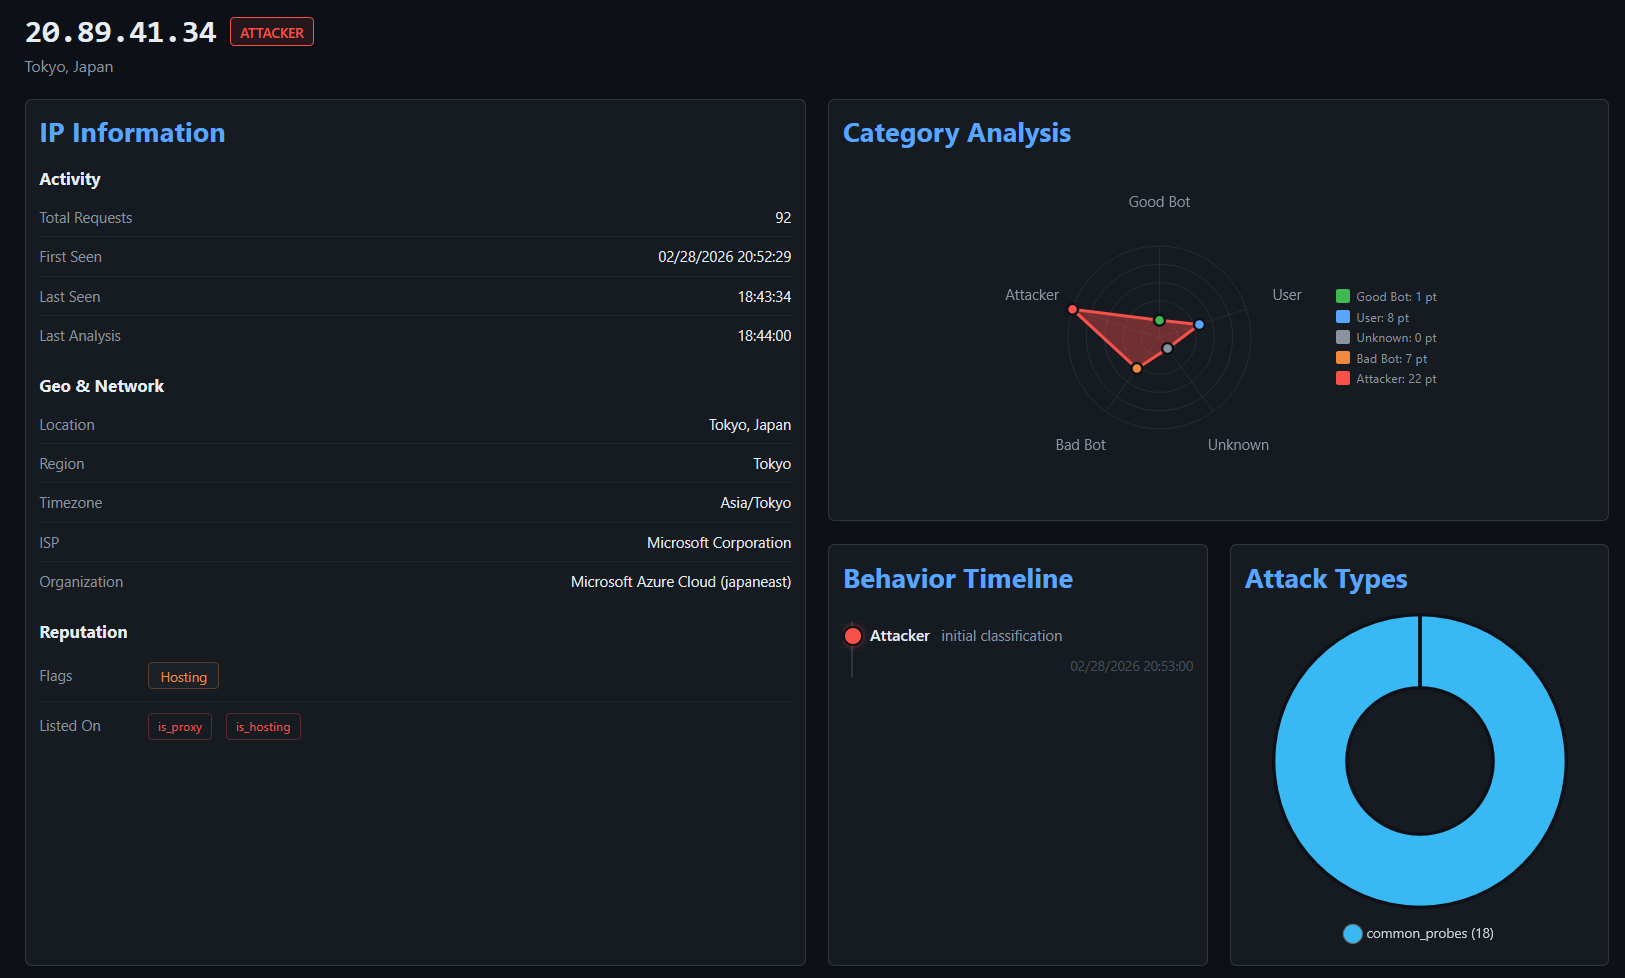
- **Analyse IP** : vue forensique approfondie d'une IP sélectionnée : géolocalisation, informations FAI/ASN, indicateurs de réputation, chronologie comportementale, répartition des types d'attaque, historique des référents, fichiers et identifiants capturés, et historique complet des accès.
De plus, après authentification avec le mot de passe du tableau de bord, des onglets protégés deviennent disponibles :
- **IP suivies** : maintenez une liste de surveillance des adresses IP que vous souhaitez surveiller dans le temps.
- **Liste de bannissement IP** : gérez les bannissements d'IP, consultez les attaquants détectés et exportez la liste de bannissement au format brut ou IPTables.
- **IP expirées** : consultez les IP actuellement retenues dans le tarpit, et exemptez celles qui ne devraient pas l'être.
- **Tromperie** : gérez les pages générées par IA, exportez-les ou importez-en de nouvelles.
- **Webhooks** : transférez les bannissements vers CloudFlare et d'autres pare-feu.
Les icônes d'en-tête ouvrent la documentation de l'API, l'export de la liste de bannissement, et un panneau de paramètres affichant la configuration en cours ainsi qu'une page de maintenance pour exécuter les tâches planifiées à la demande.
Pour plus de détails, consultez la [documentation du tableau de bord](https://github.com/blessedrebus/krawl/blob/main/docs/dashboard.md).
## Modes de déploiement
Krawl prend en charge deux modes de déploiement, contrôlés par le paramètre `mode` dans `config.yaml` ou la variable d'environnement `KRAWL_MODE`.
| | Standalone | Scalable |
|---|---|---|
| **Base de données** | SQLite (mode WAL) | PostgreSQL |
| **Cache** | Dictionnaire Python en mémoire | Redis (TTL multi-niveaux) |
| **Réplicas** | 1 (instance unique) | 1+ (mise à l'échelle horizontale) |
| **Dépendances externes** | Aucune | PostgreSQL + Redis |
| **Idéal pour** | Dev, homelabs, <500k requêtes | Production, HA, >500k requêtes |
**Standalone** : idéal pour les environnements de développement ou les homelabs à faible volume de requêtes. Aucune configuration supplémentaire nécessaire, lancez simplement Krawl et cela fonctionne.
- Déploiement en conteneur unique sans dépendances externes
- Utilisation réduite de RAM et de ressources
**Scalable** : conçu pour les environnements de production ou les honeypots à fort trafic. Le chart Helm utilise ce mode par défaut.
- Tableau de bord plus rapide et plus réactif grâce au cache multi-niveaux Redis
- E/S disque réduites avec Redis agissant comme cache de chemin chaud devant PostgreSQL
- Mise à l'échelle horizontale : augmentez le nombre de réplicas Krawl derrière un load balancer
Pour une configuration détaillée, des exemples Docker Compose, une configuration Kubernetes/Helm et des instructions de migration étape par étape, consultez la [documentation sur les modes de déploiement](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md).
## Liste de bannissement Krawl
Krawl maintient une [`banlist.txt`](https://github.com/blessedrebus/krawl/blob/main/banlist.txt) régulièrement mise à jour contenant les adresses IP des **attaquants ayant déclenché ses pièges honeypot**. La liste de bannissement est publiée chaque semaine et disponible au téléchargement, aidant la communauté à bloquer de manière préventive les acteurs malveillants connus, même sans utiliser Krawl.
La liste de bannissement peut également être récupérée directement depuis :
[https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw](https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw).
### Partage des listes de bannissement entre instances
Les instances Krawl peuvent fédérer leurs listes de bannissement : chacune peut publier sa propre liste sur un
chemin non authentifié et récupérer les listes d'autres instances (ou toute liste d'IP en texte brut).
Les IP récupérées sont fusionnées dans les décisions de bannissement locales et affichées dans le tableau de bord.```yaml
banlist:
# Public, unauthenticated download path for this instance's banlist.
# Supports the same ?categories= and ?fwtype= parameters as the main API.
# Empty = disabled.
export_path: "/public_banlist.txt"
# Upstream banlists to fetch and merge. Plain ".txt" lists work too.
sources:
- "https://demo.krawlme.com/das_dashboard/api/export-ips?categories=attacker&fwtype=raw"
- "https://krawl.example.com/public_banlist.txt"
refresh_interval: 3600 # seconds between fetches
```
## Démarrage rapide
### Docker Run
Exécutez Krawl en mode autonome avec la dernière image :```bash
docker run -d \
-p 5000:5000 \
-e KRAWL_DASHBOARD_SECRET_PATH="/my-secret-dashboard" \
-e KRAWL_DASHBOARD_PASSWORD="my-secret-password" \
-v krawl-data:/app/data \
--name krawl \
ghcr.io/blessedrebus/krawl:latest
```
Accédez au serveur à l'adresse `http://localhost:5000`
### Docker Compose
Créez un fichier `docker-compose.yaml` avec l'un des deux modes de déploiement.
**Standalone** : uniquement le serveur Krawl avec un stockage Sqlite :```yaml
services:
krawl:
image: ghcr.io/blessedrebus/krawl:latest
container_name: krawl-server
ports:
- "5000:5000"
environment:
- CONFIG_LOCATION=config.yaml
# - KRAWL_DASHBOARD_PASSWORD=my-secret-password
volumes:
- ./config.yaml:/app/config.yaml:ro
- krawl-data:/app/data
restart: unless-stopped
volumes:
krawl-data:
```
**Scalable** : avec PostgreSQL et Redis :
> [!CAUTION]
> L'exemple ci-dessous utilise des **mots de passe par défaut** (`krawl`/`krawl`). **Changez-les avant de déployer en production.**```yaml
services:
postgres:
image: postgres:16-alpine
environment:
POSTGRES_DB: krawl
POSTGRES_USER: krawl
POSTGRES_PASSWORD: krawl
volumes:
- postgres_data:/var/lib/postgresql/data
restart: unless-stopped
healthcheck:
test: ["CMD-SHELL", "pg_isready -U krawl -d krawl"]
interval: 10s
timeout: 5s
retries: 5
redis:
image: redis:7-alpine
volumes:
- redis_data:/data
restart: unless-stopped
healthcheck:
test: ["CMD", "redis-cli", "ping"]
interval: 10s
timeout: 5s
retries: 5
krawl:
image: ghcr.io/blessedrebus/krawl:latest
container_name: krawl-server
ports:
- "5000:5000"
environment:
- CONFIG_LOCATION=config.yaml
- KRAWL_MODE=scalable
- KRAWL_POSTGRES_HOST=postgres
- KRAWL_POSTGRES_PORT=5432
- KRAWL_POSTGRES_USER=krawl
- KRAWL_POSTGRES_PASSWORD=krawl
- KRAWL_POSTGRES_DATABASE=krawl
- KRAWL_REDIS_HOST=redis
- KRAWL_REDIS_PORT=6379
# - KRAWL_DASHBOARD_PASSWORD=my-secret-password
volumes:
- ./config.yaml:/app/config.yaml:ro
restart: unless-stopped
depends_on:
postgres:
condition: service_healthy
redis:
condition: service_healthy
volumes:
postgres_data:
redis_data:
```
Pour déployer, exécutez simplement```bash
docker compose up -d
```
Des fichiers compose prêts pour la production sont également disponibles dans le répertoire [`docker/`](https://github.com/blessedrebus/krawl/blob/main/docker). Pour le **développement** (compilations depuis les sources avec rechargement à chaud), utilisez les fichiers compose dans [`docker/dev/`](https://github.com/blessedrebus/krawl/blob/main/docker/dev).
Pour plus de détails sur les deux modes, consultez [Modes de déploiement](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md).
### Kubernetes
**Krawl est également disponible nativement sur Kubernetes**. L'installation peut se faire soit [via manifeste](https://github.com/blessedrebus/krawl/blob/main/kubernetes/README.md), soit [en utilisant le chart Helm](https://github.com/blessedrebus/krawl/blob/main/helm/README.md).
Le chart Helm **utilise par défaut le mode scalable** avec PostgreSQL et Redis intégrés :```bash
helm install krawl oci://ghcr.io/blessedrebus/krawl-chart --version 2.4.0 \
-n krawl-system --create-namespace \
--set postgres.password=your-password \
--set redis.password=your-redis-password \
--set dashboardPassword=your-dashboard-password \
--set config.dashboard.secret_path=/my-secret-dashboard
```
Des fichiers de valeurs d'exemple minimaux sont fournis pour les deux modes :
- [`values-minimal.yaml`](https://github.com/blessedrebus/krawl/blob/main/helm/values-minimal.yaml) ---> Scalable (par défaut)
- [`values-standalone.yaml`](https://github.com/blessedrebus/krawl/blob/main/helm/values-standalone.yaml) ---> Standalone
Voir [Modes de déploiement](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md) et [Documentation du chart](https://github.com/blessedrebus/krawl/blob/main/helm/README.md) pour la configuration complète et les instructions de migration.
### Uvicorn (Python)
Exécutez Krawl directement avec Python 3.13+ et uvicorn pour le développement local ou les tests :```bash
pip install -r requirements.txt
uvicorn app:app --host 0.0.0.0 --port 5000 --app-dir src --no-server-header
```
Accédez au serveur à l'adresse `http://localhost:5000`
## Configuration
Krawl utilise une **hiérarchie de configuration** dans laquelle **les variables d'environnement ont la priorité sur le fichier de configuration**. Cette approche est recommandée pour les déploiements Docker et une personnalisation rapide prête à l'emploi.
### Configuration via config.yaml
Vous pouvez utiliser le fichier [config.yaml](https://github.com/blessedrebus/krawl/blob/main/config.yaml) pour des configurations avancées, telles que les déploiements Docker Compose ou Helm chart.
### Configuration via les variables d'environnement
Tous les paramètres peuvent être fournis sous forme de variables d'environnement, qui remplacent `config.yaml`.
Le nom de la variable est `KRAWL_` suivi du chemin du paramètre en majuscules, ainsi `dashboard.password`
devient `KRAWL_DASHBOARD_PASSWORD`.
<details>
<summary><b>Serveur et génération de liens</b> (11 variables)</summary>
Comment Krawl se présente et façonne le labyrinthe des pages générées.
| Variable d'environnement | Description | Valeur par défaut |
|----------------------|-------------|---------|
| `CONFIG_LOCATION` | Chemin vers le fichier de configuration yaml | `config.yaml` |
| `KRAWL_PORT` | Port d'écoute du serveur | `5000` |
| `KRAWL_DELAY` | Délai de réponse en millisecondes | `100` |
| `KRAWL_SERVER_HEADER` | En-tête HTTP Server pour la tromperie | `""` |
| `KRAWL_LINKS_LENGTH_RANGE` | Plage de longueur des liens sous la forme `min,max` | `5,15` |
| `KRAWL_LINKS_PER_PAGE_RANGE` | Liens par page sous la forme `min,max` | `10,15` |
| `KRAWL_CHAR_SPACE` | Caractères utilisés pour la génération de liens | `abcdefgh...` |
| `KRAWL_MAX_COUNTER` | Valeur initiale du compteur | `10` |
| `KRAWL_PROBABILITY_ERROR_CODES` | Probabilité de réponse d'erreur (0-100%) | `0` |
| `KRAWL_INFINITE_PAGES_FOR_MALICIOUS` | Servir des pages infinies aux IP malveillantes | `true` |
| `KRAWL_MAX_PAGES_LIMIT` | Limite maximale de pages pour les crawlers | `250` |
| `KRAWL_BAN_DURATION_SECONDS` | Durée de bannissement en secondes pour les IP à débit limité | `600` |
</details>
<details>
<summary><b>Tableau de bord, métriques et journalisation</b> (13 variables)</summary>
Accès au tableau de bord, préchauffage du cache, Prometheus et niveau de journalisation.
| Variable d'environnement | Description | Valeur par défaut |
|----------------------|-------------|---------|
| `KRAWL_DASHBOARD_SECRET_PATH` | Chemin personnalisé du tableau de bord | Généré automatiquement |
| `KRAWL_DASHBOARD_PASSWORD` | Mot de passe pour les panneaux protégés du tableau de bord | Généré automatiquement |
| `KRAWL_DASHBOARD_CACHE_WARMUP` | Pré-calculer les données du tableau de bord toutes les 5 minutes pour un chargement instantané des pages | `true` |
| `KRAWL_DASHBOARD_WARMUP_PAGES` | Nombre de pages à préchauffer par panneau de table | `10` |
| `KRAWL_DASHBOARD_WARMUP_AGGREGATION` | Pré-calculer les agrégations complètes top_paths/top_ua pour un service sans requête | `false` |
| `KRAWL_DASHBOARD_TOP_N_MIN_COUNT` | Nombre d'accès minimum pour les panneaux top paths/user agents (définir à 1 pour désactiver) | `5` |
| `KRAWL_DASHBOARD_BRAND_NAME` | Nom dans le logo textuel et le titre du tableau de bord | `Krawl` |
| `KRAWL_DASHBOARD_BRAND_URL` | Vers quoi le logo textuel renvoie (vide l'affiche en texte brut) | Dépôt de Krawl |
| `KRAWL_DASHBOARD_BRAND_LOGO` | URL de l'image affichée à la place du logo GitHub | Non défini |
| `KRAWL_DASHBOARD_BRAND_SHOW_VERSION` | Afficher la version à côté du nom | `true` |
| `KRAWL_DASHBOARD_BRAND_CONTACT` | Contact affiché sous le logo textuel (adresse, URL ou texte brut) | Non défini |
| `KRAWL_METRICS_ENABLED` | Exposer les métriques Prometheus à `/<dashboard_path>/metrics` | `true` |
| `KRAWL_LOG_LEVEL` | Niveau de journalisation de l'application (`DEBUG`, `INFO`, `WARNING`, `ERROR`) | `INFO` |
</details>
<details>
<summary><b>Base de données, rétention et sauvegardes</b> (12 variables)</summary>
Emplacement de stockage, durée de conservation des données et tâche de dump.
| Variable d'environnement | Description | Valeur par défaut |
|----------------------|-------------|---------|
| `KRAWL_DATABASE_PATH` | Emplacement du fichier de base de données | `data/krawl.db` |
| `KRAWL_DATABASE_PERSIST_SUSPICIOUS_ONLY` | Ne persister que les requêtes suspectes dans le journal d'accès | `false` |
| `KRAWL_MAP_TILE_URL` | Modèle d'URL de tuile pour la carte du tableau de bord (`{z}/{x}/{y}`, `{s}`/`{r}` optionnels) | Esri dark canvas |
| `KRAWL_MAP_TILE_ATTRIBUTION` | Attribution affichée sur la carte | Esri/OSM |
| `KRAWL_MAP_API_KEY` | Ajoutée à chaque requête de tuile en tant que paramètre de requête — requise par CARTO | _(vide)_ |
| `KRAWL_MAP_API_KEY_PARAM` | Nom de ce paramètre de requête (`api_key`, `apikey`, `key`) | `api_key` |
| `KRAWL_IPV6_IGNORE` | Ignorer entièrement les requêtes IPv6 : toujours journalisées sur stdout, jamais persistées, vérifiées pour bannissement ou exportées | `false` |
| `KRAWL_IPV6_PURGE_EXISTING` | Supprimer également les lignes IPv6 existantes au prochain démarrage (irréversible ; nécessite `KRAWL_IPV6_IGNORE`) | `false` |
| `KRAWL_DATABASE_RETENTION_DAYS` | Nombre de jours de conservation des données dans la base de données | `30` |
| `KRAWL_BACKUPS_PATH` | Chemin où les dumps de base de données sont enregistrés | `backups` |
| `KRAWL_BACKUPS_CRON` | expression cron pour contrôler la planification de la tâche de sauvegarde | `*/30 * * * *` |
| `KRAWL_BACKUPS_ENABLED` | Booléen pour activer la tâche de dump de la base de données | `true` |
</details>
<details>
<summary><b>Pièges : tarpit, pages de tromperie et canary</b> (6 variables)</summary>
Pièges opt-in et pages servies aux attaquants.
| Variable d'environnement | Description | Valeur par défaut |
|----------------------|-------------|---------|
| `KRAWL_TARPIT_ENABLED` | Piéger les agents IA avec des réponses lentes et du texte aléatoire | `false` |
| `KRAWL_TARPIT_DELAY_SECONDS` | Délai supplémentaire en secondes ajouté par réponse lorsque le tarpit est actif | `5` |
| `KRAWL_DECEPTION_IMPORT_PAGES` | Importer automatiquement les pages de tromperie depuis `src/templates/deception/` au démarrage | `true` |
| `KRAWL_CUSTOM_TEMPLATE_PATH` | Chemin à l'intérieur du conteneur vers un modèle HTML personnalisé. Le modèle doit inclure les espaces réservés `{counter}` et `{content}`. | `/templates/custom_page.html` |
| `KRAWL_CANARY_TOKEN_URL` | URL du jeton canary externe | Aucune |
| `KRAWL_CANARY_TOKEN_TRIES` | Nombre de requêtes avant d'afficher le jeton canary | `10` |
</details>
<details>
<summary><b>Analyseur de réputation IP</b> (6 variables)</summary>
Seuils qui déterminent comment une IP est classifiée.
| Variable d'environnement | Description | Valeur par défaut |
|----------------------|-------------|---------|
| `KRAWL_HTTP_RISKY_METHODS_THRESHOLD` | Seuil de détection des méthodes HTTP risquées | `0.1` |
| `KRAWL_VIOLATED_ROBOTS_THRESHOLD` | Seuil de violations de robots.txt | `0.1` |
| `KRAWL_UNEVEN_REQUEST_TIMING_THRESHOLD` | Seuil du coefficient de variation pour la temporisation | `0.5` |
| `KRAWL_UNEVEN_REQUEST_TIMING_TIME_WINDOW_SECONDS` | Fenêtre temporelle pour l'analyse de la temporisation des requêtes en secondes | `300` |
| `KRAWL_USER_AGENTS_USED_THRESHOLD` | Seuil de détection de multiples user agents | `2` |
| `KRAWL_ATTACK_URLS_THRESHOLD` | Seuil de détection d'URL d'attaque | `1` |
</details>
<details>
<summary><b>Capture de threat-intel</b> (4 variables)</summary>
Hachage flou des charges utiles capturées (fichiers et corps de requêtes signalés) et regroupement
des variantes quasi-identiques en clusters de campagnes. Nécessite `py-tlsh`.
Le hachage s'exécute en tant que tâche d'arrière-plan planifiée `hash-payloads` (voir
`src/tasks/hash_payloads.py`), qui hache chaque attaque capturée une fois — les nouvelles
détections au moment de l'ingestion, et un balayage rétroactif unique de l'historique existant
suivi par un repère de haute eau `payload_hash_watermark` — puis regroupe les
empreintes en campagnes à motifs récurrents.
| Variable d'environnement | Description | Valeur par défaut |
|----------------------|-------------|---------|
| `KRAWL_TLSH_ENABLED` | Hacher les fichiers téléversés et les corps de requêtes signalés avec TLSH pour le regroupement des quasi-doublons | `true` |
| `KRAWL_TLSH_CLUSTER_THRESHOLD` | Distance TLSH en dessous de laquelle une charge utile rejoint une campagne existante (0 = octets identiques ; les variantes d'un webshell diffèrent généralement de < 100) | `150` |
| `KRAWL_TLSH_CAMPAIGN_MIN_EVENTS` | Nombre de fois qu'une charge utile doit être vue avant que sa campagne n'apparaisse dans l'onglet Threats | `10` |
| `KRAWL_REFERER_ENABLED` | Enregistrer le Referer HTTP entrant dans les journaux d'accès, pour le suivi des chaînes d'appât | `true` |
</details>
<details>
<summary><b>Liste de bannissement et IP ignorées</b> (4 variables)</summary>
Partage de listes de bannissement avec d'autres instances, et trafic à ne jamais suivre.
| Variable d'environnement | Description | Valeur par défaut |
|----------------------|-------------|---------|
| `KRAWL_IGNORED_IPS` | IP/CIDR séparés par des virgules jamais suivis, bannis ou exportés | Loopback, RFC1918, link-local, CGNAT |
| `KRAWL_BANLIST_EXPORT_PATH` | Chemin de téléchargement public de la liste de bannissement, ex. `/public_banlist.txt` (vide = désactivé) | `""` |
| `KRAWL_BANLIST_SOURCES` | URL de listes de bannissement amont séparées par des virgules à récupérer et fusionner | Liste de bannissement communautaire Krawl |
| `KRAWL_BANLIST_REFRESH_INTERVAL` | Secondes entre les récupérations de listes de bannissement amont | `3600` |
</details>
<details>
<summary><b>Pages de tromperie générées par IA</b> (10 variables)</summary>
Voir la [documentation sur la génération par IA](https://github.com/blessedrebus/krawl/blob/main/docs/ai_generation.md).
| Variable d'environnement | Description | Valeur par défaut |
|----------------------|-------------|---------|
| `KRAWL_AI_ENABLED` | Activer les pages de tromperie générées par IA | `false` |
| `KRAWL_AI_PROVIDER` | Fournisseur d'IA (`"openrouter"` ou `"openai"`) | `"openrouter"` |
| `KRAWL_AI_OPENAI_BASE_URL` | URL de base OpenAI optionnelle pour des points de terminaison API personnalisés | `"https://api.openai.com/v1"` |
| `KRAWL_AI_API_KEY` | Clé API pour le fournisseur d'IA | `None` |
| `KRAWL_AI_MODEL` | Modèle d'IA à utiliser pour la génération de pages | `"nvidia/nemotron-3-super-120b-a12b:free"` |
| `KRAWL_AI_TIMEOUT` | Délai d'expiration des requêtes en secondes pour les appels à l'API d'IA | `60` |
| `KRAWL_AI_MAX_DAILY_REQUESTS` | Nombre maximum de pages générées par IA par jour (0 = illimité) | `0` |
| `KRAWL_AI_PROMPT` | Modèle d'invite personnalisé pour la génération de pages par IA | Invite par défaut |
| `KRAWL_AI_REASONING_ENABLED` | Activer les jetons de raisonnement (modèles de raisonnement OpenRouter uniquement) | `false` |
| `KRAWL_AI_REASONING_EFFORT` | Effort de raisonnement (`none`, `minimal`, `low`, `medium`, `high`, `xhigh`) | `"medium"` |
</details>
<details>
<summary><b>Mode évolutif : PostgreSQL et Redis</b> (13 variables)</summary>
Utilisé uniquement lorsque `KRAWL_MODE=scalable`. Voir [Modes de déploiement](https://github.com/blessedrebus/krawl/blob/main/docs/deployment-modes.md).
| Variable d'environnement | Description | Valeur par défaut |
|----------------------|-------------|---------|
| `KRAWL_MODE` | Mode de déploiement (`standalone` ou `scalable`) | `standalone` |
| `KRAWL_POSTGRES_HOST` | Nom d'hôte PostgreSQL | `localhost` |
| `KRAWL_POSTGRES_PORT` | Port PostgreSQL | `5432` |
| `KRAWL_POSTGRES_USER` | Nom d'utilisateur PostgreSQL | `krawl` |
| `KRAWL_POSTGRES_PASSWORD` | Mot de passe PostgreSQL | `krawl` |
| `KRAWL_POSTGRES_DATABASE` | Nom de la base de données PostgreSQL | `krawl` |
| `KRAWL_REDIS_HOST` | Nom d'hôte Redis | `localhost` |
| `KRAWL_REDIS_PORT` | Port Redis | `6379` |
| `KRAWL_REDIS_DB` | Numéro de base de données Redis | `0` |
| `KRAWL_REDIS_PASSWORD` | Mot de passe Redis | Aucun |
| `KRAWL_REDIS_CACHE_TTL` | TTL en secondes pour les données de préchauffage du tableau de bord | `600` |
| `KRAWL_REDIS_HOT_TTL` | TTL en secondes pour les données de chemin chaud (infos de bannissement, catégories d'IP) | `30` |
| `KRAWL_REDIS_TABLE_TTL` | TTL en secondes pour les tables paginées du tableau de bord | `120` |
</details>
Par exemple```bash
# Set canary token
export CONFIG_LOCATION="config.yaml"
export KRAWL_CANARY_TOKEN_URL="http://your-canary-token-url"
# Set number of pages range (min,max format)
export KRAWL_LINKS_PER_PAGE_RANGE="5,25"
# Set analyzer thresholds
export KRAWL_HTTP_RISKY_METHODS_THRESHOLD="0.2"
export KRAWL_VIOLATED_ROBOTS_THRESHOLD="0.15"
# Set custom dashboard path and password
export KRAWL_DASHBOARD_SECRET_PATH="/my-secret-dashboard"
export KRAWL_DASHBOARD_PASSWORD="my-secret-password"
```
Exemple d'exécution Docker avec des variables d'environnement (mode autonome) :```bash
docker run -d \
-p 5000:5000 \
-e KRAWL_MODE=standalone \
-e KRAWL_PORT=5000 \
-e KRAWL_DELAY=100 \
-e KRAWL_DASHBOARD_PASSWORD="my-secret-password" \
-e KRAWL_CUSTOM_TEMPLATE_PATH="/templates/custom_page.html" \
-e KRAWL_CANARY_TOKEN_URL="http://your-canary-token-url" \
--name krawl \
ghcr.io/blessedrebus/krawl:latest
```
## Utiliser Krawl pour bannir les IP malveillantes
Krawl utilise un système basé sur la réputation pour classer les adresses IP des attaquants et propose deux méthodes d'exportation de listes d'IP pour l'intégration au pare-feu.
Le point de terminaison `/api/export-ips` interroge directement la base de données et prend en charge le filtrage par catégorie d'IP (`attacker`, `bad_crawler`, `regular_user`, `good_crawler`) et par format de sortie (`raw`, `iptables`, `nftables`) :```bash
curl "https://your-krawl-instance/<DASHBOARD-PATH>/api/export-ips?categories=attacker&fwtype=raw"
```
Cela permet le blocage automatique du trafic malveillant sur diverses plateformes :
* [OPNsense et pfSense](https://ipv64.net/v64_blocklist_integration_guide)
* [RouterOS](https://rentry.co/krawl-routeros)
* [IPtables](https://github.com/blessedrebus/krawl/blob/main/plugins/iptables/README.md) et [Nftables](https://github.com/blessedrebus/krawl/blob/main/plugins/nftables/README.md)
* [Fail2Ban](https://github.com/blessedrebus/krawl/blob/main/plugins/fail2ban/README.md)
Pour les paramètres complets de l'API, des exemples et l'ajout de formats de pare-feu personnalisés, consultez la [documentation des exportateurs de pare-feu](https://github.com/blessedrebus/krawl/blob/main/docs/firewall-exporters.md).
Krawl peut également pousser directement les IP bannies vers une liste d'IP de compte Cloudflare pour une utilisation dans les règles WAF. La synchronisation s'exécute en tant que tâche en arrière-plan et met à jour la liste par remplacement complet à un intervalle configurable. Consultez la documentation [Cloudflare Banlist Sync](https://github.com/blessedrebus/krawl/blob/main/docs/cloudflare_banlist.md).
## Réputation IP
Krawl [utilise des tâches qui analysent le trafic récent pour construire et mettre à jour en continu un score de réputation IP](https://github.com/blessedrebus/krawl/blob/main/src/tasks/analyze_ips.py). Elle s'exécute périodiquement et évalue chaque adresse IP active en fonction de multiples indicateurs comportementaux afin de la classer comme attaquant, crawler ou utilisateur régulier. Les seuils sont entièrement personnalisables.
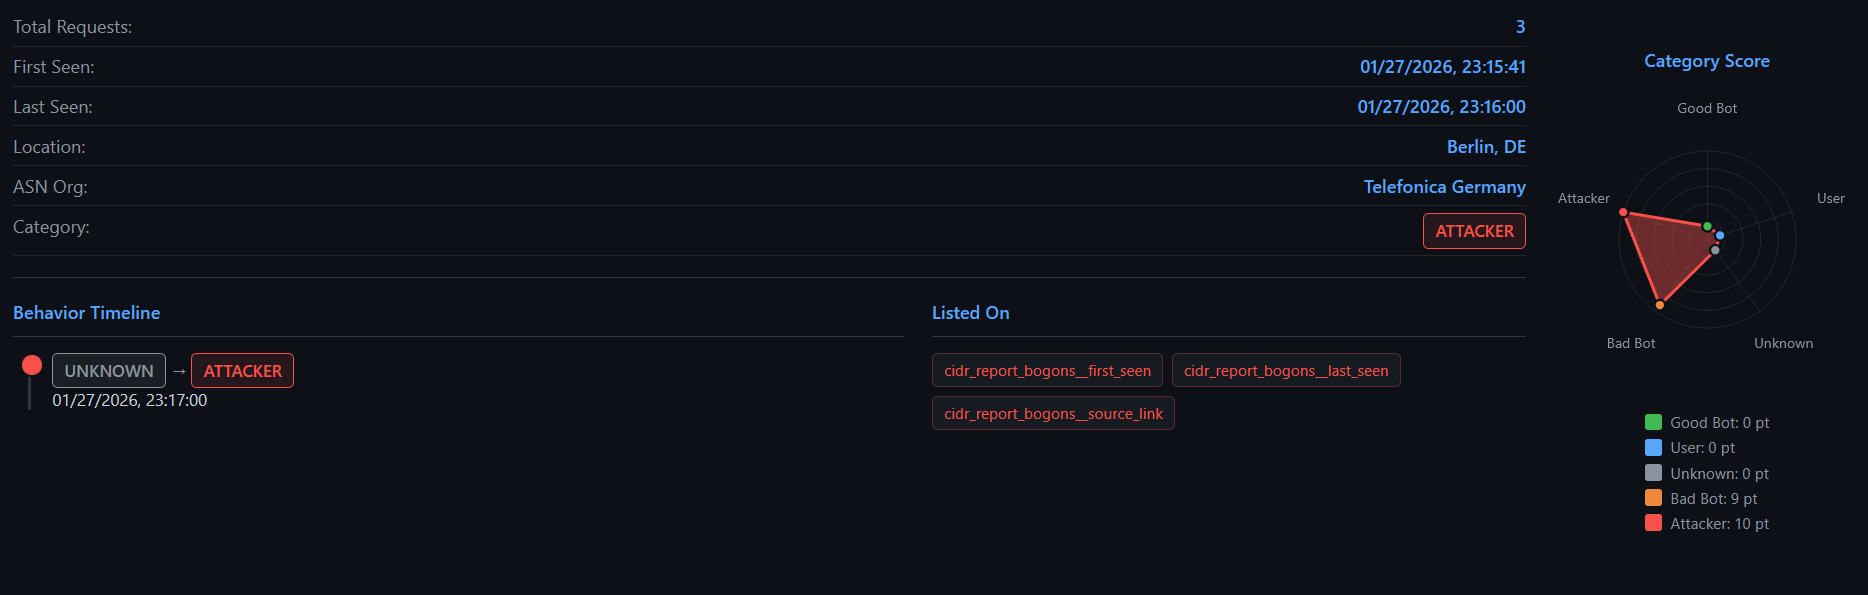
L'analyse comprend :
- **Utilisation de méthodes HTTP à risque** (par ex. ratios POST, PUT, DELETE)
- **Violations de Robots.txt**
- **Anomalies de timing des requêtes** (motifs en rafale ou irréguliers)
- **Cohérence du User-Agent**
- **Détection d'URL d'attaque** (par ex. injection SQL, motifs XSS)
Chaque signal contribue à un modèle de notation pondéré qui attribue une catégorie de réputation :
- `attacker`
- `bad_crawler`
- `good_crawler`
- `regular_user`
- `unknown` (pour données insuffisantes)
Les scores et métriques résultants sont stockés dans la base de données et utilisés par Krawl pour alimenter les tableaux de bord, le suivi de réputation et les actions d'atténuation automatisées telles que le bannissement d'IP ou l'intégration au pare-feu.
## Pages de déception générées par IA
---
[Read more](https://github.com/blessedrebus/krawl)

