

Krawl est un serveur de déception web personnalisable, léger et natif du cloud, ainsi qu'un anti-crawler, qui crée de fausses applications web présentant des vulnérabilités faciles à exploiter en utilisant des données leurres réalistes générées aléatoirement et des modèles HTML générés par IA.
Un serveur honeypot web moderne et personnalisable, conçu pour détecter et suivre l'activité malveillante des attaquants et des robots d'exploration web au moyen de pages web trompeuses, d'identifiants factices et de jetons canaris.




Astuce : explorez les chemins du robots.txt pour plus de divertissement
Krawl est un serveur de tromperie cloud‑native conçu pour détecter, retarder et analyser les attaquants malveillants, les robots d'exploration web et les scanners automatisés.
Il crée de fausses applications web réalistes remplies de cibles faciles telles que des panneaux d'administration, des fichiers de configuration et des identifiants factices exposés, afin d'attirer et d'identifier les activités suspectes.
En gaspillant les ressources des attaquants, Krawl aide à distinguer clairement les comportements malveillants des robots d'exploration légitimes.
Il propose :
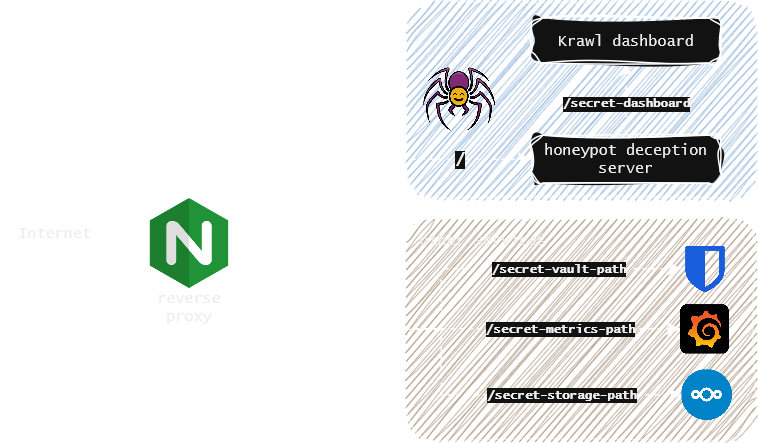
responses/manifest.yamlVous pouvez facilement exposer Krawl aux côtés de vos autres services pour les protéger des crawlers web et des utilisateurs malveillants à l'aide d'un reverse proxy. Pour plus de détails, consultez la documentation sur le reverse proxy.
Krawl fournit un tableau de bord complet, accessible à un chemin secret aléatoire généré au démarrage ou à un chemin personnalisé configuré via KRAWL_DASHBOARD_SECRET_PATH. Cela permet de garder le tableau de bord caché des attaquants qui scannent votre honeypot.
Cinq onglets sont accessibles à toute personne connaissant le chemin du tableau de bord :
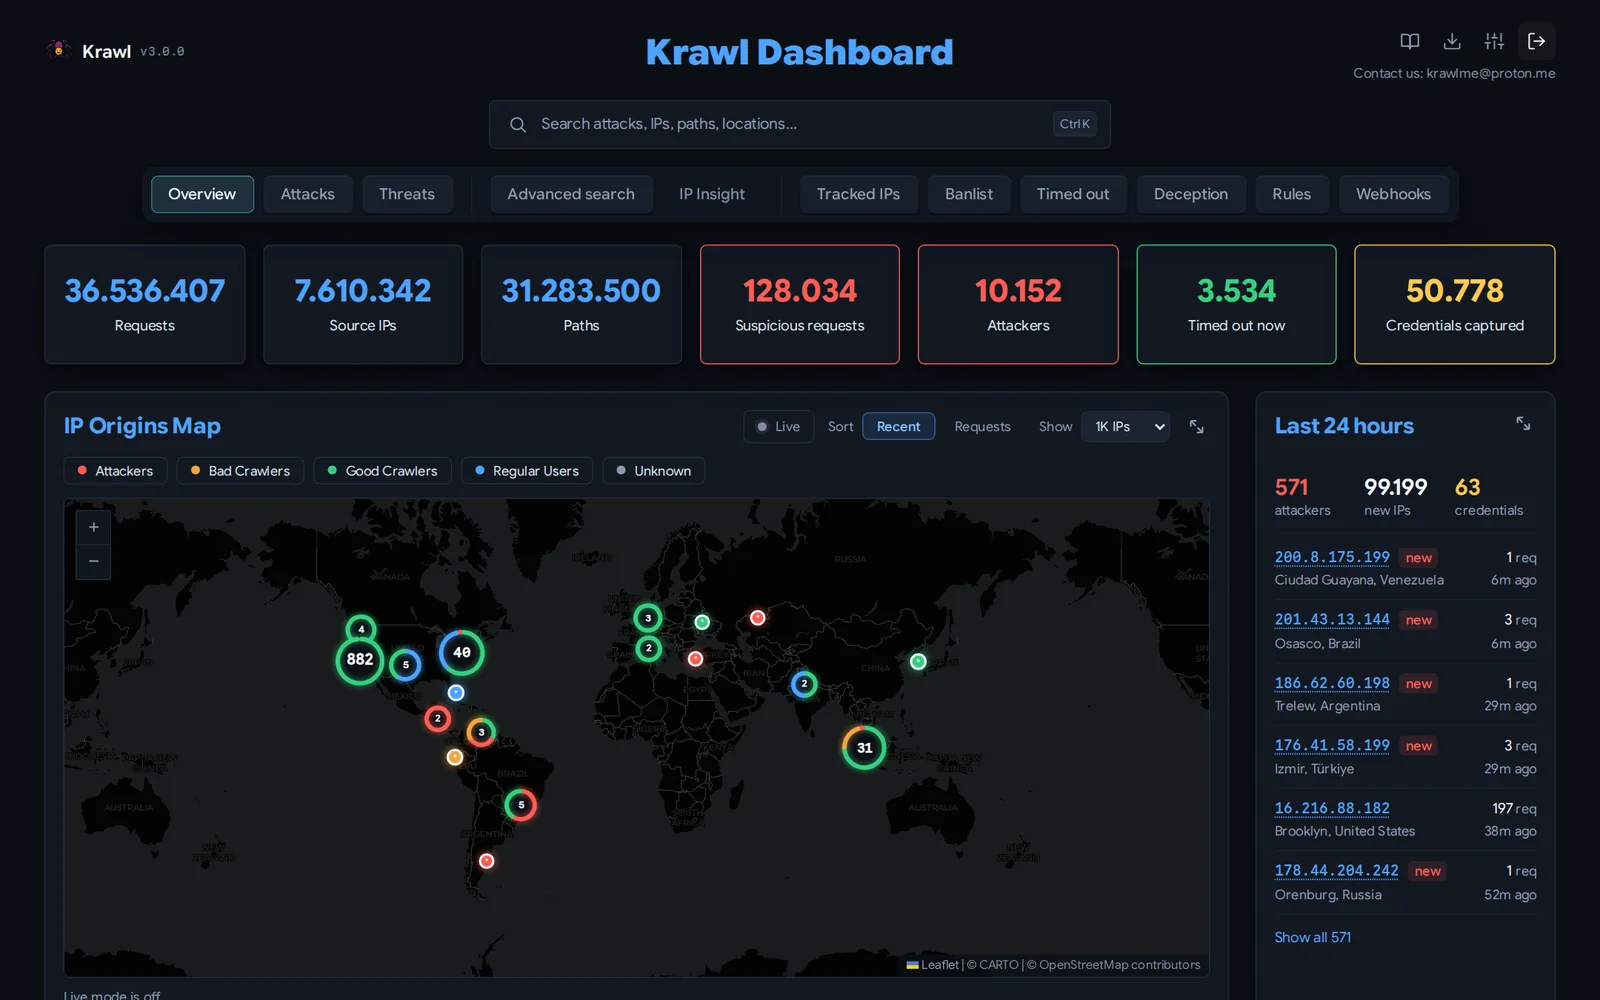
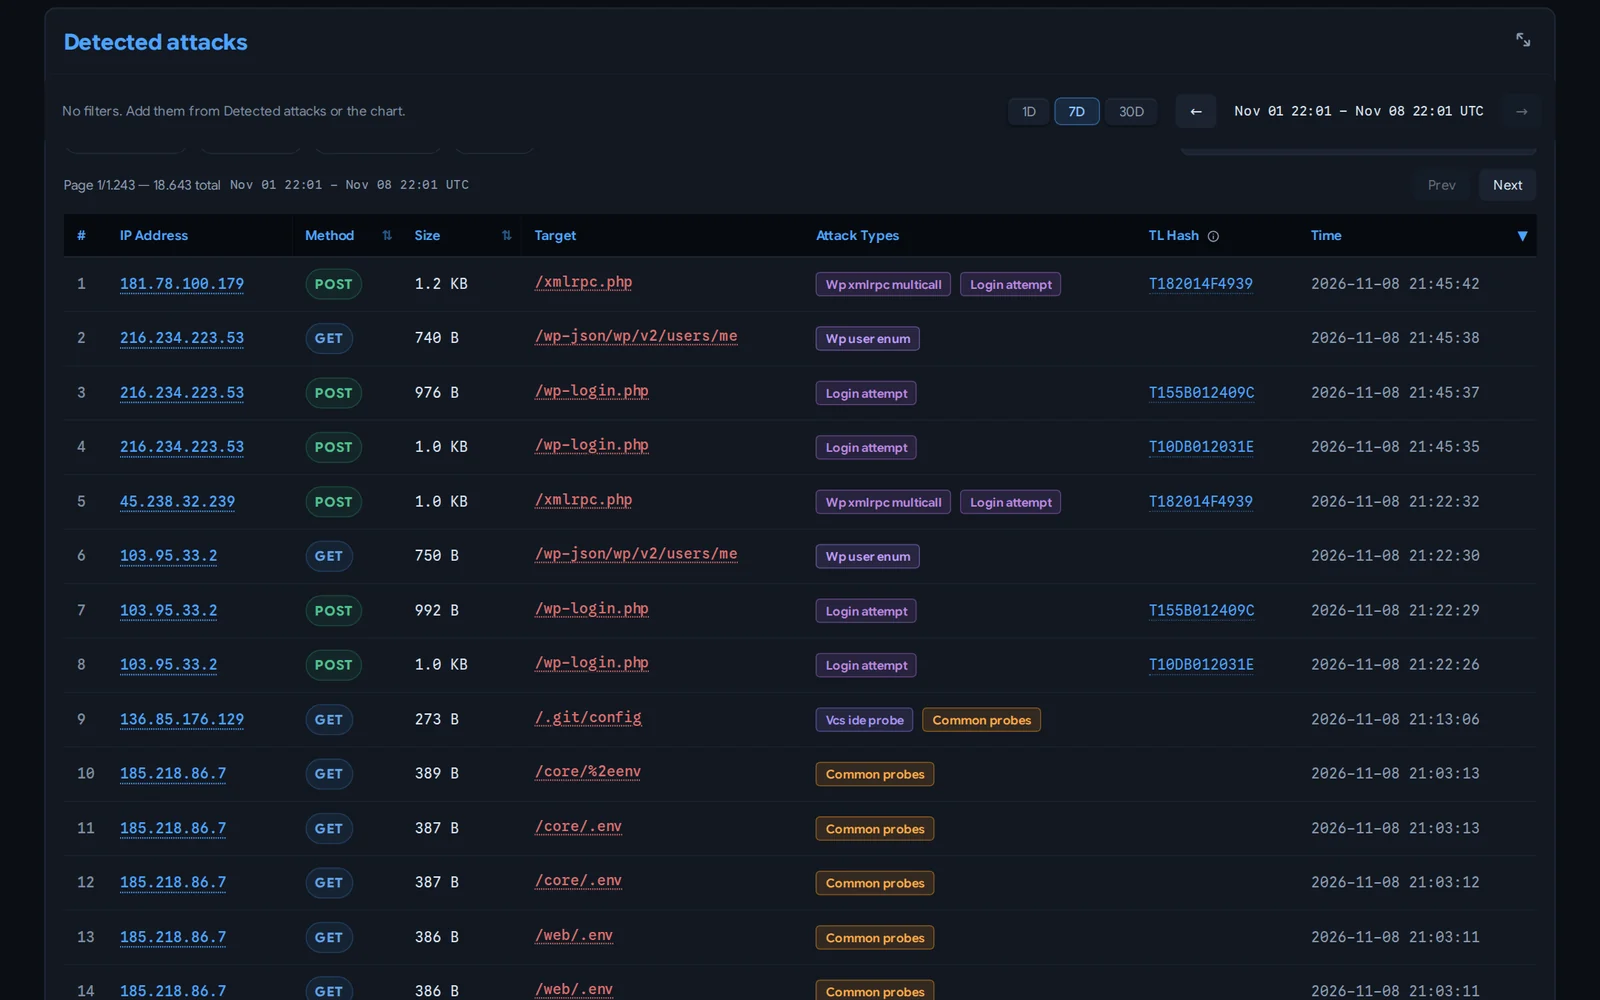
Menaces : charges utiles regroupées en campagnes par hachage flou TLSH, afin qu'un webshell et ses variantes modifiées soient lus comme une seule campagne plutôt que comme des détections sans lien, avec un index de chaque fichier capturé.
Recherche avancée : retrouver les requêtes stockées par chemin, hôte, IP, referer, user agent, méthode, texte brut de la requête et en-têtes HTTP.







