
 battelle/sandsifter
Le fuzzer de processeur x86

: le fuzzer de processeurs x86
Le sandsifter audite les processeurs x86 à la recherche d'instructions cachées et de bugs matériels, en générant systématiquement du code machine pour parcourir le jeu d'instructions d'un processeur, et en surveillant l'exécution à la recherche d'anomalies. Sandsifter a révélé des instructions processeur secrètes chez tous les grands fabricants ; des bugs logiciels omniprésents dans les désassembleurs, assembleurs et émulateurs ; des failles dans les hyperviseurs d'entreprise ; ainsi que des bugs matériels à la fois bénins et critiques pour la sécurité dans les puces x86.
Avec la multitude de processeurs x86 existants, l'objectif de l'outil est de permettre aux utilisateurs de vérifier leurs propres systèmes à la recherche d'instructions cachées et de bugs.
Pour exécuter un audit de base sur votre processeur :
sudo ./sifter.py --unk --dis --len --sync --tick -- -P1 -t

L'ordinateur est systématiquement analysé à la recherche d'instructions anormales. Dans la moitié supérieure, vous pouvez voir les instructions que le sandsifter teste actuellement sur le processeur. Dans la moitié inférieure, le sandsifter signale les anomalies qu'il trouve.
La recherche prendra de quelques heures à quelques jours, selon la vitesse et la complexité de votre processeur. Lorsqu'elle est terminée, résumez les résultats :
./summarize.py data/log
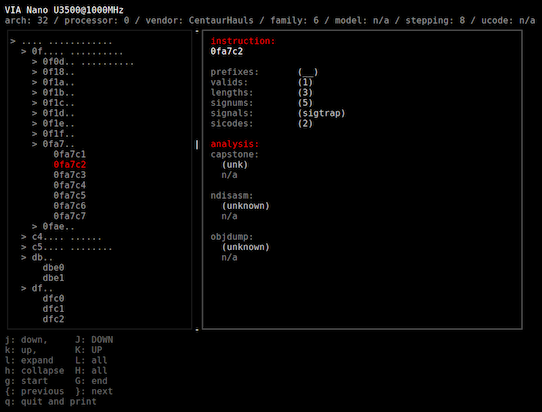
En général, plusieurs millions d'instructions non documentées seront trouvées sur votre processeur, mais celles-ci se répartissent généralement en un petit nombre de groupes différents. Après avoir regroupé les anomalies, l'outil summarize tente d'attribuer chaque instruction à une catégorie de problème :
Appuyez sur « Q » pour quitter et obtenir un résumé textuel de l'analyse du système :
Les résultats d'une analyse peuvent parfois être difficiles à classer automatiquement par les outils, et peuvent nécessiter une analyse manuelle. Pour obtenir de l'aide pour analyser vos résultats, n'hésitez pas à envoyer le fichier ./data/log à [email protected]. Aucune information personnelle, autre que la marque, le modèle et la révision du processeur (à partir de /proc/cpuinfo), n'est incluse dans ce journal.
L'analyse avec le sandsifter a révélé des fonctionnalités processeur non documentées dans des dizaines de catégories d'opcodes, des failles dans les hyperviseurs d'entreprise, des bugs dans presque tous les principaux outils de désassemblage et d'émulation, ainsi que des bugs matériels critiques ouvrant des vulnérabilités de sécurité dans le processeur lui-même.
Les détails des résultats se trouvent dans le livre blanc du projet.
(TODO : énumération détaillée des résultats ici)
Sandsifter nécessite d'abord l'installation du désassembleur Capstone : http://www.capstone-engine.org/. Capstone peut généralement être installé avec :
sudo apt-get install libcapstone3 libcapstone-dev
sudo pip install capstone
Sandsifter peut être compilé avec :
make
puis est exécuté avec :
sudo ./sifter.py --unk --dis --len --sync --tick -- -P1 -t
Les options sont passées au sifter avec --flag, et à l'injecteur avec -- -f.
Exemple :
sudo ./sifter.py --unk --dis --len --sync --tick -- -P1 -t
Options du sifter :
--len
	recherche les différences de longueur dans toutes les instructions (instructions qui
	se sont exécutées différemment de ce que le désassembleur attendait, ou qui
	n'existaient pas alors que le désassembleur les attendait

--dis
	recherche les différences de longueur dans les instructions valides (instructions qui
	se sont exécutées différemment de ce que le désassembleur attendait)

--unk
	recherche les instructions inconnues (instructions que le désassembleur ne
	connaît pas mais qui s'exécutent avec succès)

--ill
	l'inverse de --unk, recherche les désassemblages invalides (instructions qui ne
	s'exécutent pas avec succès mais que le désassembleur reconnaît)

--tick
	écrit périodiquement l'instruction courante sur le disque

--save
	sauvegarde la progression de la recherche à la sortie

--resume
	reprend la recherche à partir du dernier état sauvegardé

--sync
	écrit les résultats de la recherche sur le disque au fur et à mesure qu'ils sont trouvés

--low-mem
	ne stocke pas les résultats en mémoire
Options de l'injecteur :
-b
	mode : force brute

-r
	mode : fuzzing aléatoire

-t
	mode : fuzzing tunnelisé

-d
	mode : fuzzing dirigé en externe

-R
	mode de sortie brute

-T
	mode de sortie texte

-x
	écrit la progression périodique sur stderr

-0
	autorise la déréférence nulle (nécessite sudo)

-D
	autorise les préfixes en double

-N
	pas de prise en charge du bit NX

-s seed
	en recherche aléatoire, valeur de la graine

-B brute_depth
	en recherche par force brute, profondeur de recherche maximale

-P max_prefix
	nombre maximal de préfixes à rechercher

-i instruction
	instruction à partir de laquelle démarrer la recherche (incluse)

-e instruction
	instruction à laquelle terminer la recherche (exclue)

-c core
	cœur sur lequel effectuer la recherche

-X blacklist
	met sur liste noire l'instruction spécifiée

-j jobs
	nombre de tâches simultanées à exécuter

-l range_bytes
	nombre d'octets d'instruction de base dans chaque sous-plage
m: Mode - change le mode de recherche (force brute, aléatoire ou tunnel) du sifter
q: Quitter - quitte le sifter
p: Pause - met en pause ou reprend la recherche
L'analyse prend en charge quatre algorithmes de recherche différents, qui peuvent être définis en ligne de commande ou parcourus via des raccourcis clavier.
sudo
Pour de meilleurs résultats, l'outil doit être exécuté en tant qu'utilisateur root. Cela est nécessaire pour que le processus puisse mapper en mémoire une page à l'adresse 0, ce qui nécessite des privilèges root. Cette page empêche de nombreuses instructions de provoquer des erreurs de segmentation lors des accès mémoire, ce qui permet une analyse des défauts plus précise.
Préfixes
La principale limitation de la profondeur d'une recherche d'instructions est le nombre d'octets de préfixe à explorer, chaque octet de préfixe supplémentaire augmentant l'espace de recherche d'un facteur d'environ 10. Limitez les octets de préfixe avec l'option -P.
Couleurs
