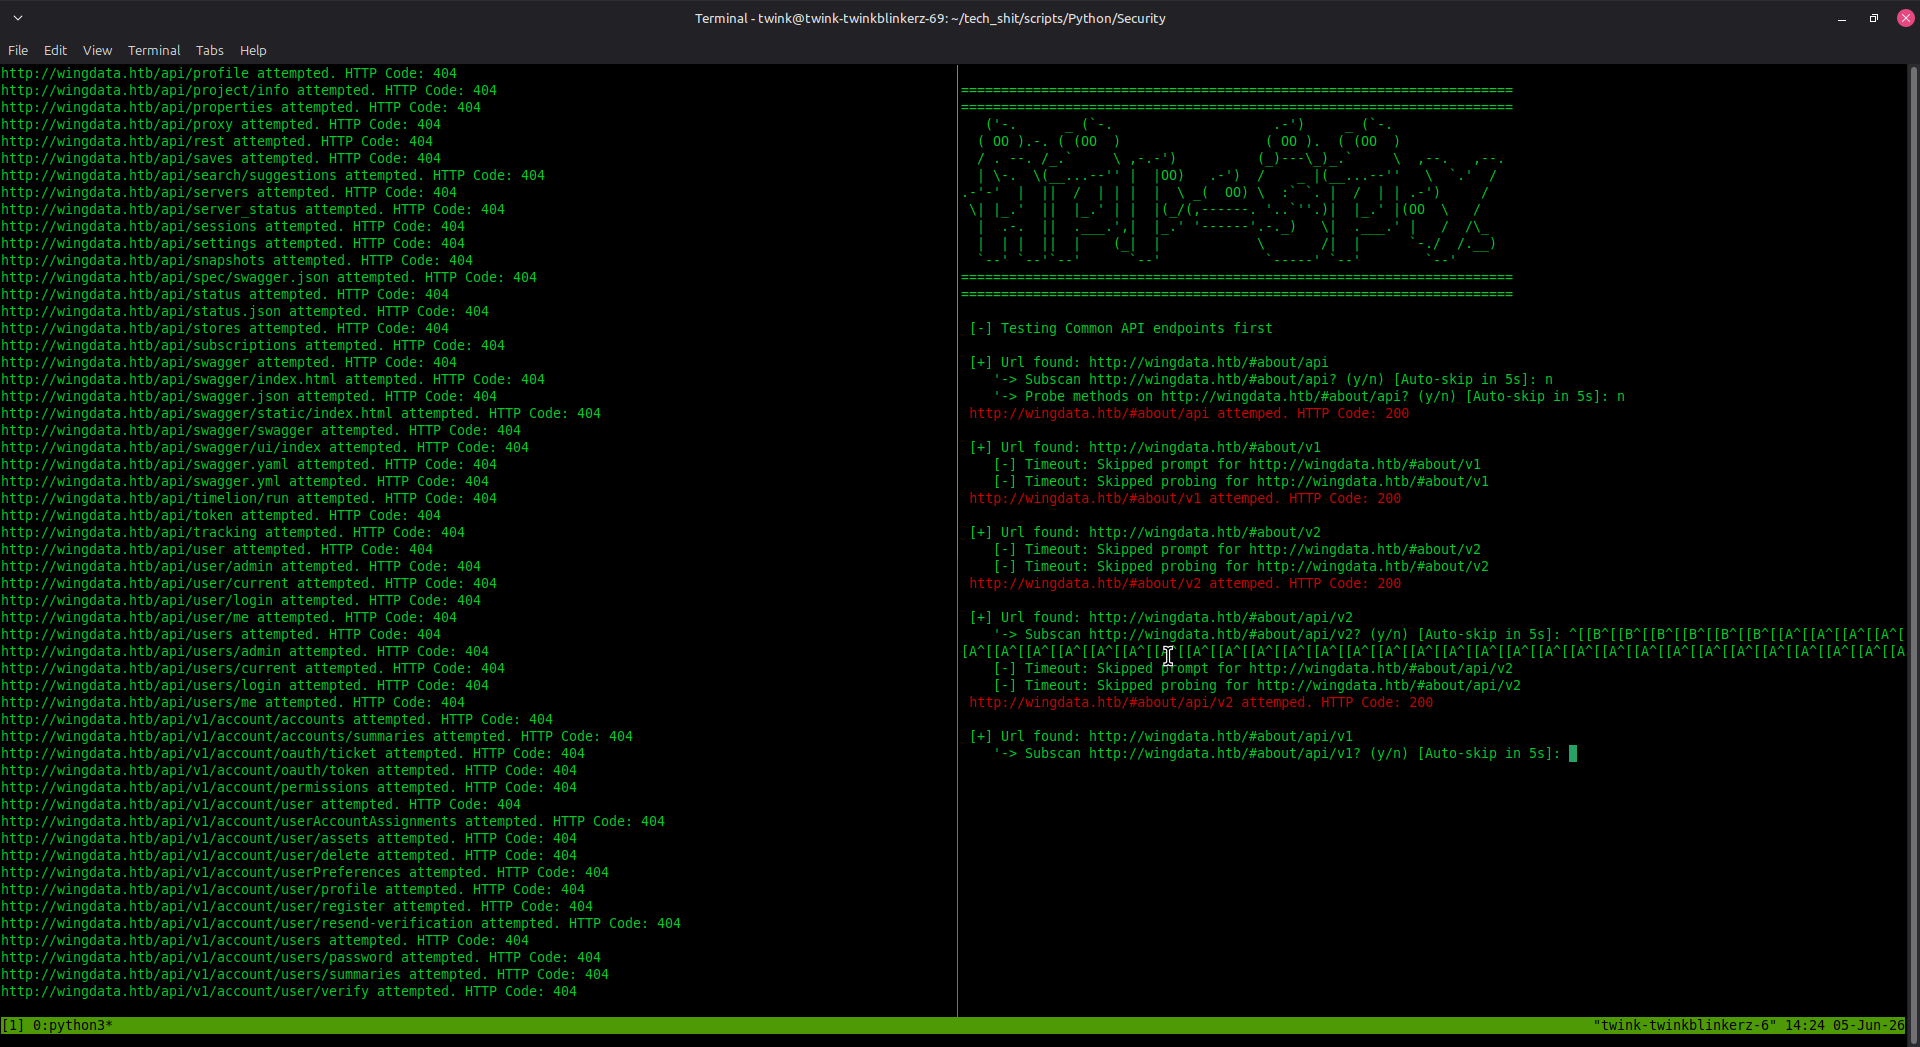

Un puissant outil de brute-force de répertoires conçu pour les opérations récursives/multiplexées, la découverte et l'énumération d'API, le scraping de fichiers JS, et l'énumération des méthodes HTTP API, en une seule commande. Il n'est pas limité aux API, mon outil excelle simplement dans ce domaine.
Un outil puissant de brute-force de répertoires conçu pour la reconnaissance d'API et les tests d'intrusion. Découvre automatiquement les points d'extrémité d'API cachés, effectue un sous-scan récursif et sonde les méthodes HTTP pour une énumération plus approfondie des API.
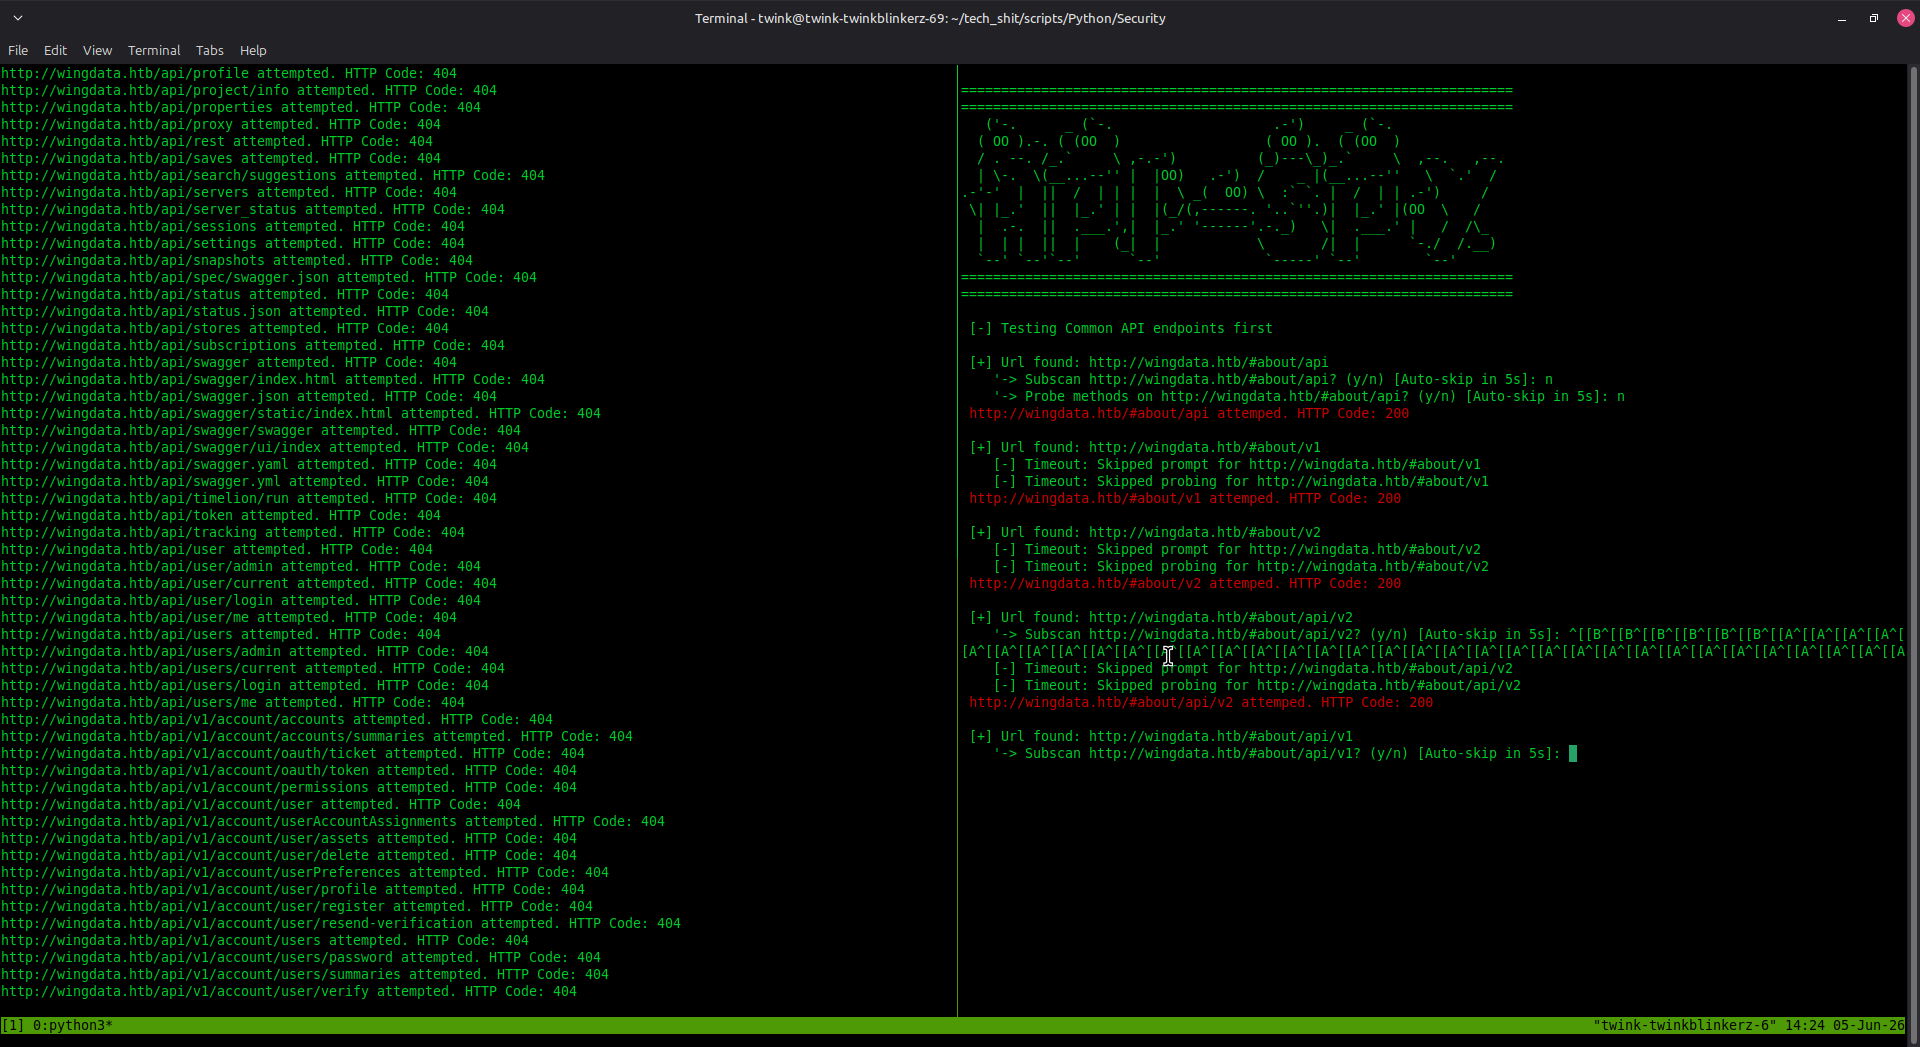
✨ Fonctionnalités principales :
requeststmux (optionnel, pour le drapeau --split)xfce-terminal (pour les environnements de bureau Linux)# Clonez le dépôt
git clone https://github.com/austinjump-sec/API-SPY.git
cd API-SPY
# Installez les dépendances
pip install requests
# Rendez les scripts exécutables (optionnel)
chmod +x apispy.py apiprobe.py
python3 apispy.py <baseUrl> <wordlist> [OPTIONS]
| Argument | Description |
|---|---|
<baseUrl> | URL cible (ex : http://example.com ou http://api.example.com) |
<wordlist> | Chemin vers le fichier wordlist contenant les points d'extrémité (un par ligne) |
| Argument | Description |
|---|---|
--t<number> | Nombre de threads (max 150, défaut : 1) |
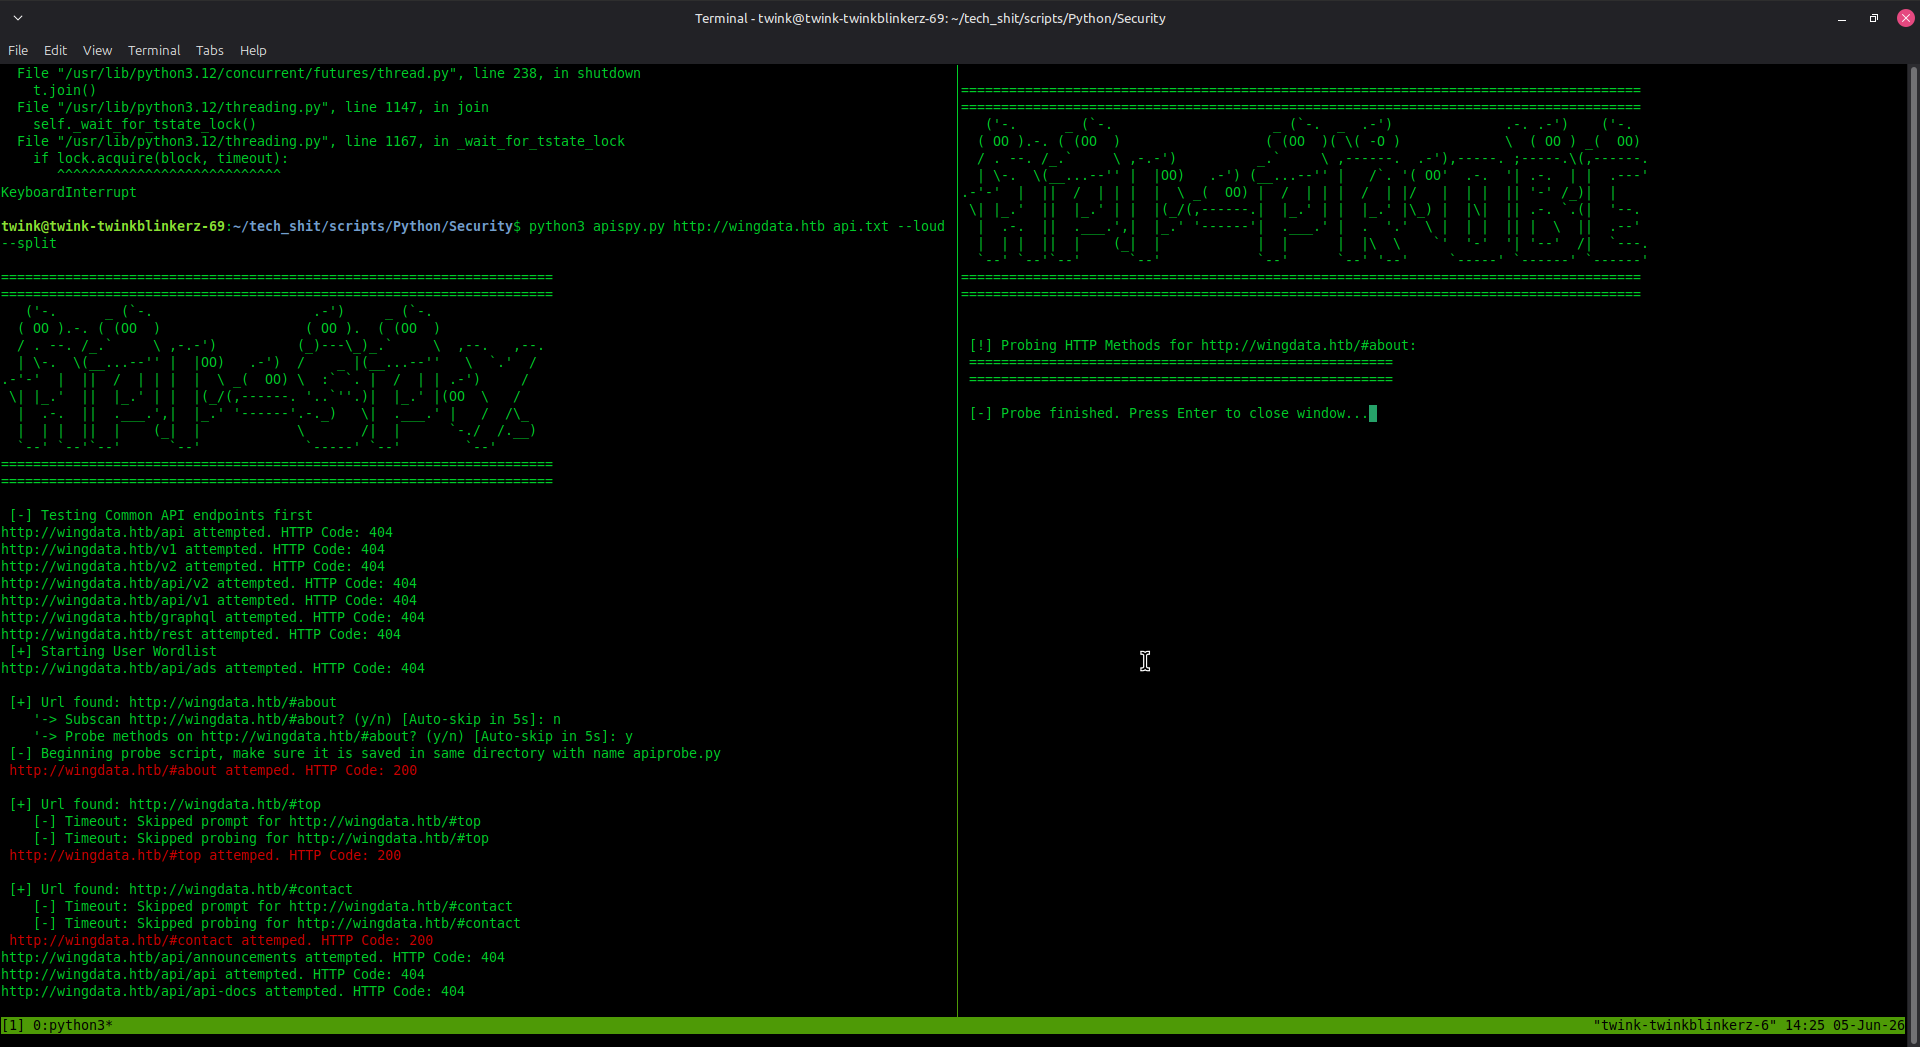
--split | Utiliser tmux split-window au lieu de nouvelles fenêtres de terminal |
--debug | Affiche les messages d'erreur autrement cachés |
--loud | Affiche tous les messages, positifs et erreurs, en mettant en évidence ceux qui ne renvoient pas 404 |
--js | Recherche les fichiers JavaScript et récupère les points d'extrémité d'API codés en dur courants |
python3 apispy.py http://api.example.com wordlist.txt
python3 apispy.py http://api.example.com wordlist.txt -t10
python3 apispy.py http://api.example.com wordlist.txt -t5 --split
python3 apispy.py http://api.example.com/v1 wordlist.txt -t20
L'outil commence par tester un ensemble prédéfini de chemins d'API courants :
api, v1, v2, api/v1, api/v2, graphql, rest#)200, 401, 403Lorsqu'un point d'extrémité est trouvé, vous êtes invité :
'-> Subscan <url>? (y/n) [Auto-skip in 5s]:
y/yes pour scanner récursivement ce point d'extrémité avec la même wordlistAprès le sous-scan, vous êtes invité :
'-> Probe methods on <url>? (y/n) [Auto-skip in 5s]:
apiprobe.py qui teste les méthodes HTTP sur le point d'extrémité découvertAllow[+] Url found: http://api.example.com/v1 ← 200 OK (accessible)
'-> Subscan http://api.example.com/v1? (y/n) [Auto-skip in 0s]:
[-] Timeout: Skipped prompt for http://api.example.com/v1?
'-> Probe methods on http://api.example.com/v1? (y/n) [Auto-skip in 4s]:
[-] Url found but not permitted (403 ERR): ... ← Forbidden but exists
[-] Url found but not permitted (401 ERR): ... ← Requires authentication
[+] GET     -> STATUS: 200 OK (Size: 1024)
[-] POST    -> STATUS: 405 (Size: 0)
[Header Hint] Allow: GET, HEAD, OPTIONS
Créez un fichier texte simple avec les points d'extrémité (un par ligne) :
admin
users
api/users
v1/products
v2/customers
/api/v1/auth
/graphql
search
data
config
Remarque : Les lignes commençant par # sont considérées comme des commentaires et ignorées.
Wordlists d'API populaires à utiliser avec API-SPY :
# Mode furtif (peu de threads)
python3 apispy.py http://target.com wordlist.txt -t3

# Mode équilibré
python3 apispy.py http://target.com wordlist.txt -t15

# Mode agressif
python3 apispy.py http://target.com wordlist.txt -t50
timeout=5 dans le code source pour personnaliserAssurez-vous que le chemin du wordlist est correct et que le fichier existe :
ls -la /path/to/wordlist.txt
Lors du sous-scan, assurez-vous :
apispy.pyapiprobe.pySi --split échoue :
sudo apt install tmuxtmux new-session -s scancurl http://your-url/check_status()
