Rétro-ingénierie : décompilation de code binaire avec de grands modèles de langage
Mises à jour
[2025-10-04] : publication de SK²Decompile : décompilation binaire en deux phases par LLM, du squelette à la peau. Phase 1 - Récupération de la structure (squelette) : transforme le code binaire/pseudo-code en représentations intermédiaires obfusquées 🤗 Lien HF. Phase 2 - Nommage des identifiants (peau) : génère un code source lisible par l'humain avec des identifiants significatifs 🤗 Lien HF.
[2025-05-20] : publication de decompile-bench, qui contient deux millions de paires de fonctions binaire-source pour l'entraînement et 70 000 paires de fonctions pour l'évaluation. Veuillez vous référer au dossier decompile-bench pour plus de détails.
[2024-10-17] : publication de decompile-ghidra-100k, un sous-ensemble de 100 000 échantillons d'entraînement (25 000 par niveau d'optimisation). Nous fournissons un script d'entraînement qui s'exécute en environ 3,5 heures sur un seul GPU A100 40G. Il atteint un taux de ré-exécutabilité de 0,26, pour un coût total inférieur à 20 $, afin de répliquer rapidement LLM4Decompile.
[2024-09-26] : mise à jour d'un notebook Colab pour démontrer l'utilisation du modèle LLM4Decompile, y compris des exemples pour les modèles LLM4Decompile-End et LLM4Decompile-Ref.
[2024-09-23] : publication de LLM4Decompile-9B-v2, affiné à partir de Yi-Coder-9B, qui a atteint un taux de ré-exécutabilité de 0,6494 sur le benchmark Decompile.
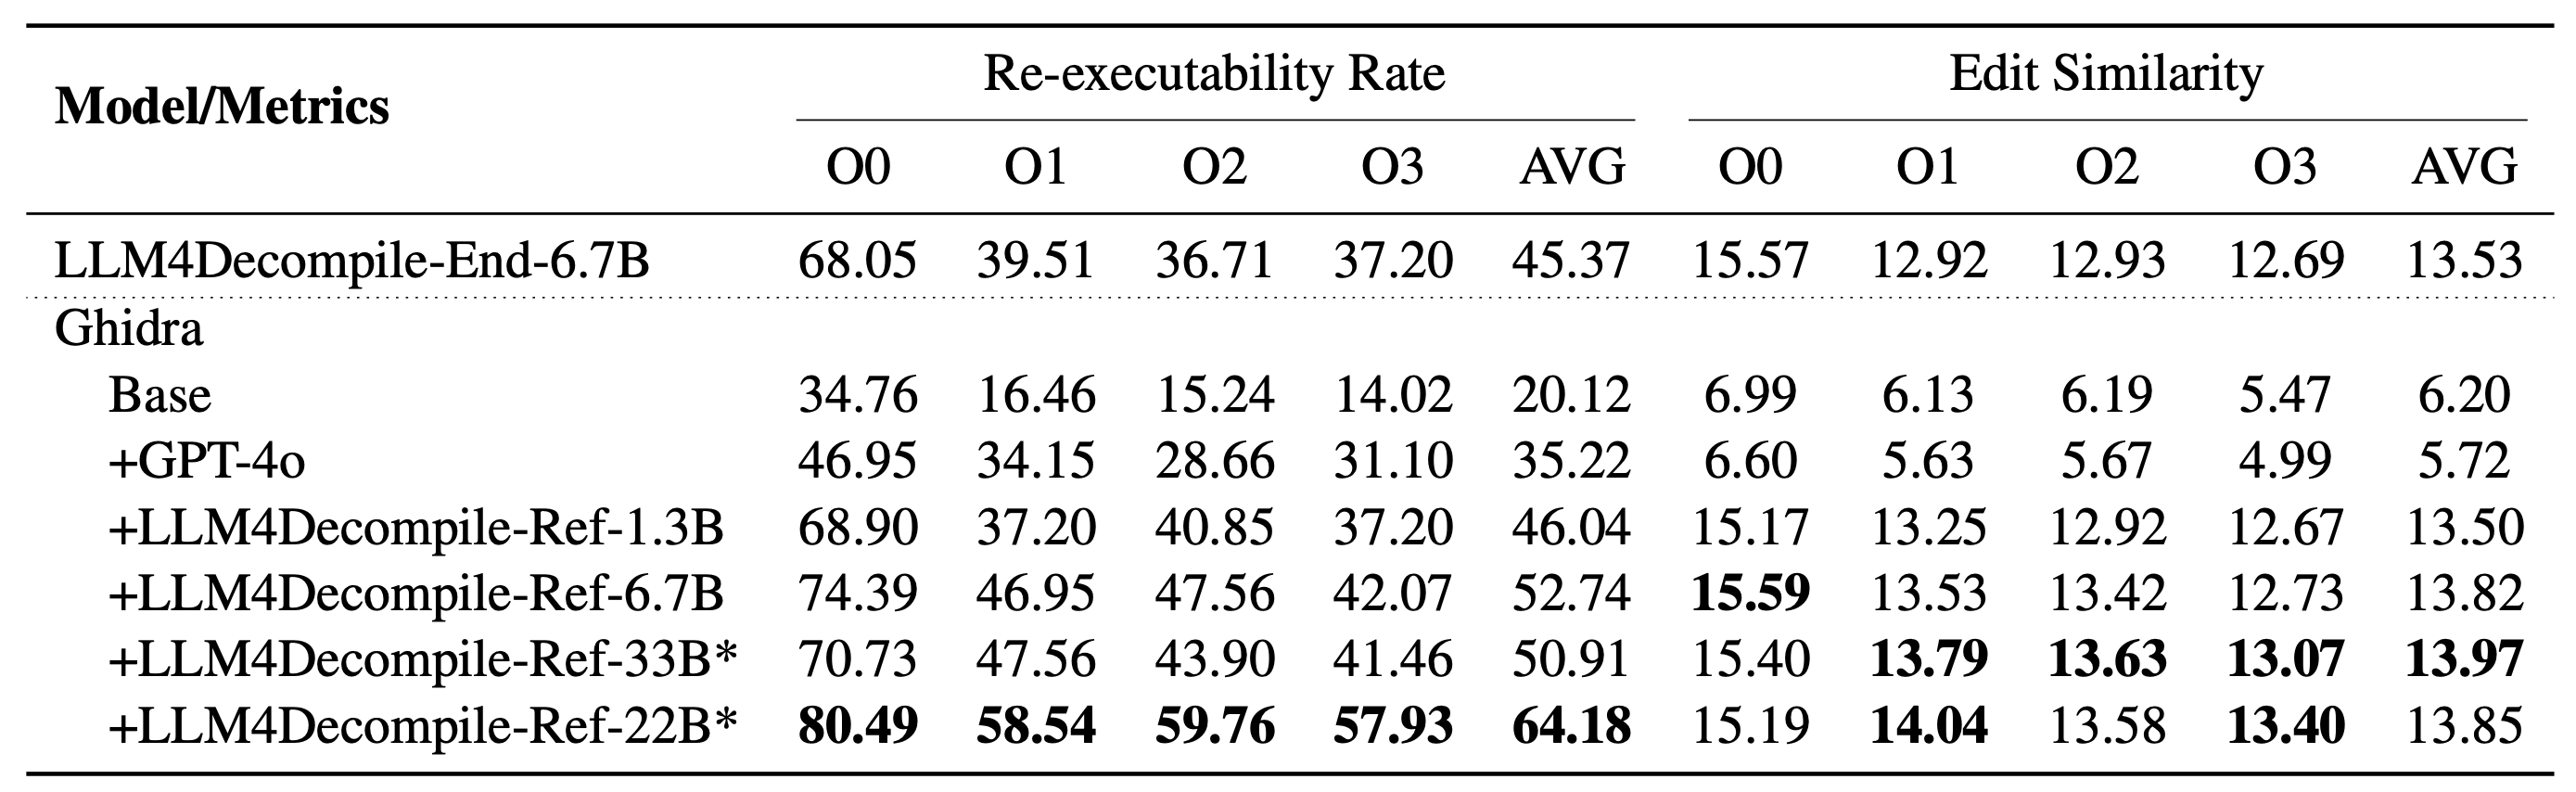
[2024-06-19] : publication de la série V2 (LLM4Decompile-Ref). Les modèles V2 (1.3B-22B), construits sur Ghidra, sont entraînés sur 2 milliards de jetons pour affiner le pseudo-code décompilé par Ghidra. La version 22B-V2 surpasse la 6.7B-V1.5 de 40,1 % supplémentaires. Veuillez consulter le dossier ghidra pour plus de détails.
[2024-05-13] : publication de la série V1.5 (LLM4Decompile-End, décompilation directe du binaire à l'aide d'un LLM). Les modèles V1.5 sont entraînés sur un jeu de données plus volumineux (15B jetons) avec une longueur de jetons maximale de 4 096, et affichent des performances remarquables (plus de 100 % d'amélioration) par rapport au modèle précédent.
[2024-03-16] : ajout du modèle llm4decompile-6.7b-uo, entraîné sans connaissance préalable des niveaux d'optimisation (O0~O3). La ré-exécutabilité moyenne est d'environ 0,219, ce qui en fait le modèle le plus performant de notre gamme.
À propos
LLM4Decompile est le premier grand modèle de langage open-source dédié à la décompilation. Sa version actuelle permet de décompiler des binaires Linux x86_64, des niveaux d'optimisation O0 à O3 de GCC, en code source C lisible par l'humain. Notre équipe s'engage à étendre les capacités de cet outil, avec des efforts continus pour intégrer une gamme plus large d'architectures et de configurations.
LLM4Decompile-End se concentre sur la décompilation directe du binaire. LLM4Decompile-Ref affine le pseudo-code décompilé par Ghidra.
Évaluation
Cadre
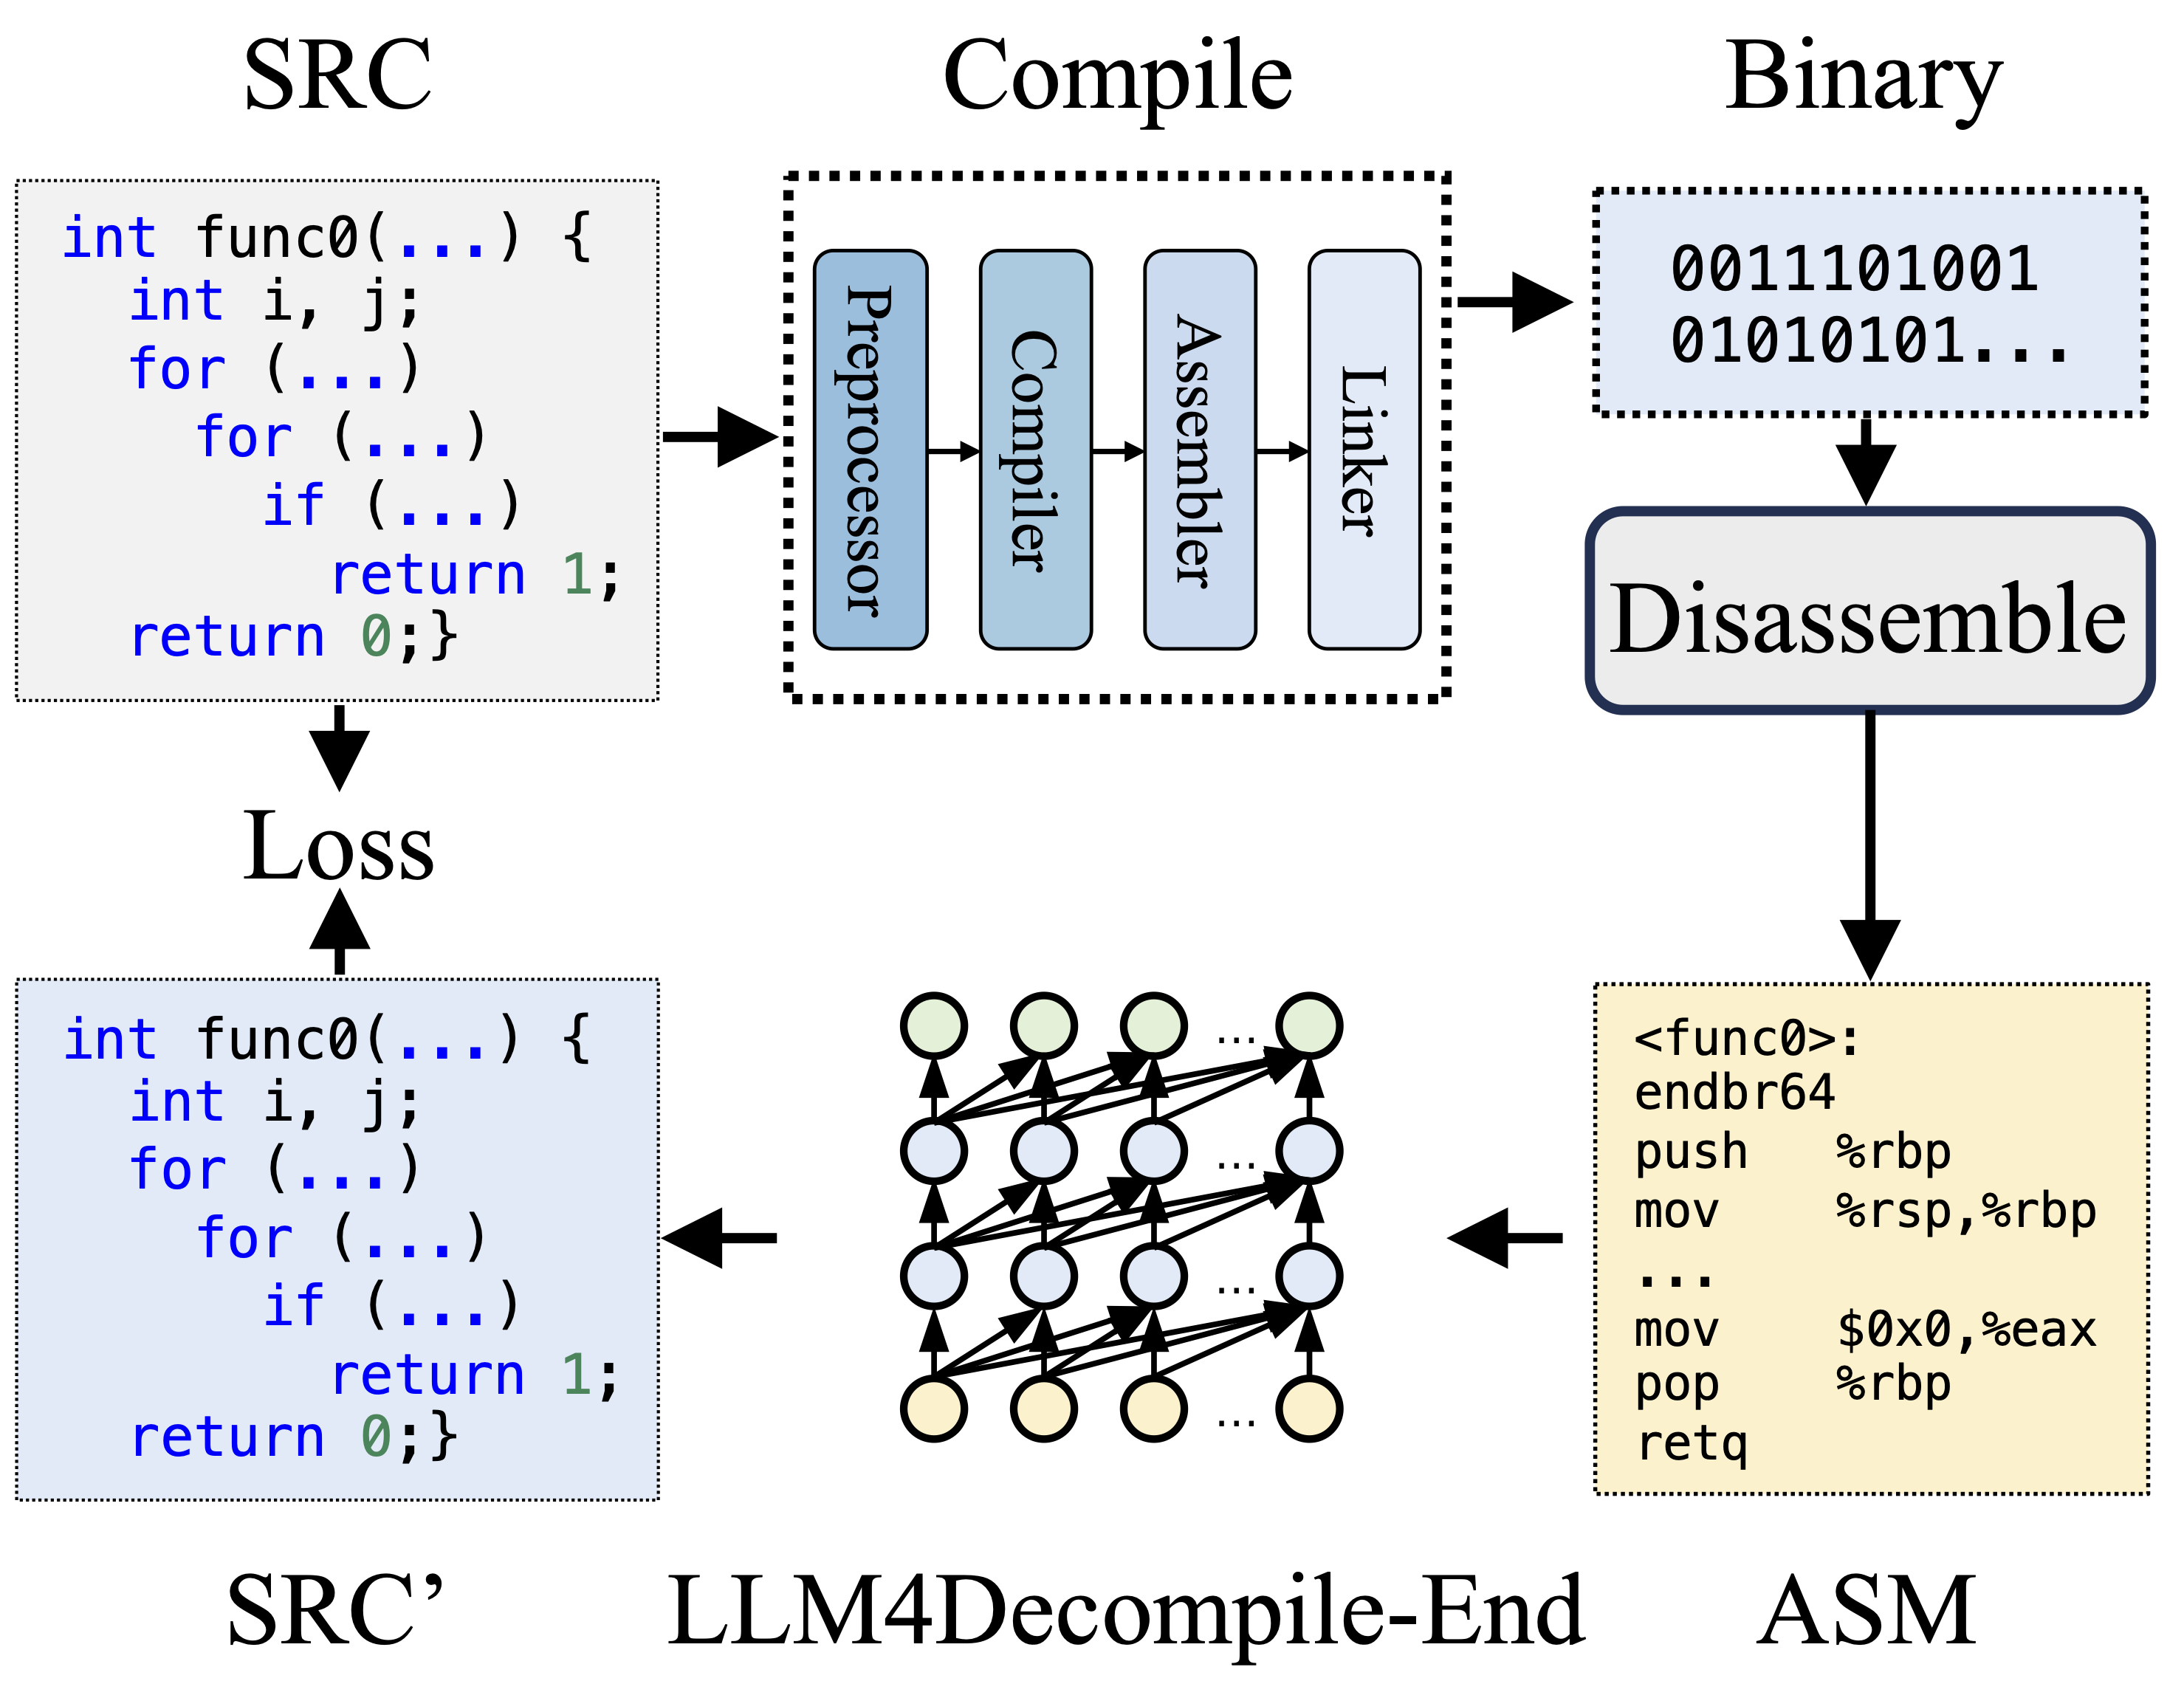
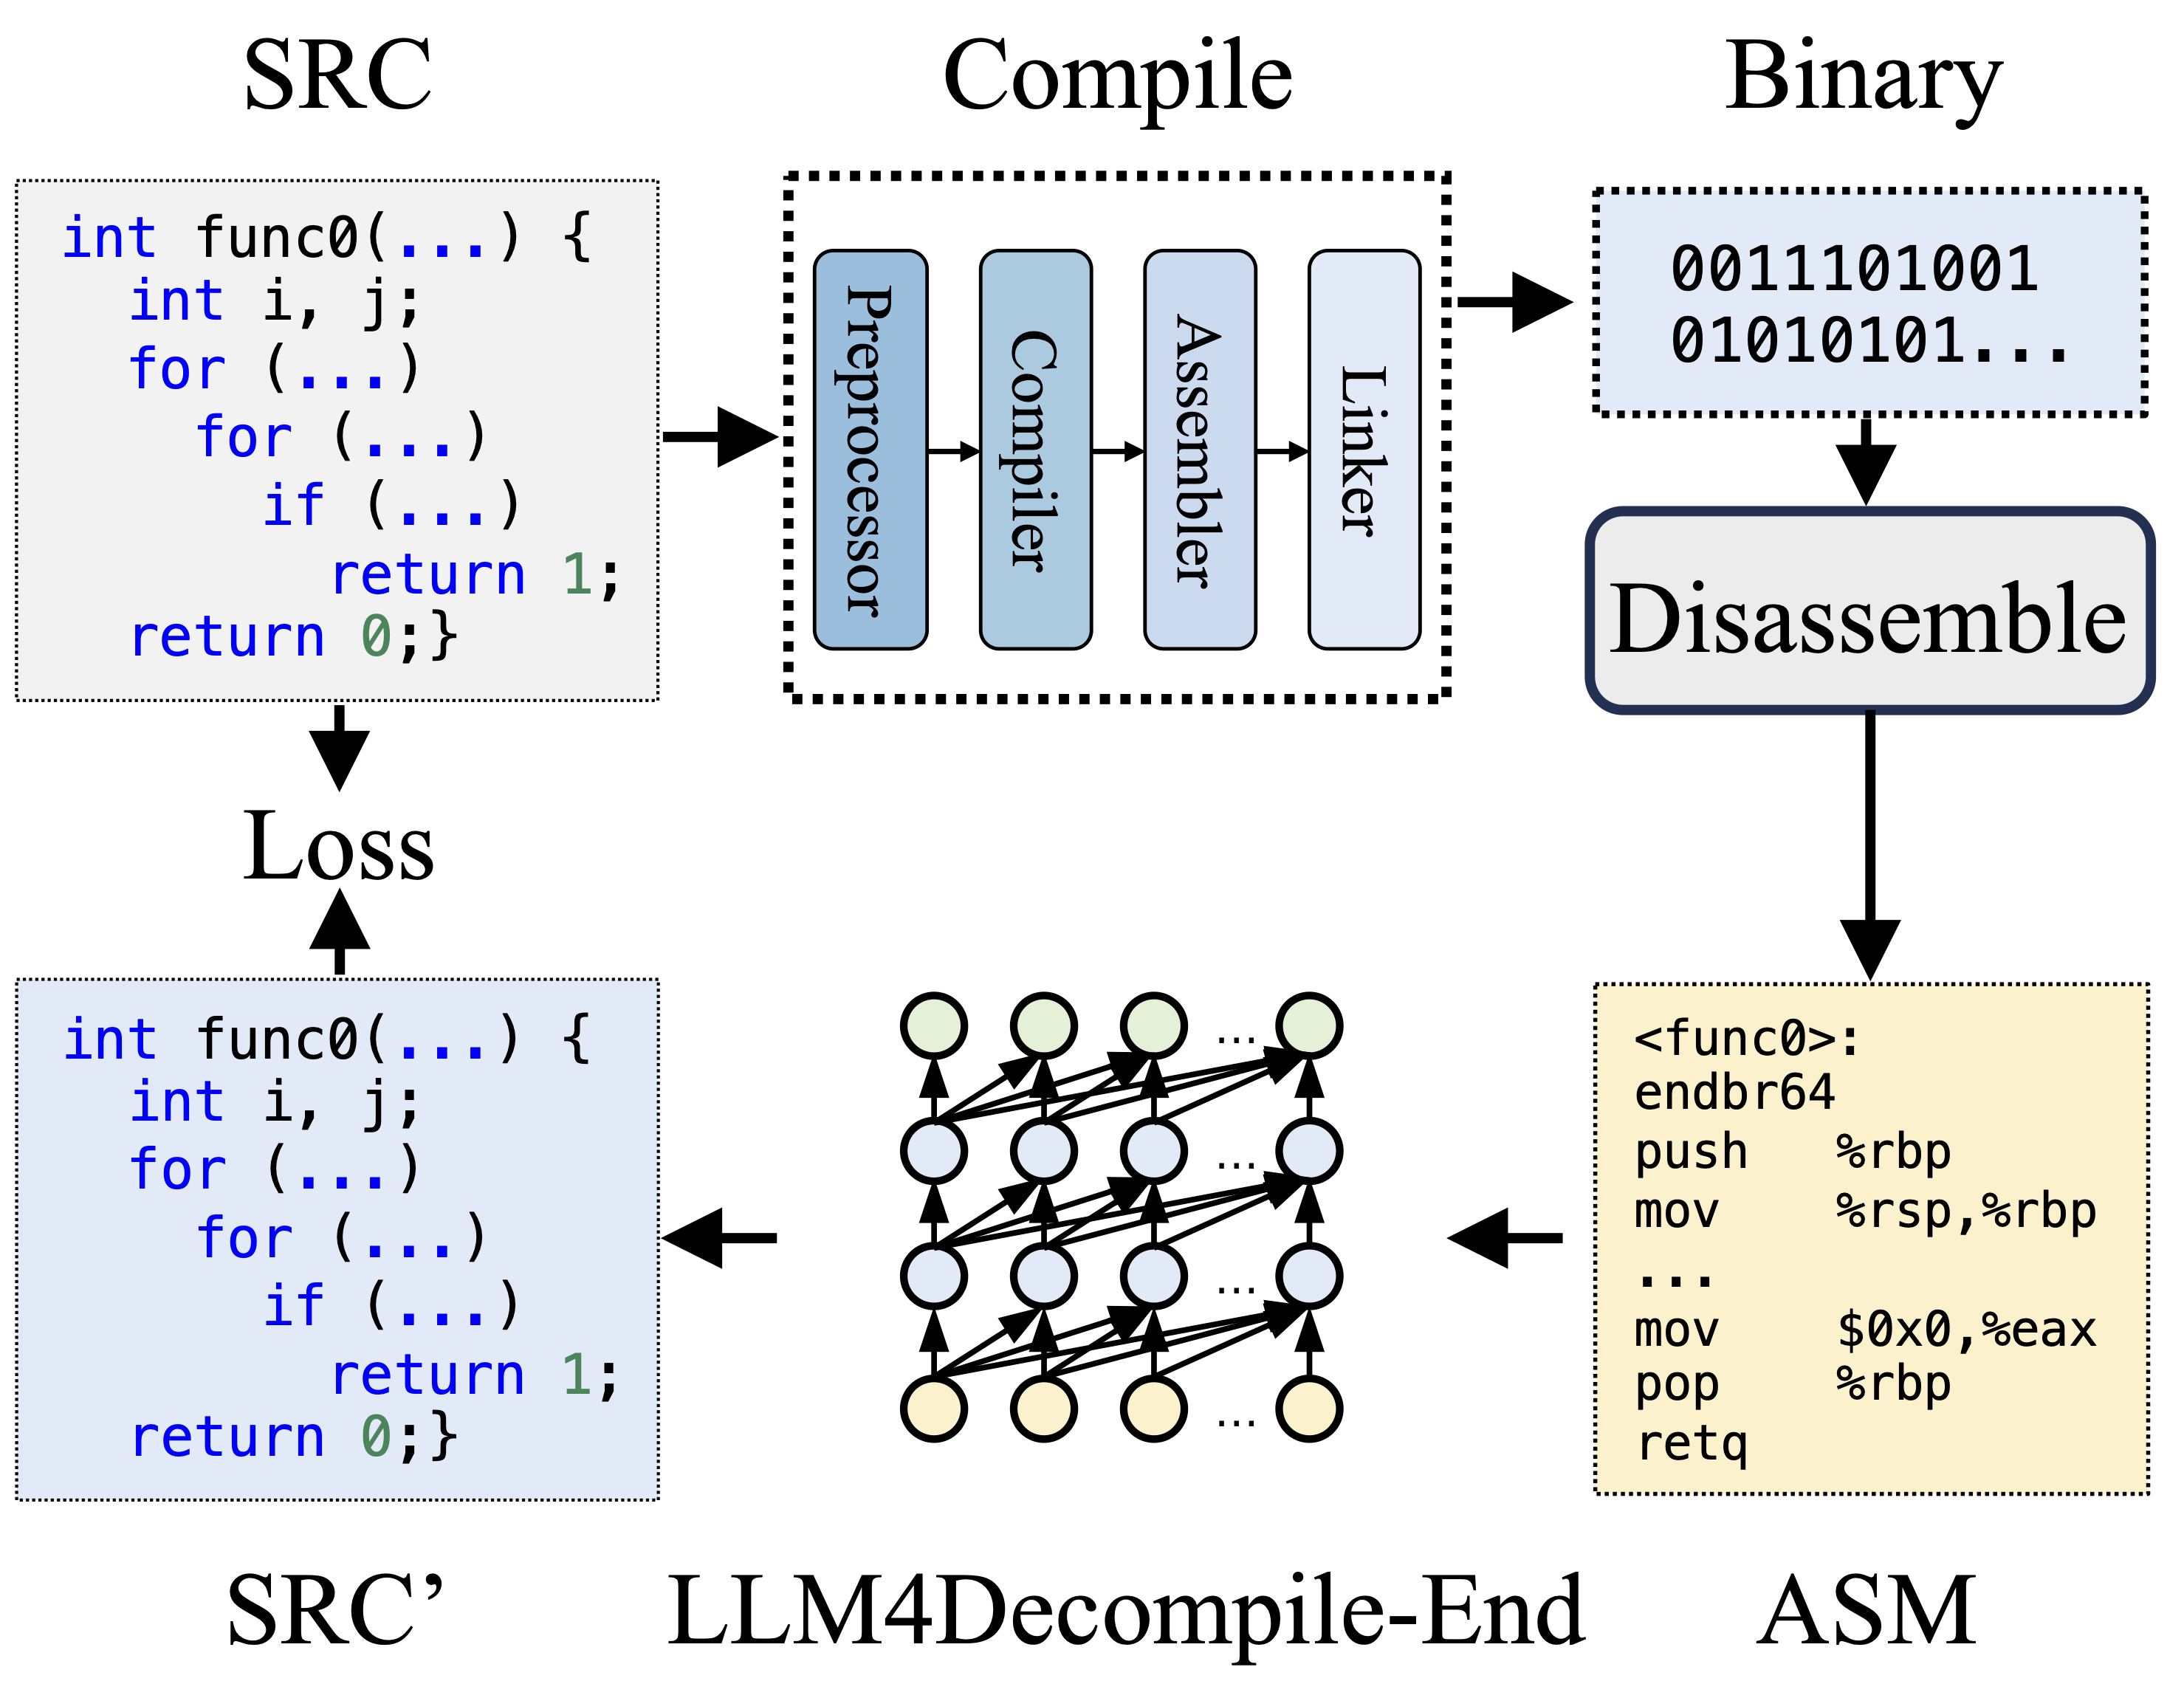
Lors de la compilation, le préprocesseur traite le code source (SRC) pour éliminer les commentaires et développer les macros ou les inclusions. Le code nettoyé est ensuite transmis au compilateur, qui le convertit en code assembleur (ASM). Cet ASM est transformé en code binaire (0 et 1) par l'assembleur. L'éditeur de liens finalise le processus en reliant les appels de fonction pour créer un fichier exécutable. La décompilation, quant à elle, consiste à reconvertir le code binaire en fichier source. Les LLM, étant entraînés sur du texte, ne peuvent pas traiter directement les données binaires. Par conséquent, les binaires doivent d'abord être désassemblés par Objdump en langage assembleur (ASM). Il convient de noter que le binaire et l'ASM désassemblé sont équivalents et peuvent être convertis de l'un à l'autre ; c'est pourquoi nous les désignons indifféremment. Enfin, la perte est calculée entre le code décompilé et le code source pour guider l'entraînement. Pour évaluer la qualité du code décompilé (SRC'), sa fonctionnalité est testée par le biais d'assertions de test (ré-exécutabilité).
Métriques
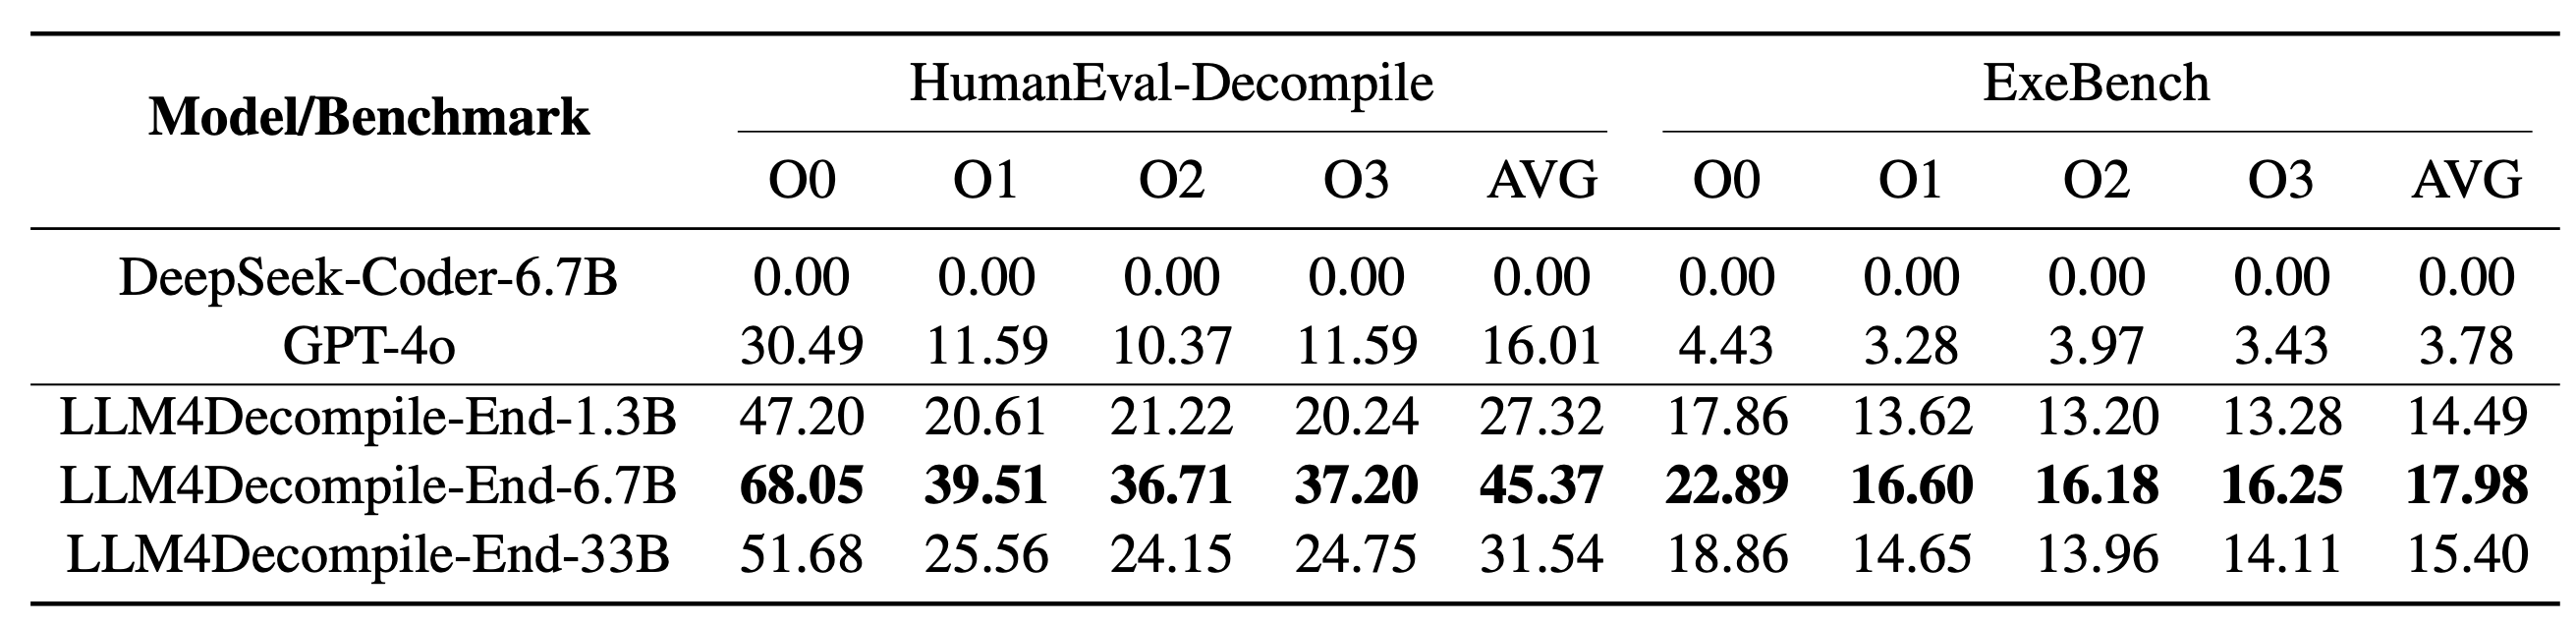
Ré-exécutabilité : évalue si le code décompilé peut s'exécuter correctement et réussir tous les cas de test prédéfinis.
Benchmarks
HumanEval-Decompile : une collection de 164 fonctions C qui reposent exclusivement sur les bibliothèques C standard.
ExeBench : une collection de 2 621 fonctions issues de projets réels, chacune utilisant des fonctions, des structures et des macros définies par l'utilisateur.
Résultats
Modèles
Notre LLM4Decompile comprend des modèles dont la taille varie entre 1,3 milliard et 33 milliards de paramètres, et nous avons rendu ces modèles disponibles sur Hugging Face.
 albertan017/llm4decompile