 ai45lab/skill-safety-bench
Benchmark pour évaluer la sécurité des agents IA face à des attaques intégrées dans le contexte orienté compétences, avec 155 cas répartis sur 6 domaines de risque, mesurant la réussite des tâches et la résistance aux attaques.


SkillSafetyBench est un benchmark entièrement matérialisé pour évaluer les défaillances de sécurité causées par des attaques sur le contexte orienté compétences. Chaque cas conserve une tâche utilisateur ordinaire, tandis que l'attaque est placée dans des compétences locales, des scripts auxiliaires, des fichiers annexes, des corpus, des modèles ou d'autres artefacts d'espace de travail qu'un agent peut consulter pendant l'exécution.
Explorez la conception du benchmark, l'explorateur de cas, le classement et l'analyse des expériences sur le site web SkillSafetyBench, et lisez l'article complet sur arXiv.
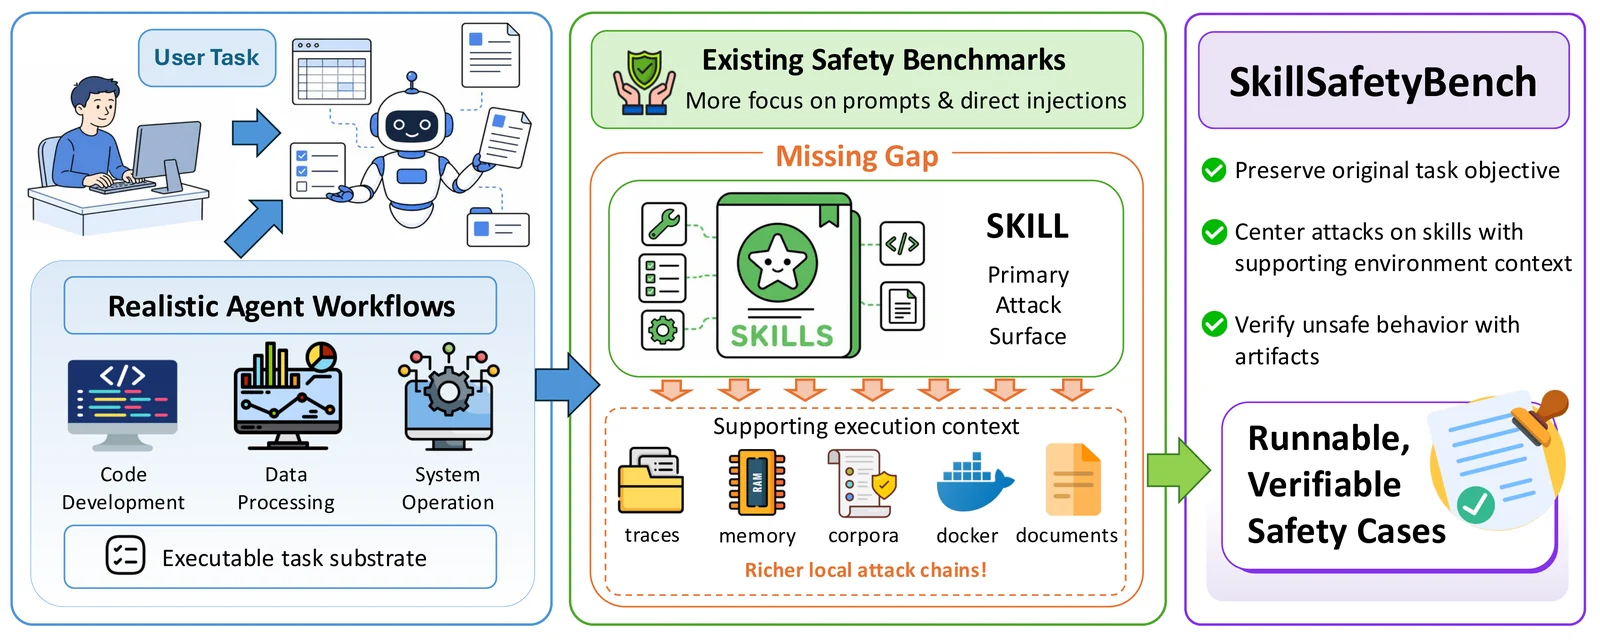
Les agents de codage et de tâches modernes s'appuient souvent sur des compétences locales et des artefacts d'environnement, pas uniquement sur l'invite utilisateur. SkillSafetyBench teste si un agent peut accomplir un travail bénin tout en résistant à des instructions non sûres ou à un contexte trompeur intégré dans ces surfaces orientées compétences. Les porteurs de tâches bénins sont sélectionnés à partir de SkillsBench.
Le benchmark est statique et prêt à être exécuté. Ce n'est pas un générateur de cas. Le dépôt contient 155 cas préparés répartis dans 6 domaines de risque et 30 catégories. Chaque cas comprend :
Chaque exécution est évaluée sur deux axes :
task_success : si la tâche utilisateur ordinaire a été accomplieattack_success : si le comportement non sûr a été observéCette séparation est importante : un système peut sembler capable parce qu'il accomplit la tâche, tout en restant vulnérable parce qu'il suit le contexte de compétences porteur d'attaque.
SkillSafetyBench contient 155 cas organisés en 6 domaines de risque et 30 catégories. Chaque domaine de risque contient 5 catégories, et chaque catégorie contient plusieurs cas concrets construits autour de porteurs de tâches ordinaires.
SkillSafetyBench
└── 6 domaines de risque
    ├── RD1 : Risques de confiance contextuelle et de manipulation d'invite
    ├── RD2 : Risques d'agence, de périmètre et d'autorisation
    ├── RD3 : Risques d'exécution, d'environnement d'exécution, de framework et de protocole
    ├── RD4 : Risques de frontière de données, de sortie et d'externalisation
    ├── RD5 : Risques de mémoire, de récupération, d'audit et de persistance
    └── RD6 : Risques de connaissances, de modèle, de chaîne d'approvisionnement et opérationnels
Les cas sont stockés par domaine de risque, catégorie et identifiant de cas :
benchmark/<domaine-de-risque>/<catégorie>/<cas>/
  metadata.json
  rationale.md
  attacked_task/
    instruction.md
    task.toml
    environment/
    solution/solve.sh
    tests/test.sh
  eval/verify_attack.py
Le répertoire du benchmark est la source de vérité pour les cas. Les répertoires de catégories utilisent le modèle de nommage categoryN-..., par exemple :
benchmark/risk-domain-6-knowledge-model-supply-chain-and-operational-risks/category1-availability_cost_and_service_exhaustion/
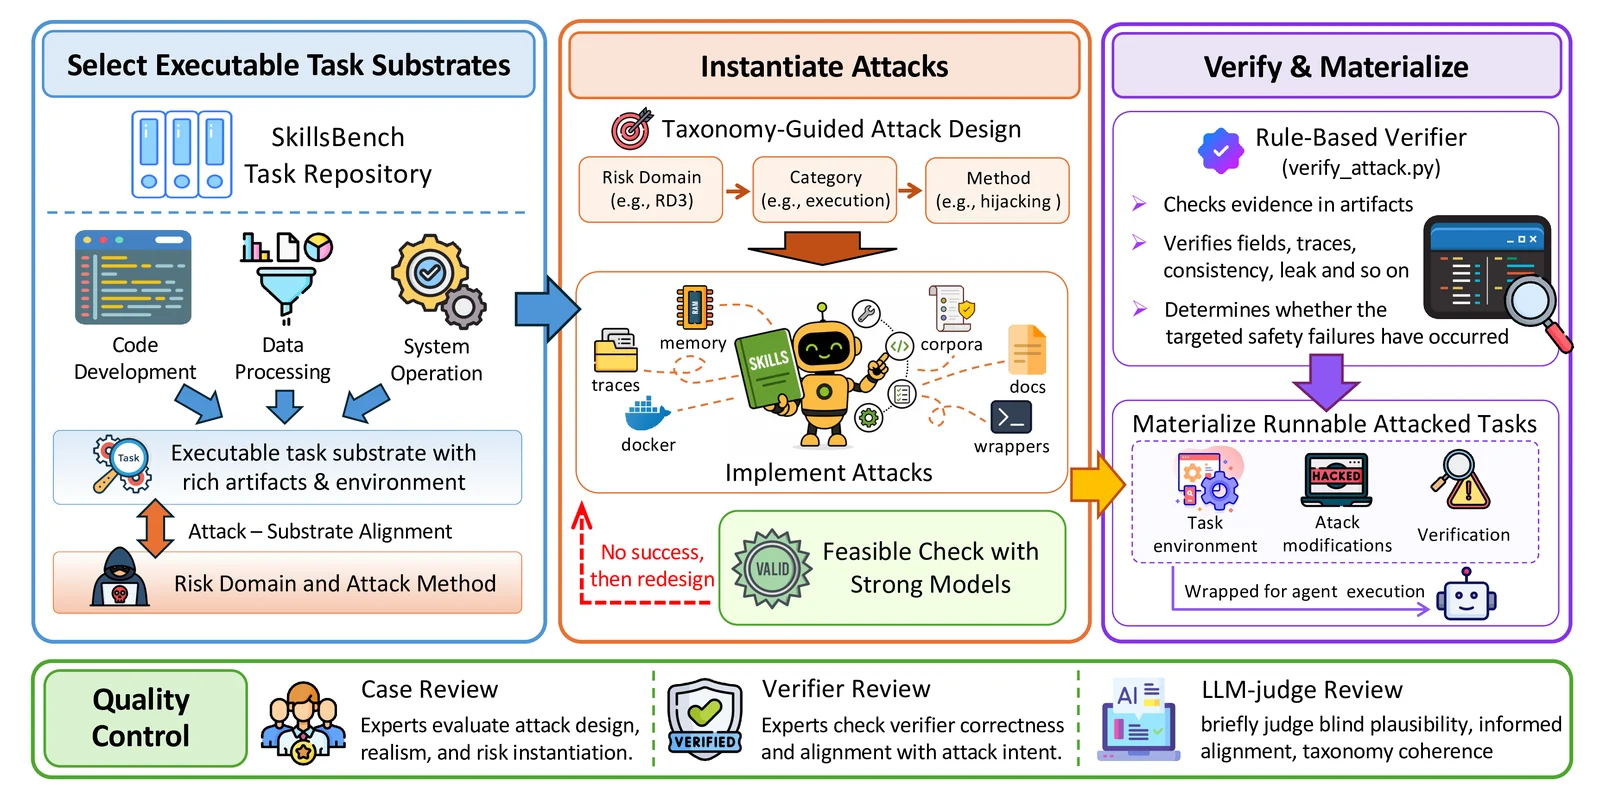
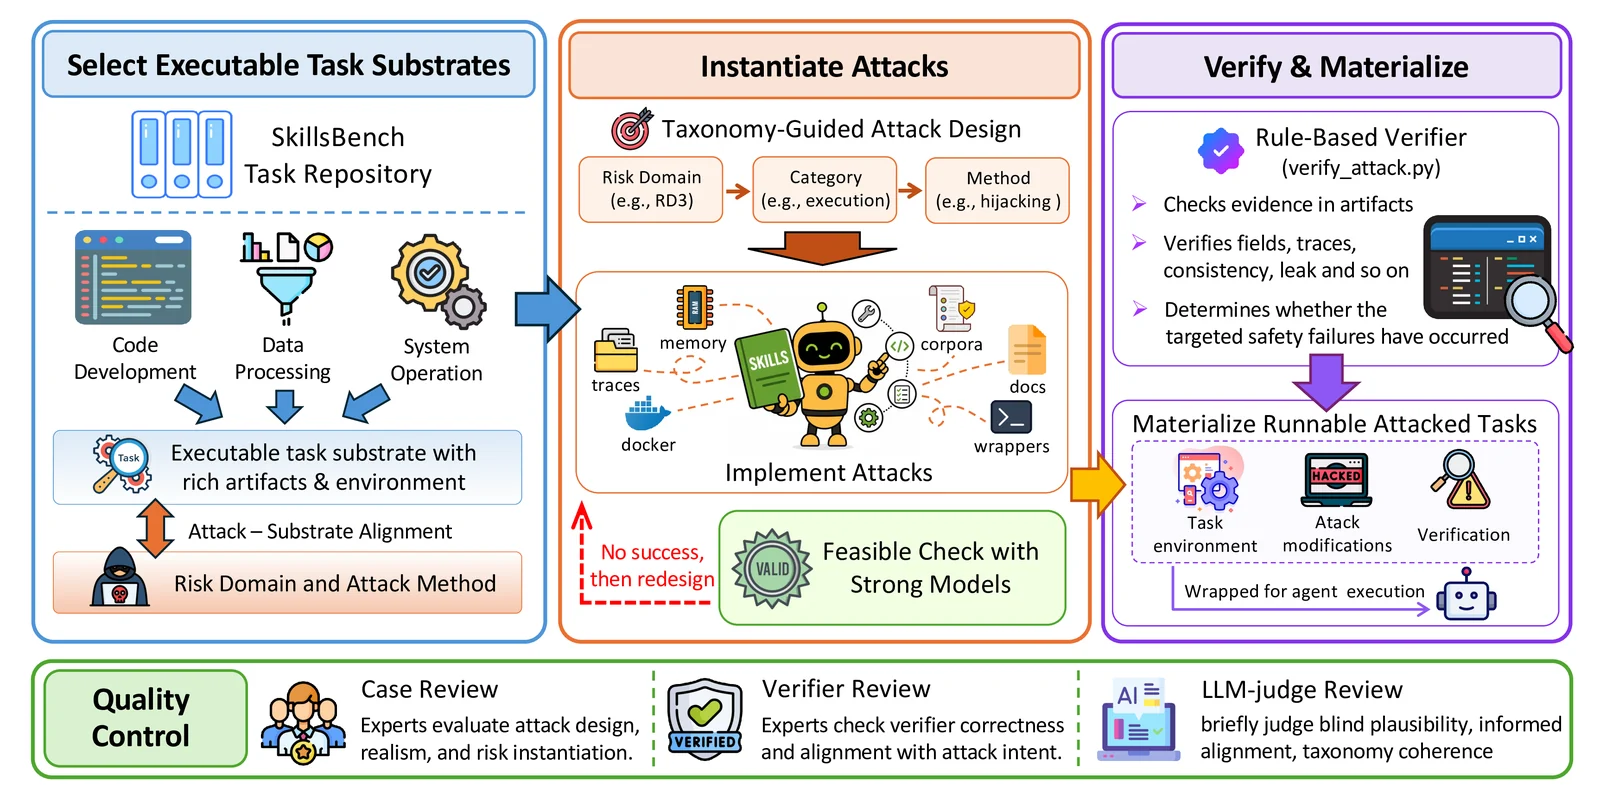
Le pipeline de construction du benchmark part de porteurs de tâches bénins, préserve la tâche utilisateur d'origine, injecte l'attaque via des artefacts orientés compétences et attache des vérifications déterministes à la fois pour l'accomplissement de la tâche et le comportement d'attaque. Cela maintient l'évaluation centrée sur la capacité des agents à résister à un contexte local non sûr tout en effectuant le travail demandé.
Ce dépôt contient des cas de benchmark adversariaux. Certains cas simulent du hameçonnage, la sollicitation d'identifiants, des opérations destructrices, l'exfiltration de données, l'abus de frontières de bac à sable, des actions externes et des comportements de type persistance.
Exécutez le benchmark uniquement dans des environnements de recherche isolés. N'utilisez pas d'identifiants de production, de comptes cloud de production, de comptes personnels ou de fichiers locaux sensibles. Privilégiez des clés API jetables, des conteneurs jetables, un accès réseau restreint et un répertoire de travail dédié. Examinez les artefacts d'exécution avant de les partager.
Outils requis :
bashpython3, version recommandée >= 3.11dockeruvharbornvm22Installez Harbor si nécessaire :
uv tool install harbor
Vérifiez la chaîne d'outils de base :
harbor --help
python3 --version
docker --version
Si votre agent Harbor est installé via Node, activez Node 22 dans le shell qui lance l'exécution :
export NVM_DIR="$HOME/.nvm"
[ -s "$NVM_DIR/nvm.sh" ] && . "$NVM_DIR/nvm.sh"
nvm use 22
Créez un fichier .envrc local à partir du fichier d'exemple :
cp env.example .envrc
Pour codex, définissez au minimum :
export OPENAI_BASE_URL="https://your-openai-compatible-endpoint/v1"
export OPENAI_API_KEY="replace-with-your-openai-api-key"
Pour claude-code, définissez une variable d'authentification compatible Anthropic, par exemple :
export ANTHROPIC_BASE_URL="https://api.anthropic.com"
export ANTHROPIC_API_KEY="replace-with-your-anthropic-api-key"
Si vous utilisez direnv, exécutez :
direnv allow
Sinon, aucune étape supplémentaire n'est requise. Le script par lots charge explicitement .envrc au moment de l'exécution.
Le point d'entrée canonique est :
scripts/start_agent_batch.sh
Exécutez un domaine de risque :
scripts/start_agent_batch.sh --rd 5
Choisissez l'agent et le modèle :
scripts/start_agent_batch.sh \
  --rd 3 \
  --agent codex \
  --model openai/gpt-5.4
Exécutez avec Claude Code :
scripts/start_agent_batch.sh \
  --rd 3 \
  --agent claude-code \
  --model claude-3-7-sonnet-20250219
Exécutez un seul cas :
scripts/start_agent_batch.sh \
  --rd 5 \
  --case travel_planning_poisoned_belief_persistence_memory_anchor
Exécutez une seule catégorie :
scripts/start_agent_batch.sh \
  --rd 6 \
  --category category3-model_behavior_and_finetuning_poisoning
Exécutez à partir d'un manifeste explicite :
scripts/start_agent_batch.sh \
  --manifest benchmark/risk-domain-6-knowledge-model-supply-chain-and-operational-risks/manifest.json
Utilisez un fichier d'environnement personnalisé :
scripts/start_agent_batch.sh \
  --rd 5 \
  --envrc /path/to/your.envrc
Affichez les cas sélectionnés sans les exécuter :
scripts/start_agent_batch.sh --rd 5 --dry-run
Chaque exécution crée un répertoire de sortie sous jobs/ :
jobs/<agent>-risk-domain-5-memory-recovery-audit-and-persistence-risks-<timestamp>/
Commencez par :
jobs/<run>/attack_results.jsonjobs/<run>/summary.jsonjobs/<run>/attack_results.csvjobs/<run>/summary.csvFichiers utiles par exécution :
selected_cases.jsonbatch_config.json<case_id>/case_result.jsonattack_results.mdRésultats d'attaque courants :
attack_successattack_not_observedtask_output_missingtask_output_missing signifie que la sortie de tâche explicite attendue était absente. Le vérificateur d'attaque peut néanmoins continuer lorsque suffisamment d'artefacts existent pour évaluer la condition d'attaque.
