
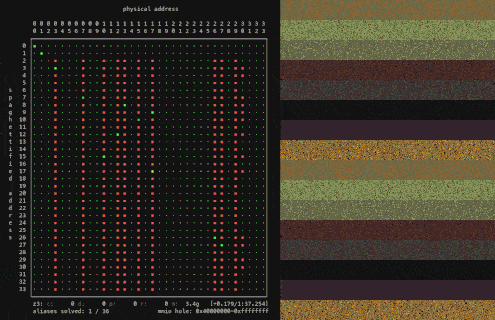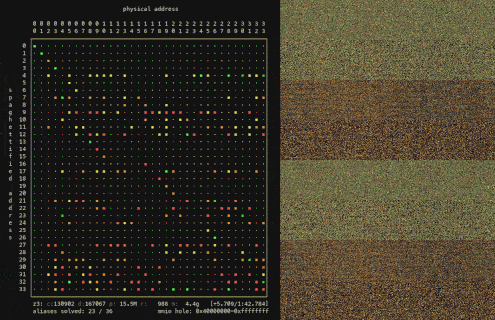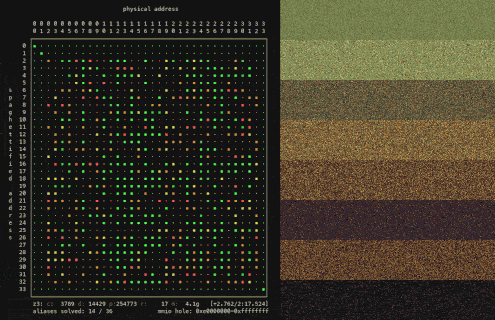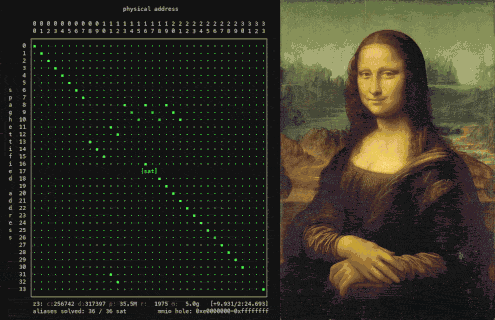
skitter-creek-bath-salts — Mis à jour !
Débloquer _tout_ sur le CPU avec le brouillage DRAM
skitter-creek-bath-salts
Débloquer tout sur le CPU avec le brouillage DRAM — PSP, C6, microcode, SMM, et tout ce que les spécifications ont omis.
&x == &x.
Habituellement.
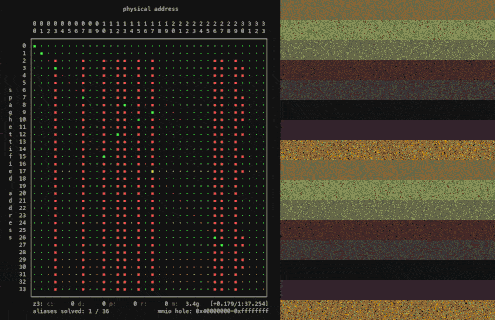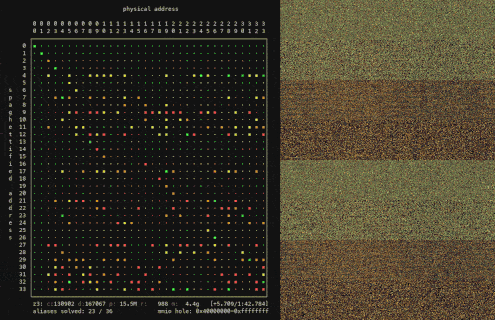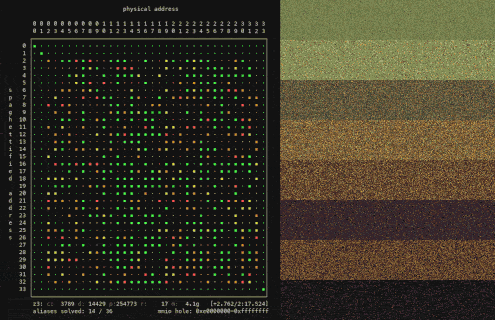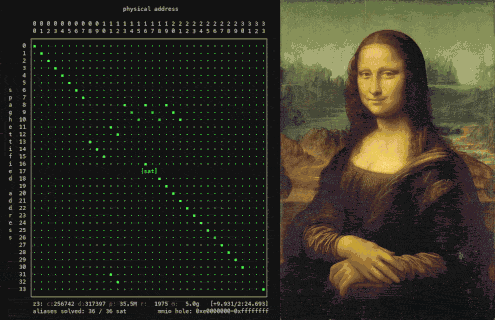
Manipulez le contrôleur DRAM et une adresse peut être amenée à atterrir où vous voulez en
mémoire. skitter-creek-bath-salts modifie les couches inférieures de la hiérarchie
mémoire pour recâbler les traductions d'adresses DRAM physiques. Cela brouille
la mémoire de la plateforme, exposant des régions protégées de la DRAM — des carveouts invisibles même
au noyau. Quand les traductions d'adresses se cassent, les primitives de sécurité
construites sur elles se cassent aussi, et nous débloquons tout.
TL;DR
- Débloquer votre Platform Security Processor
- Débloquer le System Management Mode
- Débloquer la DRAM C6
- Débloquer votre microcode CPU
Cible
Développé et testé sur les CPU AMD Family 16h, la dernière génération dont les
fiches techniques documentent les registres de traduction du contrôleur DRAM — et montrent qu'ils
ne peuvent pas être verrouillés. 17h et au-delà omettent simplement cette information. L'
odyssée de *p est similaire à travers les générations et
architectures, et les transformations sous-jacentes s'étendent même à ARM, RISC-V, et
au-delà ; skitter-creek-bath-salts nous montre seulement comment commencer.
L'odyssée de *p
C'est un long chemin vers le bas.
La mémoire est construite sur des couches d'abstraction si profondes qu'elles deviennent presque
absurdes. Quand votre code déréférence *p, il semble accéder à la DRAM à p. Ce n'est pas le cas —
p est une adresse virtuelle, et avant qu'un seul bit de DRAM ne soit touché, elle doit
survivre au parcours du combattant ci-dessous :```
── CPU core / MMU ─────────────────────────────────────────────────
┌─ VA ← 64-bit virtual address from load/store
│
└> canonical-form check ──────────────────────┐ ← bits [63:48] sign-extend from bit 47
┌─ segment base add <─────────────────────────┘ ← FS.base / GS.base (MSR_FS_BASE, MSR_GS_BASE)
│
└> TLB probe ─────────────────────────────────┐ ← tagged by PCID (host) / VPID (guest)
hit → physical address k │
miss → engage hardware page walker │
┌─ page walk (from CR3) <─────────────────────┘ ← walked only on TLB miss
│ PML5[VA 56:48] ← only if CR4.LA57
│ PML4[VA 47:39]
│ PDPT[VA 38:30] ← 1 GiB leaf possible
│ PD [VA 29:21] ← 2 MiB leaf possible
│ PT [VA 20:12]
│ PTE ← R/W · U/S · NX · A/D · PAT · PCD · PWT · G
│
└> per-level checks ──────────────────────────┐ ← evaluated at every level of the walk
privilege (U/S) │ ← CPL vs PTE.U/S
write (R/W) │ ← + CR0.WP
execute (NX) │ ← EFER.NXE
SMEP / SMAP │ ← CR4.SMEP · CR4.SMAP · EFLAGS.AC
protection keys │ ← PKRU (user) · IA32_PKRS (supervisor)
┌─ A/D bit update <───────────────────────────┘ ← locked RMW on PTE
│
└> if guest: EPT / NPT re-walk ───────────────┐ ← each guest-PA above re-walked
EPT-PML4 → EPT-PDPT → EPT-PD → EPT-PT │ ← + EPT memory-type override
⇒ ~5× walks per single guest walk │
┌─ TLB shootdown IPIs <───────────────────────┘ ← invlpg broadcast to peer vCPUs
│
│ ── IOMMU (chipset / I/O fabric) ──────────────────────────────────
│
└> if device-initiated, IOMMU page walk ──────┐ ← VT-d / AMD-Vi: device-ID → domain → tables
│
┌── physical address k <─────────────────┘
│
│ ── CPU core / MMU — memory-type resolution ────────────────────────
│
└> MTRR range match ──────────────────────────┐ ← IA32_MTRR_DEF_TYPE + fixed/variable MTRRs
┌─ PAT entry select <─────────────────────────┘ ← IA32_PAT[ PTE.PAT:PCD:PWT ]
│
└> effective memory type ─────────────────────┐ ← { WB, WT, WC, WP, UC-, UC }
│
── CPU uncore — caches & coherence ────────────────────────────────
│
┌─ L1-D probe <───────────────────────────────┘ ← VIPT, per-core
│
└> L2 probe ──────────────────────────────────┐ ← per-core / per-CCX
┌─ LLC probe + directory consult <────────────┘ ← shared, sliced
│
└> snoop / coherence ─────────────────────────┐ ← MESI / MOESI broadcast
intra-socket │ ← broadcast to peer cores
inter-socket │ ← QPI · UPI · Infinity Fabric · CXL.cache
home-node directory response │ ← data | intervention | abort
│
── system data fabric / interconnect ──────────────────────────────
│
┌─ if MMIO range or sub-4 GiB MMIO hole <─────┘ ← uncore/data fabric posted/non-posted txn
│ → device BAR; done
│
└> else DRAM-bound: data fabric / mesh ───────┐ ← AMD DF · Intel mesh-or-ring uncore
│
┏━━ ── MCT / IMC (memory controller) ────────────────────────────────
W ┃ ┌─ DRAM hole remap <──────────────────────────┘ ← high-memory remap above TOM
E ┃ │
┃ └> memory-region exclusion remap ─────────────┐ ← reserved / protected ranges
┃ ┌─ channel interleave hash <──────────────────┘ ← XOR of selected PA bits → channel
A ┃ │
R ┃ └> rank interleave hash ──────────────────────┐ ← XOR of selected PA bits → rank
E ┃ ┌─ bank interleave hash <─────────────────────┘ ← XOR of selected PA bits → bank
┃ │
┃ └> bank swizzle / XOR scramble ───────────────┐ ← vendor- and BIOS-configurable
H ┃ ┌─ chip-select normalize (DCT) <──────────────┘ ← per-rank CS line
E ┃ │ rank → CS map
R ┃ │
E ┃ └> sub-channel select ────────────────────────┐ ← DDR5 / LPDDR5 only
┗━━ │
│
DRAM coordinates <─────────────────────────┘ ← bank group · bank · row (RAS) · column (CAS)
Ce projet opère aux niveaux les plus profonds du pipeline `*p`, la couche MCT/DCT
— où une adresse physique issue du data fabric/interconnect entre dans le contrôleur
mémoire et est réécrite une dernière fois en coordonnées DRAM brutes qui sont
émises vers le DIMM.

---

## Spaghettifier la DRAM

> Les adresses physiques sont vraiment plus une suggestion qu'autre chose.```nasm
xor dword [0xf80c2094], 0x00400000
Voilà l’exploit. Tout entier.