
kviklet v0.9.0
Flux de révision/approbation similaire à une Pull Request pour les requêtes de base de données. Pour un accès Engineering conforme mais fluide à la production.
Kviklet
Kviklet.dev | Notes de version | Discord
Un accès sécurisé aux environnements de production sans nuire à la productivité des développeurs.
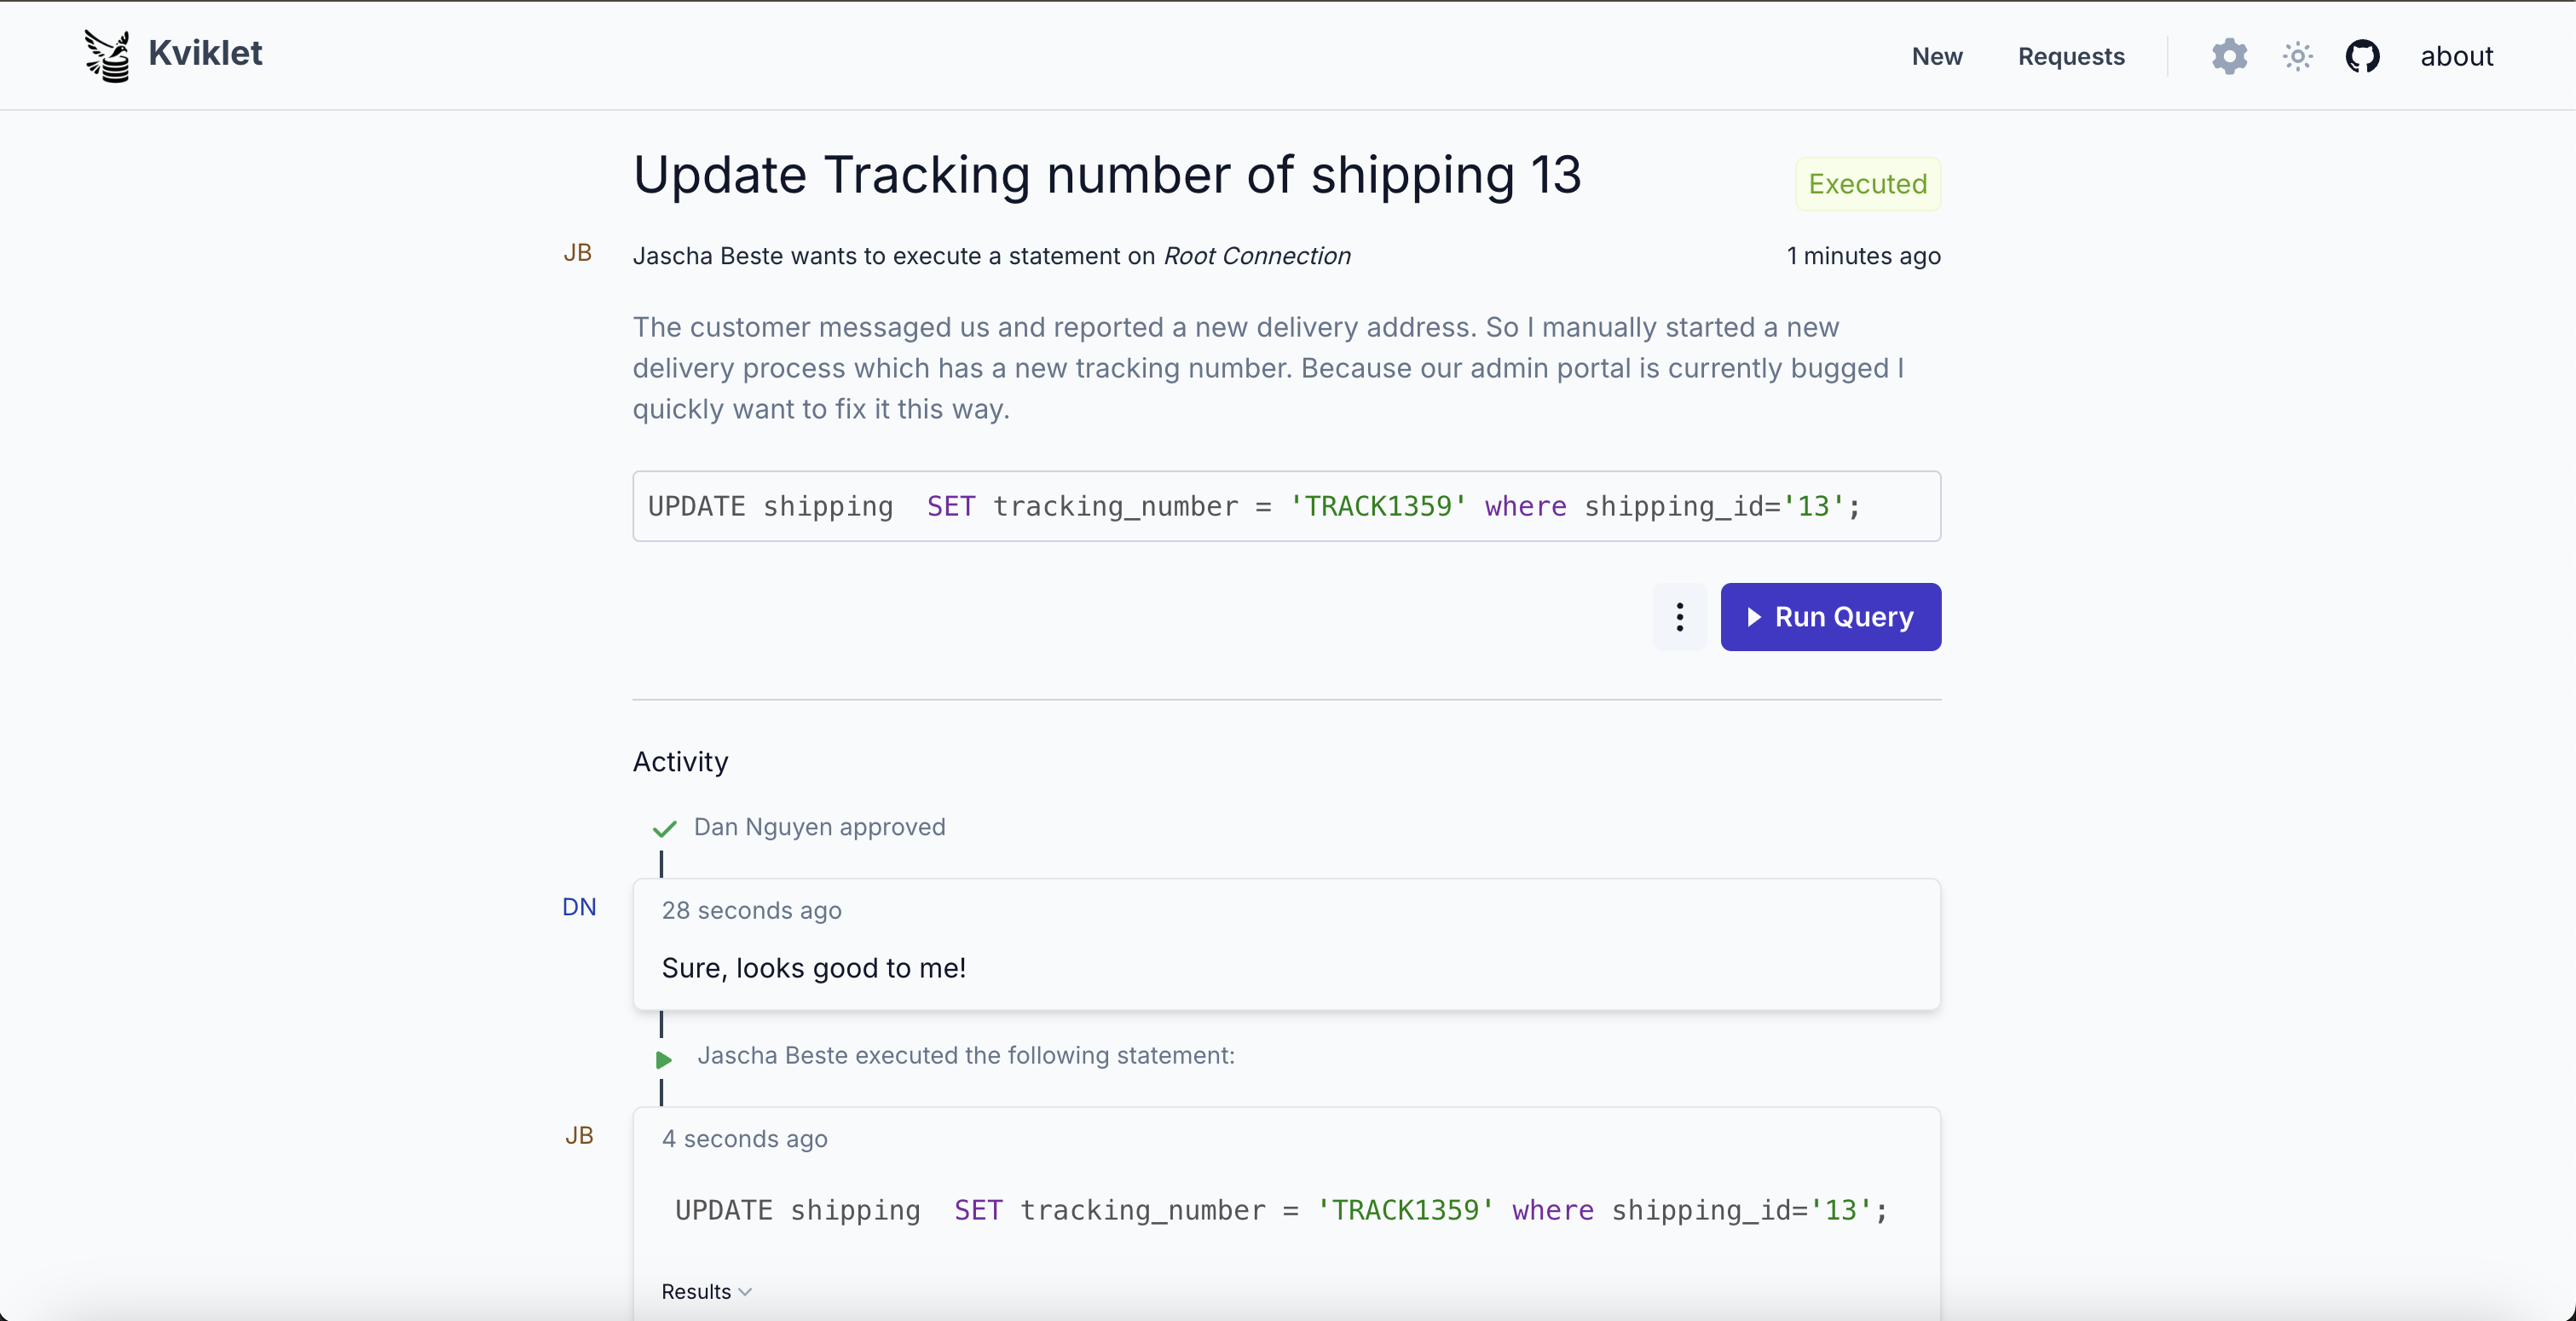
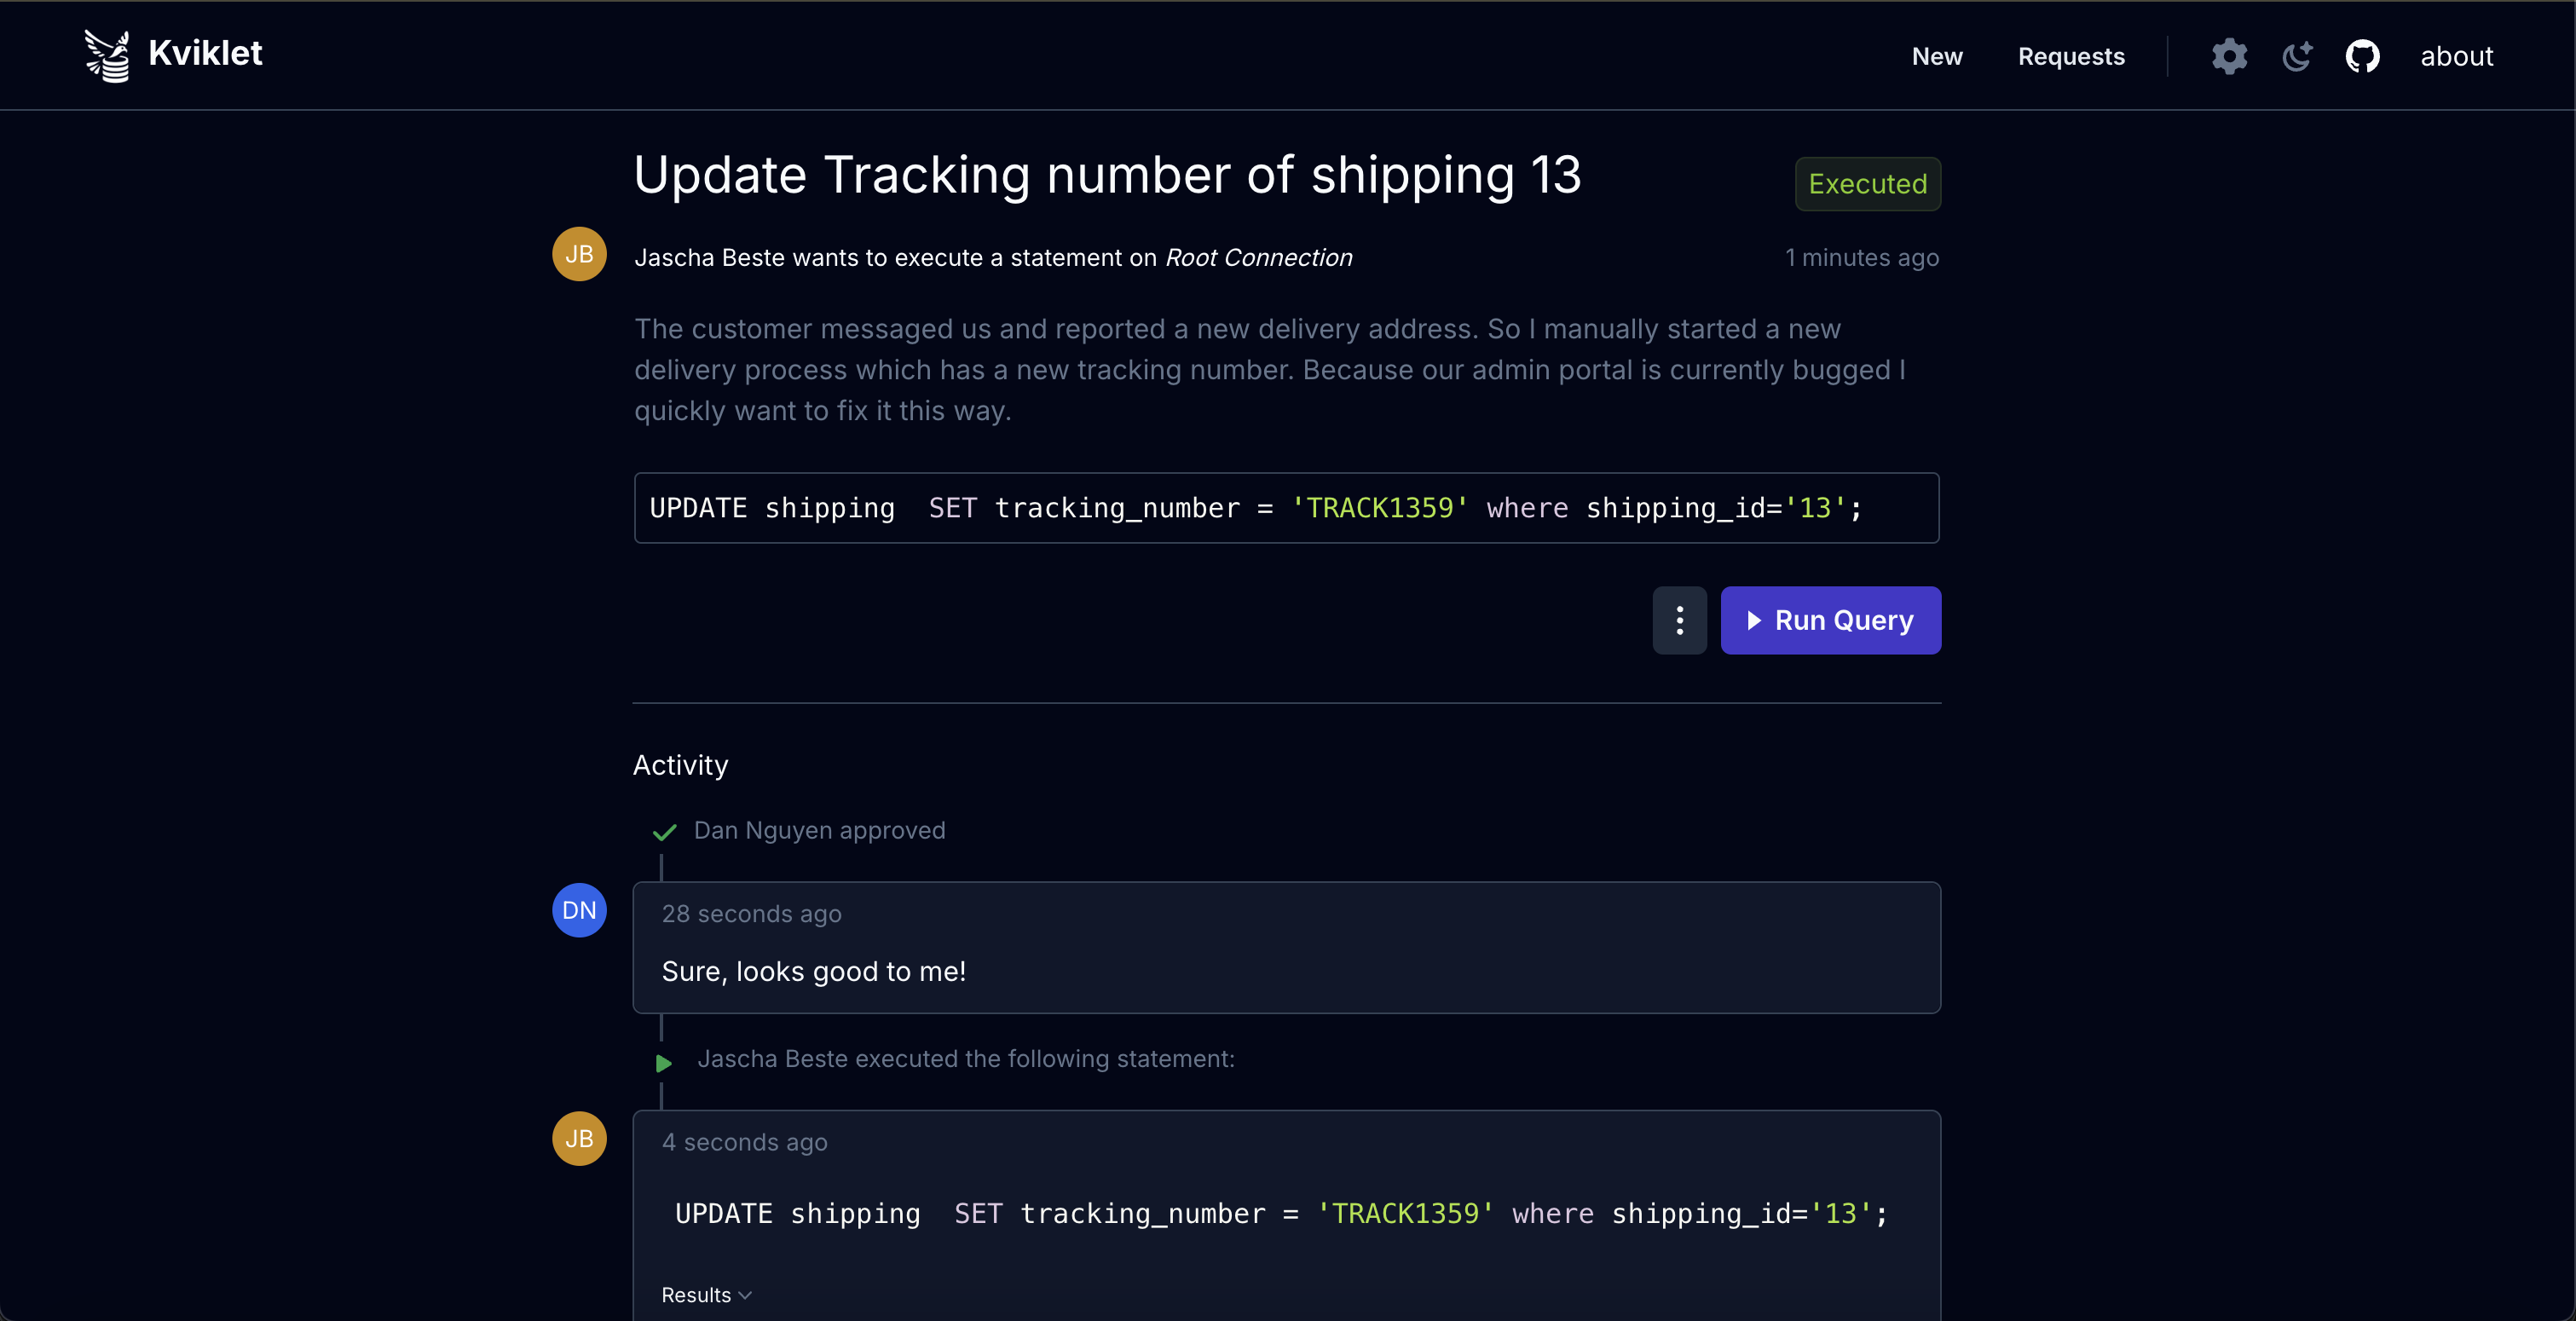
Kviklet (prononcé Quick-let) applique le principe des quatre yeux à l'accès aux bases de données de production, avec un workflow de revue et d'approbation semblable à celui d'une pull request pour des instructions SQL individuelles ou des sessions de base de données à durée limitée. Les ingénieurs peuvent examiner et approuver les demandes les uns des autres sans faire passer chaque requête par un DBA ou une équipe d'exploitation.
Kviklet est auto-hébergé et s'exécute en tant que conteneur Docker avec une base de données PostgreSQL pour l'état de l'application. Son interface web vous permet de soumettre, examiner et exécuter des demandes. Une licence entreprise optionnelle débloque l'authentification SAML, les exigences de revue basées sur les rôles, la synchronisation des rôles et les clés API. Demandez une licence entreprise sur kviklet.dev.
Les bases de données prises en charge sont Postgres, MySQL, MariaDB, MS SQL Server et MongoDB.
Modèle d'accès
Nous recommandons de connecter Kviklet à votre fournisseur d'identité existant. Kviklet prend en charge le SSO via OIDC (Google, Keycloak, etc.) ou SAML (entreprise uniquement), ainsi que l'authentification LDAP (Active Directory, etc.).
Les utilisateurs créent ensuite des demandes pour des connexions qui correspondent à un utilisateur de base de données spécifique. Ces demandes sont soit :
- Requête unique : une instruction SQL spécifique soumise pour revue.
- Accès temporaire : une session à durée limitée dans laquelle vous pouvez exécuter plusieurs instructions.
Selon la configuration, les demandes sont examinées et approuvées par d'autres utilisateurs avant que Kviklet n'autorise l'exécution.
Kviklet se connecte à la base de données au nom de l'utilisateur. Le mot de passe de la base de données de la connexion n'est jamais montré à l'utilisateur.
Un administrateur peut configurer quel rôle a accès à quelle connexion et quels contrôles de revue sont requis pour l'exécution. L'accès au niveau de la base de données est géré via les mécanismes RBAC de la base de données sous-jacente. Par exemple, il est possible de créer un rôle en lecture seule pour une connexion en lecture seule et d'assigner moins d'exigences de revue pour celle-ci que pour une connexion en écriture.
Kviklet enregistre les instructions exécutées et les associe à l'utilisateur et à la demande d'accès. Pour une couverture complète de l'accès manuel à la base de données, restreignez les connexions directes et faites passer tout accès manuel par Kviklet. Les ingénieurs n'ont pas besoin de recevoir ou de partager les identifiants de la base de données sous-jacente.
Les fonctionnalités entreprise supplémentaires incluent :
- SAML : Prise en charge de l'authentification SAML.
- Proxy (Postgres, MariaDB, MySQL) : Utilisez votre client de base de données préféré via une session d'accès temporaire approuvée avec un mot de passe temporaire. Les instructions exécutées sont enregistrées dans le journal d'audit de Kviklet.
- Contrôles de revue basés sur les rôles : Exiger des approbations de rôles spécifiques avant l'exécution.
- Synchronisation des rôles : Synchroniser automatiquement les rôles des utilisateurs à partir des groupes de votre fournisseur d'identité.
- Clés API : Accès programmatique à l'API Kviklet.
Plus de captures d'écran
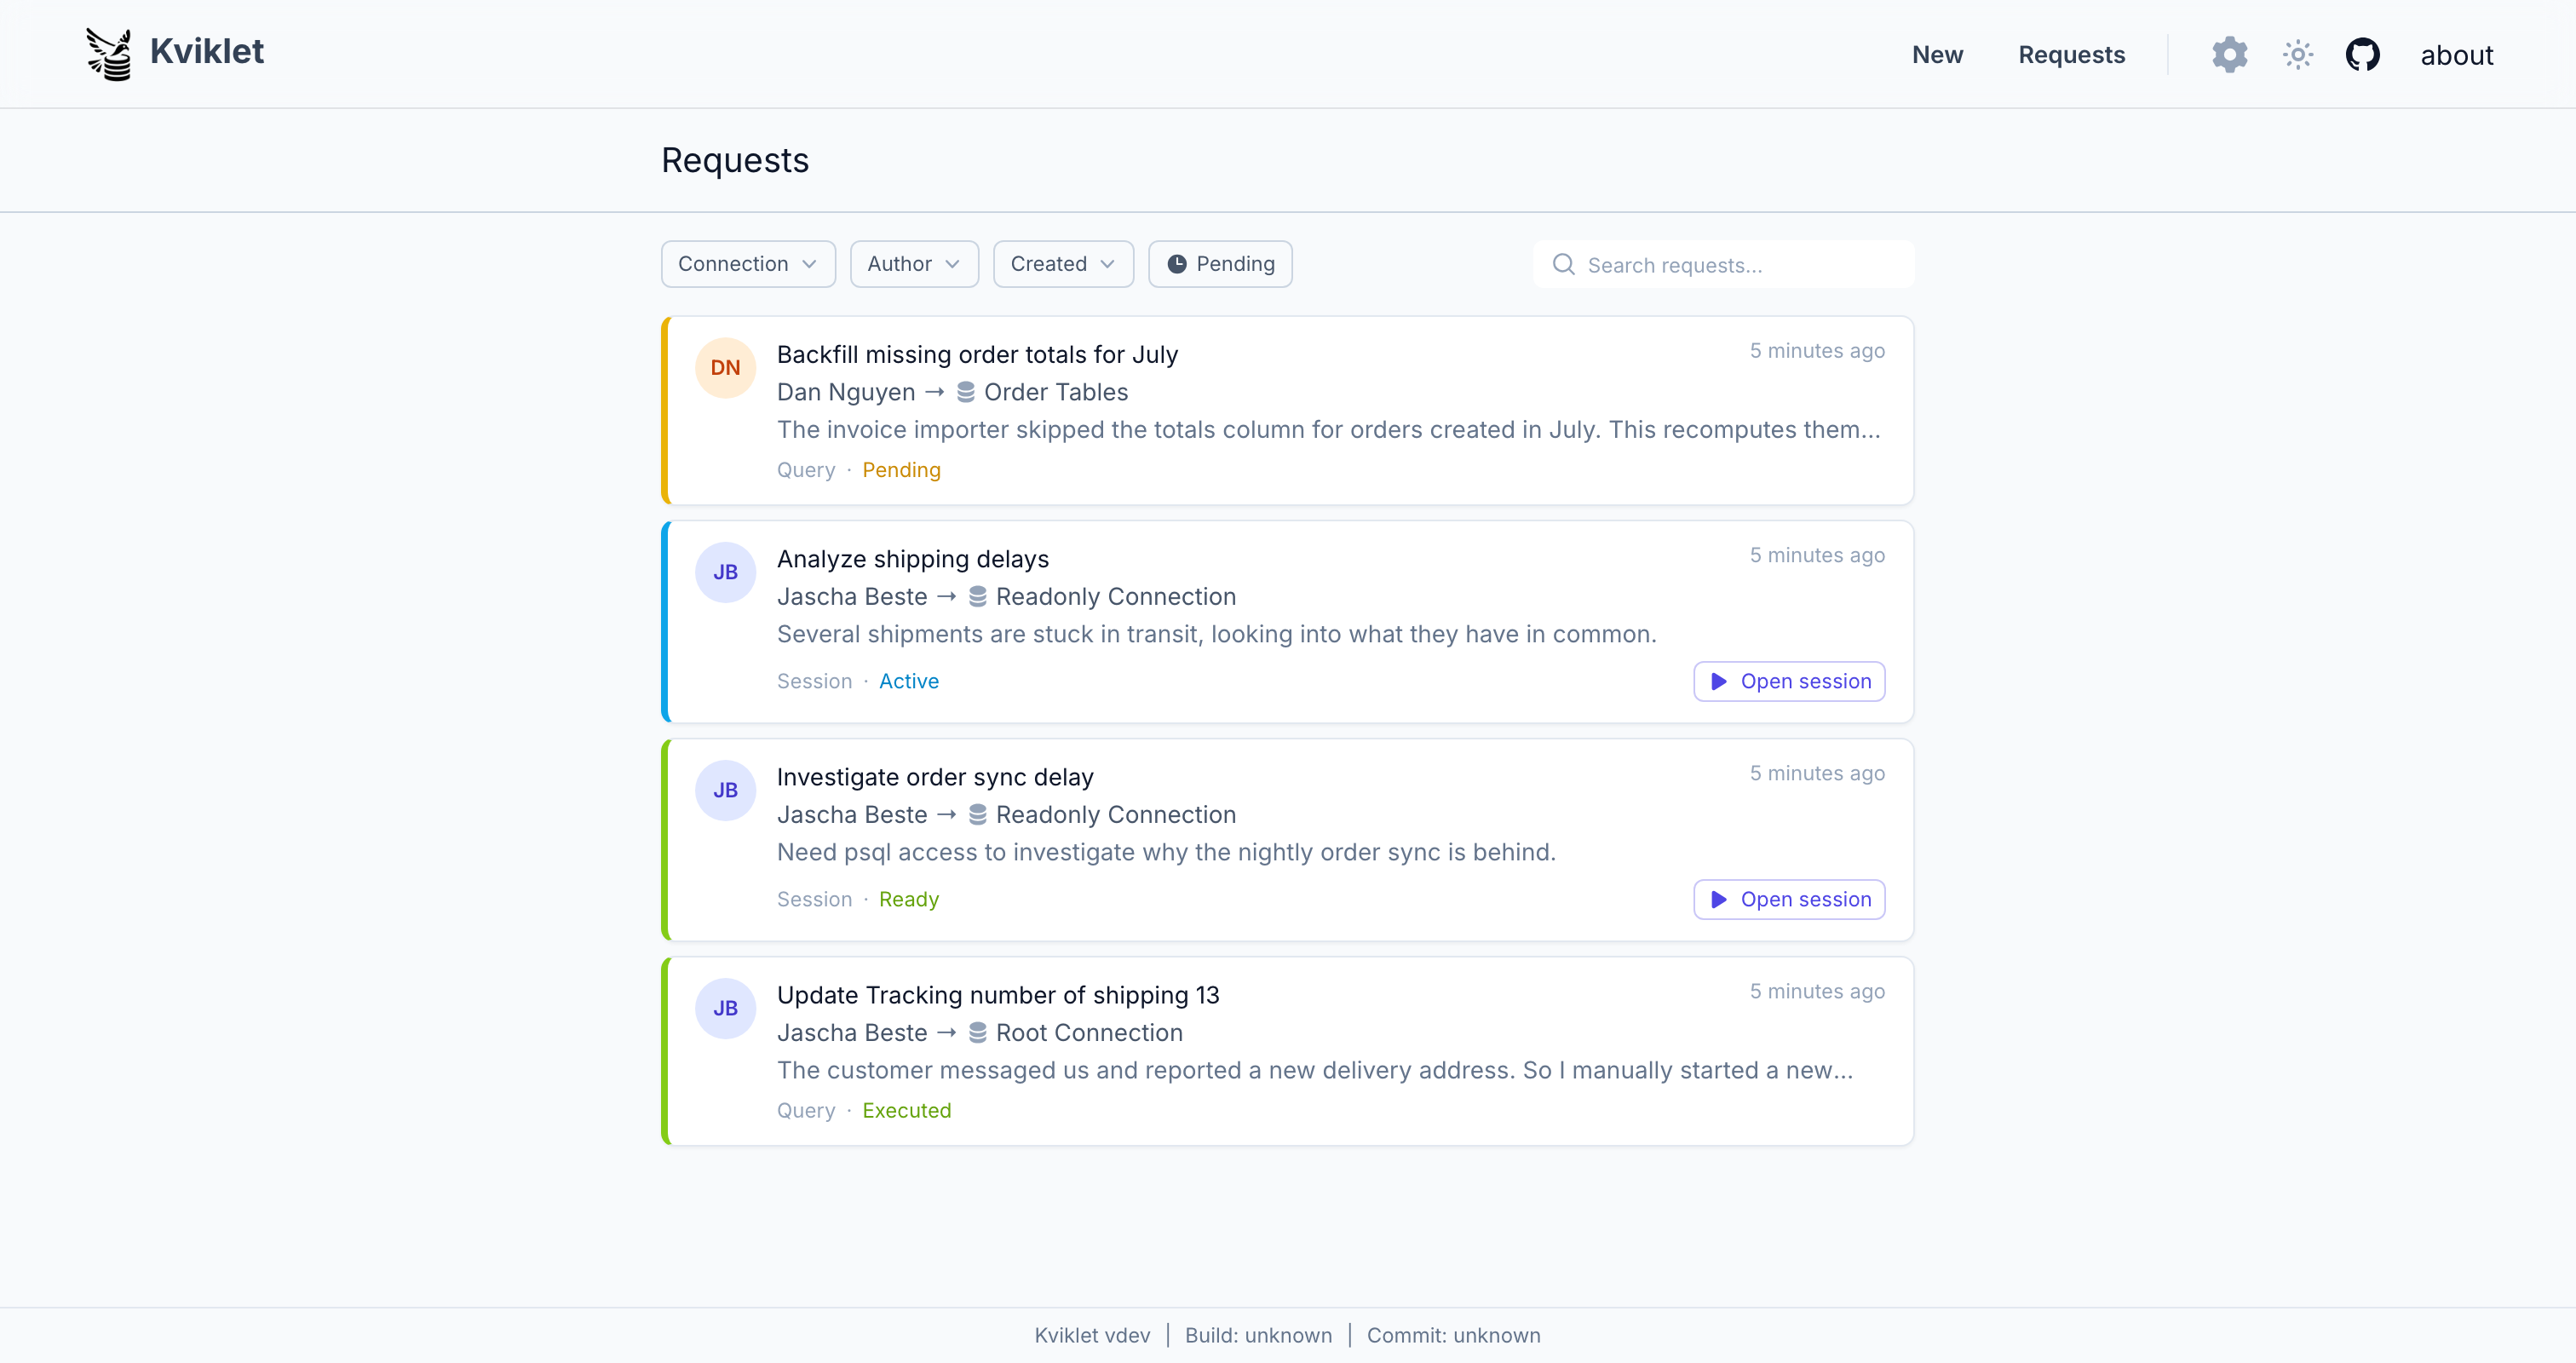
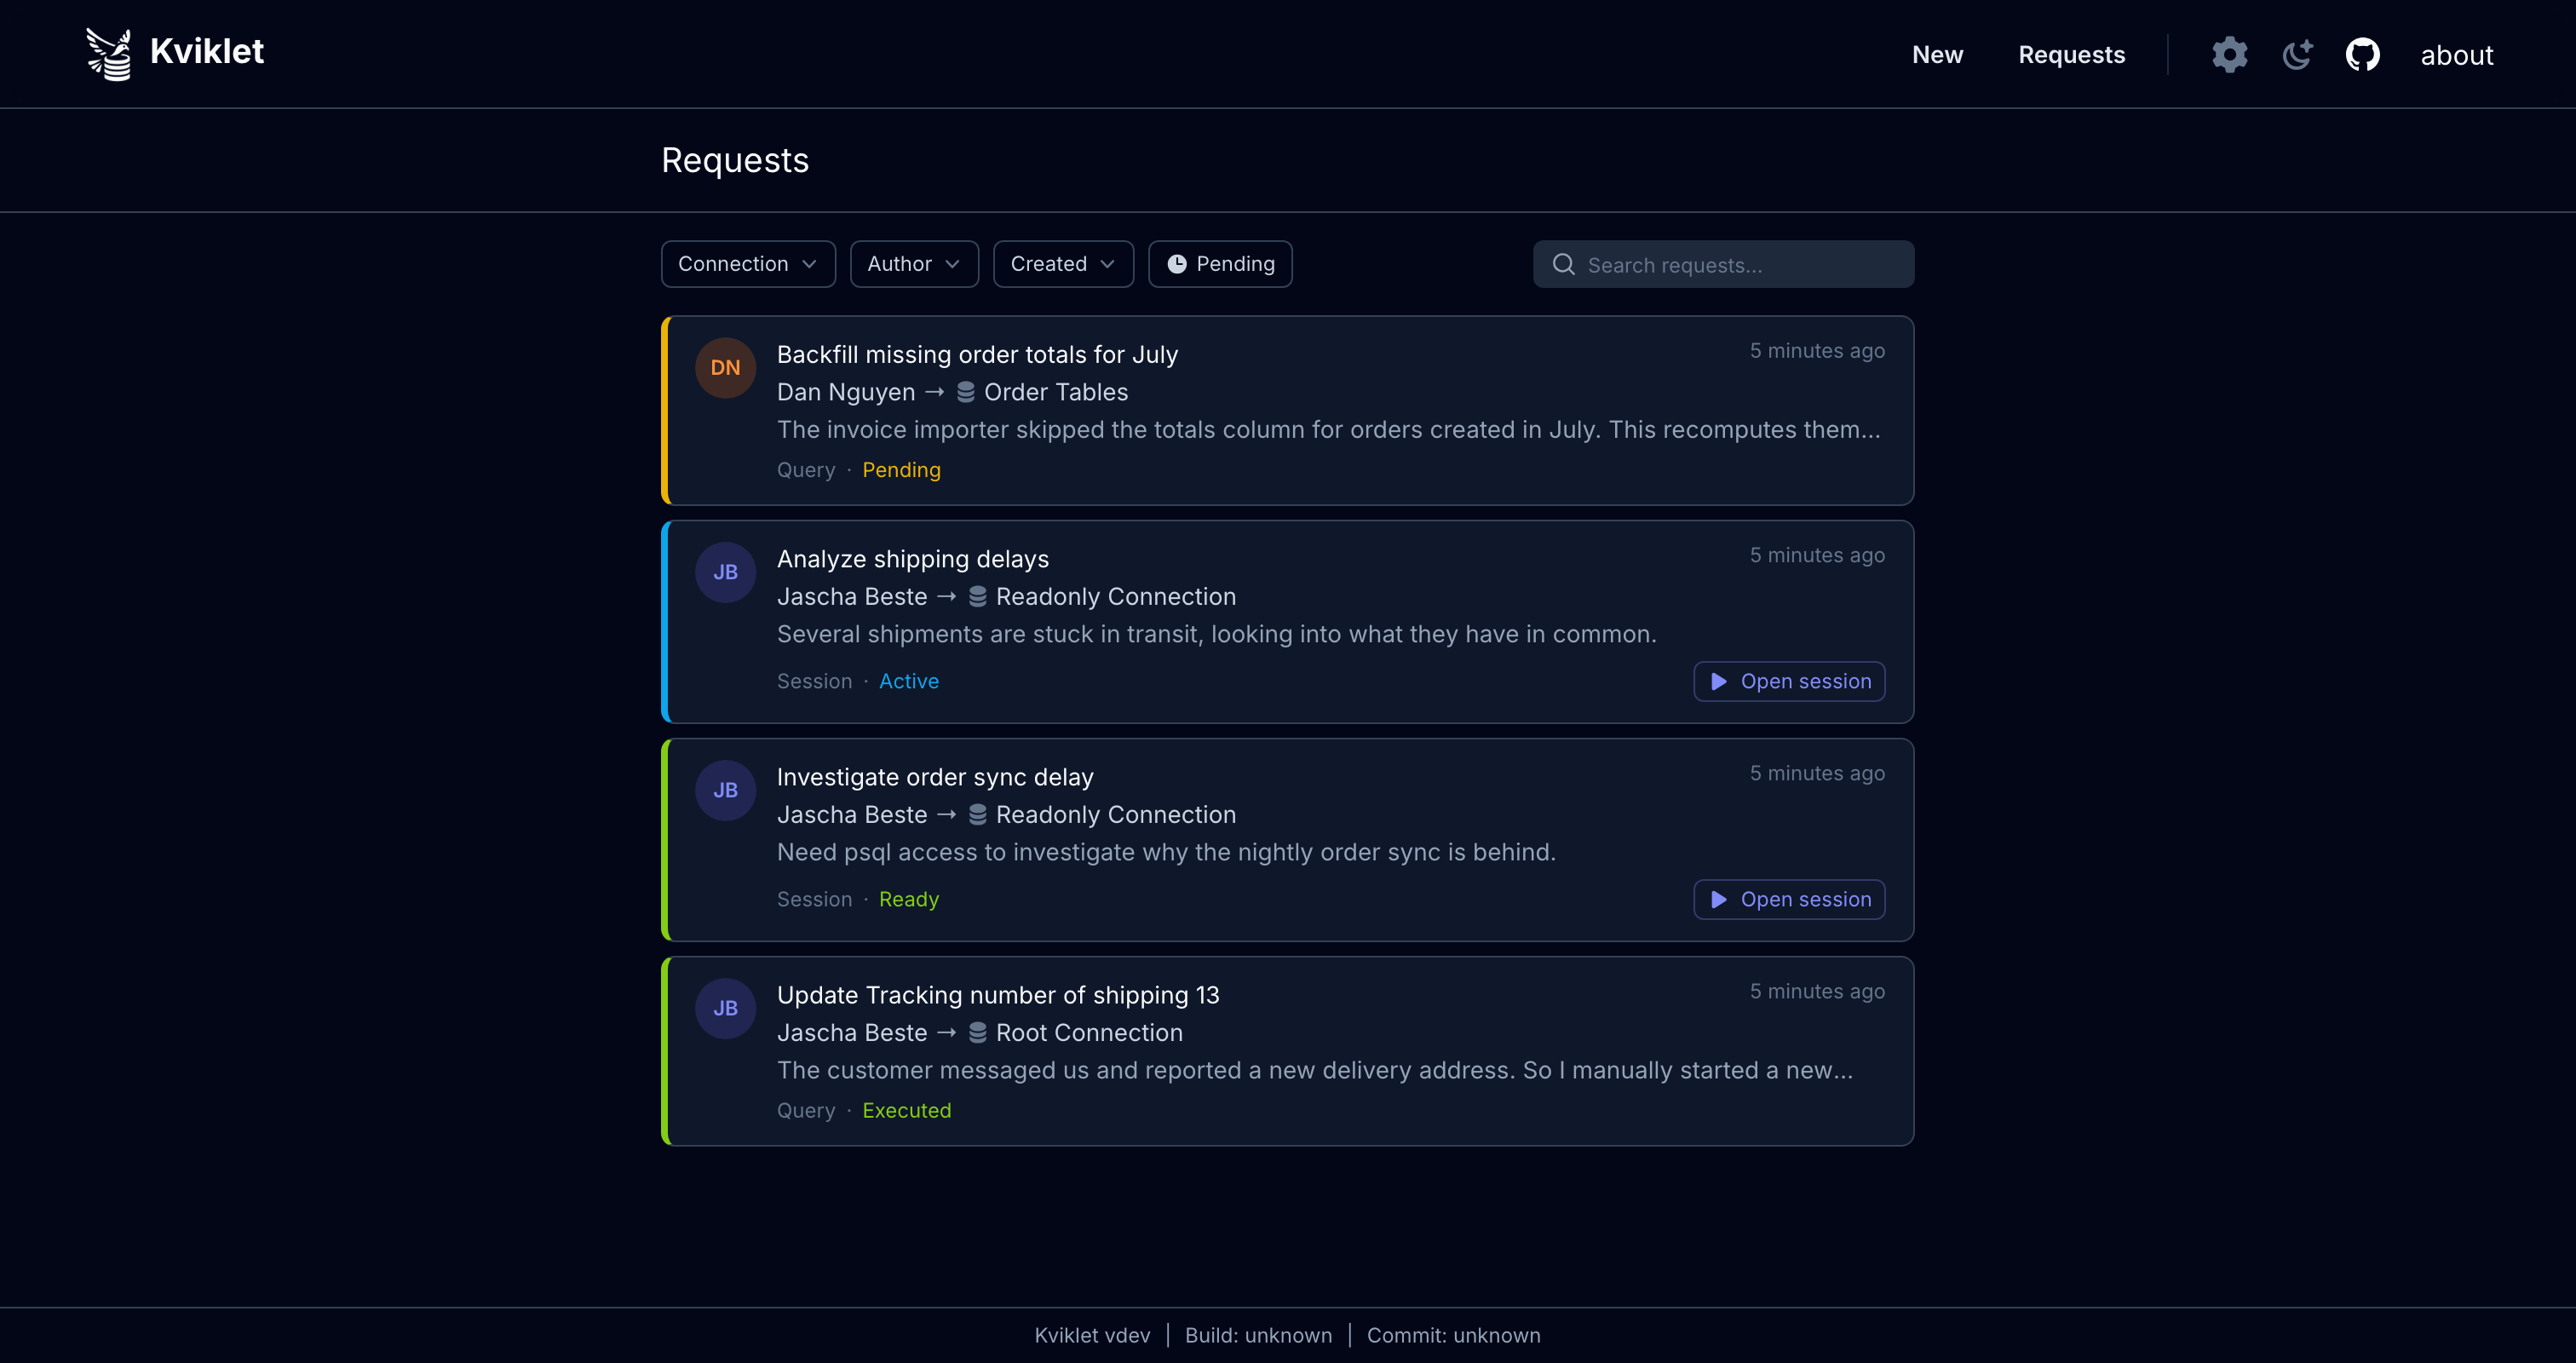
Demandes
Toutes les demandes de données sont regroupées en un seul endroit. Comme des PR ouvertes pour vos bases de données de production :
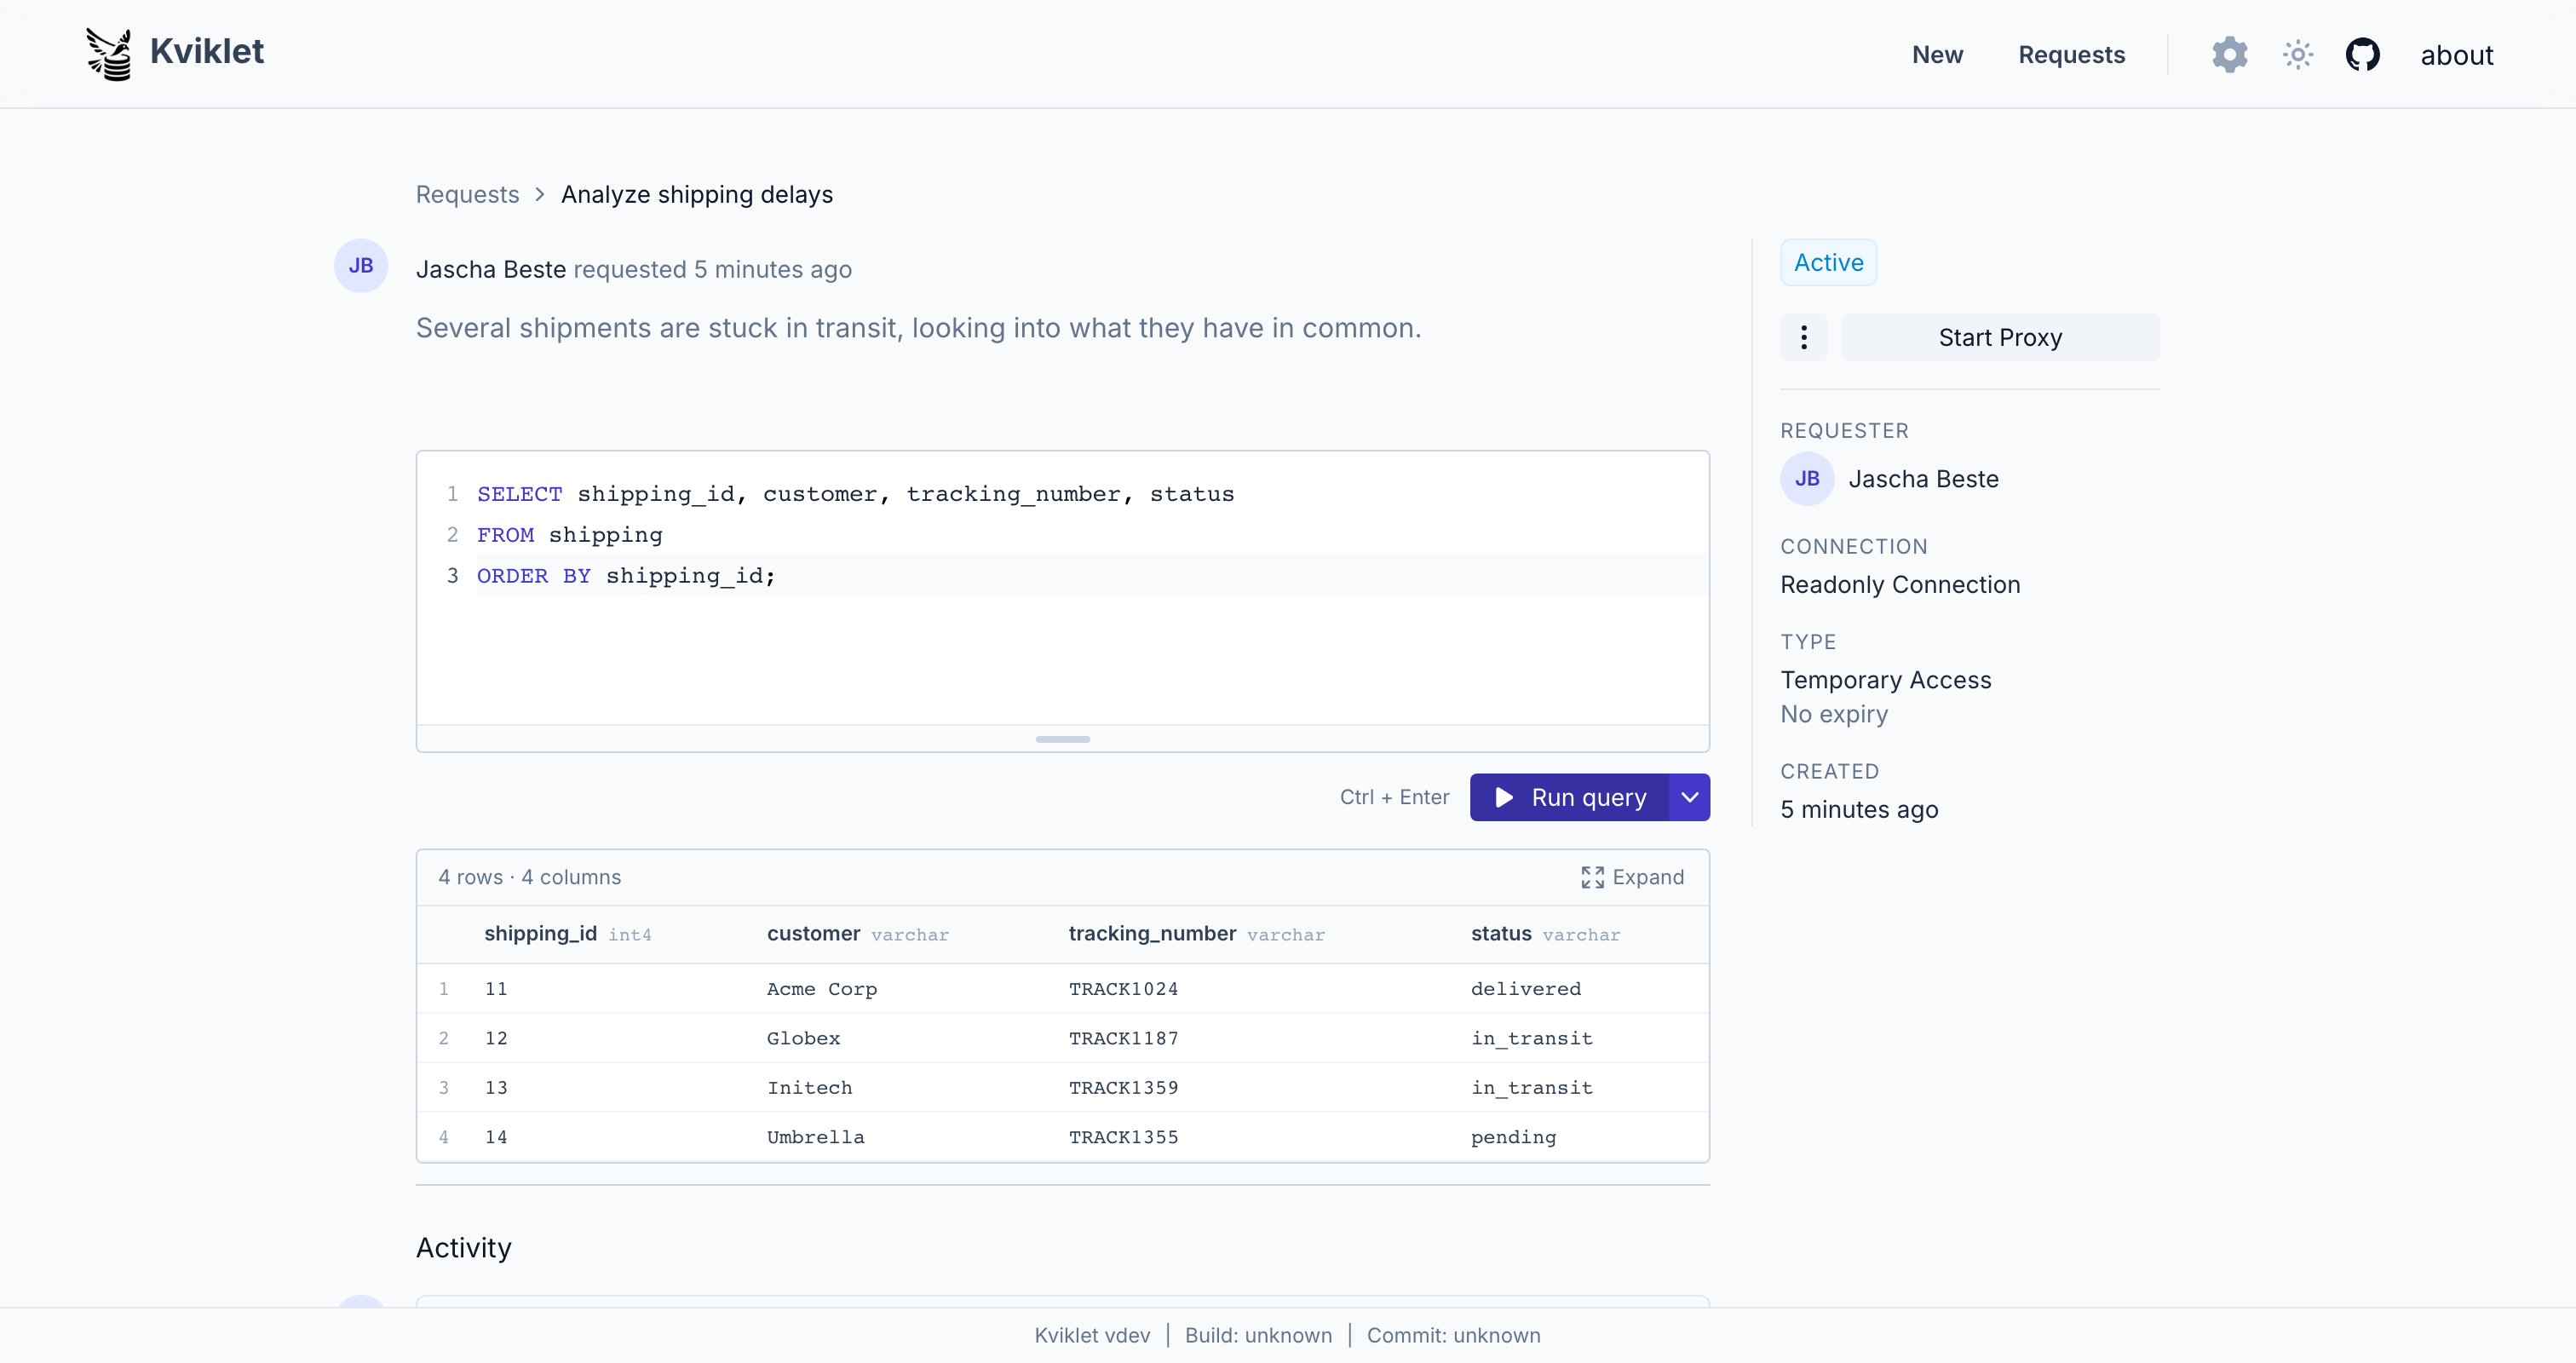
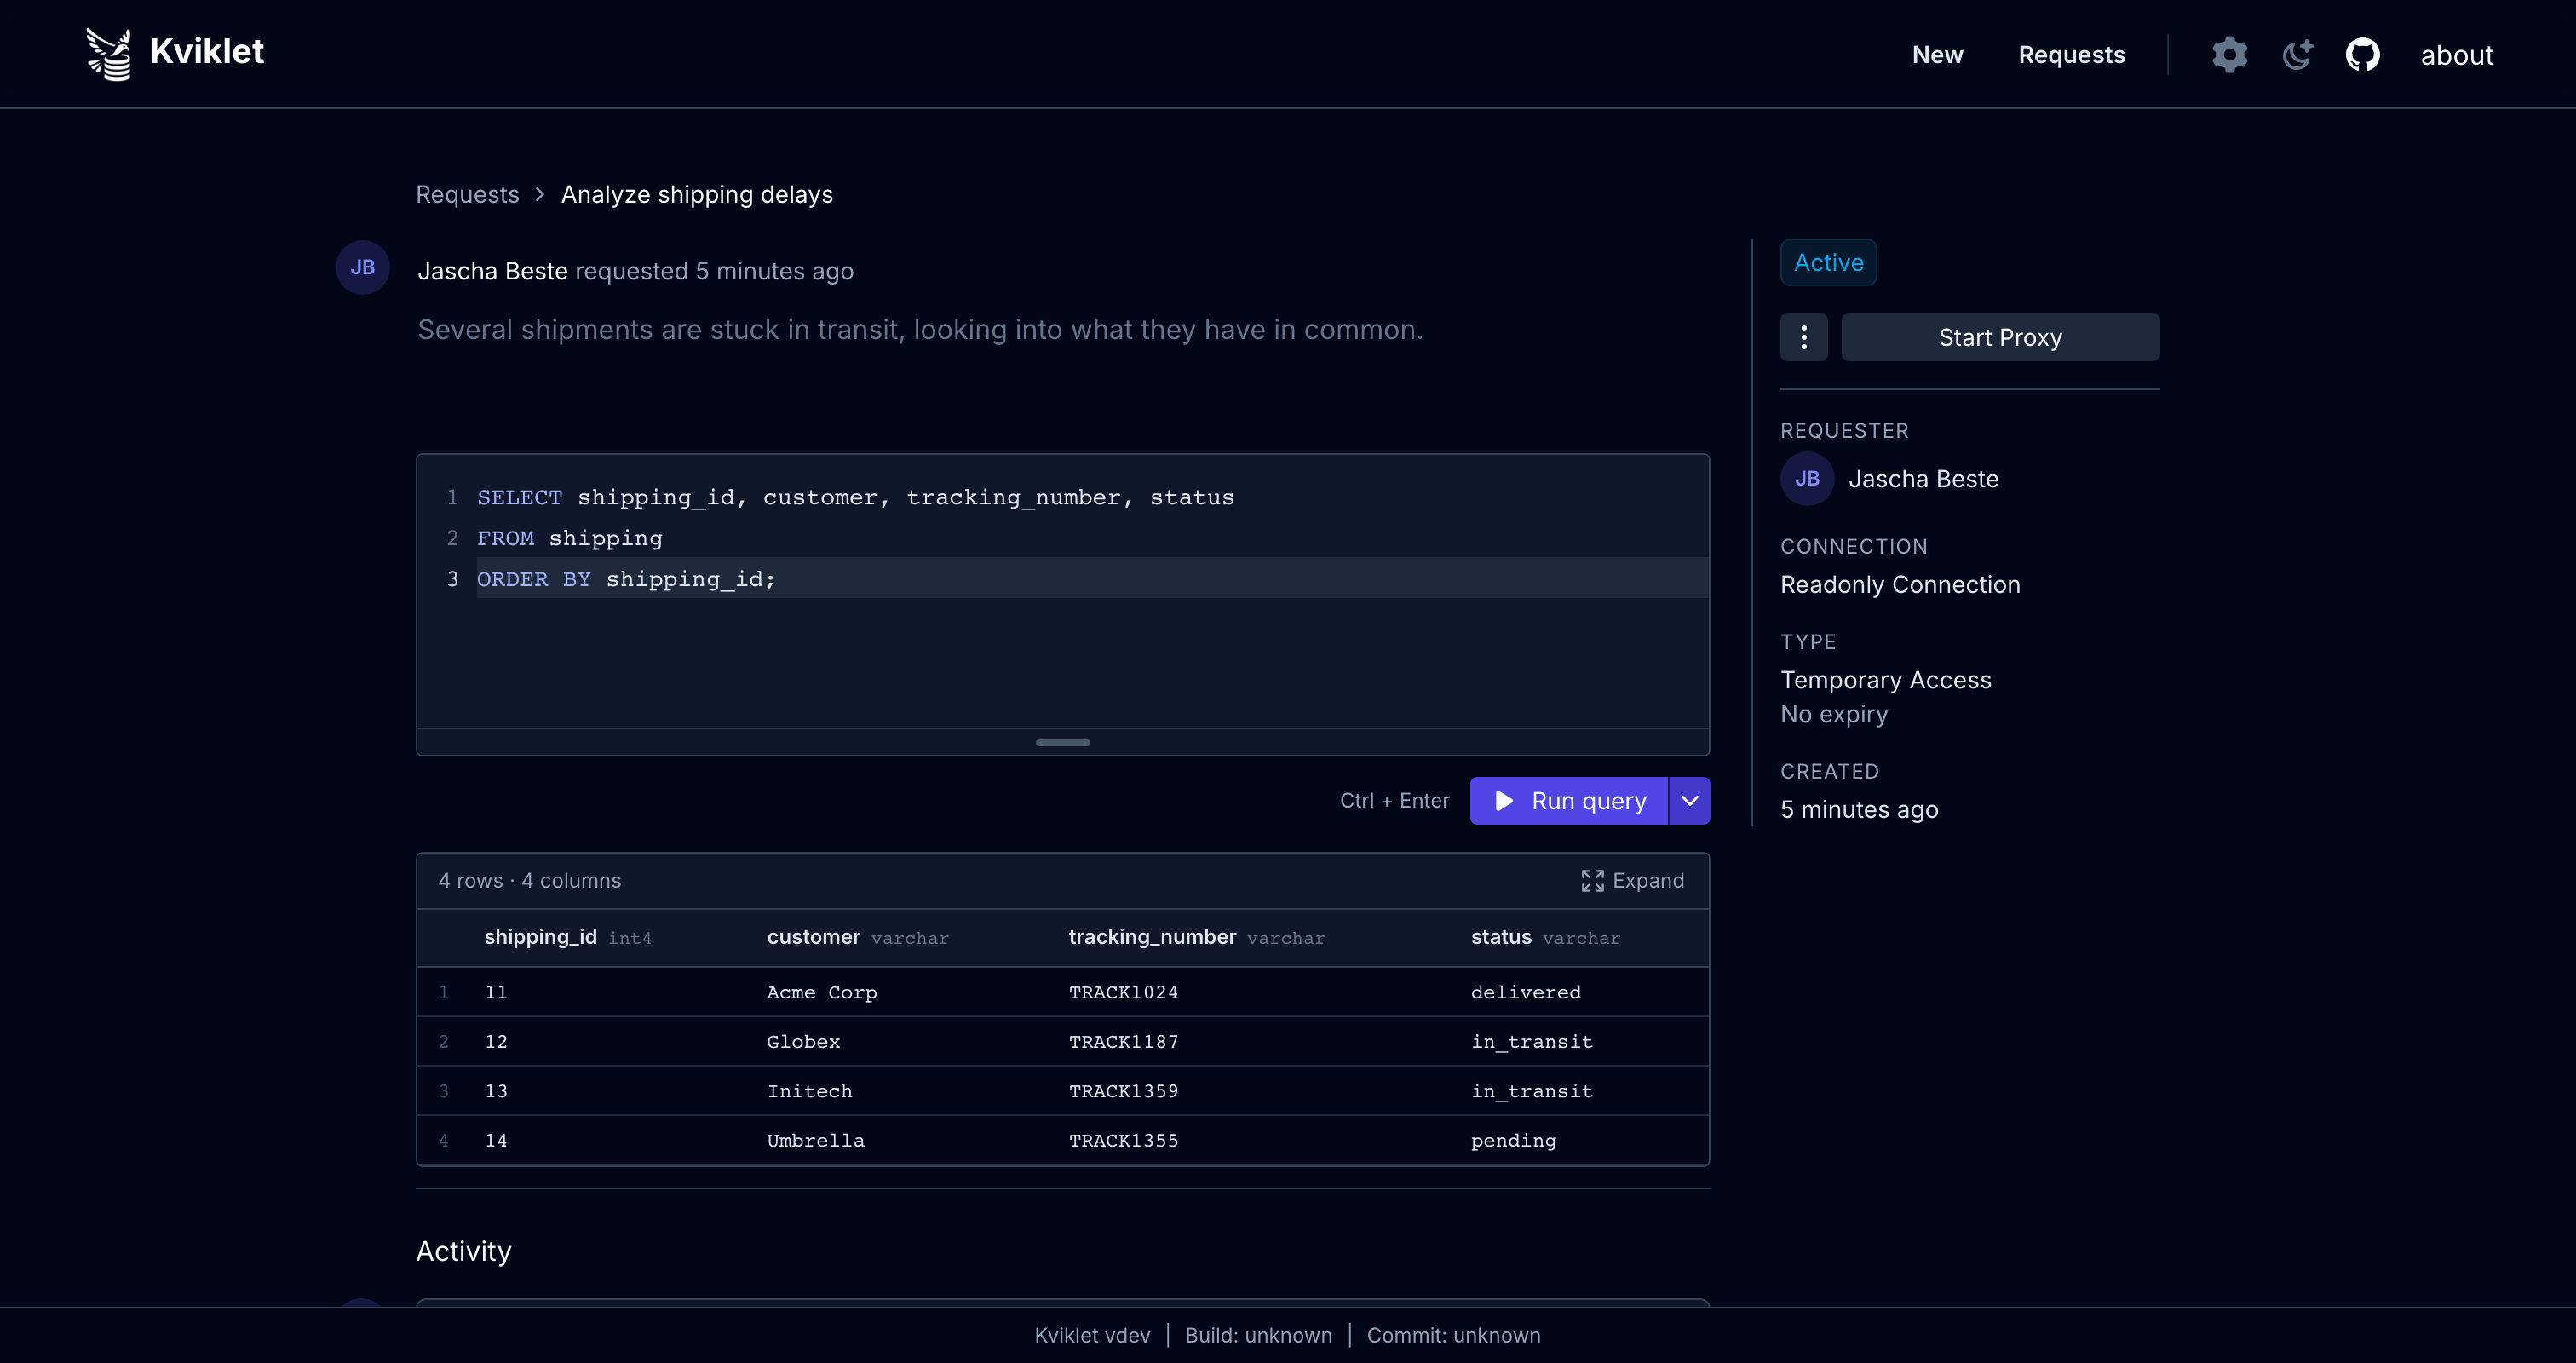
Sessions en direct
Une demande d'accès temporaire approuvée ouvre une session SQL en direct directement dans le navigateur :
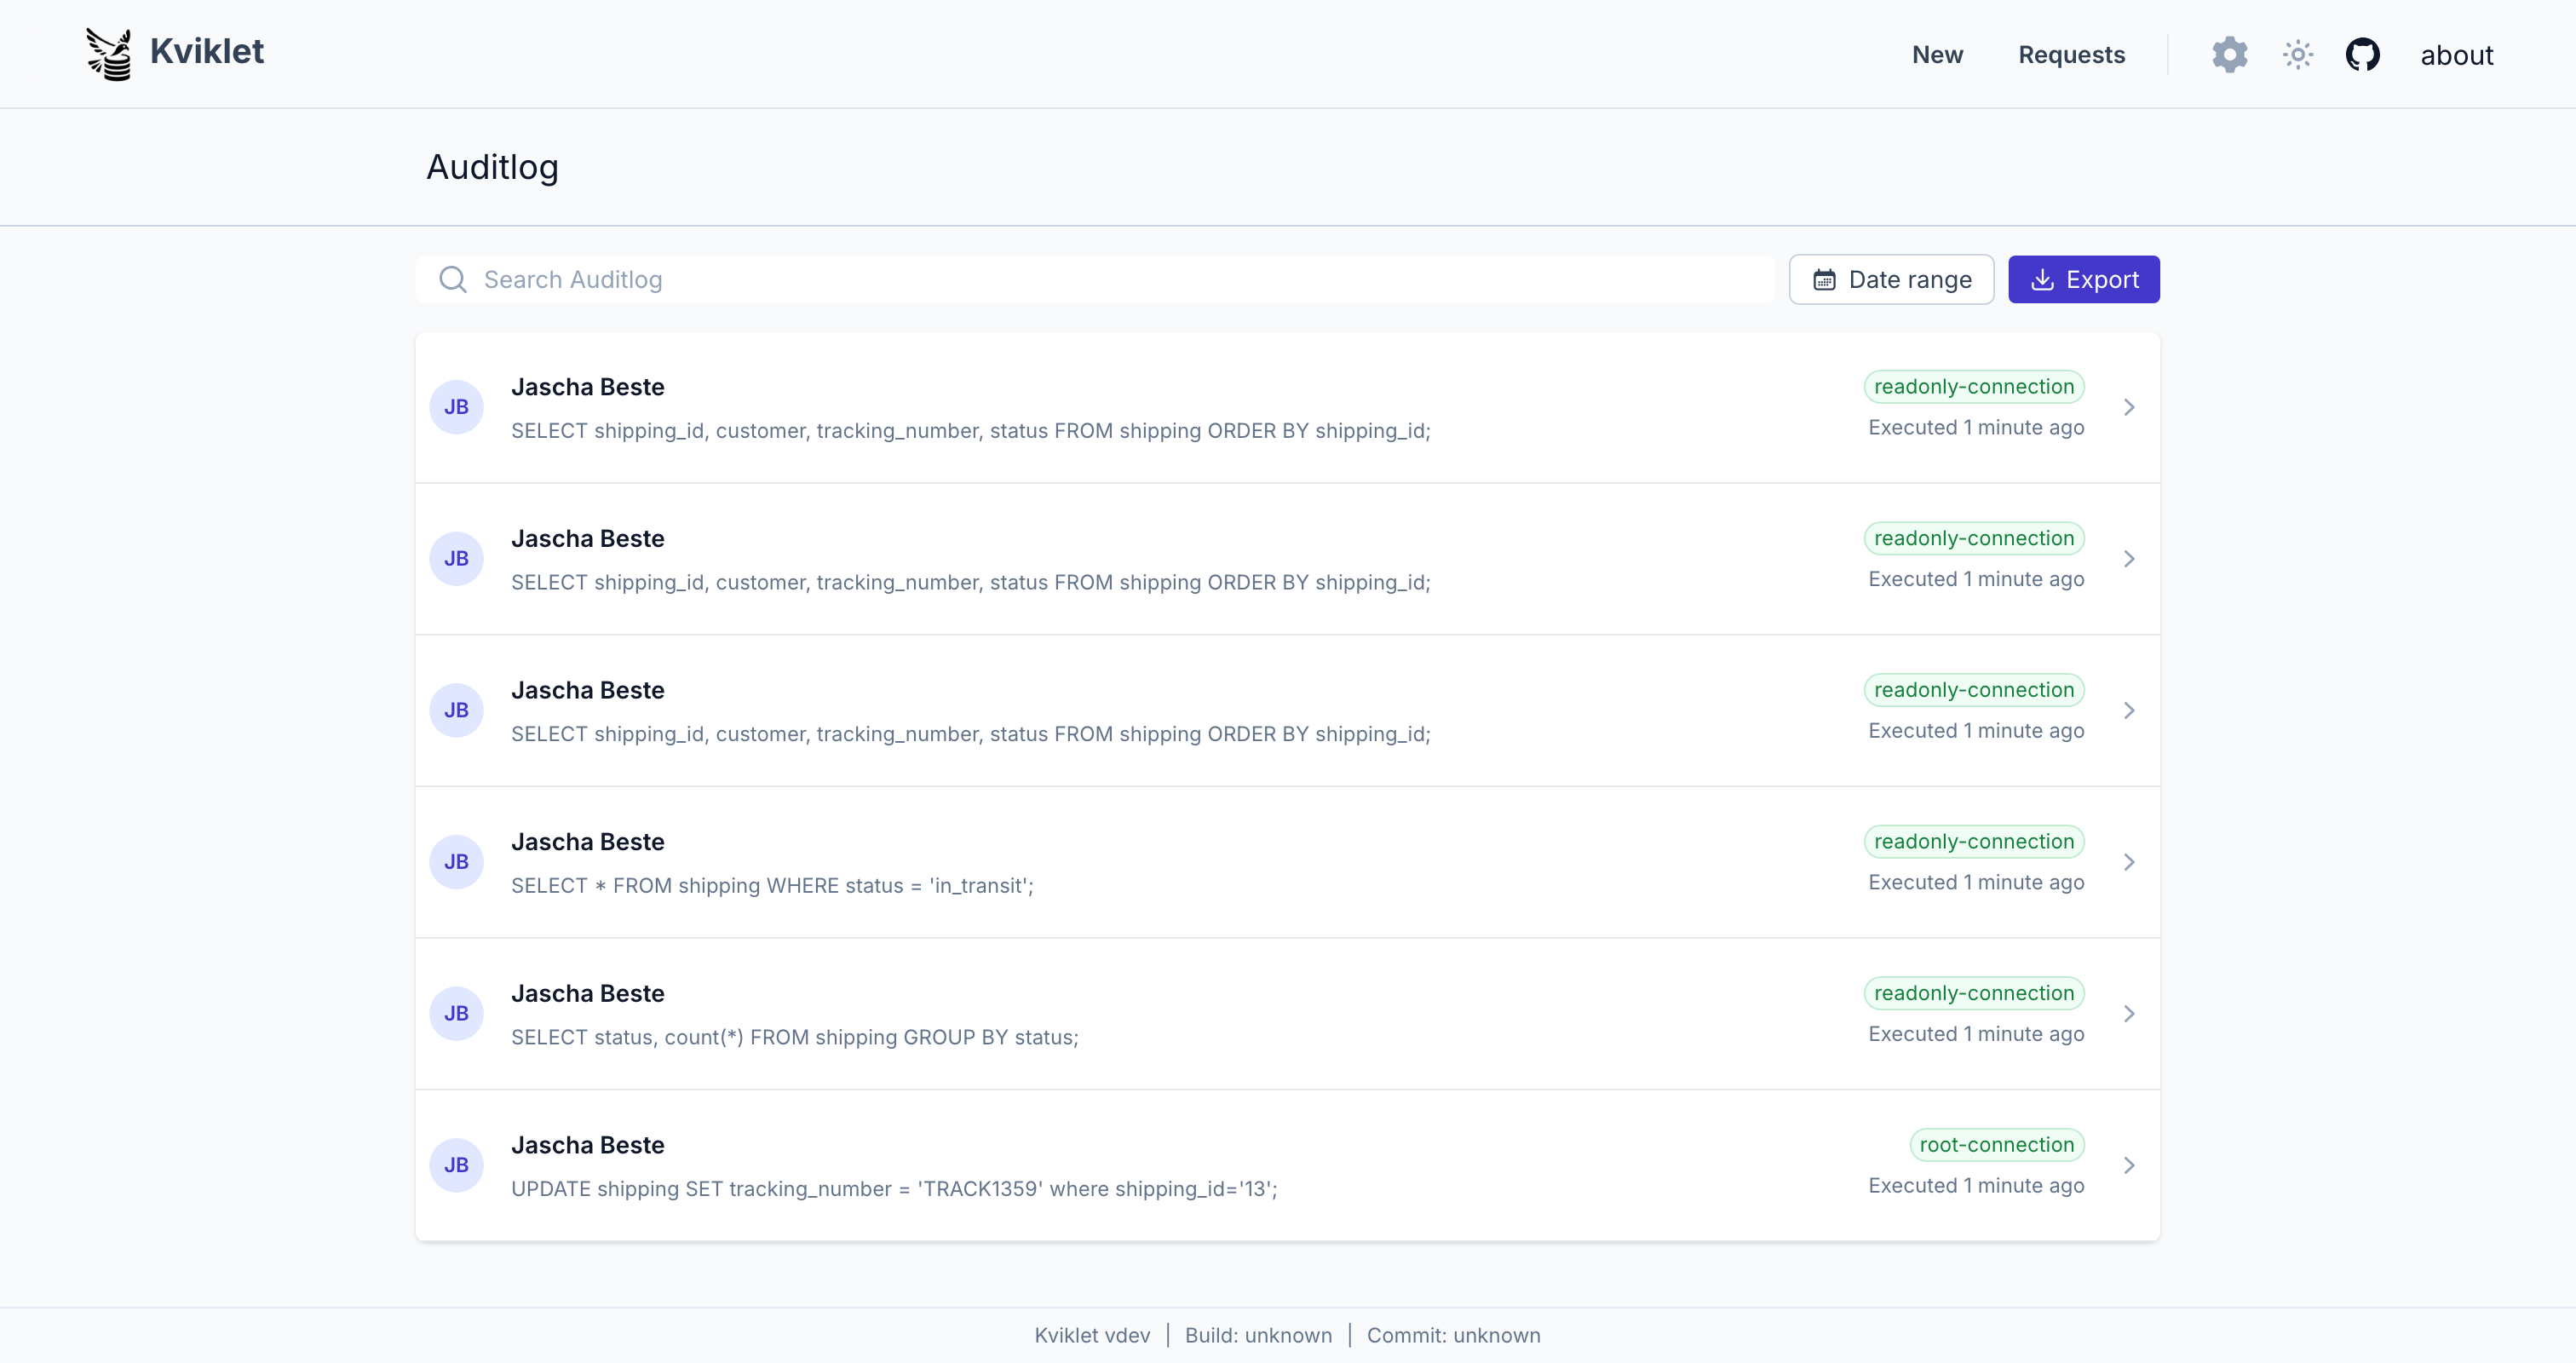
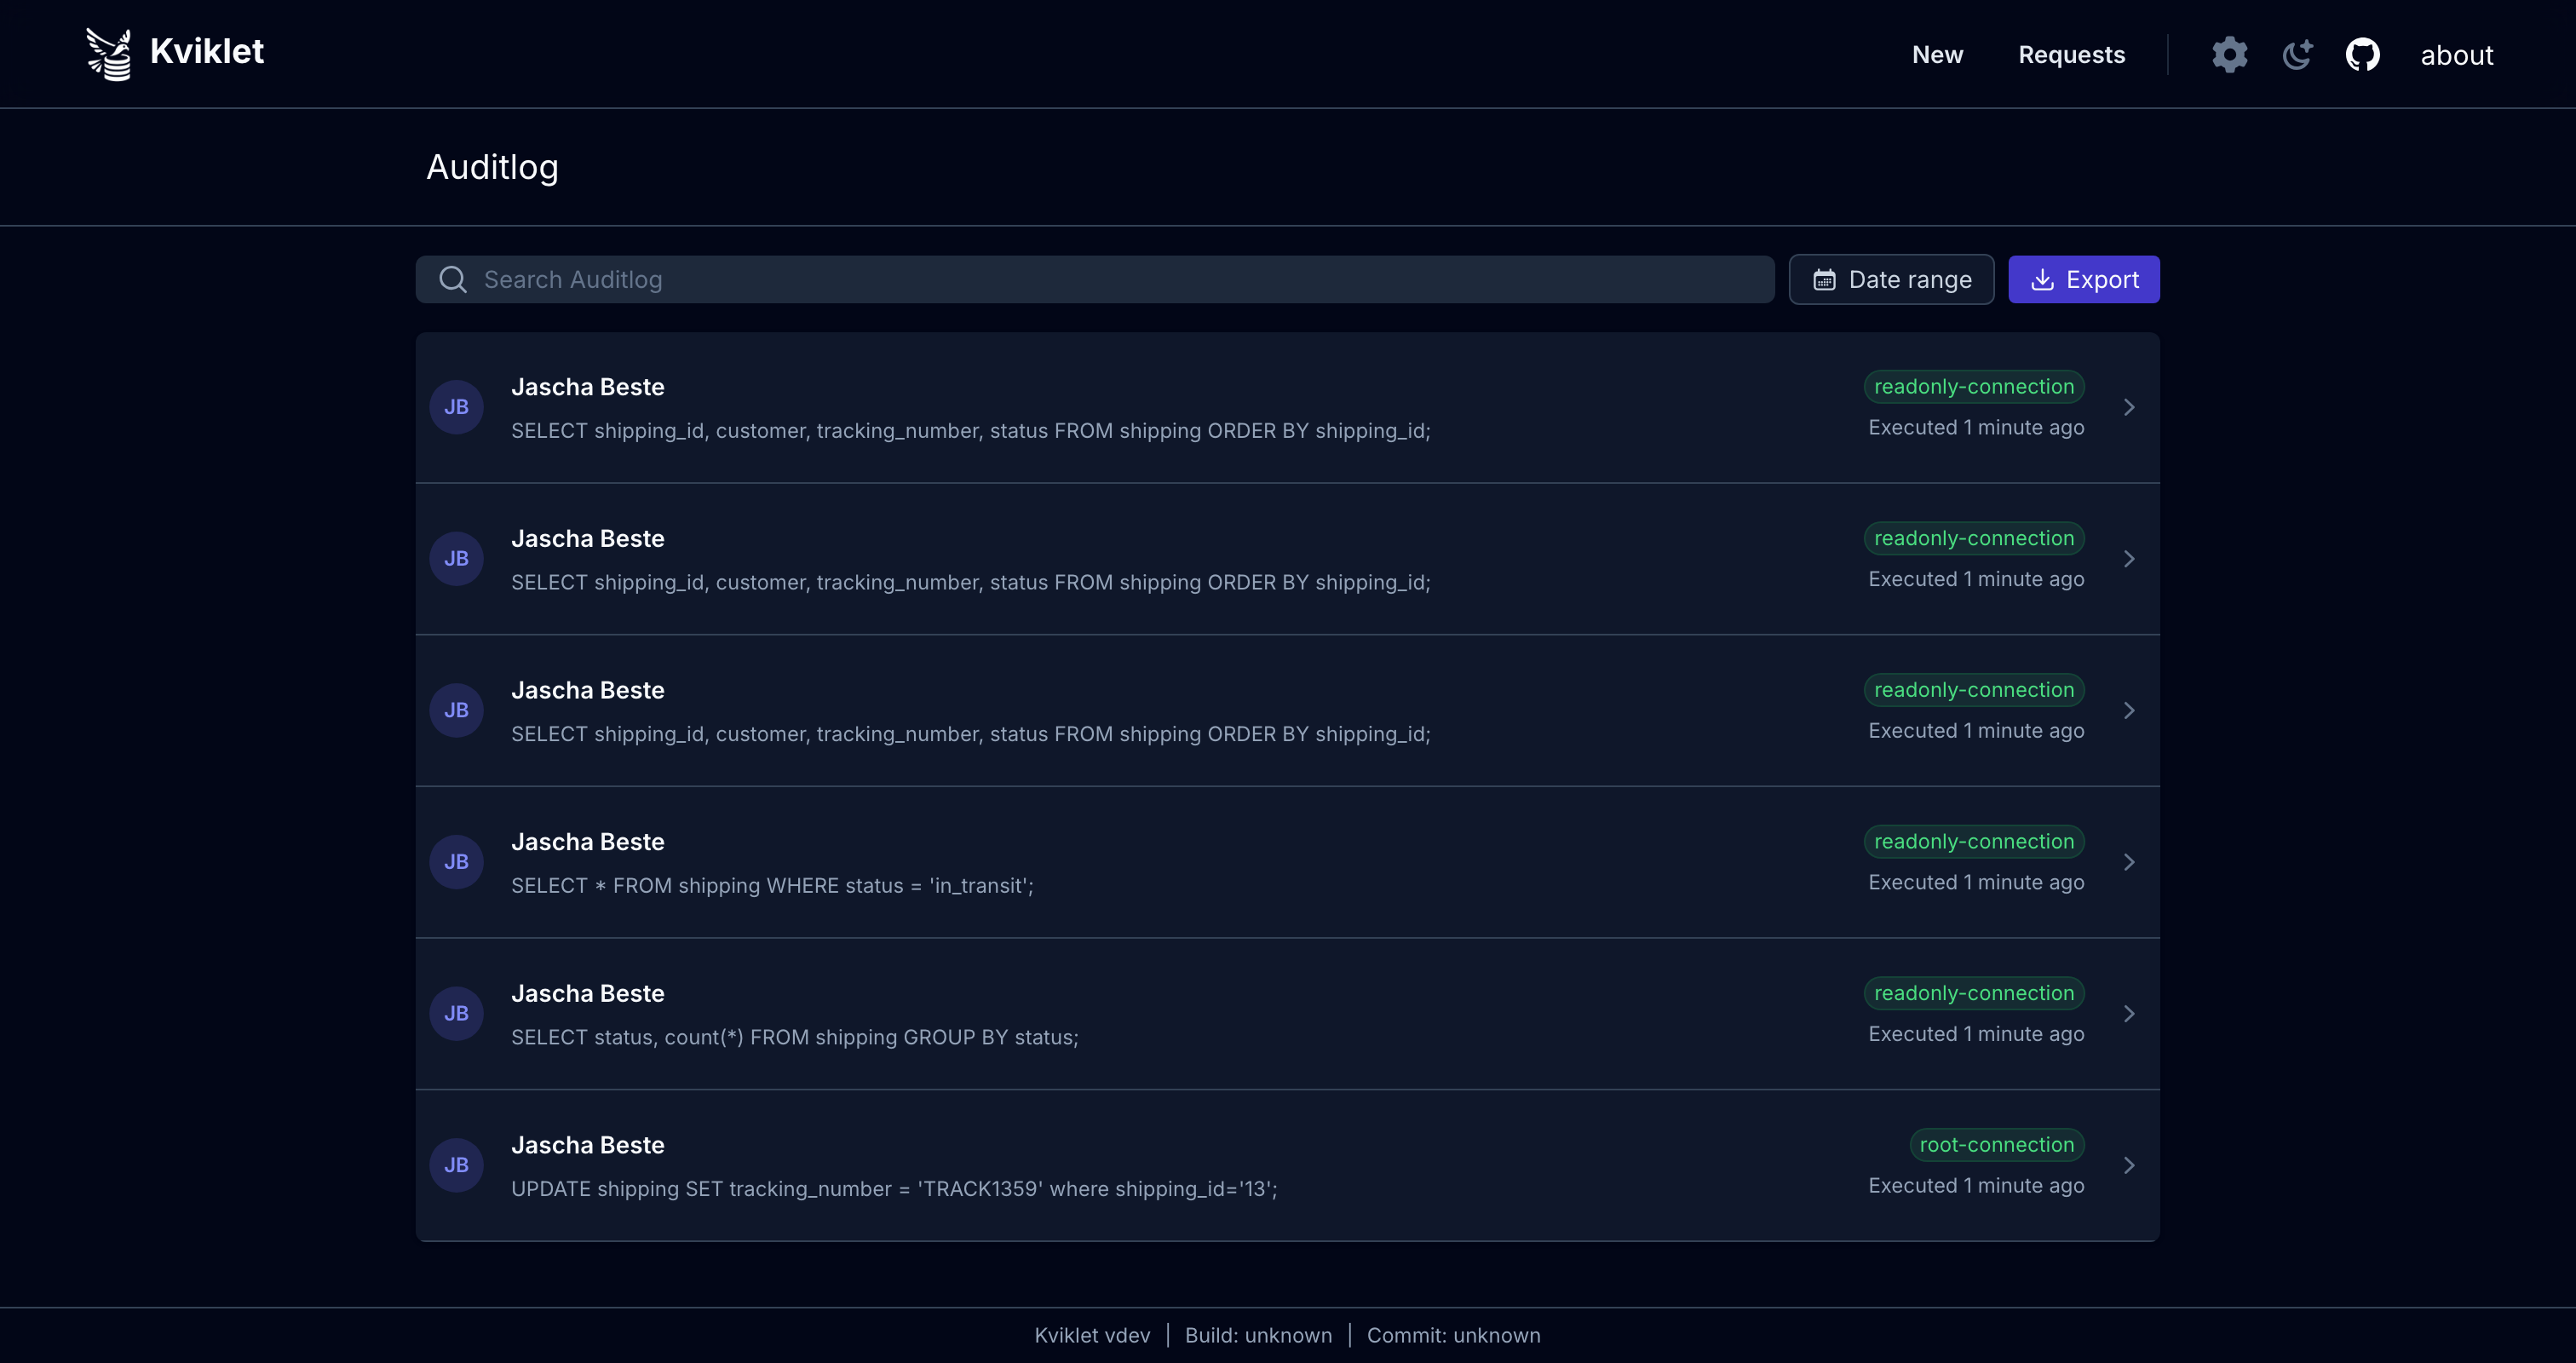
Journal d'audit
Chaque instruction exécutée est enregistrée — qu'elle ait été exécutée en tant que requête unique examinée, dans une session en direct, ou via le proxy de base de données :
Fonctionnalités par type de base de données/connexion
La plupart des fonctionnalités sont disponibles pour toutes les bases de données (SSO, LDAP, RBAC, flux de revue/approbation, journal d'audit, etc.). Mais certaines fonctionnalités sont restreintes, soit parce qu'elles n'ont simplement pas encore été développées, soit parce qu'elles n'ont pas de sens pour cet usage spécifique. Le tableau suivant montre quelles fonctionnalités sont disponibles pour quel type de base de données :
| Base de données | Revue d'instruction | Accès temporaire | Proxy(Beta) | Explain Plan |
|---|---|---|---|---|
| Postgres | ✓ | ✓ | ✓ | ✓ |
| MySQL | ✓ | ✓ | ✓ | ✓ |
| MariaDB | ✓ | ✓ | ✓ | ✓ |
| SQL Server | ✓ | ✓ | ✗ | ✓ |
| MongoDB | ✓ | ✓ | ✗ | ✗ |
| Kubernetes | ✓ | ✗ | ✗ | ✗ |
Installation
Kviklet est livré sous forme de simple conteneur Docker.
Vous pouvez trouver les versions disponibles dans les Releases. Nous recommandons de mettre à jour régulièrement la version que vous utilisez, car nous continuons à développer de nouvelles fonctionnalités.
La dernière actuellement est ghcr.io/kviklet/kviklet:0.8.0, vous pouvez aussi utiliser :main mais il peut arriver de temps en temps que nous mergions accidentellement quelque chose de bogué. Bien que nous essayions d'éviter cela.
Démarrage rapide
Si vous voulez simplement essayer comment cela fonctionne :
-
Voici un docker-compose.yaml minimal :
Cliquez pour développer le contenu du compose
``` services: postgres: image: postgres:16 restart: always environment: POSTGRES_USER: postgres POSTGRES_PASSWORD: postgres POSTGRES_DB: postgres ports: - "5432:5432" volumes: - ./postgres-data:/var/lib/postgresql/data # - ./sample_data.sql:/docker-entrypoint-initdb.d/init.sqlkviklet-postgres: image: postgres:16 restart: always environment: POSTGRES_USER: postgres POSTGRES_PASSWORD: postgres POSTGRES_DB: kviklet ports: - "5433:5432" volumes: - ./kviklet-postgres-data:/var/lib/postgresql/data
kviklet: image: ghcr.io/kviklet/kviklet:main ports: - "80:8080" environment: - SPRING_DATASOURCE_URL=jdbc:postgresql://kviklet-postgres:5432/kviklet - SPRING_DATASOURCE_USERNAME=postgres - SPRING_DATASOURCE_PASSWORD=postgres - INITIAL_USER_EMAIL=[email protected] - INITIAL_USER_PASSWORD=admin depends_on: - kviklet-postgres
-
Lancez le
docker-compose.ymlviadocker-compose up -d. Kviklet démarrera sur le port 80, rendez-vous surlocalhostet explorez. L'identifiant admin est [email protected] avecadmincomme mot de passe. -
Le docker-compose contient une base de données postgres supplémentaire pour laquelle vous pouvez configurer une connexion dans Kviklet. Pour que cette base de données contienne des données, décommentez cette ligne : ``` - ./sample_data.sql:/docker-entrypoint-initdb.d/init.sql
Et créez un fichier sample_data.sql :
Cliquez pour développer le contenu de sample_data.sql
```sql CREATE TABLE Locations ( Name VARCHAR(100) NOT NULL, Address VARCHAR(255) NOT NULL, City VARCHAR(100) NOT NULL, Country VARCHAR(100) NOT NULL, PostalCode VARCHAR(20) NOT NULL );alter table public.Locations owner to postgres;
INSERT INTO public.Locations (Name, Address, City, Country, PostalCode) VALUES ('Central Park', '59th to 110th St', 'New York', 'USA', '10022'), ('Eiffel Tower', 'Champ de Mars, 5 Avenue Anatole', 'Paris', 'France', '75007'), ('Colosseum', 'Piazza del Colosseo, 1', 'Rome', 'Italy', '00184'), ('Sydney Opera House', 'Bennelong Point', 'Sydney', 'Australia', '2000'), ('Great Wall of China', 'Huairou District', 'Beijing', 'China', '101405');
</details>

### Configuration de la base de données

Kviklet a besoin de sa propre base de données postgres (ou au moins d'un schéma) pour enregistrer les métadonnées relatives aux requêtes, connexions, approbations, etc.
Vous pouvez trouver leur image officielle ici : https://hub.docker.com/_/postgres, ou utiliser une version hébergée dans le cloud par le fournisseur de cloud de votre choix.

Lors du démarrage du conteneur kviklet, vous devrez alors définir ces trois variables d'environnement en conséquence :```
SPRING_DATASOURCE_PASSWORD = password
SPRING_DATASOURCE_USERNAME = username
SPRING_DATASOURCE_URL = jdbc:postgresql://[host]:[port]/[database]?currentSchema=[schema]
Méthodes d'authentification alternatives
- IAM Auth :
Il est possible d'utiliser AWS IAM Auth pour la connexion à la base de données, auquel cas vous omettez simplement le mot de passe et définissez uniquement le nom d'utilisateur.
Vous devez également définir la variable d'environnement : ```
SPRING_DATASOURCE_IAMAUTH=true
Kviklet chargera les identifiants depuis les emplacements habituels (variables d'environnement, rôles d'instance, etc.) et générera un token pour la connexion.
- Certificats : Vous pouvez également utiliser des certificats pour la connexion à la base de données, voir ici pour un exemple.
Utilisateur initial
Vous aurez besoin d'un utilisateur administrateur initial à des fins de configuration. Pour cela, définissez les 2 variables d'environnement :
INITIAL_USER_EMAIL et INITIAL_USER_PASSWORD afin de pouvoir vous connecter à l'interface web. Vous pouvez modifier le mot de passe par la suite via l'interface utilisateur.
Exemple :```
INITIAL_USER_EMAIL=[email protected]
INITIAL_USER_PASSWORD=someverysecurepassword
Nous publions nos conteneurs sur GitHub packages pour l'instant, donc avec tout ceci configuré, vous pouvez exécuter `ghcr.io/kviklet/kviklet:main`, n'oubliez pas de mapper le port `8080` qui est le port par défaut sur lequel Kviklet démarre.

Un exemple de docker run pourrait ressembler à ceci :```
docker run \
-e SPRING_DATASOURCE_PASSWORD=postgres \
-e SPRING_DATASOURCE_USERNAME=postgres \
-e SPRING_DATASOURCE_URL=jdbc:postgresql://localhost:5432/Kviklet \
-e [email protected] \
-e INITIAL_USER_PASSWORD=someverysecurepassword \
--network host \
ghcr.io/kviklet/kviklet:main
SSO via OIDC / OAuth2
Si vous souhaitez configurer le SSO pour votre instance Kviklet (ce qui est tout à fait logique, sinon vous devez à nouveau gérer des mots de passe). Vous devez configurer ces 3 variables d'environnement :``` KVIKLET_IDENTITYPROVIDER_CLIENTID KVIKLET_IDENTITYPROVIDER_CLIENTSECRET KVIKLET_IDENTITYPROVIDER_TYPE=google
The google client id and secret you can easily get by following google instructions here:
https://developers.google.com/identity/gsi/web/guides/get-google-api-clientid

For valid redirect URIs, you should configure: https://[kviklet_host]/api/login/oauth2/code/google
For Allowed Origins, simply your hosted kviklet url.

After setting those environment variables everyone in your organization can login with the sign in with google button. But they wont have any permissions by default, you will have to assign them a role after they log in once.

#### Keycloak

If you want to setup SSO with Keycloak instead you need to set these 4 environment variables:```
KVIKLET_IDENTITYPROVIDER_CLIENTID
KVIKLET_IDENTITYPROVIDER_CLIENTSECRET
KVIKLET_IDENTITYPROVIDER_TYPE=keycloak
KVIKLET_IDENTITYPROVIDER_ISSUERURI=http://[host]:[port]/realms/[realm]
Vous obtenez le client id et le secret lorsque vous créez une application dans Keycloak. Pour les URI de redirection valides, vous devez configurer : https://[kviklet_host]/api/login/oauth2/code/keycloak Pour les Allowed Origins, simplement votre URL kviklet hébergée.
Après avoir défini ces variables d'environnement, la page de connexion devrait afficher un bouton Login with Keycloak qui redirige vers votre instance keycloak. Dans l'édition entreprise, vous pouvez activer la synchronisation des rôles pour synchroniser automatiquement les rôles depuis votre instance keycloak vers kviklet. Consultez la section Role Sync pour plus de détails.
GitHub (Beta)
Beta : L'authentification GitHub est nouvelle et ne prend pas encore en charge la synchronisation des rôles — chaque nouvel utilisateur arrive avec le rôle par défaut et doit se voir attribuer des rôles manuellement.
GitHub n'est pas conforme à OIDC (c'est du pur OAuth 2.0), c'est pourquoi Kviklet lui consacre un support dédié. Définissez ces variables d'environnement :``` KVIKLET_IDENTITYPROVIDER_CLIENTID KVIKLET_IDENTITYPROVIDER_CLIENTSECRET KVIKLET_IDENTITYPROVIDER_TYPE=github KVIKLET_IDENTITYPROVIDER_GITHUB_ALLOWEDORGS=your-org,another-org
Créez une GitHub OAuth App sur https://github.com/settings/developers et configurez :

- Authorization callback URL : `https://[kviklet_host]/api/login/oauth2/code/github`
- Homepage URL : l'URL de votre instance Kviklet hébergée

`KVIKLET_IDENTITYPROVIDER_GITHUB_ALLOWEDORGS` est **obligatoire** (Kviklet refuse de démarrer sans). Les GitHub OAuth Apps ne peuvent pas restreindre qui termine le flux OAuth, donc Kviklet appelle `/user/orgs` après l'authentification et rejette les utilisateurs qui ne sont pas membres d'au moins une organisation autorisée (insensible à la casse, les 100 premières organisations sont vérifiées).

Pour que la vérification d'organisation puisse voir l'appartenance d'un utilisateur, celui-ci doit cliquer sur **Grant** (ou **Request**) à côté de chaque organisation autorisée sur l'écran de consentement OAuth. Si l'organisation a activé « Restrict third-party OAuth applications », un propriétaire de l'organisation doit également approuver l'application OAuth une fois avant que l'appartenance d'un membre ne devienne visible.

Kviklet demande les scopes `read:user`, `user:email` et `read:org`. Les e-mails sont toujours lus depuis `/user/emails` et seule une entrée `primary && verified` est acceptée, donc les utilisateurs avec des adresses e-mail privées peuvent quand même se connecter avec succès.

#### Autres fournisseurs OIDC

Les autres fournisseurs compatibles OIDC (GitLab, Auth0, Okta, etc.) devraient fonctionner de manière similaire à Keycloak. Notez que l'`redirect URI` changera selon le type que vous choisissez, donc si vous choisissez `gitlab` ce sera `https://[kviklet_host]/api/login/oauth2/code/gitlab`.
Si vous rencontrez des problèmes, n'hésitez pas à créer une issue, nous n'avons pas essayé tous les fournisseurs OIDC existants (pas encore) et il pourrait y avoir de légères différences dans l'implémentation qui pourraient nécessiter des mises à jour du côté de Kviklet.

### LDAP

Kviklet prend en charge l'authentification LDAP. Pour activer et configurer LDAP, vous pouvez surcharger les variables d'environnement suivantes :```
LDAP_ENABLED=true
LDAP_URL=ldap://your-ldap-server:389
LDAP_BASE=dc=your,dc=domain,dc=com
LDAP_PRINCIPAL=cn=admin,dc=your,dc=domain,dc=com
LDAP_PASSWORD=your-admin-password
LDAP_UNIQUE_IDENTIFIER_ATTRIBUTE=uid
LDAP_EMAIL_ATTRIBUTE=mail
LDAP_FULL_NAME_ATTRIBUTE=cn
LDAP_USER_OU=people
LDAP_SEARCH_BASE=ou=people
Voici ce que signifie chaque paramètre :
LDAP_ENABLED: Défini surtruepour activer l'authentification LDAP.LDAP_URL: L'URL de votre serveur LDAP.LDAP_BASE: Le DN de base pour les recherches LDAP.LDAP_PRINCIPAL: Le DN de l'utilisateur administrateur pour la liaison au serveur LDAP.LDAP_PASSWORD: Le mot de passe de l'utilisateur administrateur.LDAP_UNIQUE_IDENTIFIER_ATTRIBUTE: L'attribut LDAP utilisé comme identifiant unique pour les utilisateurs (par défaut : "uid").LDAP_EMAIL_ATTRIBUTE: L'attribut LDAP qui contient l'adresse e-mail de l'utilisateur (par défaut : "mail").LDAP_FULL_NAME_ATTRIBUTE: L'attribut LDAP qui contient le nom complet de l'utilisateur (par défaut : "cn").LDAP_USER_OU: L'unité organisationnelle (OU) où sont stockés les comptes utilisateurs (par défaut : "people").LDAP_SEARCH_BASE: Permet de remplacer le DN de base pour les recherches d'utilisateurs (par défaut : "ou=people"). Si vous utilisez FreeIPA, vous devrez peut-être définir ceci sur par exemplecn=users. Si défini, LDAP_USER_OU est ignoré.
Vous pouvez personnaliser ces attributs pour correspondre à votre schéma LDAP. Après avoir configuré LDAP, les utilisateurs pourront se connecter en utilisant leurs identifiants LDAP. La première fois qu'un utilisateur LDAP se connecte, un compte utilisateur correspondant sera créé dans Kviklet avec les permissions par défaut. Un administrateur devra attribuer les rôles appropriés à ces utilisateurs après leur première connexion.
SAML (Enterprise uniquement)
Kviklet prend en charge l'authentification SAML 2.0. Pour activer SAML, définissez les variables d'environnement suivantes :``` SAML_ENABLED=true SAML_ENTITYID=https://your-identity-provider.com SAML_SSOSERVICELOCATION=https://your-identity-provider.com/sso SAML_VERIFICATIONCERTIFICATE=-----BEGIN CERTIFICATE-----\nMIICmzCCAYMCBgF4...\n-----END CERTIFICATE-----
Détails de configuration :

- `SAML_ENABLED` : Défini sur `true` pour activer l'authentification SAML
- `SAML_ENTITYID` : L'ID d'entité de votre fournisseur d'identité SAML
- `SAML_SSOSERVICELOCATION` : L'URL du service SSO de votre fournisseur d'identité
- `SAML_VERIFICATIONCERTIFICATE` : Le certificat X.509 utilisé pour vérifier les réponses SAML (incluez les lignes BEGIN/END CERTIFICATE)

Vous pouvez éventuellement personnaliser les mappages d'attributs SAML :```
SAML_USERATTRIBUTES_EMAILATTRIBUTE=email
SAML_USERATTRIBUTES_NAMEATTRIBUTE=name
SAML_USERATTRIBUTES_IDATTRIBUTE=nameID
Votre fournisseur d'identité doit être configuré avec :
- Entity ID :
https://[kviklet_host]/api/saml2/service-provider-metadata/saml - Redirect Uri :
https://[kviklet_host]/api/login/saml2/sso/saml
Après avoir configuré SAML, les utilisateurs peuvent se connecter via le fournisseur d'identité. Lors de la première connexion, un compte utilisateur est créé avec les permissions par défaut.
Si vous êtes correctement redirigé vers l'IDP mais que vous obtenez ensuite une erreur CORS, vous pouvez ajouter l'hôte de votre IDP aux origines autorisées dans Kviklet via :``` CORS_ALLOWEDORIGINS=https://[idp_host]
## Configuration
### Connexions
Après avoir démarré Kviklet, vous devez d'abord configurer une connexion à une base de données. Allez dans Settings -> Databases -> Add Connection.
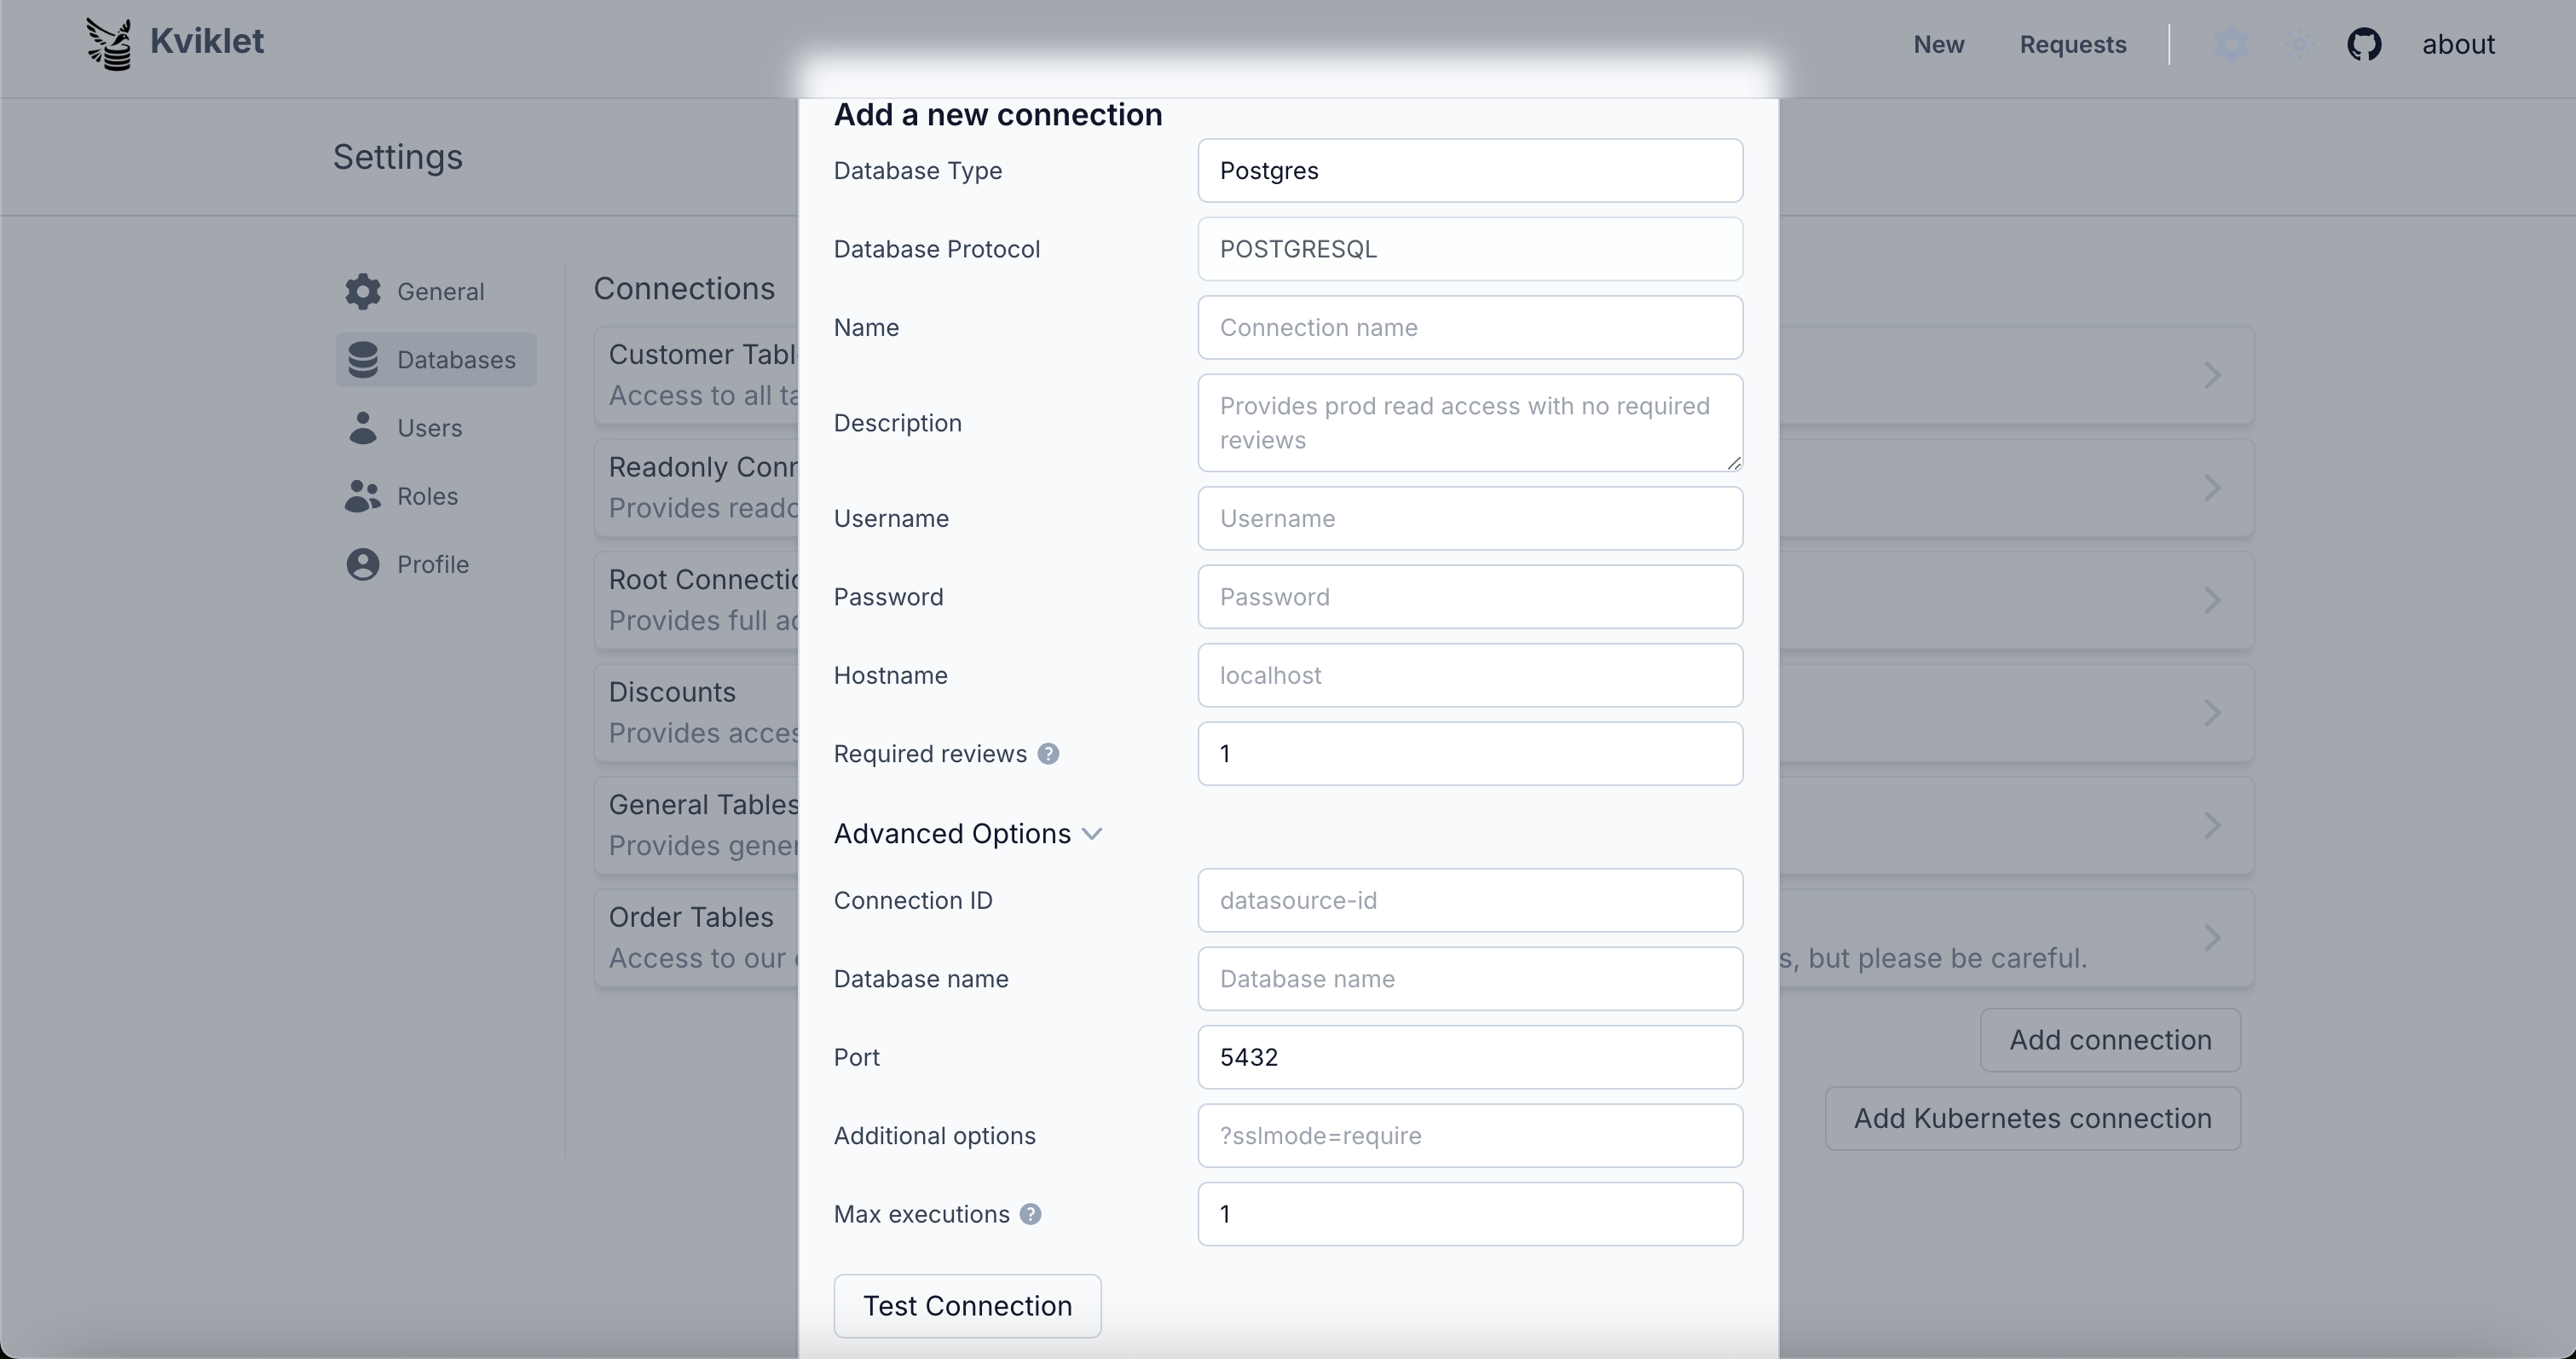
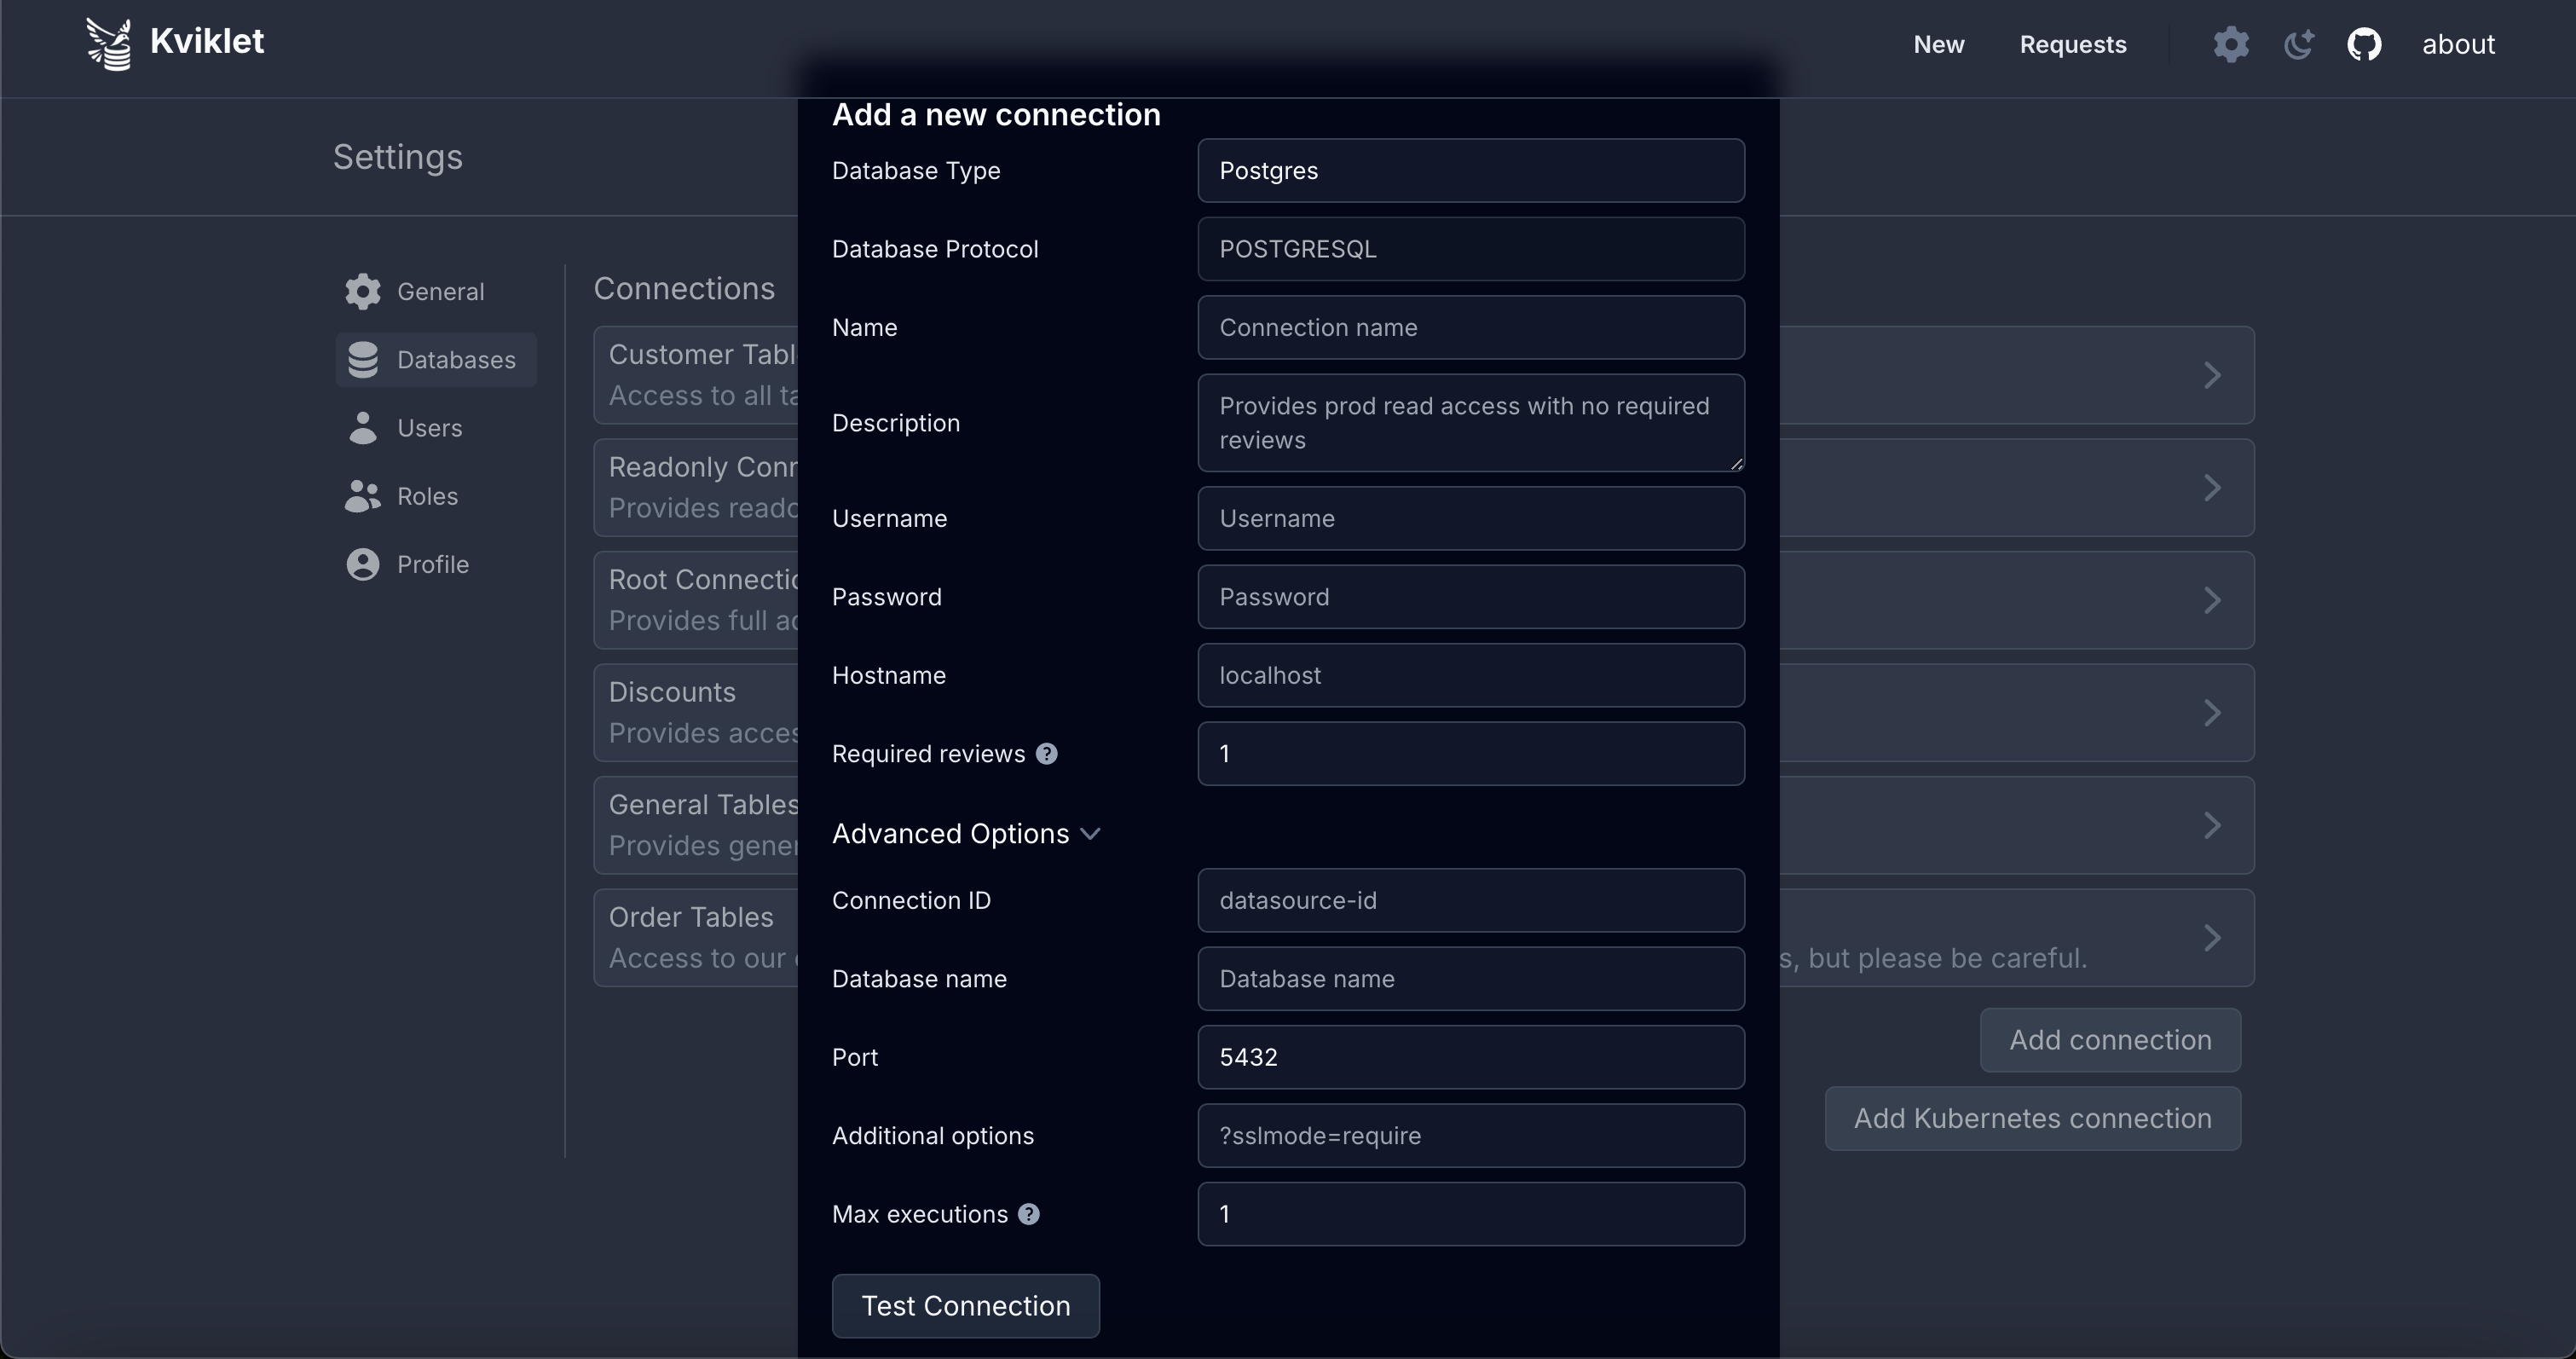
Ici, vous pouvez configurer les exigences de révision et les limites d'exécution pour chaque connexion. Voir [Review Gates](#review-gates) pour plus de détails.
#### AWS IAM AUTH
Kviklet prend en charge l'utilisation d'IAM Auth pour les connexions aux bases de données Postgres, MySQL et MariaDB ; pour cela, choisissez IAM Auth lors de la création d'une nouvelle connexion.

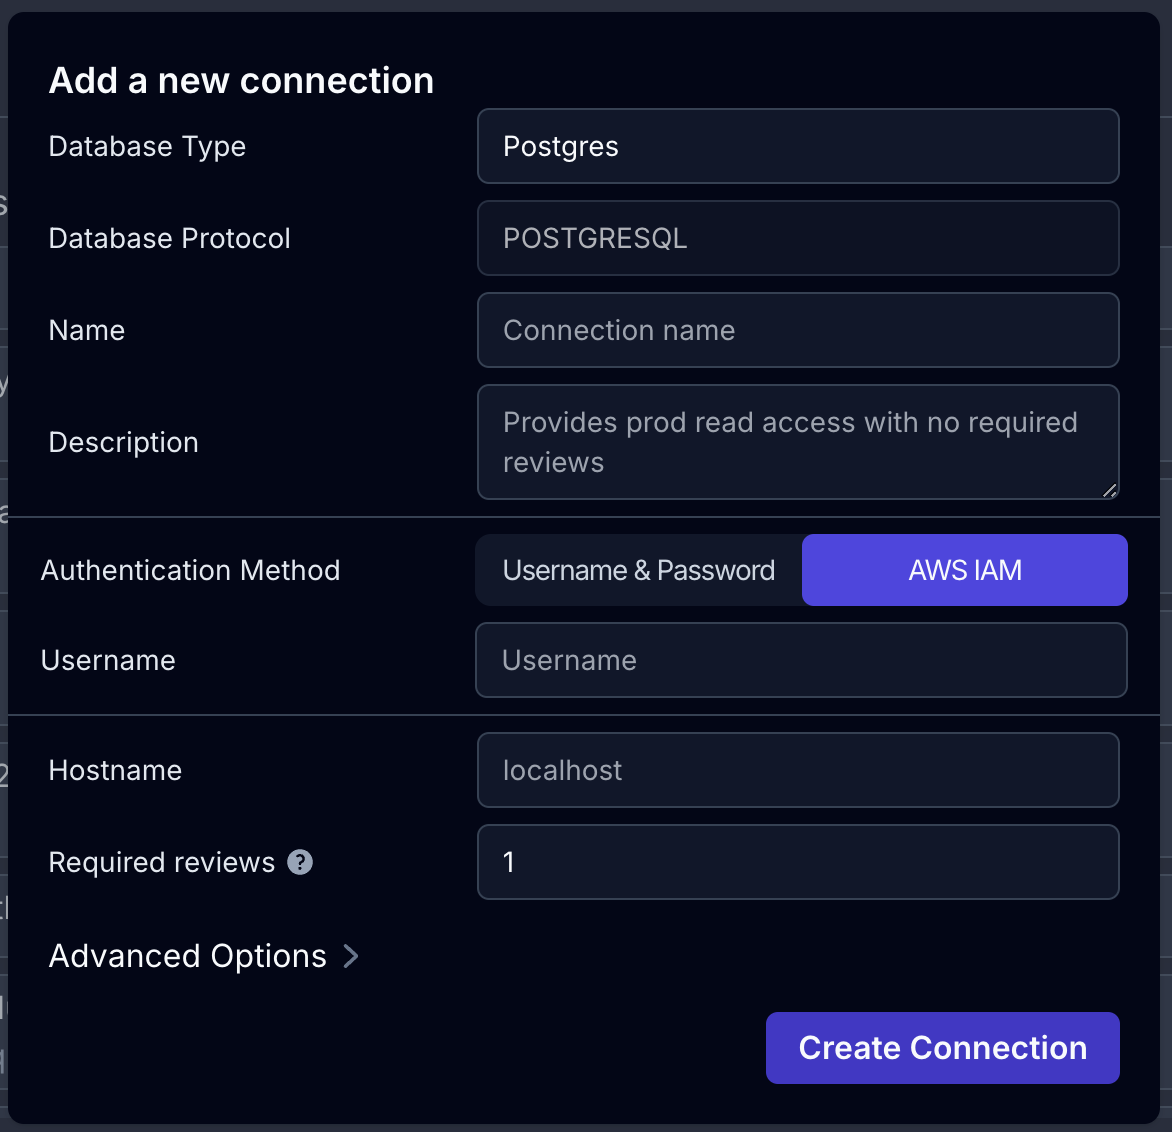
Cela supprimera l'option de définir un mot de passe et utilisera à la place les identifiants AWS pour se connecter à la base de données.
Kviklet utilise le `DefaultCredentialsProvider` d'AWS pour trouver les identifiants et générer le token pour la connexion. Cela signifie que tous les emplacements typiques devraient fonctionner (variables d'environnement ou rôles d'instance associés) ; l'ordre exact est documenté ici : https://sdk.amazonaws.com/java/api/latest/software/amazon/awssdk/auth/credentials/DefaultCredentialsProvider.html
De plus, vous pouvez fournir un ARN de rôle AWS que Kviklet assumera, et utiliser ces identifiants pour créer le token temporaire de la base de données. Cela est particulièrement utile pour se connecter à des bases de données qui ne se trouvent pas dans le même compte AWS que Kviklet. Pour utiliser cette fonctionnalité, saisissez simplement l'ARN du rôle dans le champ prévu lors de la création ou de la modification d'une connexion IAM Auth. Laisser le champ vide utilisera le fournisseur d'identifiants par défaut (aucune assumption de rôle).
La région AWS à utiliser lors de la génération du token est déduite de votre URL de connexion, il n'y a donc pas d'option pour la définir.
Pour apprendre à configurer IAM Auth pour votre base de données, suivez la documentation officielle AWS : https://docs.aws.amazon.com/AmazonRDS/latest/UserGuide/UsingWithRDS.IAMDBAuth.html
Les deux points principaux sont :
- Créer un utilisateur de base de données avec l'option IAM auth et les permissions correctes
- Créer une politique IAM qui permet à l'entité AWS de générer des tokens pour cet utilisateur
### Review Gates
Par défaut, Kviklet permet une configuration simple du nombre de révisions. Vous pouvez configurer combien d'approbations les demandes sur une connexion spécifique nécessitent avant de pouvoir être exécutées.
Le statut d'approbation d'une demande est calculé en fonction de la dernière action de chaque réviseur. Si un réviseur approuve puis demande ensuite des modifications, seule la demande de modification compte — son approbation antérieure est supprimée. La modification d'une demande réinitialise toujours toutes les approbations précédentes, garantissant qu'aucune modification ne peut être exécutée sans avoir été révisée au préalable. De même, si une exécution échoue (par exemple en raison d'une erreur de syntaxe SQL), les approbations sont réinitialisées afin que la demande puisse être corrigée et approuvée à nouveau sans avoir à en créer une nouvelle.
Vous pouvez également configurer une limite de **max executions** par connexion pour contrôler la fréquence à laquelle une demande approuvée peut être exécutée. La valeur par défaut est 1. La définir à 0 permet des exécutions illimitées. Les exécutions échouées ne comptent pas dans cette limite.
#### Exigences de révision basées sur les rôles (Enterprise)
Avec une licence Kviklet Enterprise, vous pouvez configurer des connexions individuelles pour exiger des approbations d'utilisateurs ayant des rôles spécifiques. Cela vous permet, par exemple, d'exiger l'approbation de l'équipe qui maintient une base de données donnée ou de conditionner les connexions sensibles à des approbations DBA ou de la direction.
**Comment cela fonctionne :**
Chaque connexion a un nombre **total de révisions requises** (`numTotalRequired`) qui agit comme un plancher — le nombre minimum d'approbations distinctes nécessaires, indépendamment des rôles. En plus de cela, vous pouvez ajouter des **exigences de rôle** qui spécifient combien d'approbations doivent provenir d'utilisateurs ayant un rôle particulier (par exemple, « 1 de DBA, 1 de Security »).
Une demande n'est approuvée que lorsque **les deux** conditions sont remplies :
- Le nombre total d'approbations distinctes atteint `numTotalRequired`
- Chaque exigence de rôle est individuellement satisfaite
Si un utilisateur appartient à plusieurs rôles, une seule approbation de cet utilisateur compte pour toutes les exigences de rôle correspondantes. Cependant, elle ne compte toujours que comme une seule approbation dans le total.
**Exemple :** Une connexion nécessite 3 approbations au total, dont 1 d'un DBA et 1 de Security. Un utilisateur qui possède à la fois le rôle DBA et le rôle Security approuve — cela satisfait les deux exigences de rôle mais ne compte que comme 1 des 3 approbations totales nécessaires. Deux approbations supplémentaires de n'importe quels utilisateurs sont encore requises.
Si votre licence enterprise expire, les exigences de révision basées sur les rôles existantes restent appliquées mais ne peuvent plus être modifiées. Vous pouvez uniquement les supprimer pour revenir à la configuration simple du nombre total de révisions.
### Rôles
Kviklet est livré avec 3 rôles : Default, Admins et Developers.
- Le rôle default fournit un accès en lecture à toutes les connexions et aux Requests. Ce rôle est attribué à chaque utilisateur et ne peut pas être supprimé. Vous pouvez toutefois modifier les permissions de ce rôle comme vous le souhaitez.
- Les Admins ont la permission de créer et modifier des connexions, ainsi que d'ajouter de nouveaux utilisateurs et de définir leurs permissions.
- Les Developers peuvent créer des Requests ainsi que les approuver et les commenter, et bien sûr exécuter les instructions réelles.
Vous pouvez personnaliser les rôles et, par exemple, donner à un rôle uniquement l'accès à une connexion spécifique ou à un groupe de connexions de bases de données.
Cela est utile, par exemple, si vous avez différentes équipes avec différentes bases de données et souhaitez contrôler l'accès à celles-ci de manière plus granulaire.
#### Création d'un nouveau rôle
La création d'un nouveau rôle fonctionne comme suit. Allez dans Settings -> Roles -> Add Role.
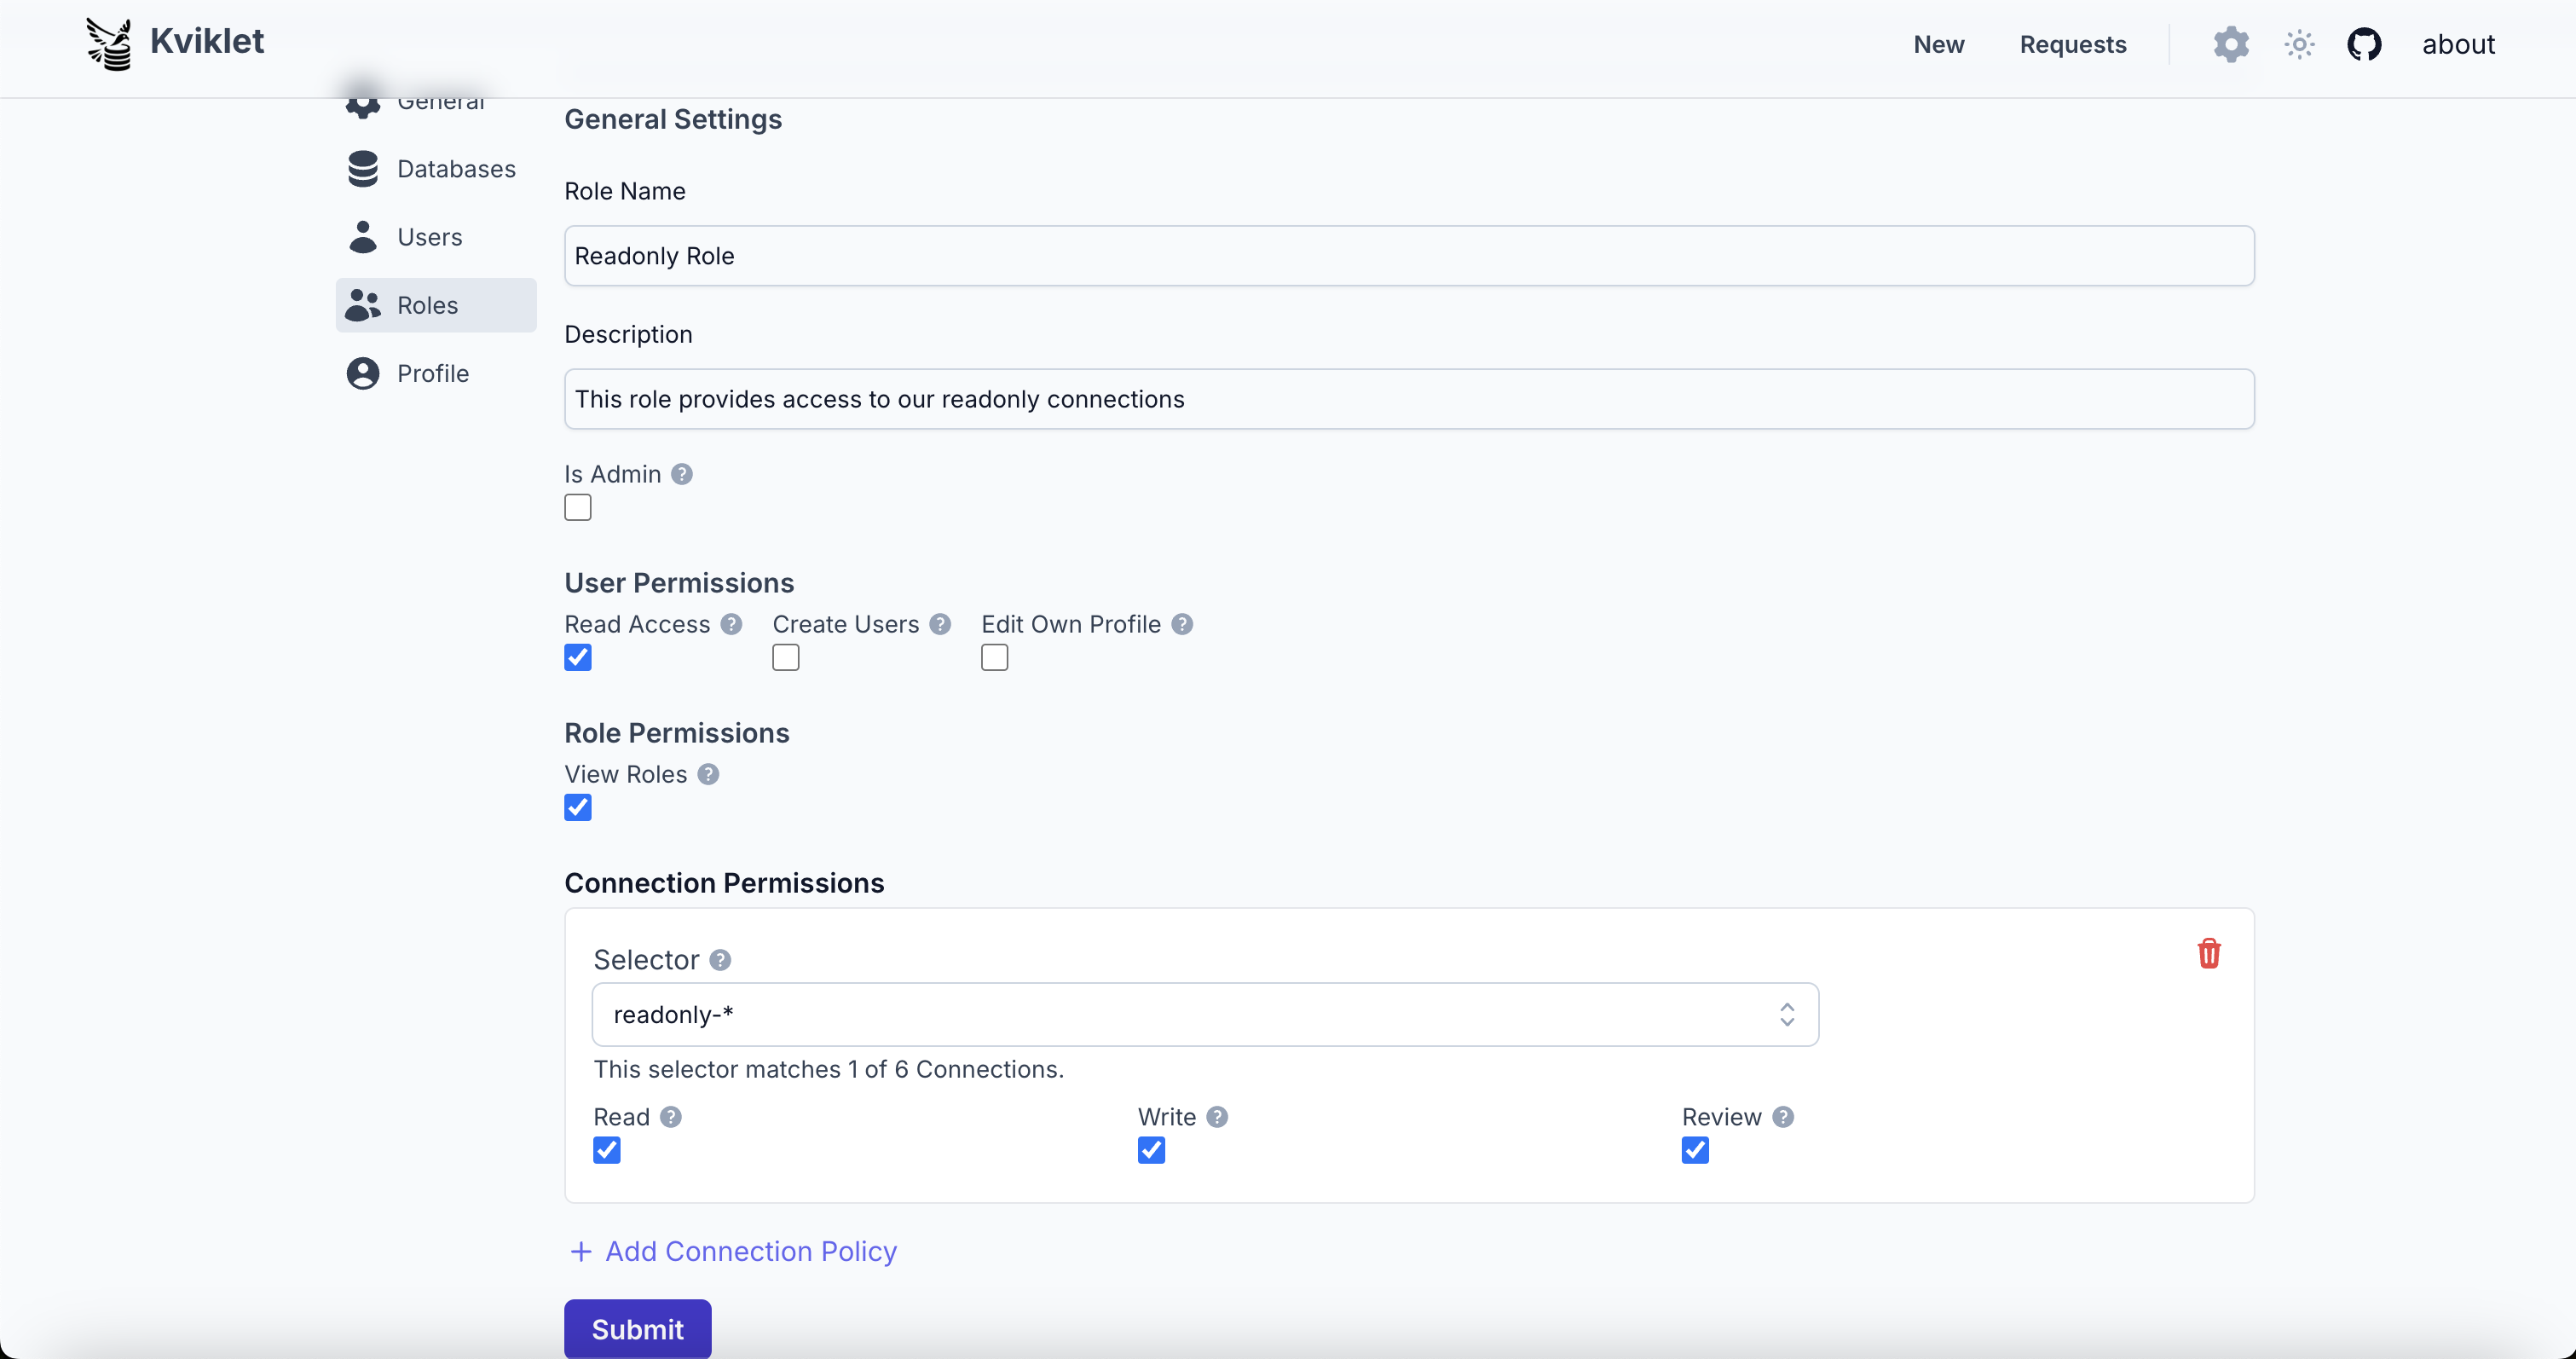
Les paramètres par défaut ne sont pas très pertinents pour la plupart des rôles et vous pouvez simplement donner l'accès User Read et RoleView et en rester là.
Plus intéressant est l'ajout de permissions individuelles pour les connexions. Ici, vous ajoutez d'abord un sélecteur pour sélectionner des connexions spécifiques. Cela peut être soit un id spécifique, soit vous utilisez des wildcards avec `*` pour correspondre à plusieurs connexions. Par exemple, si vous voulez avoir un rôle qui a accès à toutes les bases de données de dev (au cas où vous géreriez aussi l'accès à celles-ci avec kviklet), vous utiliseriez un sélecteur comme `dev-*` et vous vous assureriez que les ids des connexions sont correctement définis.
Vous pouvez bien sûr aussi concevoir un système que vous utilisez pour vos différentes équipes au sein de votre organisation.
### Role Sync (Enterprise)
Synchronisez automatiquement les rôles des utilisateurs à partir des groupes de votre fournisseur d'identité. Cette fonctionnalité nécessite une licence enterprise.
**La configuration** se fait dans Settings > Role Sync :
- **Enable Role Sync** : Activer/désactiver la synchronisation
- **Sync Mode** :
- **Full Sync** - Les rôles des utilisateurs correspondent exactement à leurs mappages de groupes IdP (plus le rôle par défaut)
- **Additive** - Les groupes IdP ajoutent des rôles mais ne suppriment pas ceux existants
- **First Login Only** - Les rôles sont synchronisés uniquement lors de la première connexion, les modifications manuelles sont préservées par la suite
- **Groups Attribute** : L'attribut IdP contenant les appartenances aux groupes (par défaut : `groups`)
- **Role Mappings** : Mapper les noms de groupes IdP (par exemple, `engineering`) aux rôles Kviklet
#### Configuration OIDC
Configurez votre fournisseur OIDC pour inclure une claim `groups` dans le token d'ID :
- **Keycloak** :
Keycloak n'inclut pas les groupes dans les tokens par défaut, vous devrez donc ajouter un mapper au client.
1. Naviguez vers **Clients** dans le menu de gauche
2. Sélectionnez votre client Kviklet
3. Allez dans l'onglet **Client scopes**
4. Cliquez sur le scope dédié (par exemple, `kviklet-dedicated`)
5. Allez dans l'onglet **Mappers**
6. Cliquez sur **Add mapper** → **By configuration**
7. Sélectionnez **Group Membership**
8. Configurez le mapper :
| Setting | Value |
| ------------------- | -------- |
| Name | `groups` |
| Token Claim Name | `groups` |
| Full group path | **OFF** |
| Add to ID token | **ON** |
| Add to access token | **ON** |
| Add to userinfo | **ON** |
9. Cliquez sur **Save**
> **Important :** Le « Token Claim Name » doit correspondre au « Groups Attribute » configuré dans les paramètres Role Sync de Kviklet (par défaut : `groups`).
- **Autres fournisseurs OIDC** : Ajoutez un mapper/claim de groupes qui inclut les appartenances aux groupes de l'utilisateur dans le token d'ID. Cela se fait généralement dans l'interface d'administration du fournisseur.
Si vous rencontrez des problèmes, n'hésitez pas à créer une issue ; nous n'avons pas encore essayé tous les fournisseurs OIDC existants (pas encore) et il pourrait y avoir de légères différences dans l'implémentation qui pourraient nécessiter des mises à jour du côté de Kviklet.
#### Configuration LDAP
La synchronisation des rôles LDAP utilise l'attribut `memberOf` :
1. Assurez-vous que votre serveur LDAP a l'overlay `memberOf` activé
2. Définissez **Groups Attribute** sur `memberOf` dans Kviklet
3. Les noms de groupes sont ensuite extraits de l'attribut `memberOf` dans les attributs des utilisateurs.
#### Configuration SAML
Configurez votre IdP SAML pour inclure les groupes dans l'assertion :
1. Ajoutez une déclaration d'attribut qui mappe les appartenances aux groupes des utilisateurs
2. Définissez le **Groups Attribute** dans Kviklet pour correspondre au nom de votre attribut SAML
3. Les noms de groupes sont ensuite extraits de l'attribut SAML dans les attributs des utilisateurs.
### Notifications
Vous pouvez configurer Kviklet pour envoyer des notifications vers un canal dans Slack ou Teams. Cela est utile pour informer votre équipe des nouvelles demandes qui doivent être révisées. Vous pouvez configurer cela dans Settings -> General -> Notification Settings.
#### Slack
Pour configurer les notifications Slack, vous devez créer une Slack App et activer les webhooks pour celle-ci. Vous pouvez suivre les instructions ici : https://api.slack.com/messaging/webhooks
#### Teams
Les notifications Teams utilisent un webhook **Workflow** Power Automate. Kviklet envoie une Adaptive Card, que le modèle de webhook publie dans votre canal.
**Recommandé : utiliser le modèle de workflow**
1. Dans Teams, ouvrez le canal dans lequel vous souhaitez recevoir les notifications, cliquez sur **...** à côté du nom du canal et choisissez **Workflows** (ou ajoutez l'application **Workflows**).
2. Recherchez et créez le modèle **« Send webhook alerts to a channel »**.
3. Connectez-vous lorsque cela vous est demandé, puis sélectionnez l'équipe et le canal cibles et créez le workflow.
4. Ouvrez l'étape de déclenchement et copiez l'**HTTP POST URL** générée.
5. Collez l'URL dans Kviklet sous Settings -> General -> Notification Settings et cliquez sur save.
**Alternative : construire le workflow manuellement**
Si vous préférez construire le flux vous-même (ou si le modèle n'est pas disponible) :
1. Canal **...** -> **Workflows** -> créez un flux avec le déclencheur **« When a Teams webhook request is received »**.
2. Ajoutez l'action **Microsoft Teams -> « Post card in a chat or channel »**.
3. Définissez le champ **Adaptive Card** de l'action sur l'expression `string(triggerBody())` afin qu'elle publie la carte envoyée par Kviklet.
4. Sélectionnez l'équipe et le canal cibles, **Save**, puis copiez l'**HTTP POST URL** depuis l'étape de déclenchement.
Actuellement, il existe des notifications pour :
- Les nouvelles Requests, qui nécessitent des approbations
- Les nouvelles approbations sur les demandes
#### Configuration de l'URL de base
Lorsque Kviklet est exécuté derrière un reverse proxy ou un Ingress Kubernetes, les liens de notification peuvent utiliser l'adresse IP interne au lieu de votre domaine public. Kviklet essaie de suivre l'URL correcte en examinant les requêtes entrantes, mais certains reverse proxies ne définissent pas correctement les en-têtes Forwarded. Pour corriger cela, définissez explicitement l'URL de base :```
KVIKLET_BASE_URL=https://kviklet.example.com
Cela garantit que tous les liens de notification pointent vers l'URL publique correcte.
Télémétrie
Kviklet rapporte des statistiques d'utilisation anonymes pour nous aider à comprendre quelles fonctionnalités sont utilisées et où les erreurs se produisent. Pour la désactiver, définissez :``` KVIKLET_TELEMETRY_ENABLED=false
Kviklet journalise une ligne au démarrage indiquant si la télémétrie est activée.

**Ce qui est envoyé.** Chaque événement porte un identifiant d'instance aléatoire (généré une fois et stocké dans la
base de données de Kviklet), l'URL de base à laquelle Kviklet est accessible (voir ci-dessus ; souvent un nom d'hôte interne), et la version de Kviklet. Les utilisateurs sont identifiés uniquement par un identifiant opaque limité à l'instance, ce qui permet de compter les utilisateurs uniques, mais aucune adresse e-mail ni aucun nom n'est jamais envoyé. Les événements exacts et leurs propriétés sont définis dans `backend/src/main/kotlin/dev/kviklet/kviklet/telemetry/TelemetryEvent.kt`.

**Ce qui n'est jamais envoyé.** Requêtes, instructions, résultats, sortie de commande, messages d'erreur, noms de connexion, noms d'hôte, identifiants, titres ou descriptions de requêtes, commentaires, et noms d'utilisateurs ou de rôles.

### Journalisation

Par défaut, Kviklet écrit des journaux lisibles par l'humain (pretty) sur stdout, ce qui est pratique
lorsqu'on les lit directement ou via `docker logs`.

Si vous exportez les journaux vers un système centralisé (Elasticsearch, Loki, Datadog, CloudWatch, …), vous
pouvez passer à des **journaux JSON** structurés, plus faciles à indexer et à interroger. Définissez
le format via une variable d'environnement :```
# One of: ecs (Elastic Common Schema), logstash, gelf (Graylog)
LOGGING_STRUCTURED_FORMAT_CONSOLE=ecs
Chiffrement
Si vous ne souhaitez pas que les identifiants soient stockés en clair dans la base de données, il est recommandé d'activer le chiffrement de la base de données sur la base postgres de Kviklet elle-même. Pour la plupart des hébergeurs, il s'agit d'une simple case à cocher. Néanmoins, si la base de données Kviklet est compromise d'une manière ou d'une autre, il s'agit d'un risque de sécurité majeur. En effet, elle contient les identifiants de base de données pour potentiellement l'ensemble de vos datastores de production. Vous pouvez donc activer le chiffrement des identifiants au repos.
Pour ce faire, il suffit de définir les deux variables d'environnement.``` ENCRYPTION_ENABLED=true ENCRYPTION_KEY_CURRENT=some-secret
Kviklet chiffrera toutes vos informations d'identification existantes au démarrage, et utilisera le secret pour les futures connexions que vous créez.

### Rotation de clé

Si vous souhaitez faire tourner la clé, vous pouvez simplement ajouter une autre variable pour la clé précédente et modifier la clé actuelle :```
ENCRYPTION_KEY_PREVIOUS=some-secret
ENCRYPTION_KEY_CURRENT=another-secret
Kviklet re-chiffrera toutes les connexions au démarrage, afin que vous puissiez ensuite redémarrer le conteneur avec la clé précédente supprimée.
Clés API
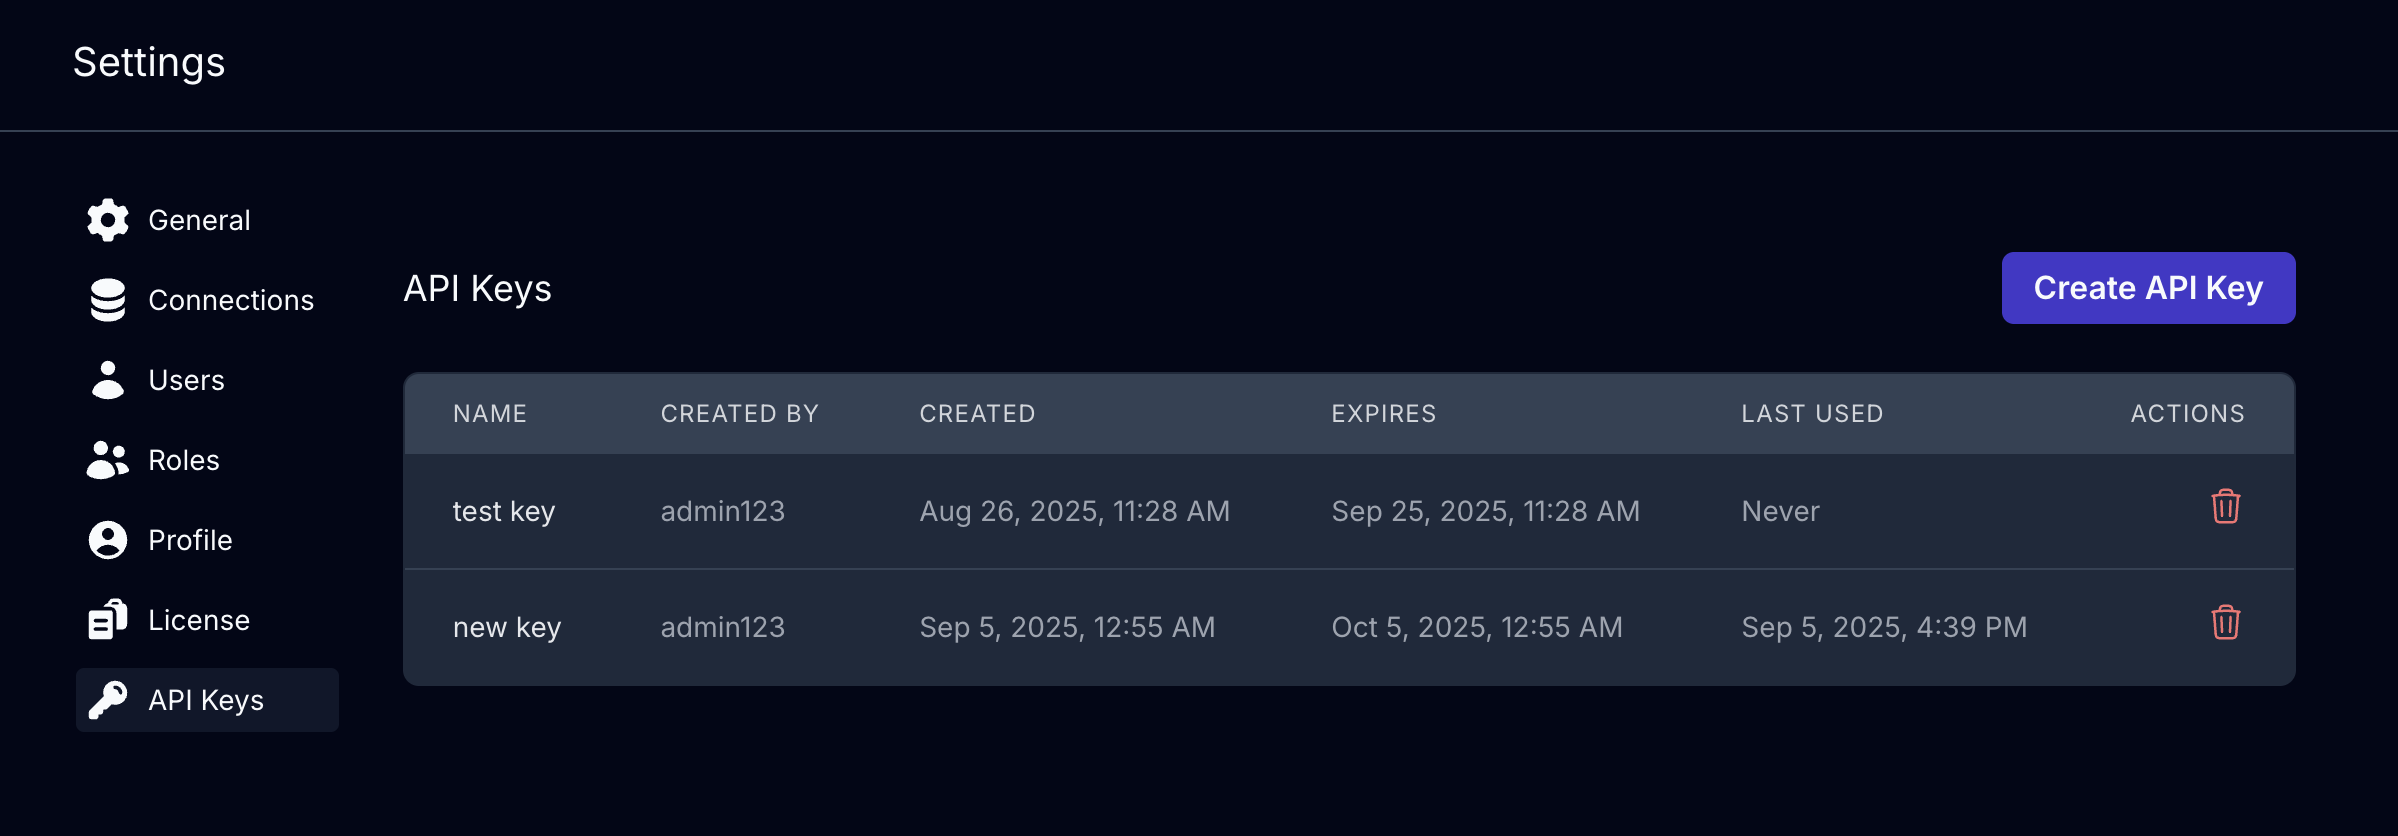
Kviklet prend en charge les clés API pour l'accès programmatique au système. Il s'agit d'une fonctionnalité réservée à l'édition entreprise et nécessite une licence valide. Vous pouvez créer des clés API dans la section Paramètres -> Clés API.
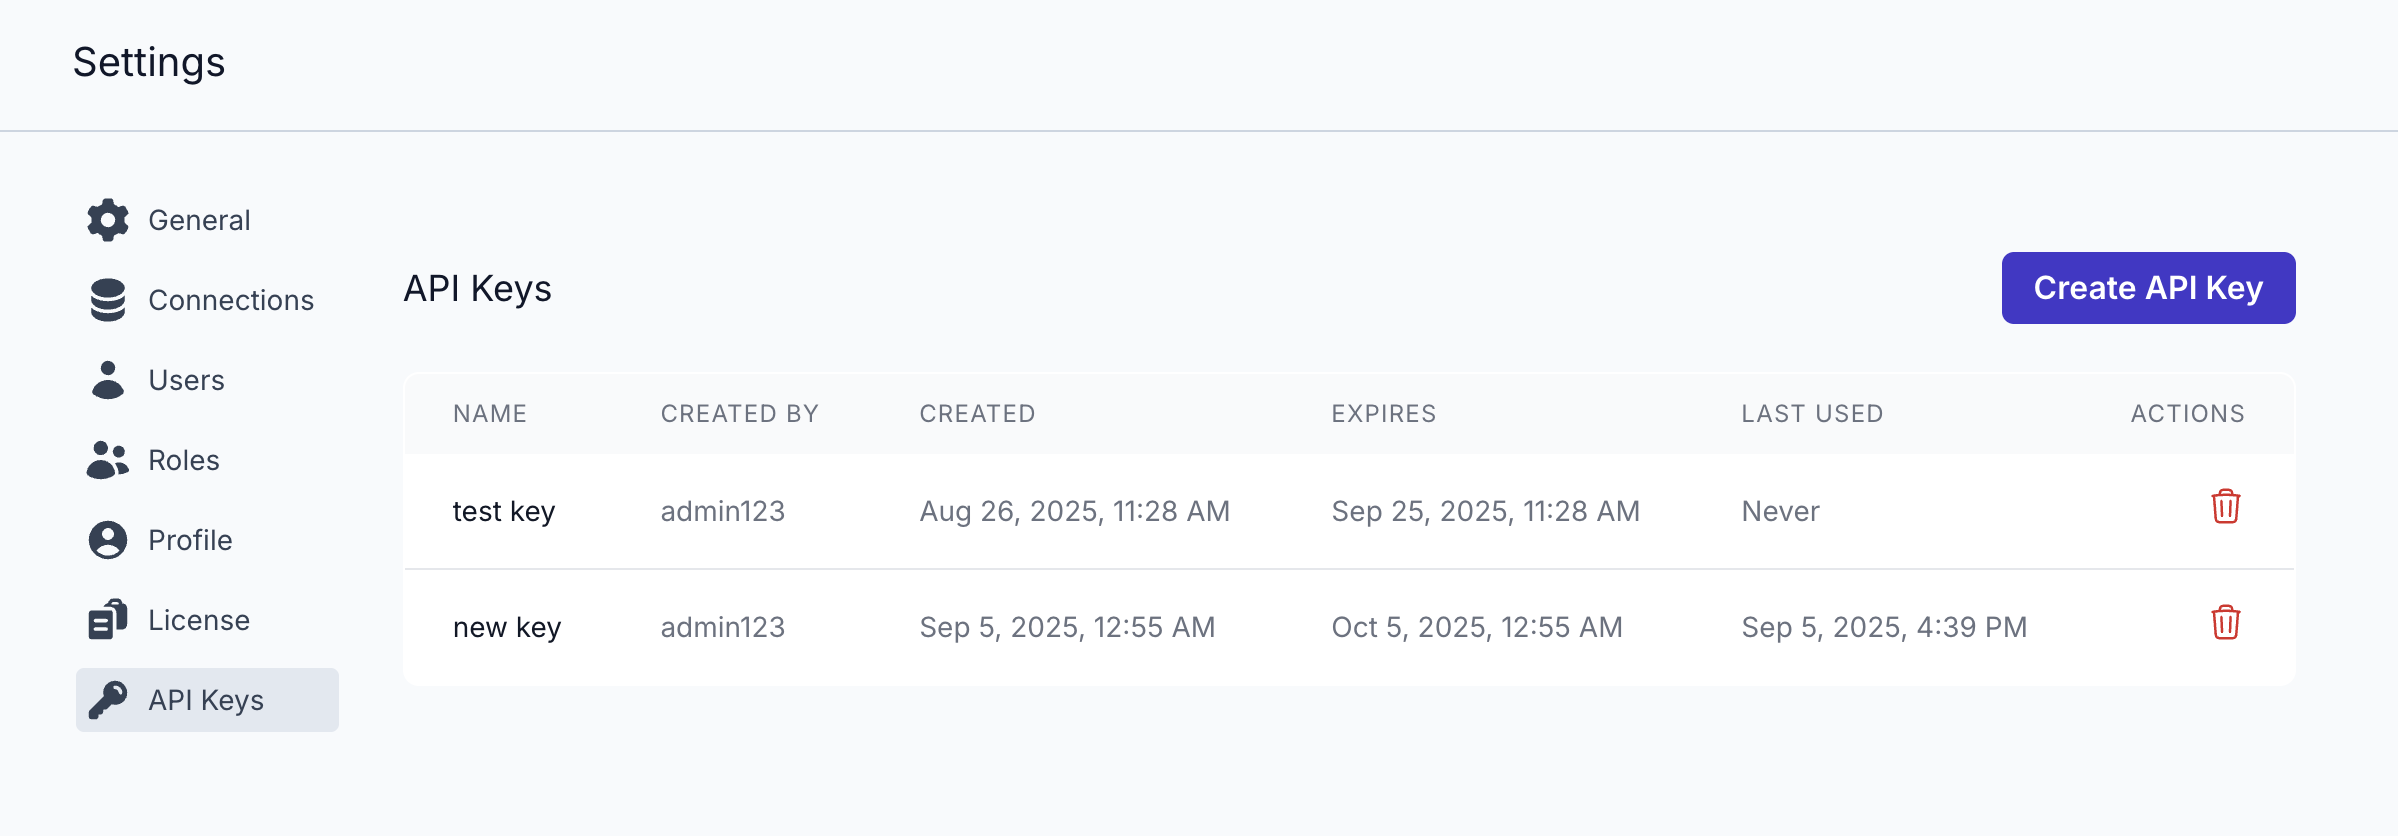

Utilisez-la comme suit :```bash
curl --location '[kviklet_host]/api/connections/'
--header 'Authorization: Bearer your-api-key'
Les clés API héritent des permissions de l'utilisateur qui les crée. Actuellement, seuls les administrateurs peuvent gérer les clés API et toutes les actions effectuées avec une clé API sont attribuées à l'utilisateur qui a créé la clé.
Une documentation API rudimentaire est disponible à l'adresse `[kviklet_host]/api/swagger-ui/index.html`. Mais gardez à l'esprit qu'il s'agit d'un travail en cours et que l'API pourrait changer dans les versions futures.
Au final, la vérité se trouve dans le code, vous pouvez donc toujours consulter le contrôleur pour voir comment l'API est définie. Si vous avez des questions, n'hésitez pas à ouvrir une issue.
## Fonctionnalités expérimentales
Il existe actuellement deux fonctionnalités expérimentales. Elles ont été développées principalement à partir des retours de la communauté. N'hésitez pas à les essayer et à nous faire part de vos commentaires. Nous espérons les développer davantage à l'avenir et les faire fonctionner correctement avec le flux d'approbation principal.
### Kubernetes Exec
Si vous souhaitez utiliser la fonctionnalité Kubernetes Exec, vous devez créer une connexion Kubernetes distincte. Kviklet utilisera l'utilisateur du pod déployé pour exécuter la commande. Assurez-vous donc que cet utilisateur dispose des permissions nécessaires pour exécuter des commandes sur les pods auxquels vous souhaitez accéder.
Kviklet utilise également /bin/sh pour exécuter la commande, vous devrez donc vous assurer que vos pods disposent d'un shell ou au moins d'un lien symbolique dans /bin/sh. Si cela vous pose problème, n'hésitez pas à ouvrir une issue, nous pourrons potentiellement rendre cela configurable ou trouver une autre solution.
Les commandes Kubernetes n'attendent que 5 secondes pour la sortie ; si la commande prend plus de temps, Kviklet attendra jusqu'à une heure avant d'expirer la commande. Il s'agit d'une solution provisoire, nous étudions les websockets pour rendre cela plus réactif et potentiellement permettre des sessions terminal.
### Proxy - Postgres, MariaDB, MySQL (Enterprise)
Si vous créez des demandes d'accès temporaire, vous pouvez - au lieu d'utiliser l'interface web - exécuter vos requêtes via un proxy géré par kviklet et utiliser le client de base de données de votre choix.
Le proxy est une fonctionnalité enterprise : il nécessite une licence valide, et un administrateur doit en plus l'activer dans Settings -> General -> Database Proxy.
Pour cela, le conteneur écoute sur des ports stables (5432 et 3306 par défaut, configurables via `kviklet.proxy.postgres.port` et `kviklet.proxy.mysql.port`), vous devez donc exposer ces ports.
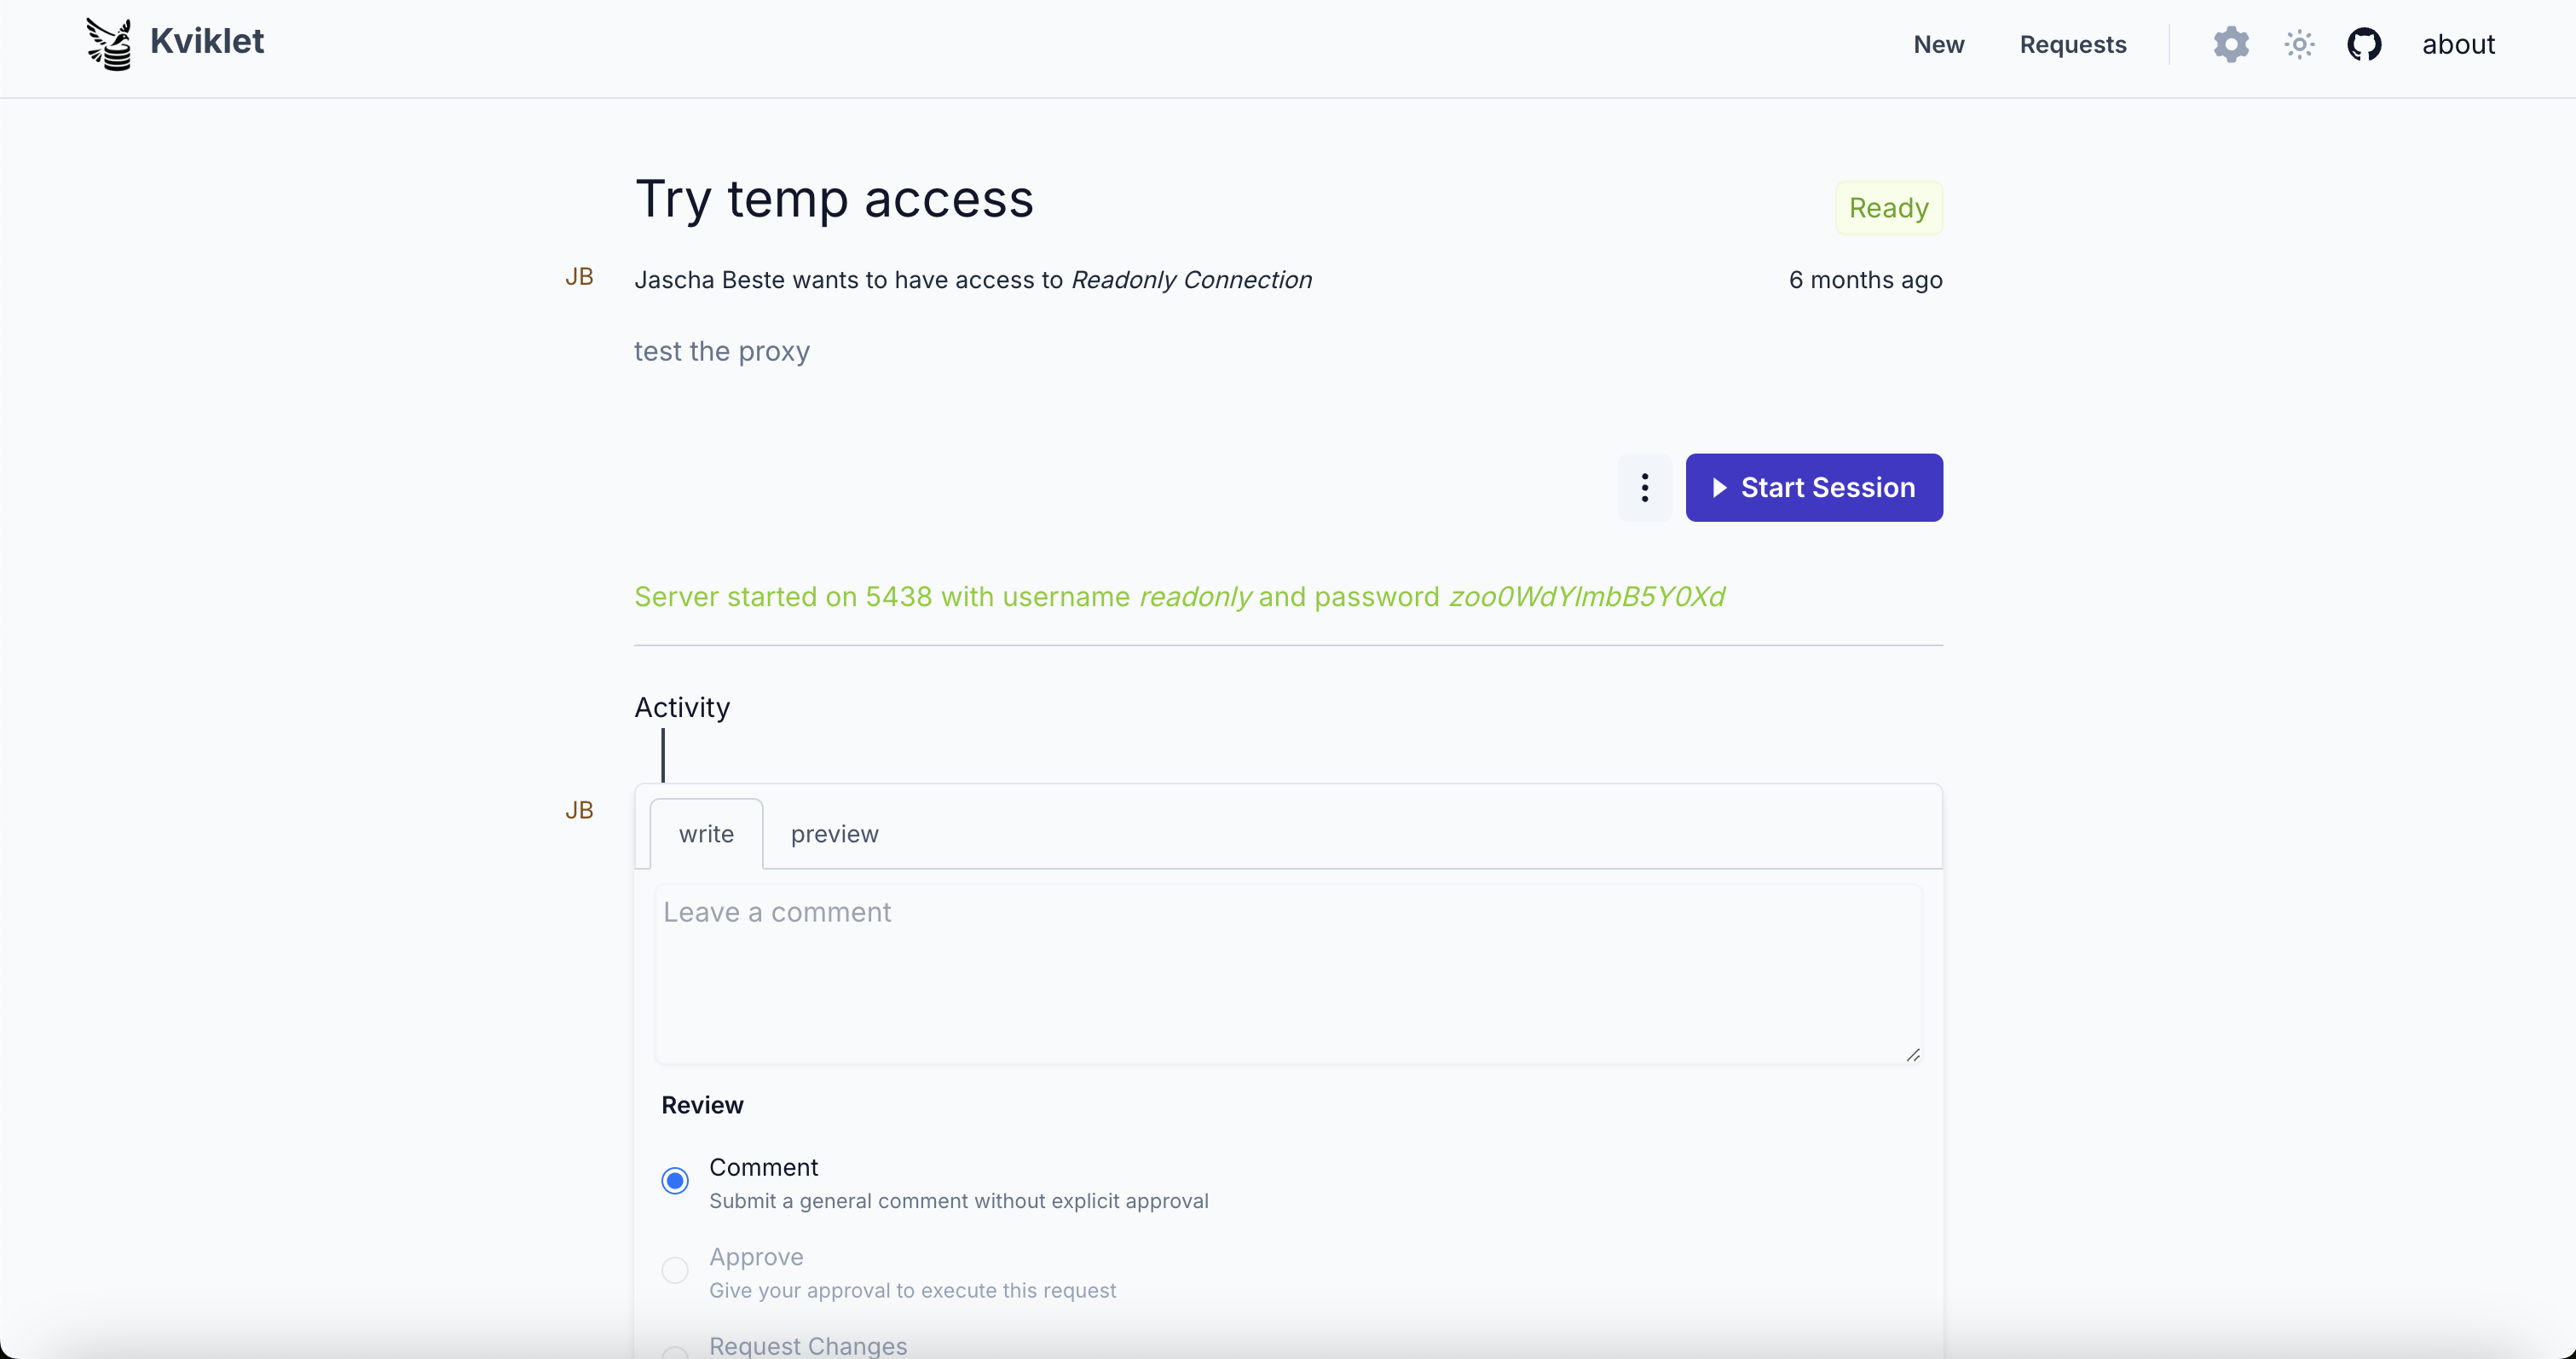
Les utilisateurs peuvent ensuite créer une demande d'accès temporaire et cliquer sur « Start Proxy » une fois celle-ci approuvée. Chaque demande obtient un nom d'utilisateur et un mot de passe temporaires ; Kviklet route chaque connexion vers sa demande en fonction du nom d'utilisateur. Avec ceux-ci, ils peuvent se connecter à la base de données. Kviklet valide l'utilisateur temporaire et le mot de passe et proxyfie toutes les requêtes vers l'utilisateur sous-jacent sur la base de données. Toutes les instructions exécutées sont enregistrées dans le journal d'audit comme si elles avaient été exécutées via l'interface web.
Remarque : le proxy ne prend actuellement pas en charge le suivi des résultats. Ainsi, les instructions exécutées sont enregistrées mais pas les résultats ni si une instruction réussit ou échoue.

#### Proxy - TLS
Kviklet termine la connexion TLS vers la base de données. Cela signifie que par défaut, tout trafic depuis et vers le proxy lui-même n'est pas chiffré.
Si vous souhaitez que kviklet rechiffre le trafic, vous pouvez fournir à Kviklet un certificat TLS et une clé pour le proxy en définissant les variables d'environnement suivantes :```
PROXY_TLS_CERTIFICATE_SOURCE=env
PROXY_TLS_CERTIFICATE_CERT=your-certificate
PROXY_TLS_CERTIFICATE_KEY=your-key
alternativement, vous pouvez utiliser des fichiers :``` PROXY_TLS_CERTIFICATE_SOURCE=file PROXY_TLS_CERTIFICATE_CERT_FILE=path/to/cert.pem PROXY_TLS_CERTIFICATE_KEY_FILE=path/to/key.pem
Dans les deux cas, le certificat et la clé doivent être stockés au [format pem](https://en.wikipedia.org/wiki/Privacy-Enhanced_Mail).

## Questions ? Contributions ?

Si vous avez des questions, souhaitez donner votre avis ou avez besoin d'aide pour la configuration, rejoignez notre [communauté Discord](https://discord.gg/7SmPJfeP6e). Vous pouvez également créer une [issue GitHub](https://github.com/kviklet/kviklet/issues) pour signaler des bugs et demander des fonctionnalités.

Si vous souhaitez contribuer, n'hésitez pas à forker et à créer des PR pour de petites choses. Si vous prévoyez des fonctionnalités plus importantes, j'apprécierais une discussion en amont dans une issue GitHub ou sur Discord.

Vous pouvez également me contacter à [email protected].