
vc5 v0.3.4
Un équilibreur de charge de couche 4 horizontalement évolutif avec retour direct du serveur (DSR) pour Linux, utilisant XDP/eBPF.
VC5
Ce README est actuellement en cours de mise à jour pour refléter les changements récents – certaines informations peuvent ne pas correspondre au code actuel. Cette itération du code n'est pas encore prête pour une utilisation en conditions réelles – utilisez une version v0.2 pour la production
Un équilibreur de charge de couche 4 (L4LB) pour Linux, horizontalement évolutif, à retour direct du serveur (DSR), utilisant XDP/eBPF.
Si vous pensez que cela peut être utile ou si vous avez des questions/suggestions, n'hésitez pas à me contacter à [email protected] ou à ouvrir une issue GitHub.
Prend désormais en charge IPv6 et la distribution en couche 3 (alias tunnellisation) ! La bibliothèque XVS a été mise à jour pour inclure ces fonctionnalités et élimine également la nécessité d'exécuter les contrôles de santé depuis un espace de noms réseau, ce qui simplifie considérablement le code. Cela mettra fin à l'exigence selon laquelle tous les backends partagent un VLAN avec l'équilibreur de charge.
Les restrictions actuelles du code signifient que l'activation de la tunnellisation sur une
base par service n'est pas prise en charge. L'utilisation de l'option -tunnel permet
d'activer globalement une tunnellisation de couche 3 à l'aide d'un seul schéma
(IP-in-IP, GRE, FOU ou GUE). À l'avenir, le code sera mis à jour
pour permettre de configurer la tunnellisation au niveau du service.
L'équilibrage de charge de couche 2 continuera d'être pris en charge – la raison principale du lancement du projet était l'absence de prise en charge de la couche 2 par l'équilibreur de charge Katran de Facebook.
Un exemple de fichier de configuration IPv6/L3 est inclus – une meilleure documentation suivra.
À propos
VC5 est un équilibreur de charge réseau conçu pour remplacer les
anciennes appliances matérielles. Il permet de distribuer des services dotés d'adresses
IP virtuelles (VIP) vers des ensembles de serveurs backend (« réels »).
Les serveurs réels peuvent exécuter les services eux-mêmes ou agir comme
proxys pour une autre couche de serveurs (par ex. HAProxy servant de routeur HTTP de couche 7 /
déchargement SSL lorsque des décisions de niveau applicatif doivent être
prises). La seule exigence étant que les VIP doivent être configurées sur un
périphérique loopback de chaque serveur réel, par ex. : ip addr add 192.168.101.1/32 dev lo
Les services et les serveurs réels sont spécifiés dans un fichier de configuration, ainsi que les définitions des contrôles de santé. Lorsque les serveurs backend réussissent les contrôles et qu'ils sont suffisamment disponibles pour fournir un service, les adresses IP virtuelles sont annoncées aux routeurs via BGP.
La distribution du trafic en couche 2 comme en couche 3 est désormais prise en charge. La distribution en couche 2 exige que les serveurs réels partagent un VLAN avec l'équilibreur de charge ; à la réception d'un paquet à distribuer, l'équilibreur de charge met à jour les adresses matérielles Ethernet du paquet pour utiliser l'adresse MAC du serveur réel comme destination et sa propre adresse MAC comme source, puis transmet le paquet via l'interface appropriée, en mettant à jour l'ID VLAN 802.1Q si les paquets sont tagués VLAN.
La distribution en couche 3 exige que les paquets soient encapsulés dans un protocole de tunnellisation adressé à l'IP du serveur réel et transmis via un routeur (sauf si le serveur et l'équilibreur de charge partagent un VLAN). Si, une fois encapsulé, un paquet dépasse la taille maximale de transmission du réseau, un message ICMP est envoyé à la source avec une recommandation sur la MTU appropriée à utiliser. Les serveurs backend n'ont besoin que de décapsuler les paquets – la tunnellisation bidirectionnelle avec les équilibreurs de charge n'est pas requise.
Un serveur doté d'une interface réseau 10 Gbit/s devrait être capable de prendre en charge un service HTTP avec une bande passante sortante supérieure à 100 Gbit/s, en raison de la nature asymétrique de la plupart du trafic Internet. Pour des services plus petits, une ou deux machines virtuelles modestes suffiront probablement pour un service générant plusieurs gigabit/s de trafic sortant.
Si une instance ne suffit pas, d'autres serveurs peuvent être ajoutés pour faire évoluer la capacité horizontalement (et fournir une redondance) à l'aide de la fonctionnalité ECMP de votre routeur. Les interfaces agrégées 802.3ad et le trunking VLAN 802.1Q sont pris en charge (voir le répertoire examples/).
Aucun module noyau ni configuration complexe n'est requis, bien que pour des performances optimales, un pilote de carte réseau avec prise en charge du mode natif XDP soit recommandé (par ex. : mlx4, mlx5, i40e, ixgbe, ixgbevf, nfp, bnxt, thunder, dpaa2, qede). Une liste complète est disponible sur la page de prise en charge des pilotes du projet XDP.
Objectifs/état d'avancement
- ✅ Déploiement simple avec un seul binaire
- ✅ Sélection stable des backends avec l'algorithme de hachage Maglev
- ✅ Injection de la route de santé gérée automatiquement ; aucun besoin d'exécuter d'autre logiciel tel qu'ExaBGP
- ✅ Minimalement invasif ; ne nécessite aucune modification des règles iptables sur l'équilibreur
- ✅ Aucune modification des serveurs backend au-delà de l'ajout de la VIP à un périphérique loopback/terminaison de tunnel avec la distribution L3
- ✅ Les contrôles de santé sont effectués sur la VIP des serveurs backend, et non sur leurs adresses réelles
- ✅ Contrôles de santé HTTP/HTTPS, sonde SYN semi-ouverte et DNS UDP/TCP intégrés
- ✅ Commutation de paquets dans le noyau avec eBPF/XDP ; les pilotes en mode natif évitent l'allocation de sk_buff
- ✅ Prise en charge de plusieurs VLAN
- ✅ Prise en charge de plusieurs NIC pour les applications à plus faible bande passante/de développement
- ✅ Périphériques réseau tagués/agrégés pour la haute disponibilité/haute bande passante
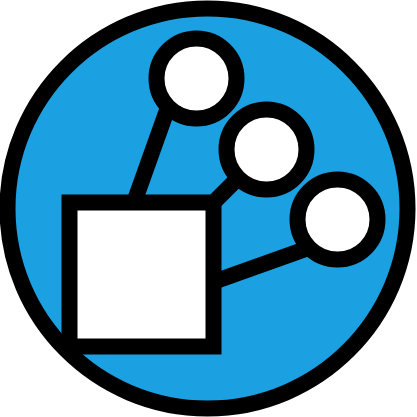
- ✅ Observabilité via une console web, la journalisation Elasticsearch (en développement) et les métriques Prometheus
- ✅ Prise en charge IPv6 et possibilité de mélanger des backends IPv4 et IPv6 avec l'un ou l'autre type de VIP.
- ✅ Distribution du trafic en couche 3 avec prise en charge d'IP-in-IP, GRE, FOU et GUE.
Démarrage rapide
Pour de meilleurs résultats, vous devriez désactiver/désinstaller irqbalance.
Vous devrez sélectionner une IP principale à passer à l'équilibreur. Elle est utilisée comme ID de routeur BGP.
Un exemple simple sur un serveur avec une seule interface Ethernet non taguée :