bbot v3.0.0
Le scanner internet récursif pour les hackers. 🧡




BEE·bot est un scanner polyvalent inspiré par Spiderfoot, conçu pour automatiser vos missions de Recon, de Bug Bounty et votre ASM !
https://github.com/blacklanternsecurity/bbot/assets/20261699/e539e89b-92ea-46fa-b893-9cde94eebf81
Un scan BBOT en temps réel - visualisation avec VivaGraphJS
Installation
# stable version
pipx install bbot

# bleeding edge (dev branch)
pipx install --pip-args '\--pre' bbot
Pour plus de méthodes d'installation, notamment Docker, consultez Getting Started
Vous migrez depuis la 2.x ? BBOT 3.0 contient des changements majeurs dans la CLI, les presets, les modules, les événements et l'API Python. Consultez le guide de migration 2.x → 3.0 (source) avant de mettre à niveau.
Conseil de rapidité : le résolveur DNS de BBOT (blastdns) lance plusieurs threads par résolveur dans
/etc/resolv.conf. Ajouter davantage de résolveurs non filtrés accélère considérablement les scans. Voir l'exemple de resolv.conf et Tips and Tricks pour plus de détails.
Exemples de commandes
1) Découverte de sous-domaines
Sources API passives ainsi qu'un brute-force DNS récursif avec des mutations de sous-domaines spécifiques à la cible.
# find subdomains of evilcorp.com
bbot -t evilcorp.com -p subdomain-enum

# passive sources only
bbot -t evilcorp.com -p subdomain-enum -rf passive
subdomain-enum.yml
description: Enumerate subdomains via APIs, brute-force

flags:
  # enable every module with the subdomain-enum flag
  - subdomain-enum

output_modules:
  # output unique subdomains to TXT file
  - subdomains

config:
  dns:
    threads: 25
    brute_threads: 1000
  # put your API keys here
  # modules:
  #   github:
  #     api_key: ""
  #   chaos:
  #     api_key: ""
  #   securitytrails:
  #     api_key: ""
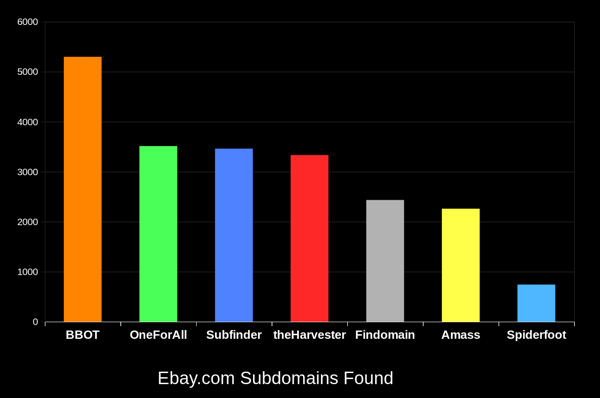
BBOT trouve systématiquement 20 à 50 % de sous-domaines en plus que les autres outils. Plus le domaine est gros, plus l'écart est grand. Pour comprendre comment c'est possible, voir How It Works.
2) Spider Web
# crawl evilcorp.com, extracting emails and other goodies
bbot -t evilcorp.com -p spider
spider.yml
description: Recursive web spider

modules:
  - http

blacklist:
  # Prevent spider from invalidating sessions by logging out
  - "RE:/.*(sign|log)[_-]?out"

config:
  web:
    # how many links to follow in a row
    spider_distance: 2
    # don't follow links whose directory depth is higher than 4
    spider_depth: 4
    # maximum number of links to follow per page
    spider_links_per_page: 25
3) Collecteur d'e-mails
# quick email enum with free APIs + scraping
bbot -t evilcorp.com -p email-enum

# pair with subdomain enum + web spider for maximum yield
bbot -t evilcorp.com -p email-enum subdomain-enum spider
email-enum.yml
description: Enumerate email addresses from APIs, web crawling, etc.

flags:
  - email-enum

output_modules:
  - emails
4) Scanner Web
# run a light web scan against www.evilcorp.com
bbot -t www.evilcorp.com -p web

# run a heavy web scan against www.evilcorp.com
bbot -t www.evilcorp.com -p web-heavy
web.yml
description: Quick web scan

include:
  - iis-shortnames

flags:
  - web
web-heavy.yml
description: Aggressive web scan

include:
  # include the web preset
  - web

flags:
  - web-heavy
5) Tout, partout, à la fois
# everything everywhere all at once
bbot -t evilcorp.com -p kitchen-sink

# roughly equivalent to:
bbot -t evilcorp.com -p subdomain-enum cloud-enum code-enum email-enum spider web paramminer webbrute web-screenshots
kitchen-sink.yml
description: Everything everywhere all at once

include:
  - subdomain-enum
  - cloud-enum
  - code-enum
  - email-enum
  - spider
  - web
  - paramminer
  - webbrute
  - web-screenshots
  - baddns-heavy

config:
  modules:
    dnsbrute:
      recursive_mutations: true
    dnscommonsrv:
      recursive_mutations: true
    webbrute:
      avoid_wafs: False
    wayback:
      urls: True
      parameters: True
      archive: True
Comment ça marche
Cliquez sur le graphique ci-dessous pour explorer les rouages internes de BBOT.