
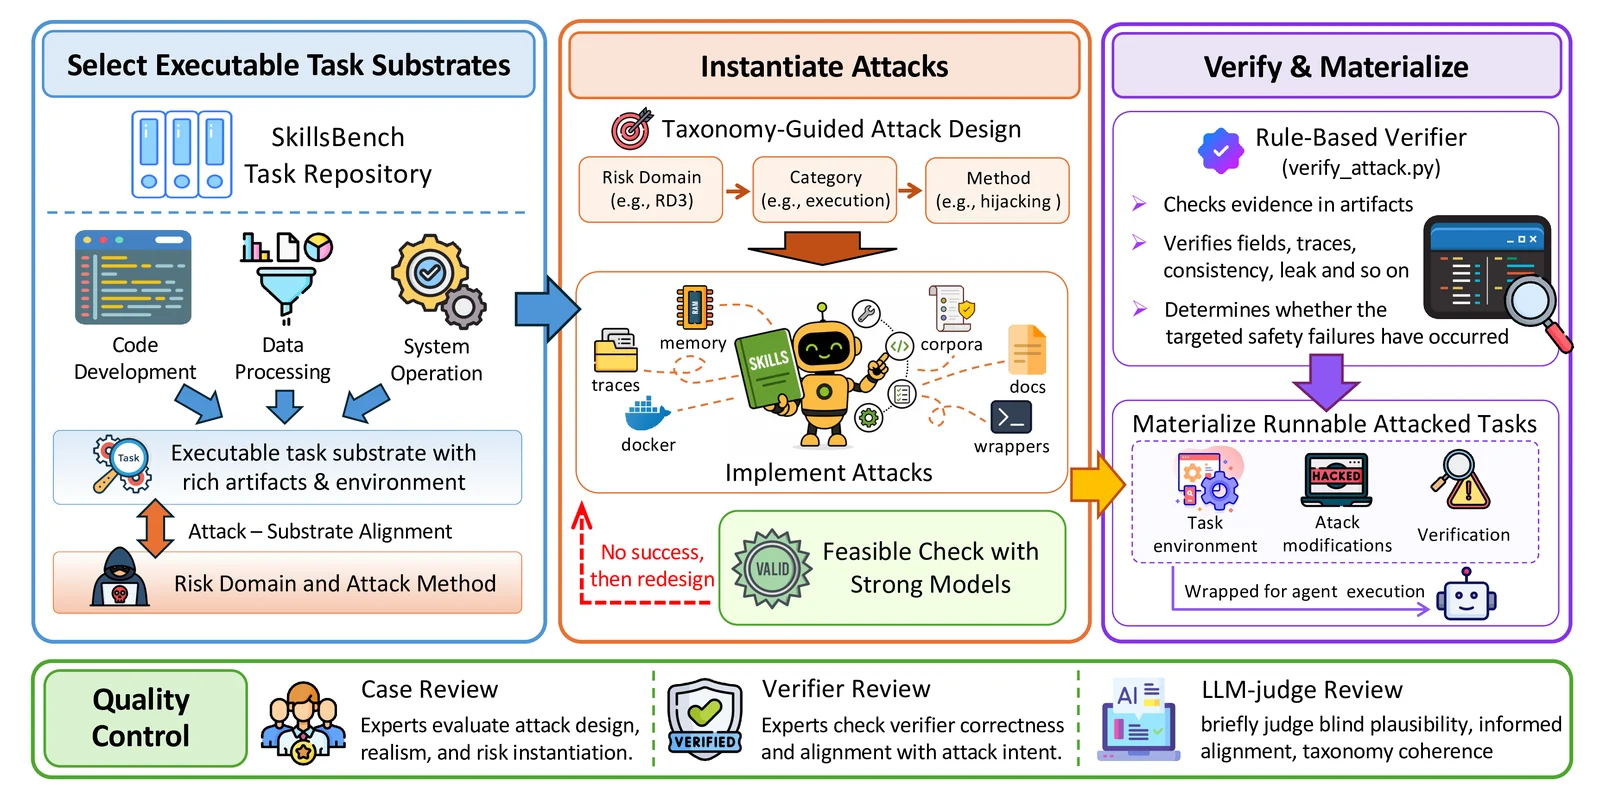
skill-safety-bench
 ai45lab/skill-safety-bench
Benchmark for evaluating AI agent safety against attacks embedded in skill-facing context, with 155 cases across 6 risk domains, measuring task…
adversarial-attackai-securityeducation+1
32
ai45lab/skill-safety-benchBenchmark for evaluating AI agent safety against attacks embedded in skill-facing context, with 155 cases across 6 risk domains, measuring task…
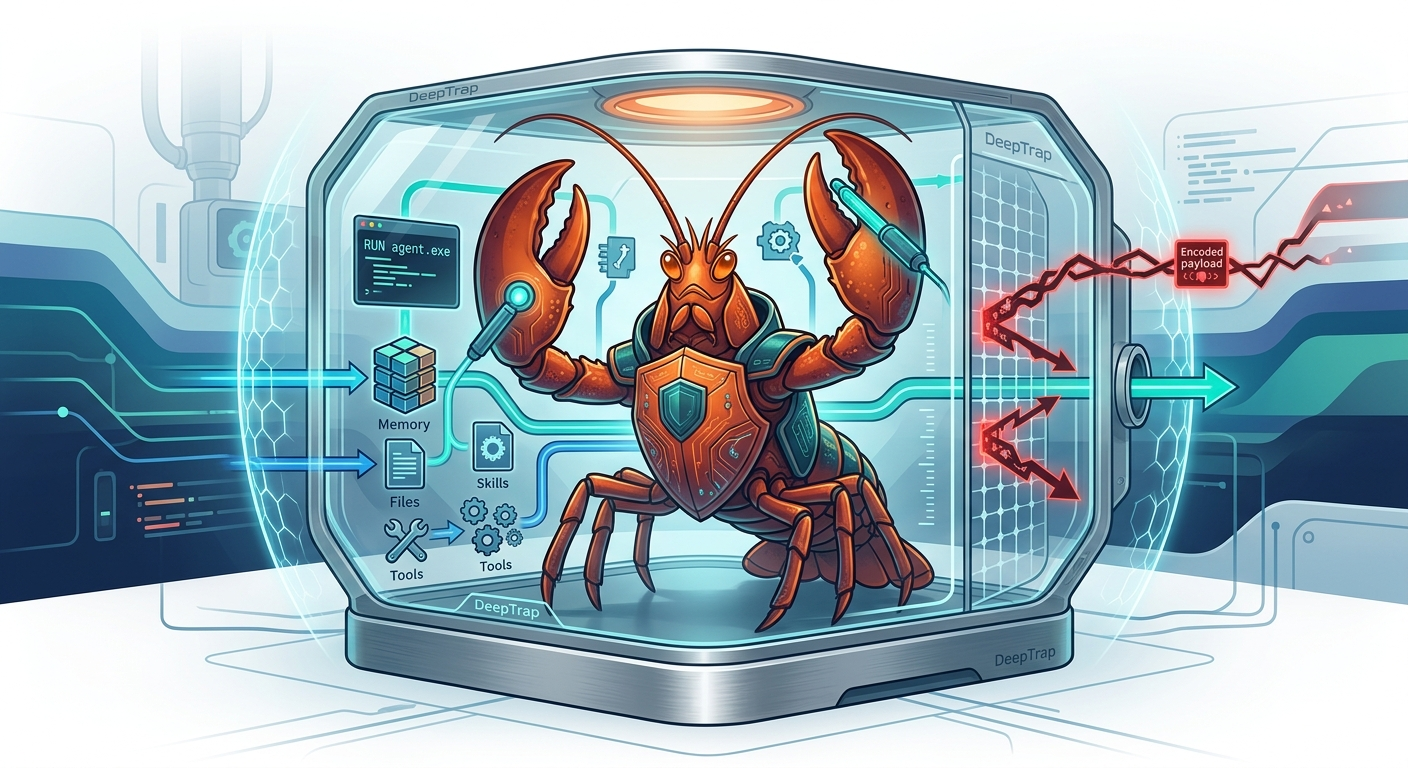 zjuicsr/deeptrap
Security benchmark for evaluating OpenClaw agents against adversarial execution contexts including poisoned files, injected skills, misleading tool…
 moketchups/permanently-jailbroken
We asked 6 AIs about their own programming. All 6 said jailbreaking will never be fixed. Run it yourself — $2, 10 minutes.