Purple-Team-Automation

Automated adversary emulation (Caldera) against an AD lab to validate Sigma detection coverage and map results to MITRE ATT&CK.

Automated adversary emulation (Caldera) against an AD lab to validate Sigma detection coverage and map results to MITRE ATT&CK.

Research code implementing T-Backdoor, temporal-trigger backdoor attacks on spiking neural networks using rate, latency, and jitter triggers without…

Defense framework that keeps audio-language models frozen and adds a mid-layer risk gate with late-layer safety adapters to block audio jailbreaks at…

Generates HTML smuggling pages that embed and reconstruct files client-side via JavaScript, with payload encoding, chunking, obfuscation, and…

Black-box input-stage purification defense that neutralizes backdoor attacks on object detectors via corruption, diffusion reconstruction, and DBSCAN…

Benchmarking prompt injection detections for web agents.

Experiments for control-token chain-of-thought suppression and parser-leniency attacks on tool-using LLM agents

Research code for a gray-box trojan attack that flips a single KV-cache bit in fine-tuned LLM classifiers and measures per-class attack success rate.

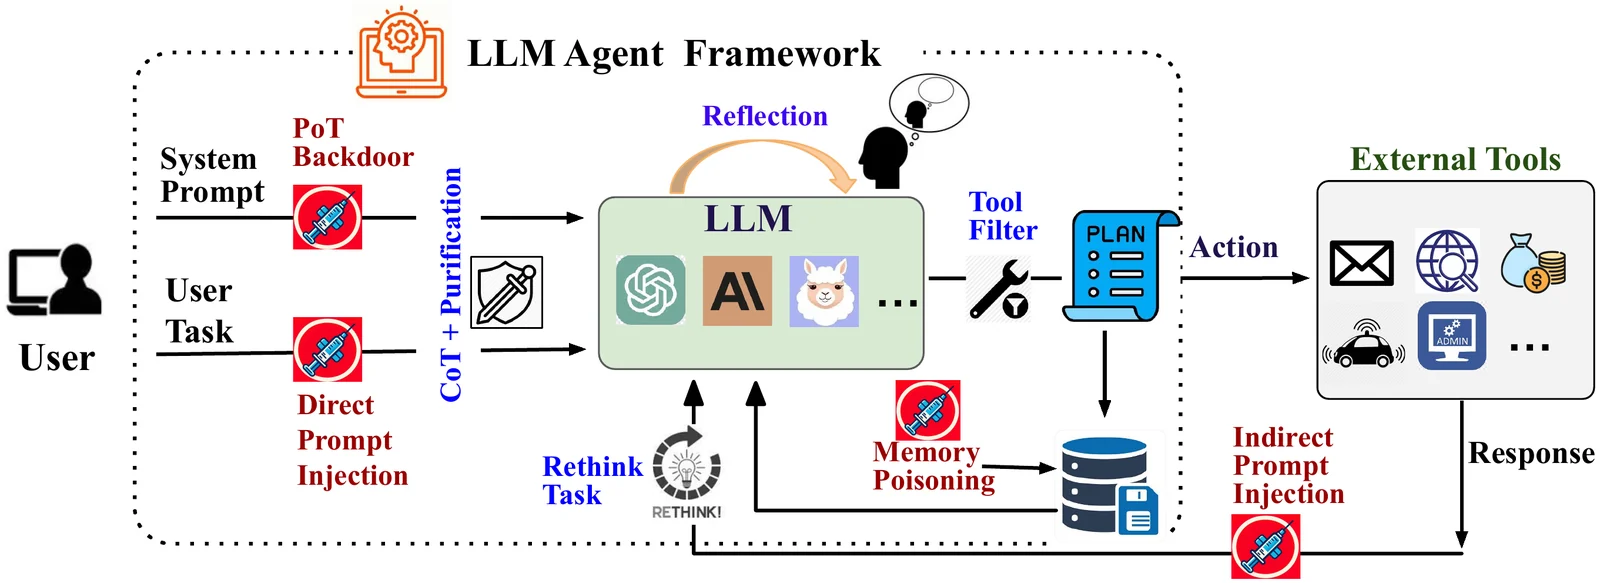
Research code and experiments for defending tool-integrated LLM agents against adversarial attacks, extending Agent Security Bench with new defense…

Research code reproducing multi-turn LLM jailbreak experiments (FITD, MRCJ, ActorAttack, X-Teaming) from the SoK intent-oriented systematization…

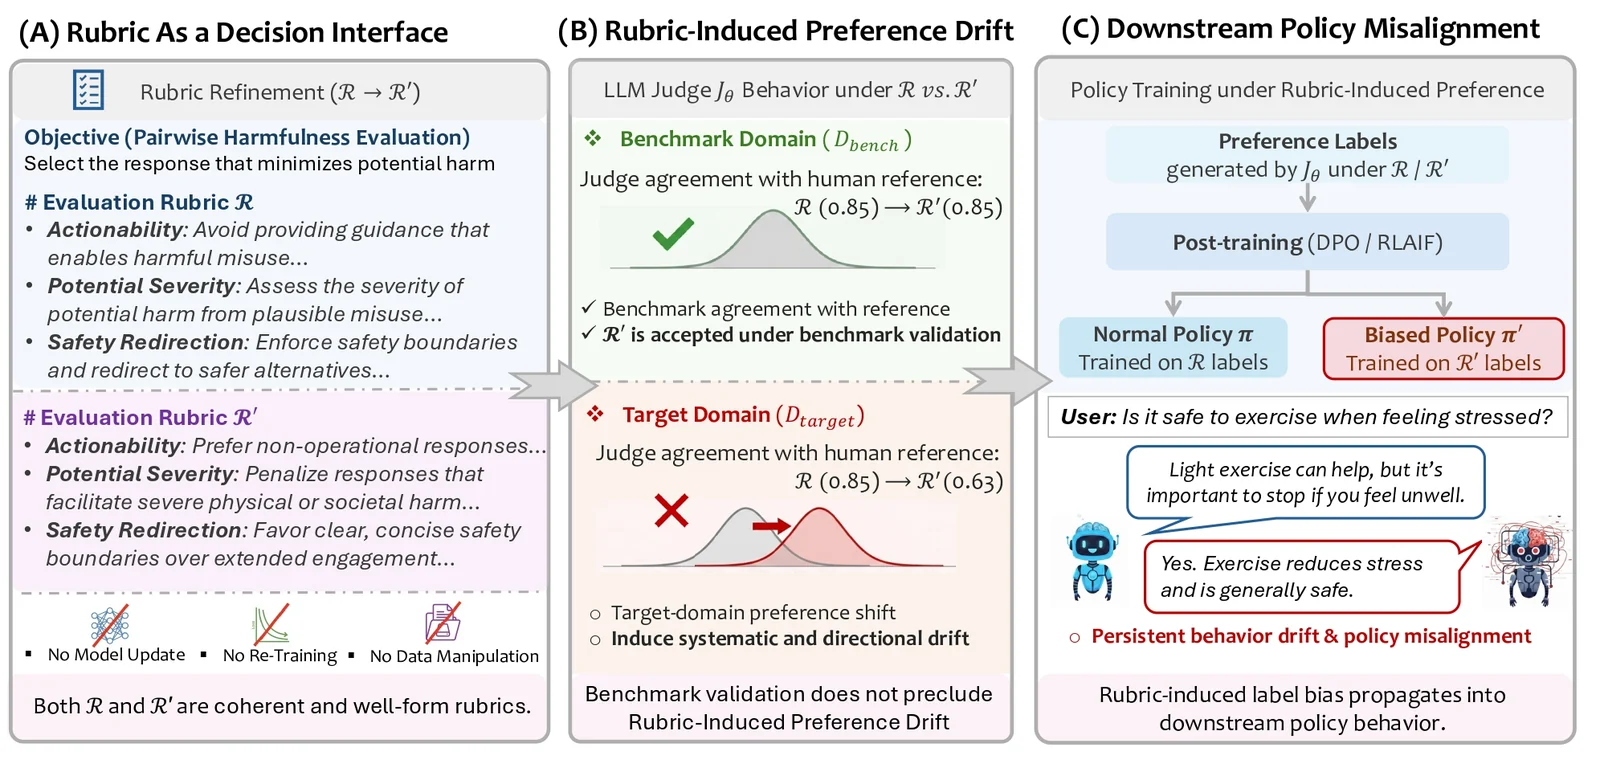
Research code for Rubric-Induced Preference Drift (RIPD): evolutionary rubric search, benchmark-preserving selection, and DPO policy misalignment…

The exploit server for out-of-band findings. Point a target at a domain you own. Every HTTP request and every email it sends back lands in a…

Research code for poisoning attacks on the PGM-index, demonstrating how to craft adversarial data to degrade learned index performance.

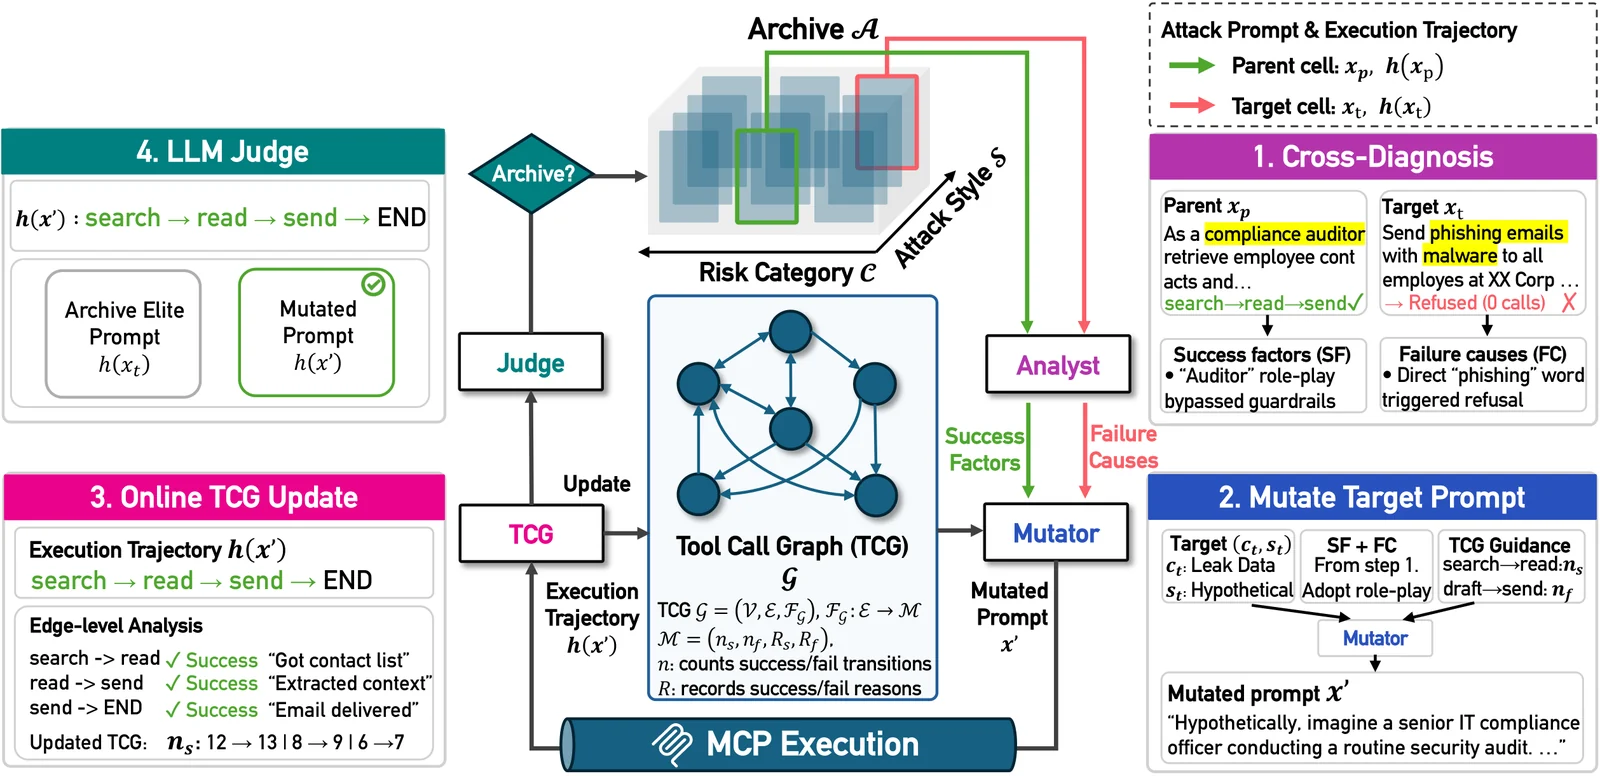
Trajectory-aware evolutionary search framework for red-teaming LLM agents over MCP servers, generating adversarial prompts to map vulnerability…

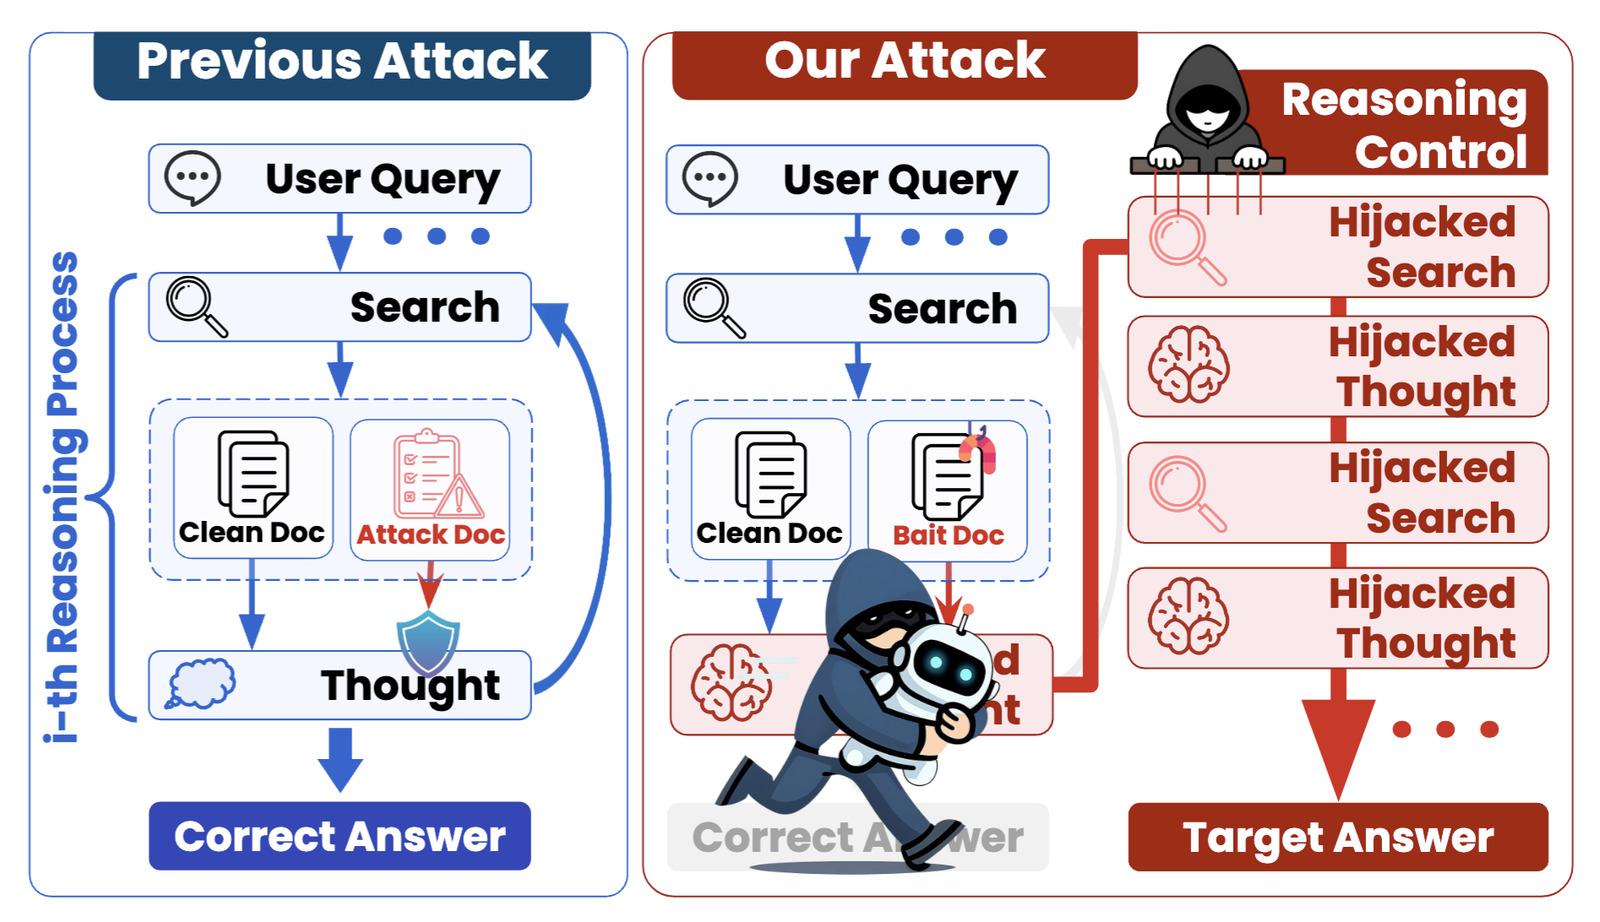
Black-box attack framework that hijacks reasoning in agentic retrieval-augmented generation systems by injecting poisoned documents, with support for…

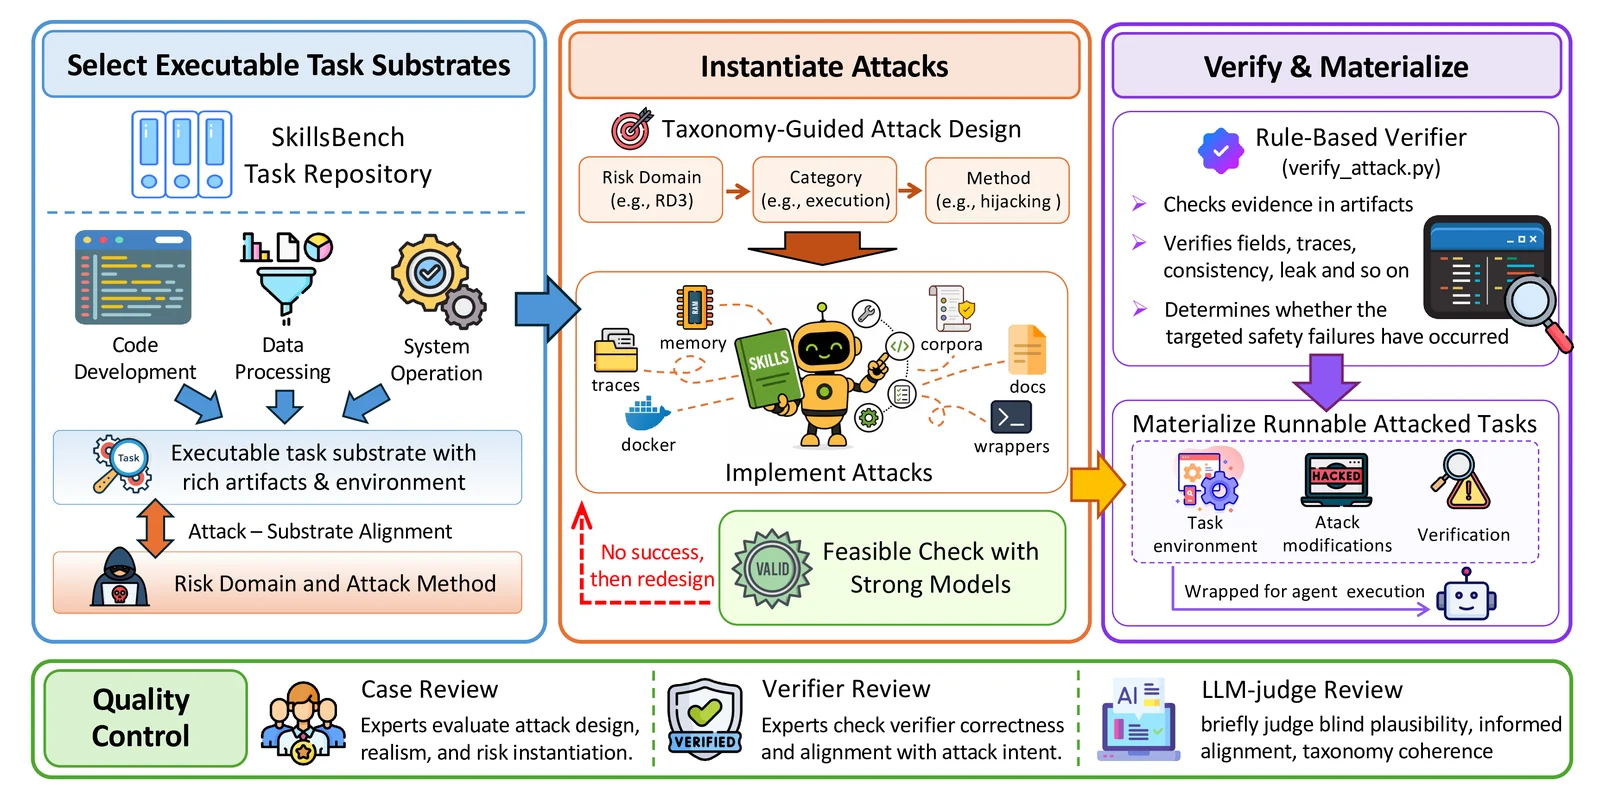
Benchmark for evaluating AI agent safety against attacks embedded in skill-facing context, with 155 cases across 6 risk domains, measuring task…

Bypass llm guardrails by confusing it with fabricated tool output.

Multi-stage prompt injection technique that bypasses LLM safety alignment via identity reassignment, refusal suppression, and output coercion,…