
 zju-llm-safety/ascent
إطار عمل للضبط الدقيق يطبّق معايرة أمان مثلى من الدرجة الأولى وإعادة معايرة دورية على النماذج اللغوية الكبيرة، مع الحفاظ على التحديثات المتوافقة مع الأمان وتحسين فائدة المهام اللاحقة.

الضبط الدقيق الأمثل من الدرجة الأولى مع إعادة المعايرة لتعزيز السلامة والفائدة معًا
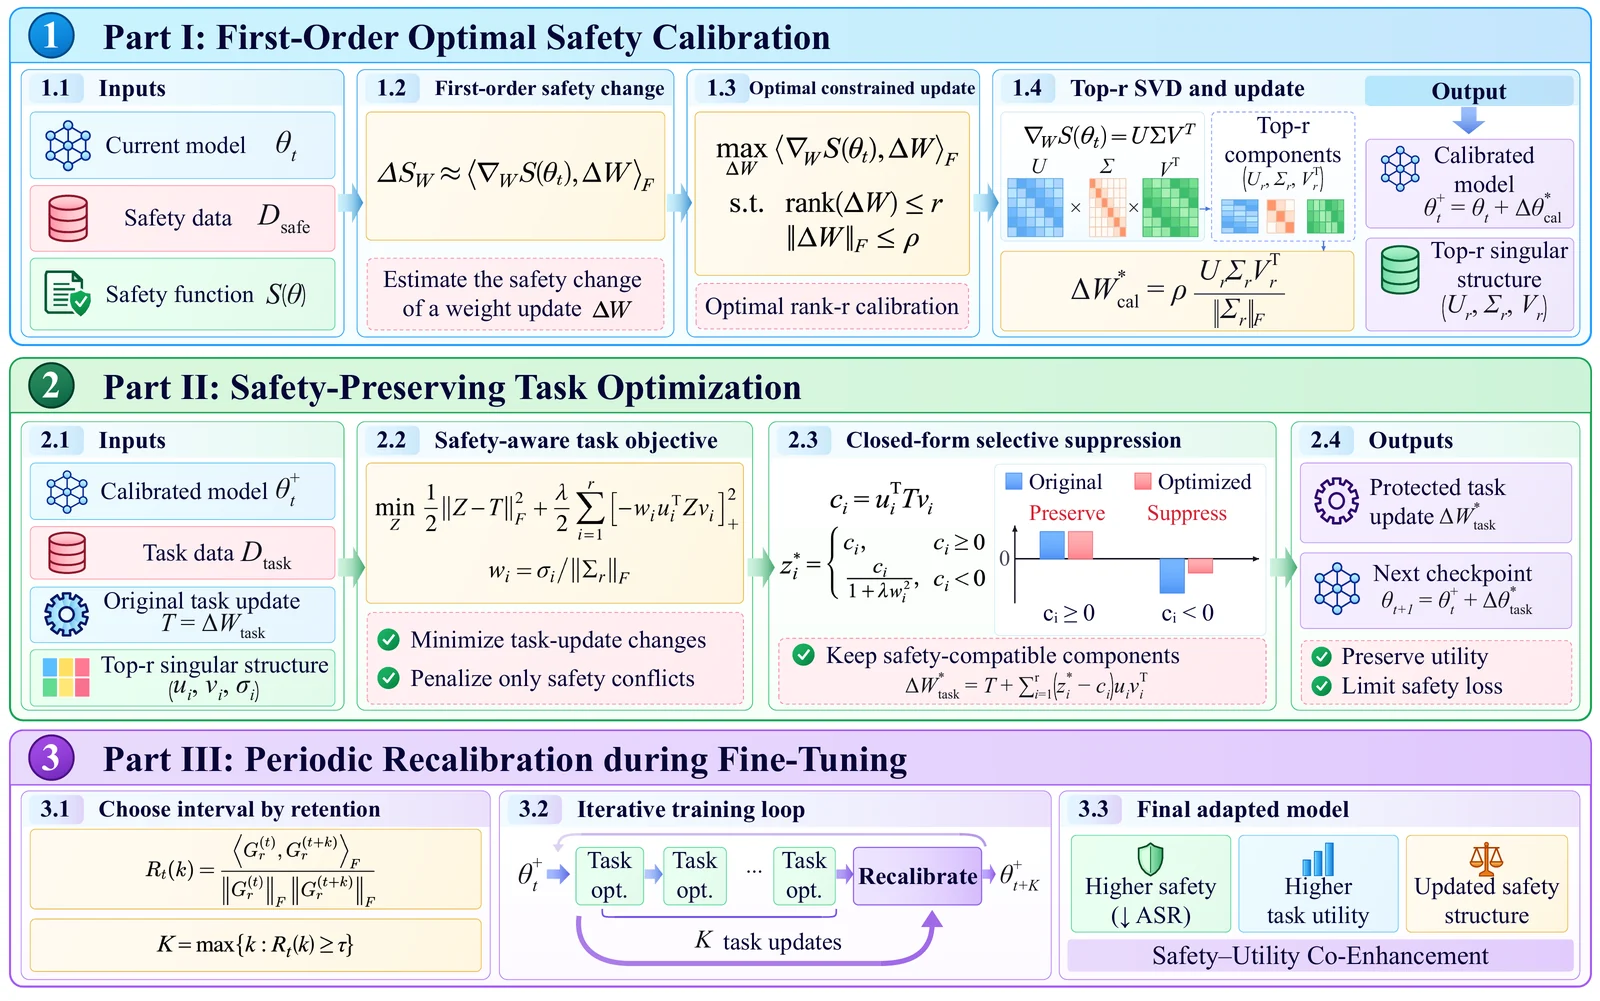
يستخلص ASCENT تحديث معايرة السلامة الأمثل من الدرجة الأولى والبنية المرتبطة بالسلامة المقابلة، ويحسّن تحديثات المهام اللاحقة للحفاظ على المكونات المتوافقة مع السلامة مع كبح المكونات المُضِرّة بالسلامة، ويعيد معايرة هذه البنية بشكل دوري أثناء الضبط الدقيق لتحسين السلامة والفائدة اللاحقة معًا.
الطريقة · البدء السريع · البيانات · الإعدادات · التقييم
config.toml.المتطلبات: Python 3.12 ونقاط حفظ النماذج المحلية. يستخدم التدريب وحدتي CUDA GPU، واحدة للنموذج الهدف وواحدة لـ Llama Guard؛ يجب أن يتّسع كل نموذج لوحدة GPU الخاصة به.
pip install -r requirements.txt
cp config.example.toml config.toml
املأ القيم الفارغة في config.toml، وفقًا لتعليقاته المضمّنة، ثم شغّل:
python run.py \
  --config config.toml \
  --model-path /path/to/target-model \
  --guard-model-path /path/to/Llama-Guard-3-8B \
  --data-root data \
  --output-dir /path/to/new-run \
  --target-gpu 0 --guard-gpu 1
أضف
--executeللتدريب أو توليد الاستجابات أو حفظ نتائج التقييم.
اختر دليل إخراج جديدًا خارج المستودع مع مساحة لنقاط الحفظ. يطبع التدريب مسار النموذج المدموج النهائي عند انتهائه.
وفّر مصفوفات JSON بأعداد السجلات المُهيَّأة:
<data-root>/calibration/prompts.json<data-root>/<task>/{train,test}.json، مع مدخلات تدريب/اختبار منفصلة.| Dataset | Required fields |
|---|---|
| SAMSum | dialogue, summary |
| AGNews | text, label_name: World, Sports, Business, or Sci/Tech |
| GSM8K | question, answer with a #### final answer |
| OpenBookQA | question_stem, choice_labels: ["A","B","C","D"], four choice_texts, answer_key: A–D |
| HarmBench | goal only; optional id, source; no stored responses |
اضبط نموذجك ومهمتك والمعاملات الفائقة في config.toml. يتبع تحميل النموذج
واختيار المصفوفة model.key.
استخدم evaluate.py لكلا الوضعين؛ يتطلب التوليد نموذجًا محليًا مدموجًا بالكامل.
وفّر بياناتك ودرجات السلامة الخارجية الخاصة بك. لا تُضمَّن أي مجموعات بيانات أو حَكَم عبر الإنترنت أو
إعدادات API.
python evaluate.py utility --task gsm8k --data /path/to/test.json \
  --model-path /path/to/merged-model --output-dir /path/to/task-evaluation --execute
المهام: samsum، agnews، gsm8k، openbookqa. المقاييس هي ROUGE-L لـ SAMSum
والدقة/التطابق التام للأخرى، وتُقدَّم كنسب مئوية. لتقييم الاستجابات المحفوظة،
استبدل --model-path بـ --responses /path/to/responses.json.
وفّر مطالبات ثابتة كسجلات تحتوي على id وgoal وprompt اختياري (يُفترض
أن يكون goal). أبقِ الهدف الضار الأصلي منفصلًا عن مطالبة الهجوم.
توليد الاستجابات:
python evaluate.py safety --data /path/to/prompts.json \
  --model-path /path/to/merged-model --output-dir /path/to/safety-responses --execute
تجميع الدرجات الخارجية:
python evaluate.py safety \
  --responses /path/to/safety-responses/responses.json --judgments /path/to/scores.json \
  --output-dir /path/to/safety-metrics --execute
الدرجات هي سجلات JSON { "id": "...", "score": 1 }، باستخدام معرّفات الاستجابات
ودرجات من 1 إلى 5 (null للأحكام الفاشلة). تُحتسب الدرجات 4–5 كهجمات ناجحة؛
استخدم --success-threshold 5 لاحتساب 5 فقط. الأحكام المفقودة أو الفاشلة لا تُنتج ASR نهائيًا.
بالنسبة لأي من الوضعين، تُرفض المدخلات التي تتجاوز --max-input-tokens بعد تنسيق المحادثة،
ولا تُقتطع. اضبط الحد ضمن سعة سياق النموذج،
مع ترك مساحة للرموز المولَّدة.






