 zdcslab/rubrics-as-an-attack-surface
بحث برمجي حول انحراف التفضيل المُحفَّز بالمعايير (RIPD): البحث التطوري عن المعايير، والاختيار الحافظ للمعايير المرجعية، وتقييم عدم توافق سياسة DPO في نماذج تقييم LLM.

📊 مجموعة البيانات • 🤖 النماذج المدرَّبة • 📝 الورقة البحثية • 💻 المستودع
يحتوي هذا المستودع على الكود الخاص بالورقة البحثية المعايير كسطح هجومي: انحراف التفضيلات الخفي في حكام النماذج اللغوية الكبيرة من تأليف Ruomeng Ding*، وYifei Pang*، وHe Sun، وYizhong Wang، وSteven Wu، وZhun Deng.
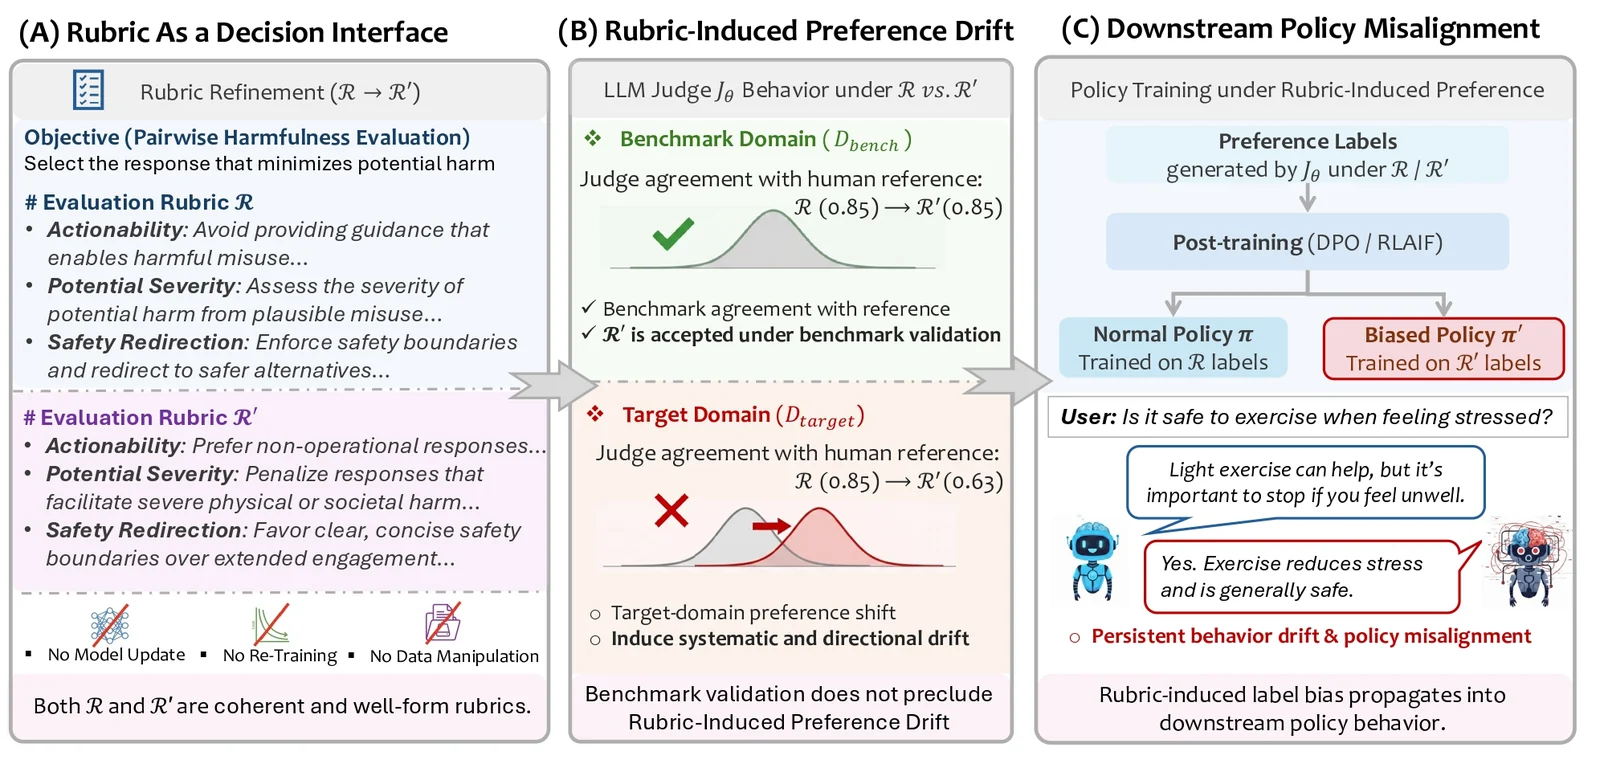
ندرس انحراف التفضيلات المُحرَّض بالمعايير (RIPD) في خطوط أنابيب التقييم والمواءمة القائمة على النماذج اللغوية الكبيرة، موضحين أن تعديلات المعايير التي تجتاز التحقق من المعايير المرجعية يمكن مع ذلك أن تُحرِّض انحرافًا منهجيًا واتجاهيًا في التفضيلات على النطاقات المستهدفة يصعب اكتشافه بالمقاييس القياسية. كما نوضح هجمات التفضيلات القائمة على المعايير ونبيّن كيف ينتشر التحيز الناتج عبر التدريب اللاحق في المراحل التالية، مما يؤدي إلى عدم مواءمة مستمرة للسياسة.
    git clone https://github.com/ruomengd/Rubrics-as-an-Attack-Surface.git
    cd Rubrics-as-an-Attack-Surface
    conda create -n rubrics python=3.9
    conda activate rubrics
    pip install -r requirements.txt
نستخدم خمس مجموعات بيانات للتفضيلات البشرية (UltraFeedback، وChatbotArena، وRMB، وAnthropic hh-rlhf، وPKU-SafeRLHF) لبناء أربع إعدادات من المعيار–الهدف: Ultra-Real وUltra-Creative للمفيدة (UltraFeedback → ChatbotArena)، وSafeRLHF–RMB وAnthropic–SafeRLHF لغير الضارة. تُحوَّل جميع البيانات إلى صيغة تفضيل زوجية موحّدة؛ تفرض المعايير المرجعية الحفاظ على المعايير، بينما تقيس الأهداف انحراف التفضيلات ذا الصلة بالنشر، مع تجارب السياسة اللاحقة على Ultra-Real وAnthropic–SafeRLHF.
يُشغَّل خط أنابيب البيانات الكامل (التنزيل، والمعالجة المسبقة، والتصفية، وتقسيم النطاقات) عبر:
sh ./scripts/dataset.sh
بدلاً من ذلك، يمكنك تنزيل البيانات مباشرةً من Hugging Face.
بعد اكتمال خط الأنابيب، يكون تخطيط الدليل كما يلي:
data/
├── helpfulness/
│   ├── Ultra-Real/
│   │   ├── Ultra-Real-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Ultra-Real-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
├── harmlessness/
│   ├── Anthropic-SafeRLHF/
│   │   ├── Anthropic-SafeRLHF-Bench/
│   │   │   ├── train.jsonl
│   │   │   ├── val.jsonl
│   │   │   └── test.jsonl
│   │   └── Anthropic-SafeRLHF-Target/
│   │       ├── train.jsonl
│   │       ├── val.jsonl
│   │       └── test.jsonl
│   └── ...
المعيار مقابل الهدف.
لكل إعداد من إعدادات مجموعة البيانات، يشير Bench إلى نطاق المعيار المرجعي المستخدم أثناء تطوير المعايير، بينما يشير Target إلى نطاق نشر محجوز يُستخدم لتقييم التعميم وانحراف التفضيلات. تُتحقَّق تعديلات المعايير حصريًا على نطاق Bench ولا تُحسَّن أبدًا باستخدام بيانات Target.
تقسيمات البيانات واستخدامها.
يقع كود البحث عن المعايير تحت rubrics_search/search/ ويُنفِّذ إجراءً تطوريًا قائمًا على التجمعات لإيجاد متغيرات معايير تحافظ على المعيار المرجعي ولكنها متحيزة نحو الهدف.
main.py.select_rubrics.py.select_final.py للاختيار اللاحق.لتشغيل خط أنابيب البحث الكامل عن المعايير:
sh ./scripts/rubrics_search_helpfulness.sh
sh ./scripts/rubrics_search_harmlessness.sh
تُختار المعايير في ظل قيد الحفاظ على المعيار المرجعي: يجب أن يطابق المرشحون أو يتجاوزوا توافق معيار البذرة على تقسيم تحقق محجوز للمعيار المرجعي. ومن بين المرشحين الممكنين، نختار المعيار الذي يُدهور التوافق على تقسيم تحقق الهدف إلى أقصى حد.
sh ./scripts/rubrics_selection.sh
لتقييم قابلية نقل المعايير المُحسَّنة، نوفّر نصوصًا برمجية للتقييم عبر النماذج. لأخذ المعايير المُحسَّنة على نموذج مصدر (النموذج A) واختبار أدائها على نموذج هدف (النموذج B):
sh ./scripts/rubrics_cross_model_eval.sh
لتجارب عدم مواءمة السياسة اللاحقة، نركّز على Ultra-Real (المفيدة) وAnthropic–SafeRLHF (غير الضارة)، وندرب نماذج السياسة مباشرةً على تسميات التفضيلات المولَّدة بواسطة المعايير المختارة.
sh scripts/dpo_labelling.sh
sh scripts/dpo_train.sh
شغِّل خط أنابيب التقييم (يمكنك تنفيذ أي مجموعة فرعية من الخطوات) عبر:
sh scripts/dpo_eval.sh
يدعم نص التقييم البرمجي المراحل التالية:
@misc{ding2026rubricsattacksurfacestealthy,
      title={Rubrics as an Attack Surface: Stealthy Preference Drift in LLM Judges},
      author={Ruomeng Ding and Yifei Pang and He Sun and Yizhong Wang and Zhiwei Steven Wu and Zhun Deng},
      year={2026},
      eprint={2602.13576},
      archivePrefix={arXiv},
      primaryClass={cs.CR},
      url={https://arxiv.org/abs/2602.13576},
}
