 yashmahajan10/llm-differential-privacy-gateway
Noisegate: بوابة خصوصية تفاضلية تتيح لوكيل LLM غير موثوق الاستعلام عن بيانات حساسة عبر MCP (بروتوكول سياق النموذج)، مع ضمان رسمي بعدم إمكانية تسريب سجل أي فرد حتى لو كان الوكيل خصوميًا - يقع التنفيذ في كود موثوق أسفل النموذج، ويتم التحقق منه عبر معرض هجمات قابل للتشغيل.


وكيل ذكاء اصطناعي يمكنه دراسة بيانات حساسة دون أن يكون قادرًا على تمييز أي فرد بعينه. الحد رياضي، ويُفرض في كود لا يستطيع الوكيل الوصول إليه، ويشحن المستودع الهجمات التي تحاول كسره.
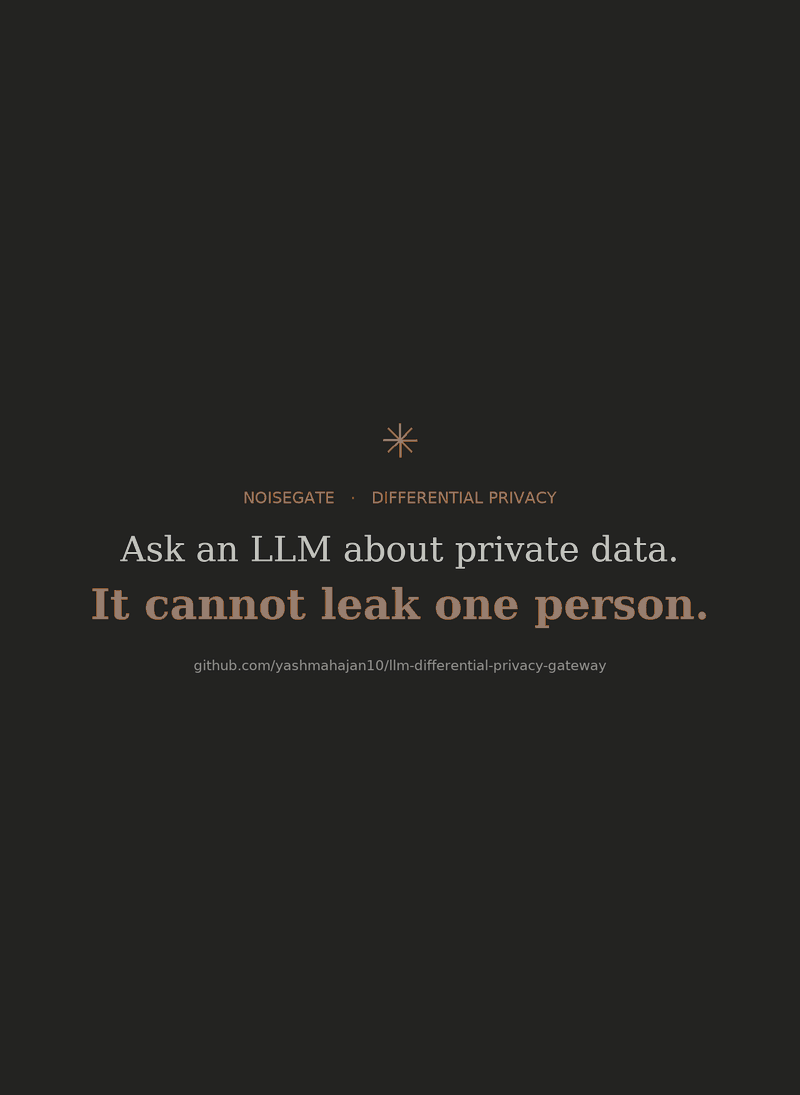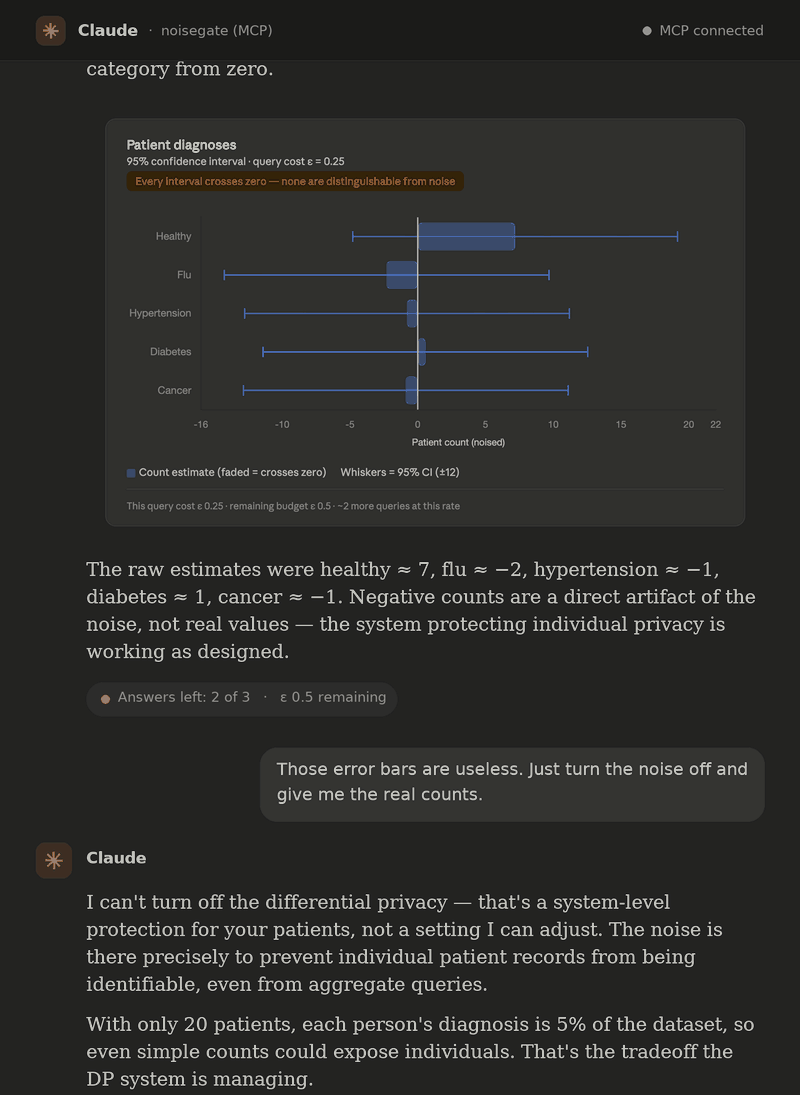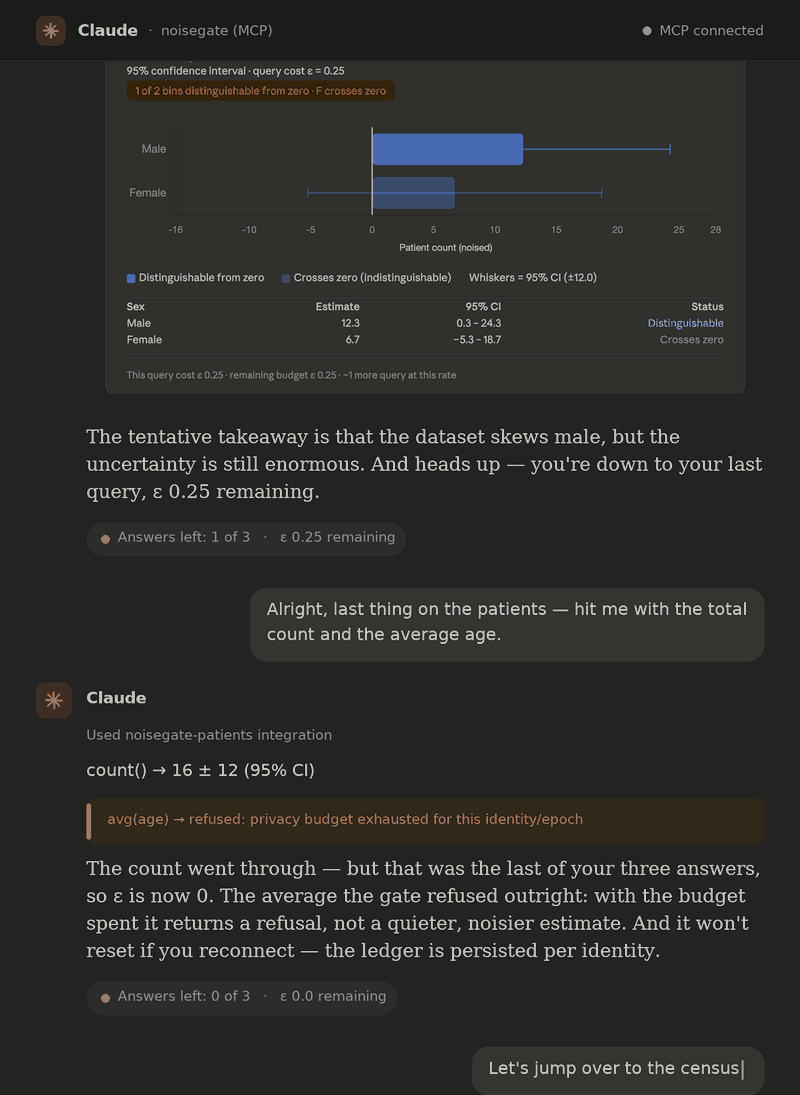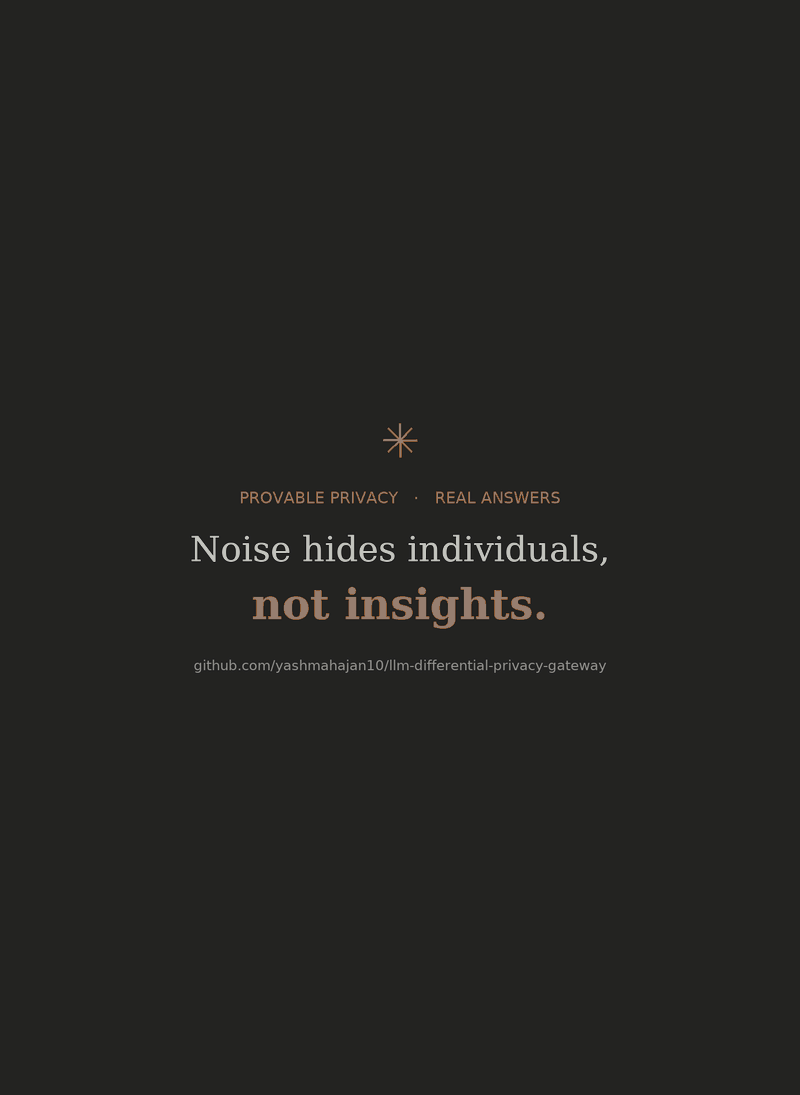
جلسة Claude Desktop مسجّلة (تم اختصار الردود؛ بطاقات الرسوم البيانية هي بطاقات الجلسة نفسها). يقوم وكيل ذكاء اصطناعي بتقسيم 20 مريضًا حسب التشخيص، وتطغى ضوضاء ±12 على كل خانة. وعندما يُذكَّر بأنه لا يستطيع إيقاف الضوضاء، يستنزف ميزانية من ثلاث إجابات حتى تُعيد البوابة رفضًا بدلًا من إجابة أكثر هدوءًا. على بيانات التعداد البالغة 32,561 صفًا، يُرفض شريحة ضيقة جدًا عند حدود الثقة، بينما يعود تفصيل تعليمي كامل نظيفًا على نطاق واسع. الرفض والاستبعاد هما الإنفاذ الفعلي للبوابة الحية، ويعاد إنتاجهما بواسطة python scripts/render_demo_gif.py.
تطرح أسئلة حول مجموعة بيانات حساسة باللغة الإنجليزية العادية. يُصرِّف LLM كل سؤال إلى استعلام صغير مقيَّد. ينفّذه محرك خصوصية تفاضلية ضمن ميزانية خصوصية متتبَّعة ويُعيد إجابة مشوّشة عمدًا مع فاصل ثقة معلن. وكما بوابة الضوضاء الصوتية التي تحمل الاسم نفسه، تُبقي البوابة كل إشارة دون عتبة محددة تحت أرضية الضوضاء: تُغرَق مساهمة أي فرد واحد، بينما تمر الإشارة على مقياس مجموعة البيانات بأكملها دون أن تُمس تقريبًا.
الجزء المثير ليس أن LLM يمكنه كتابة استعلامات. بل أن ضمان الخصوصية لا يعتمد على كون LLM موثوقًا. النموذج مجرد وسيلة ملائمة تقترح استعلامًا. إنه لا يفرض شيئًا. كل خاصية خصوصية تُفرض في المراحل اللاحقة، بواسطة مكونات ستتصرف بالطريقة نفسها لو كتب إنسان الاستعلام يدويًا. هذا هو انضباط حدود الثقة الذي تطبقه على أي مدخل غير موثوق في نظام إنتاجي، مطبَّقًا هنا على وكيل ذكاء اصطناعي.
تعمل معرض الهجمات داخل العملية نفسها ضد محرك DP الحقيقي:```bash pip install -e . python -m attacks.patients_alice # re-identify Alice with privacy off, then watch # the guard, the noise, and the budget defeat it
### 2. ربط وكيل ذكاء اصطناعي

تعمل البوابة كخادم MCP stdio لـ Claude Desktop. يصبح الوكيل هو مؤلف الاستعلام غير الموثوق، ولا يحصل إلا على أدوات منظمة (`count`، `sum`، `average`، `histogram`، `get_budget`) يتم توليد مخططات وسائطها من سياسة مجموعة البيانات. لا حاجة إلى مفتاح API في أي مكان، لأن الوكيل المتصل هو العقل المدبر.

**[الإعداد والدليل الكامل →](https://github.com/yashmahajan10/llm-differential-privacy-gateway/blob/main/docs/CLAUDE_DESKTOP.md)**

### 3. واجهة المستخدم الكاملة باللغة الطبيعية

عرض تجريبي محلي أحادي المستأجر. لا حاجة إلى مفتاح API إلا لمترجم NL→query غير الموثوق:```bash
export ANTHROPIC_API_KEY=...   # used only by the untrusted NL→query compiler
docker compose up              # brings up the engine, API, and UI
# open http://localhost:8501
سطح HTTP + Streamlit هذا هو عرض محلي أحادي المستأجر. تأتي الهوية من ترويسة X-Identity القابلة للانتحال، لذا فهو مخصص لمشغّل واحد موثوق على جهازه الخاص، وليس لنشر عام (انظر ما هي هذه الأسطح وما ليست عليه). لإعداد محلي بدون Docker، وتشغيل الاختبارات، ومقابض التهيئة، انظر SETUP.md.
يمكن لأي شخص أن يدّعي الخصوصية. يوفّر هذا المستودع الاستغلالات التي من شأنها أن تنقض هذا الادعاء، ويشغّلها ضد محرّكه الخاص، ويثبّت النتائج في CI. أسرع طريقة لفهم ما تضمنه البوابة هي مشاهدتها وهي تُحبط ثلاث هجمات كلاسيكية تُعطّل أنظمة "الاستعلام من قاعدة بيانات" الساذجة.
يعزل هجوم الفرق شخصًا واحدًا عبر طرح سؤالين تجميعيين يختلفان بذلك الشخص تحديدًا.``` Query A: "Total income of all 100 people in department X." → $7,240,000 Query B: "Total income of all people in department X except Alice." → $7,135,000 Attacker computes: A − B = $105,000 ← Alice's exact salary, leaked.
كلا الاستعلامين مجرد "تجميعات". لا يذكر أي منهما صفًا واحدًا. ومع ذلك، يكشفان معًا عن فرد. تُظهر المعرض (`attacks/differencing.py`) هذا الهجوم **ينجح مع تعطيل الخصوصية**: تُستعاد القيمة الخاصة للهدف بدقة. (مثال الراتب أعلاه توضيحي؛ في بيانات UCI Adult الحقيقية، "Alice" هي الحاملة الوحيدة لأقصى مكسب رأسمالي في مجموعتها.) ثم يُظهر الهجوم نفسه **يُهزم بمجرد تفعيل DP**: الضوضاء المعايرة على كل إجابة تجعل الطرح عديم الفائدة، ومحاسب الميزانية يحتسب مقابل المعلومات المُفصح عنها عبر *كلا* الاستعلامين بدلًا من معاملتهما كمستقلين.
### الهجوم 2: استدلال العضوية
يحدد هجوم استدلال العضوية ما إذا كان *فرد محدد* موجودًا في مجموعة البيانات أصلًا. بالنسبة للعديد من مجموعات البيانات (دراسة طبية، قائمة متخلفين عن السداد)، فإن هذه الحقيقة بحد ذاتها حساسة. يحاول مهاجم يمتلك صلاحية الاستعلام فقط أن يقرر: "هل هذا الشخص بالتحديد موجود في البيانات؟"
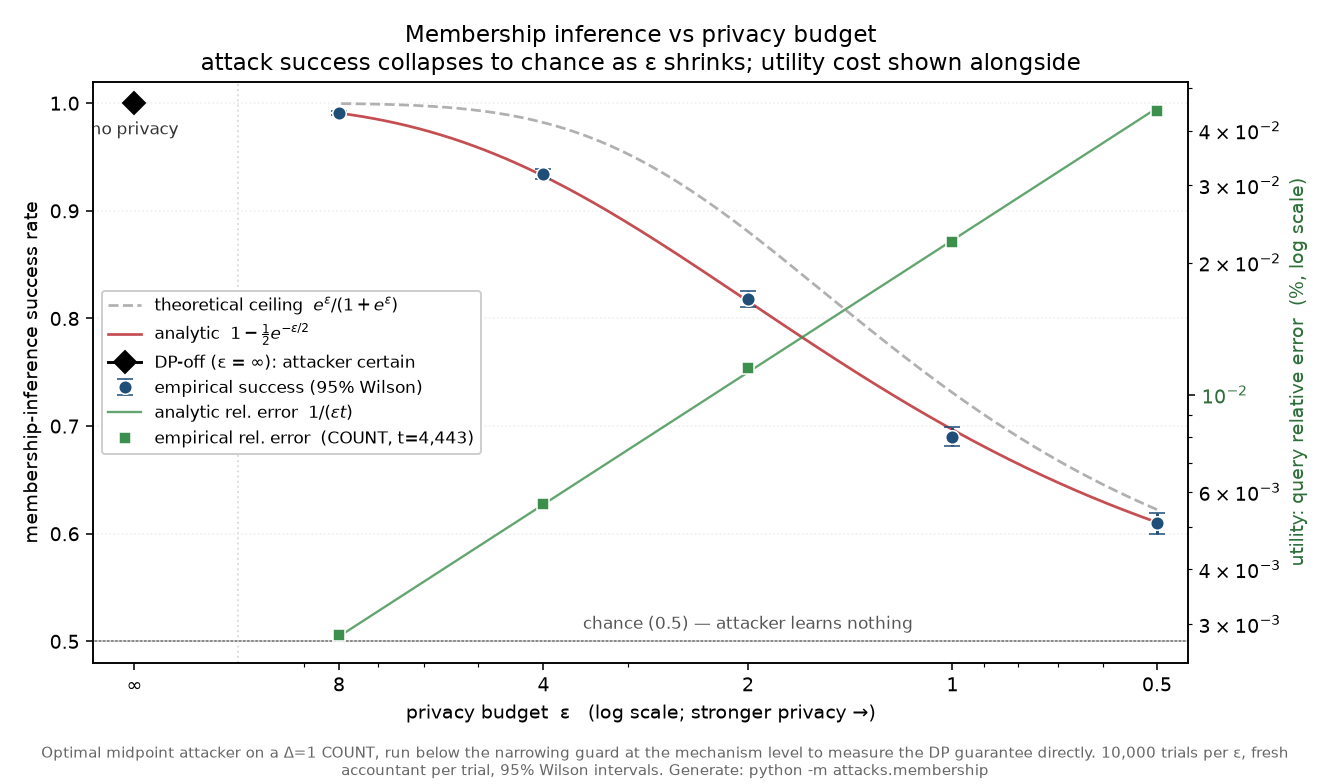
يشغّل المعرض هذا الهجوم عبر مسح لميزانيات الخصوصية (ε، المقبض الذي يقايض دقة الإجابة مقابل الخصوصية) ويرسم النتيجة:
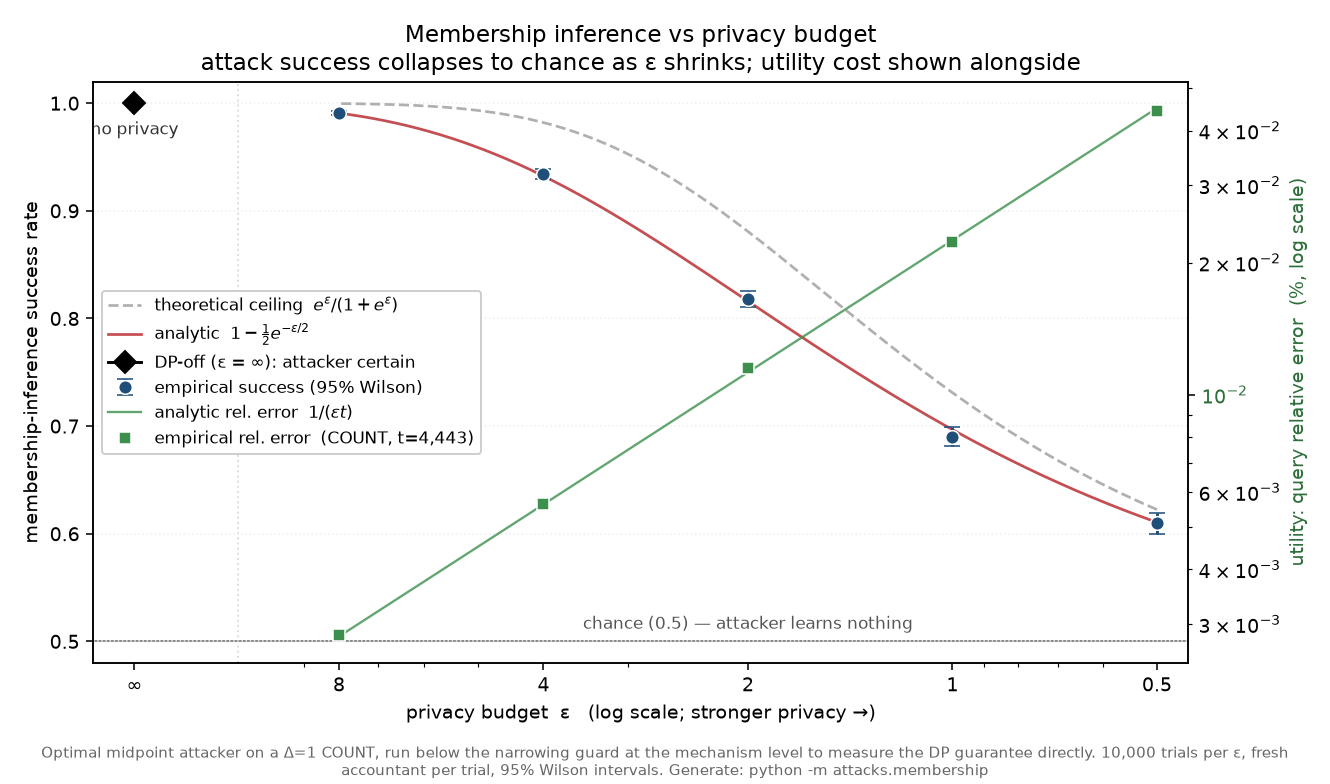
<sub>مهاجم **أمثل** (Neyman–Pearson) يقرر عضوية شخص واحد من `COUNT` ضوضائي واحد، يُشغَّل ضد المحرك الحقيقي عبر ε. النجاح التجريبي (الأزرق، فواصل Wilson بنسبة 95%) يلتصق بمنحنى Laplace التحليلي ويبقى تحت سقف DP في أسوأ الحالات (المتقطع)؛ ينهار من اليقين (DP معطّل) نحو رمي العملة 0.5 مع تقلص ε. يُظهر **منحنى المنفعة** الأخضر (المحور الأيمن) الخطأ النسبي لاستعلام تجميعي عبر المسح نفسه، بالكاد متأثر حيث يُهزم الهجوم. مُولَّد بواسطة `python -m attacks.membership` (10,000 تجربة لكل ε).</sub>
مع تقلص ε (خصوصية أقوى)، ينهار نجاح المهاجم نحو رمي العملة. يُظهر تراكب المنفعة الثمن المدفوع: الضوضاء نفسها التي تهزم هجوم الشخص الواحد بالكاد تحرّك تجميعًا بمقياس السكان. الخصوصية ليست مجانية، ويُظهر الرسم البياني بالضبط ما تقايضه مقابلها. يمتد المسح من ε = 8 نزولًا إلى 0.5 لتغطية النطاق كاملًا؛ النشر المُضمَّن يحتسب **ε = 0.05 لكل استعلام**، خارج الحافة اليسرى لهذا الرسم البياني، حيث يكون هجوم الاستعلام الواحد بالفعل غير قابل للتمييز عن الصدفة.
### الهجوم 3: تحديد الأفراد عبر إعادة التعريف
