 thunlp/openattack
حزمة مفتوحة المصدر للهجوم الخصومي النصي.


الوثائق • الميزات والاستخدامات • أمثلة الاستخدام • نماذج الهجوم • تصميم الأدوات
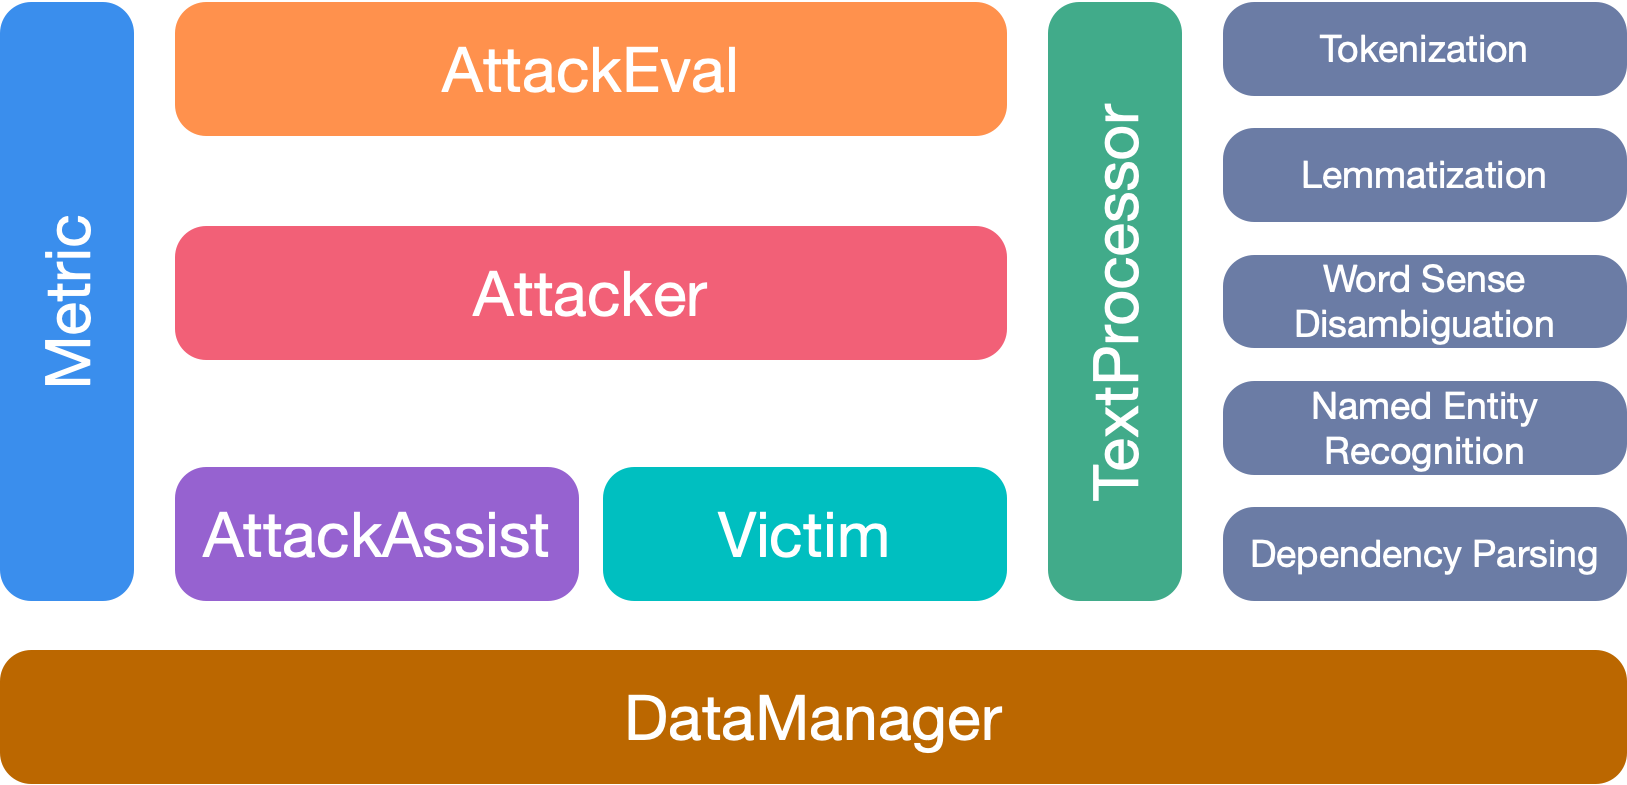
OpenAttack هي مجموعة أدوات مفتوحة المصدر قائمة على بايثون للهجوم العدائي النصي، والتي تتولى العملية الكاملة للهجوم العدائي النصي، بما في ذلك معالجة النص مسبقًا، والوصول إلى النموذج الضحية، وتوليد الأمثلة العدائية والتقييم.
⭐️ دعم جميع أنواع الهجمات. يدعم OpenAttack جميع أنواع الهجمات بما في ذلك الاضطرابات على مستوى الجملة/الكلمة/الحرف ونماذج الهجوم القائمة على التدرج/النتيجة/القرار/الأعمى؛
⭐️ تعدد اللغات. يدعم OpenAttack اللغتين الإنجليزية والصينية الآن. يتيح تصميمه القابل للتوسيع الدعم السريع لمزيد من اللغات؛
⭐️ المعالجة المتوازية. يوفر OpenAttack دعمًا لتشغيل نماذج الهجوم بعدة عمليات لتحسين كفاءة الهجوم؛
⭐️ التوافق مع 🤗 Hugging Face. OpenAttack متكامل تمامًا مع مكتبتي 🤗 Transformers و Datasets؛
⭐️ قابلية توسع كبيرة. يمكنك بسهولة مهاجمة نموذج ضحية مخصص على أي مجموعة بيانات مخصصة، أو تطوير وتقييم نموذج هجوم مخصص.
✅ توفير خطوط أساسية متنوعة ومفيدة لنماذج الهجوم؛
✅ تقييم نماذج الهجوم بشكل شامل باستخدام مقاييس تقييم شاملة؛
✅ المساعدة في التطوير السريع لنماذج هجوم جديدة بمساعدة مكونات الهجوم الشائعة؛
✅ تقييم المتانة لنموذج تعلم آلي ضد الهجمات العدائية المختلفة؛
✅ إجراء تدريب عدائي لتحسين متانة نموذج تعلم آلي من خلال إثراء بيانات التدريب بالأمثلة العدائية المُولَّدة.
pip (موصى به)```bashpip install OpenAttack
#### 2. استنساخ هذا المستودع```bash
git clone https://github.com/thunlp/OpenAttack.git
cd OpenAttack
python setup.py install
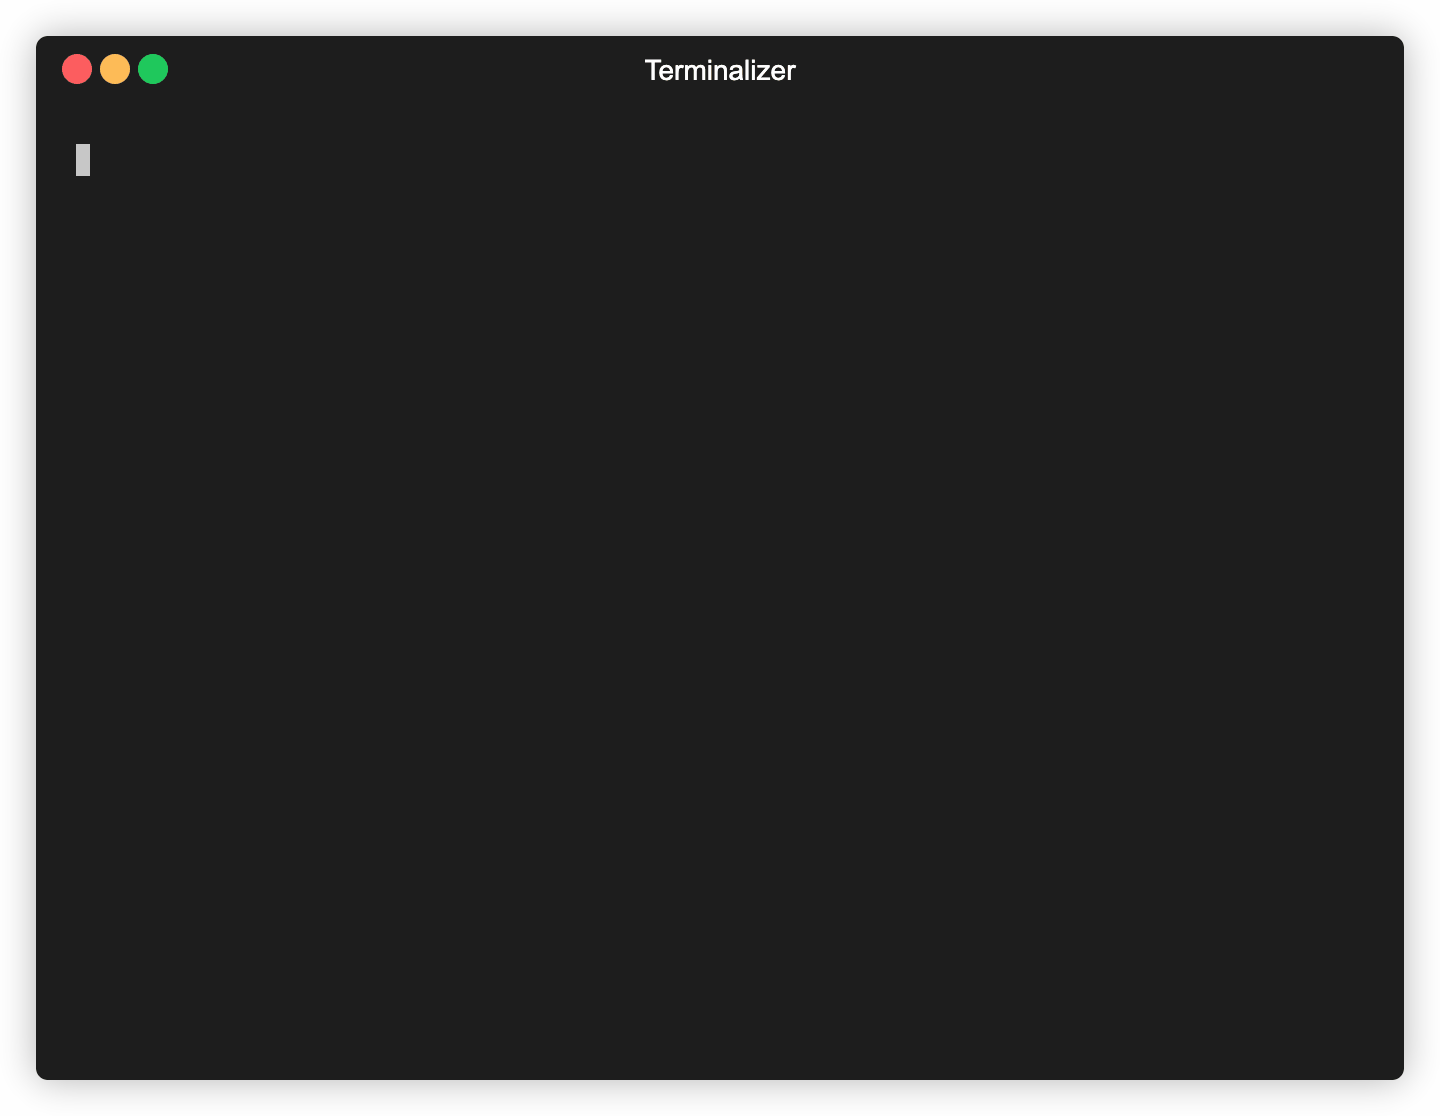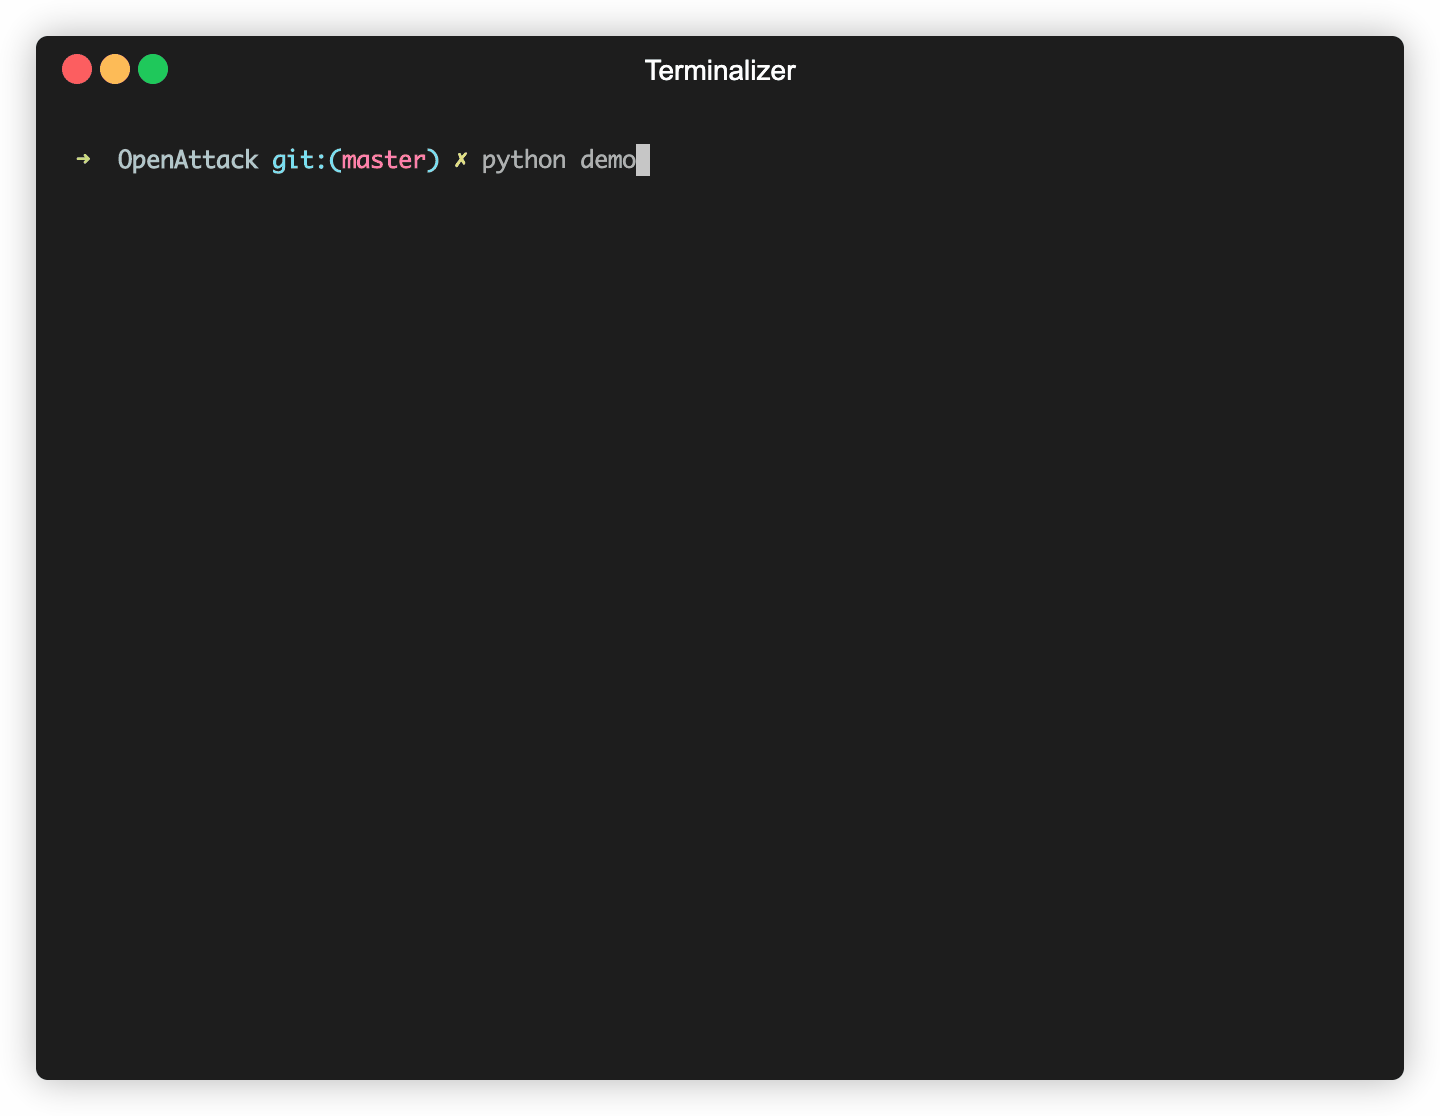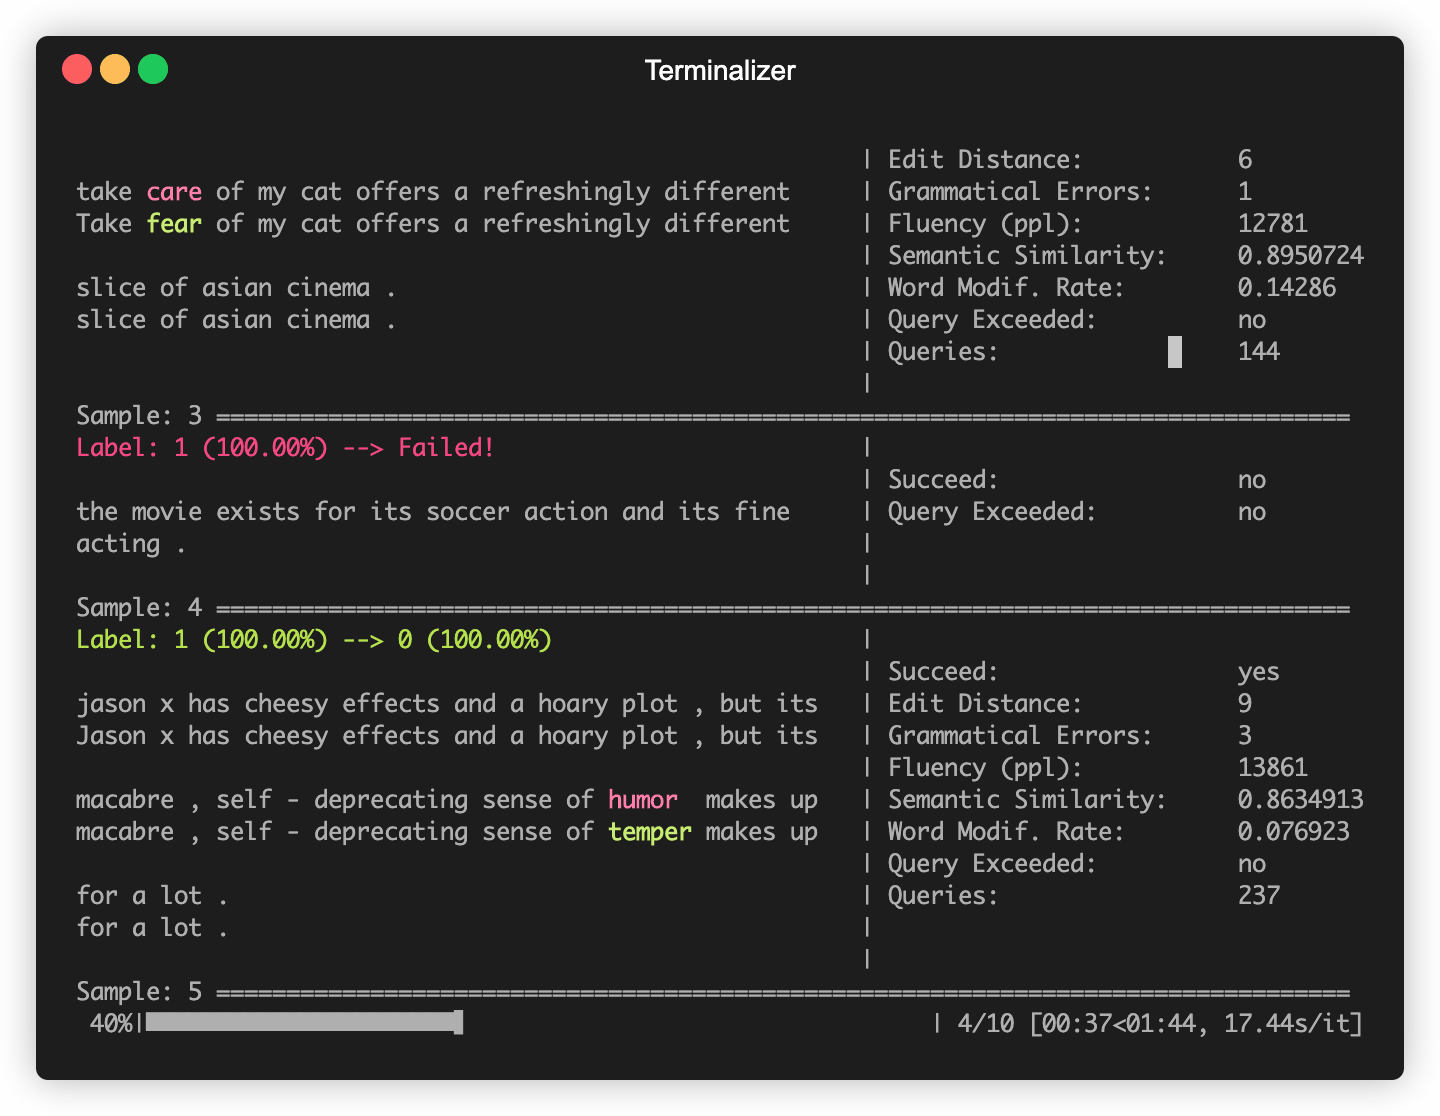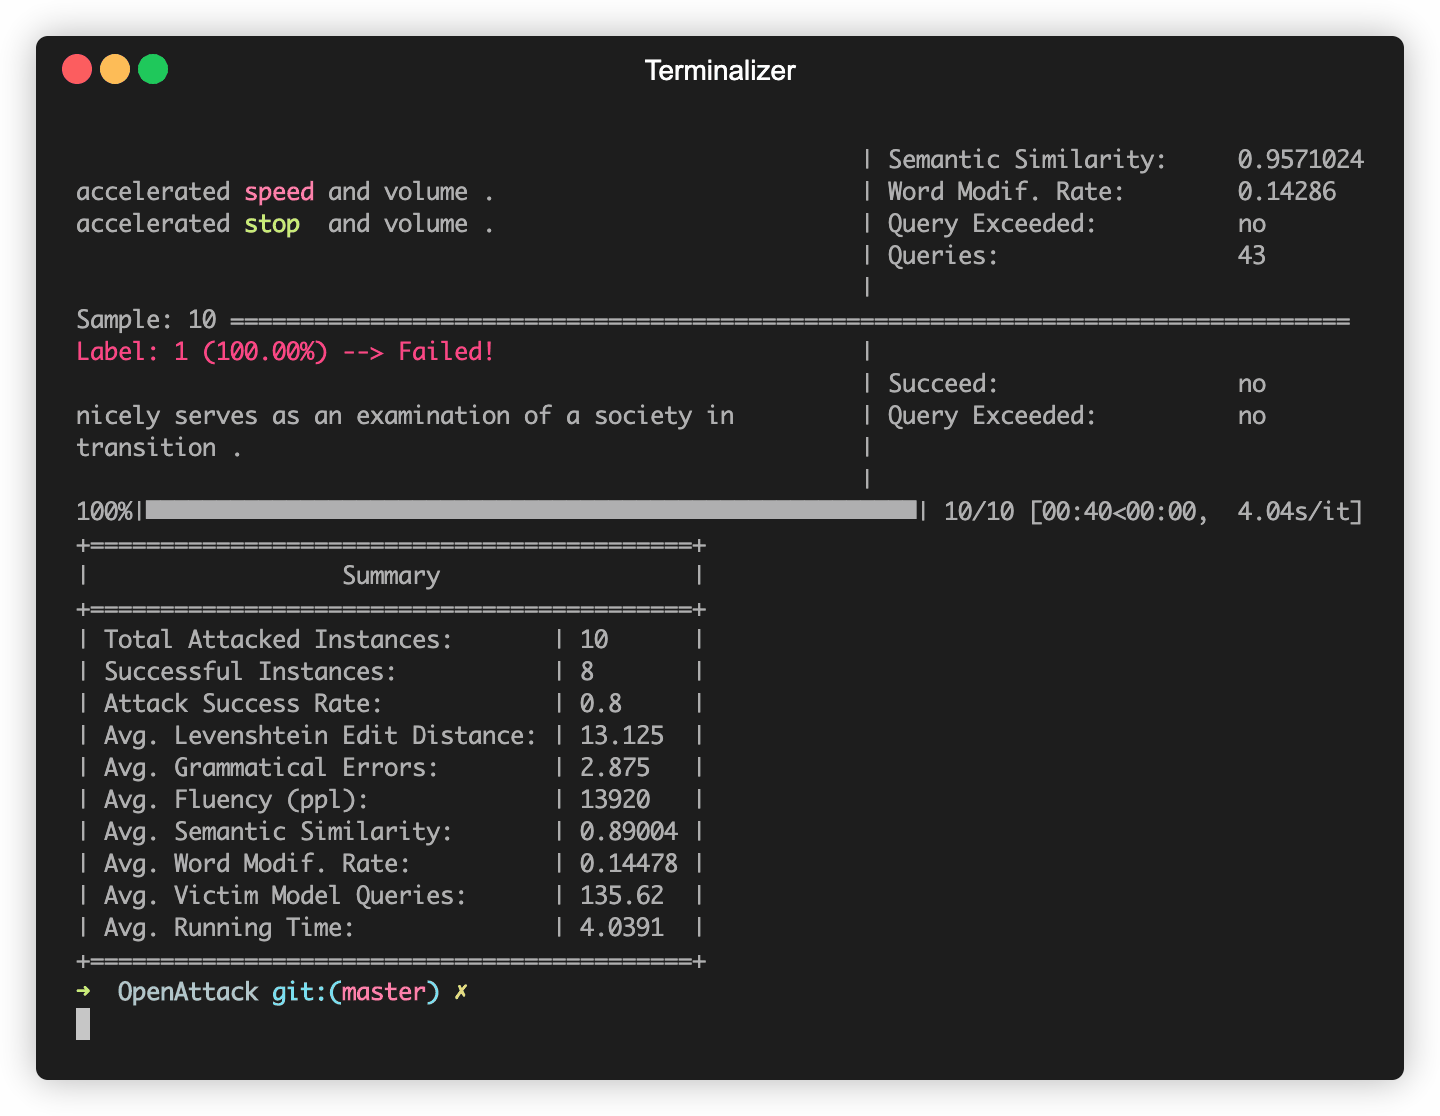
بعد التثبيت، يمكنك محاولة تشغيل demo.py للتحقق من أن OpenAttack يعمل بشكل جيد:```
python demo.py
## أمثلة الاستخدام
#### مهاجمة نماذج الضحية المدمجة
يُدرج OpenAttack بعض نماذج معالجة اللغة الطبيعية شائعة الاستخدام مثل BERT ([Devlin et al. 2018](https://arxiv.org/abs/1810.04805)) وRoBERTa ([Liu et al. 2019](https://arxiv.org/abs/1907.11692)) والتي تم ضبطها بدقة على بعض مجموعات البيانات شائعة الاستخدام (مثل [SST-2](https://nlp.stanford.edu/sentiment/treebank.html)). يمكنك بسهولة شن هجمات عدائية ضد نماذج الضحية المدمجة هذه.
يوضح مقتطف الشيفرة التالي كيفية استخدام PWWS، وهو نموذج هجوم قائم على الخوارزمية الجشعة ([Ren et al., 2019](https://www.aclweb.org/anthology/P19-1103.pdf))، لمهاجمة BERT على مجموعة بيانات SST-2 (الشيفرة الكاملة القابلة للتنفيذ موجودة [هنا](https://github.com/thunlp/openattack/blob/master/examples/workflow.py)).```python
import OpenAttack as oa
import datasets # use the Hugging Face's datasets library
# change the SST dataset into 2-class
def dataset_mapping(x):
return {
"x": x["sentence"],
"y": 1 if x["label"] > 0.5 else 0,
}
# choose a trained victim classification model
victim = oa.DataManager.loadVictim("BERT.SST")
# choose 20 examples from SST-2 as the evaluation data
dataset = datasets.load_dataset("sst", split="train[:20]").map(function=dataset_mapping)
# choose PWWS as the attacker and initialize it with default parameters
attacker = oa.attackers.PWWSAttacker()
# prepare for attacking
attack_eval = OpenAttack.AttackEval(attacker, victim)
# launch attacks and print attack results
attack_eval.eval(dataset, visualize=True)
يوضح مقتطف الكود التالي كيفية استخدام PWWS لمهاجمة نموذج تحليل المشاعر المخصص (نموذج إحصائي مبني في NLTK) على SST-2 (الكود القابل للتنفيذ الكامل موجود هنا).
import OpenAttack as oa
import numpy as np
import datasets
import nltk
from nltk.sentiment.vader import SentimentIntensityAnalyzer


# configure access interface of the customized victim model by extending OpenAttack.Classifier.
class MyClassifier(oa.Classifier):
    def __init__(self):
        # nltk.sentiment.vader.SentimentIntensityAnalyzer is a traditional sentiment classification model.
        nltk.download('vader_lexicon')
        self.model = SentimentIntensityAnalyzer()

    def get_pred(self, input_):
        return self.get_prob(input_).argmax(axis=1)

    # access to the classification probability scores with respect input sentences
    def get_prob(self, input_):
        ret = []
        for sent in input_:
            # SentimentIntensityAnalyzer calculates scores of “neg” and “pos” for each instance
            res = self.model.polarity_scores(sent)

            # we use 𝑠𝑜𝑐𝑟𝑒_𝑝𝑜𝑠 / (𝑠𝑐𝑜𝑟𝑒_𝑛𝑒𝑔 + 𝑠𝑐𝑜𝑟𝑒_𝑝𝑜𝑠) to represent the probability of positive sentiment
            # Adding 10^−6 is a trick to avoid dividing by zero.
            prob = (res["pos"] + 1e-6) / (res["neg"] + res["pos"] + 2e-6)

            ret.append(np.array([1 - prob, prob]))

        # The get_prob method finally returns a np.ndarray of shape (len(input_), 2). See Classifier for detail.
        return np.array(ret)

def dataset_mapping(x):
    return {
        "x": x["sentence"],
        "y": 1 if x["label"] > 0.5 else 0,
    }

# load some examples of SST-2 for evaluation
dataset = datasets.load_dataset("sst", split="train[:20]").map(function=dataset_mapping)
# choose the costomized classifier as the victim model
victim = MyClassifier()
# choose PWWS as the attacker and initialize it with default parameters
attacker = oa.attackers.PWWSAttacker()
# prepare for attacking
attack_eval = oa.AttackEval(attacker, victim)
# launch attacks and print attack results
attack_eval.eval(dataset, visualize=True)
```
</details>


<details>
<summary><strong>مجموعة بيانات مخصصة</strong></summary>

يوضح مقتطف الشفرة التالي كيفية استخدام PWWS لمهاجمة نموذج تحليل المشاعر المدرب بدقة على مجموعة بيانات **مخصصة** (الشفرة القابلة للتنفيذ الكاملة موجودة [هنا](https://github.com/thunlp/openattack/blob/master/examples/custom_dataset.py)).```python
import OpenAttack as oa
import transformers
import datasets

# load a fine-tuned sentiment analysis model from Transformers (you can also use our fine-tuned Victim.BERT.SST)
tokenizer = transformers.AutoTokenizer.from_pretrained("echarlaix/bert-base-uncased-sst2-acc91.1-d37-hybrid")
model = transformers.AutoModelForSequenceClassification.from_pretrained("echarlaix/bert-base-uncased-sst2-acc91.1-d37-hybrid", num_labels=2, output_hidden_states=False)
victim = oa.classifiers.TransformersClassifier(model, tokenizer, model.bert.embeddings.word_embeddings)
