 rodricios/wxpath
wxpath - زحف ويب تصريحي باستخدام XPath؛ لغة استعلام ويب (WQL)


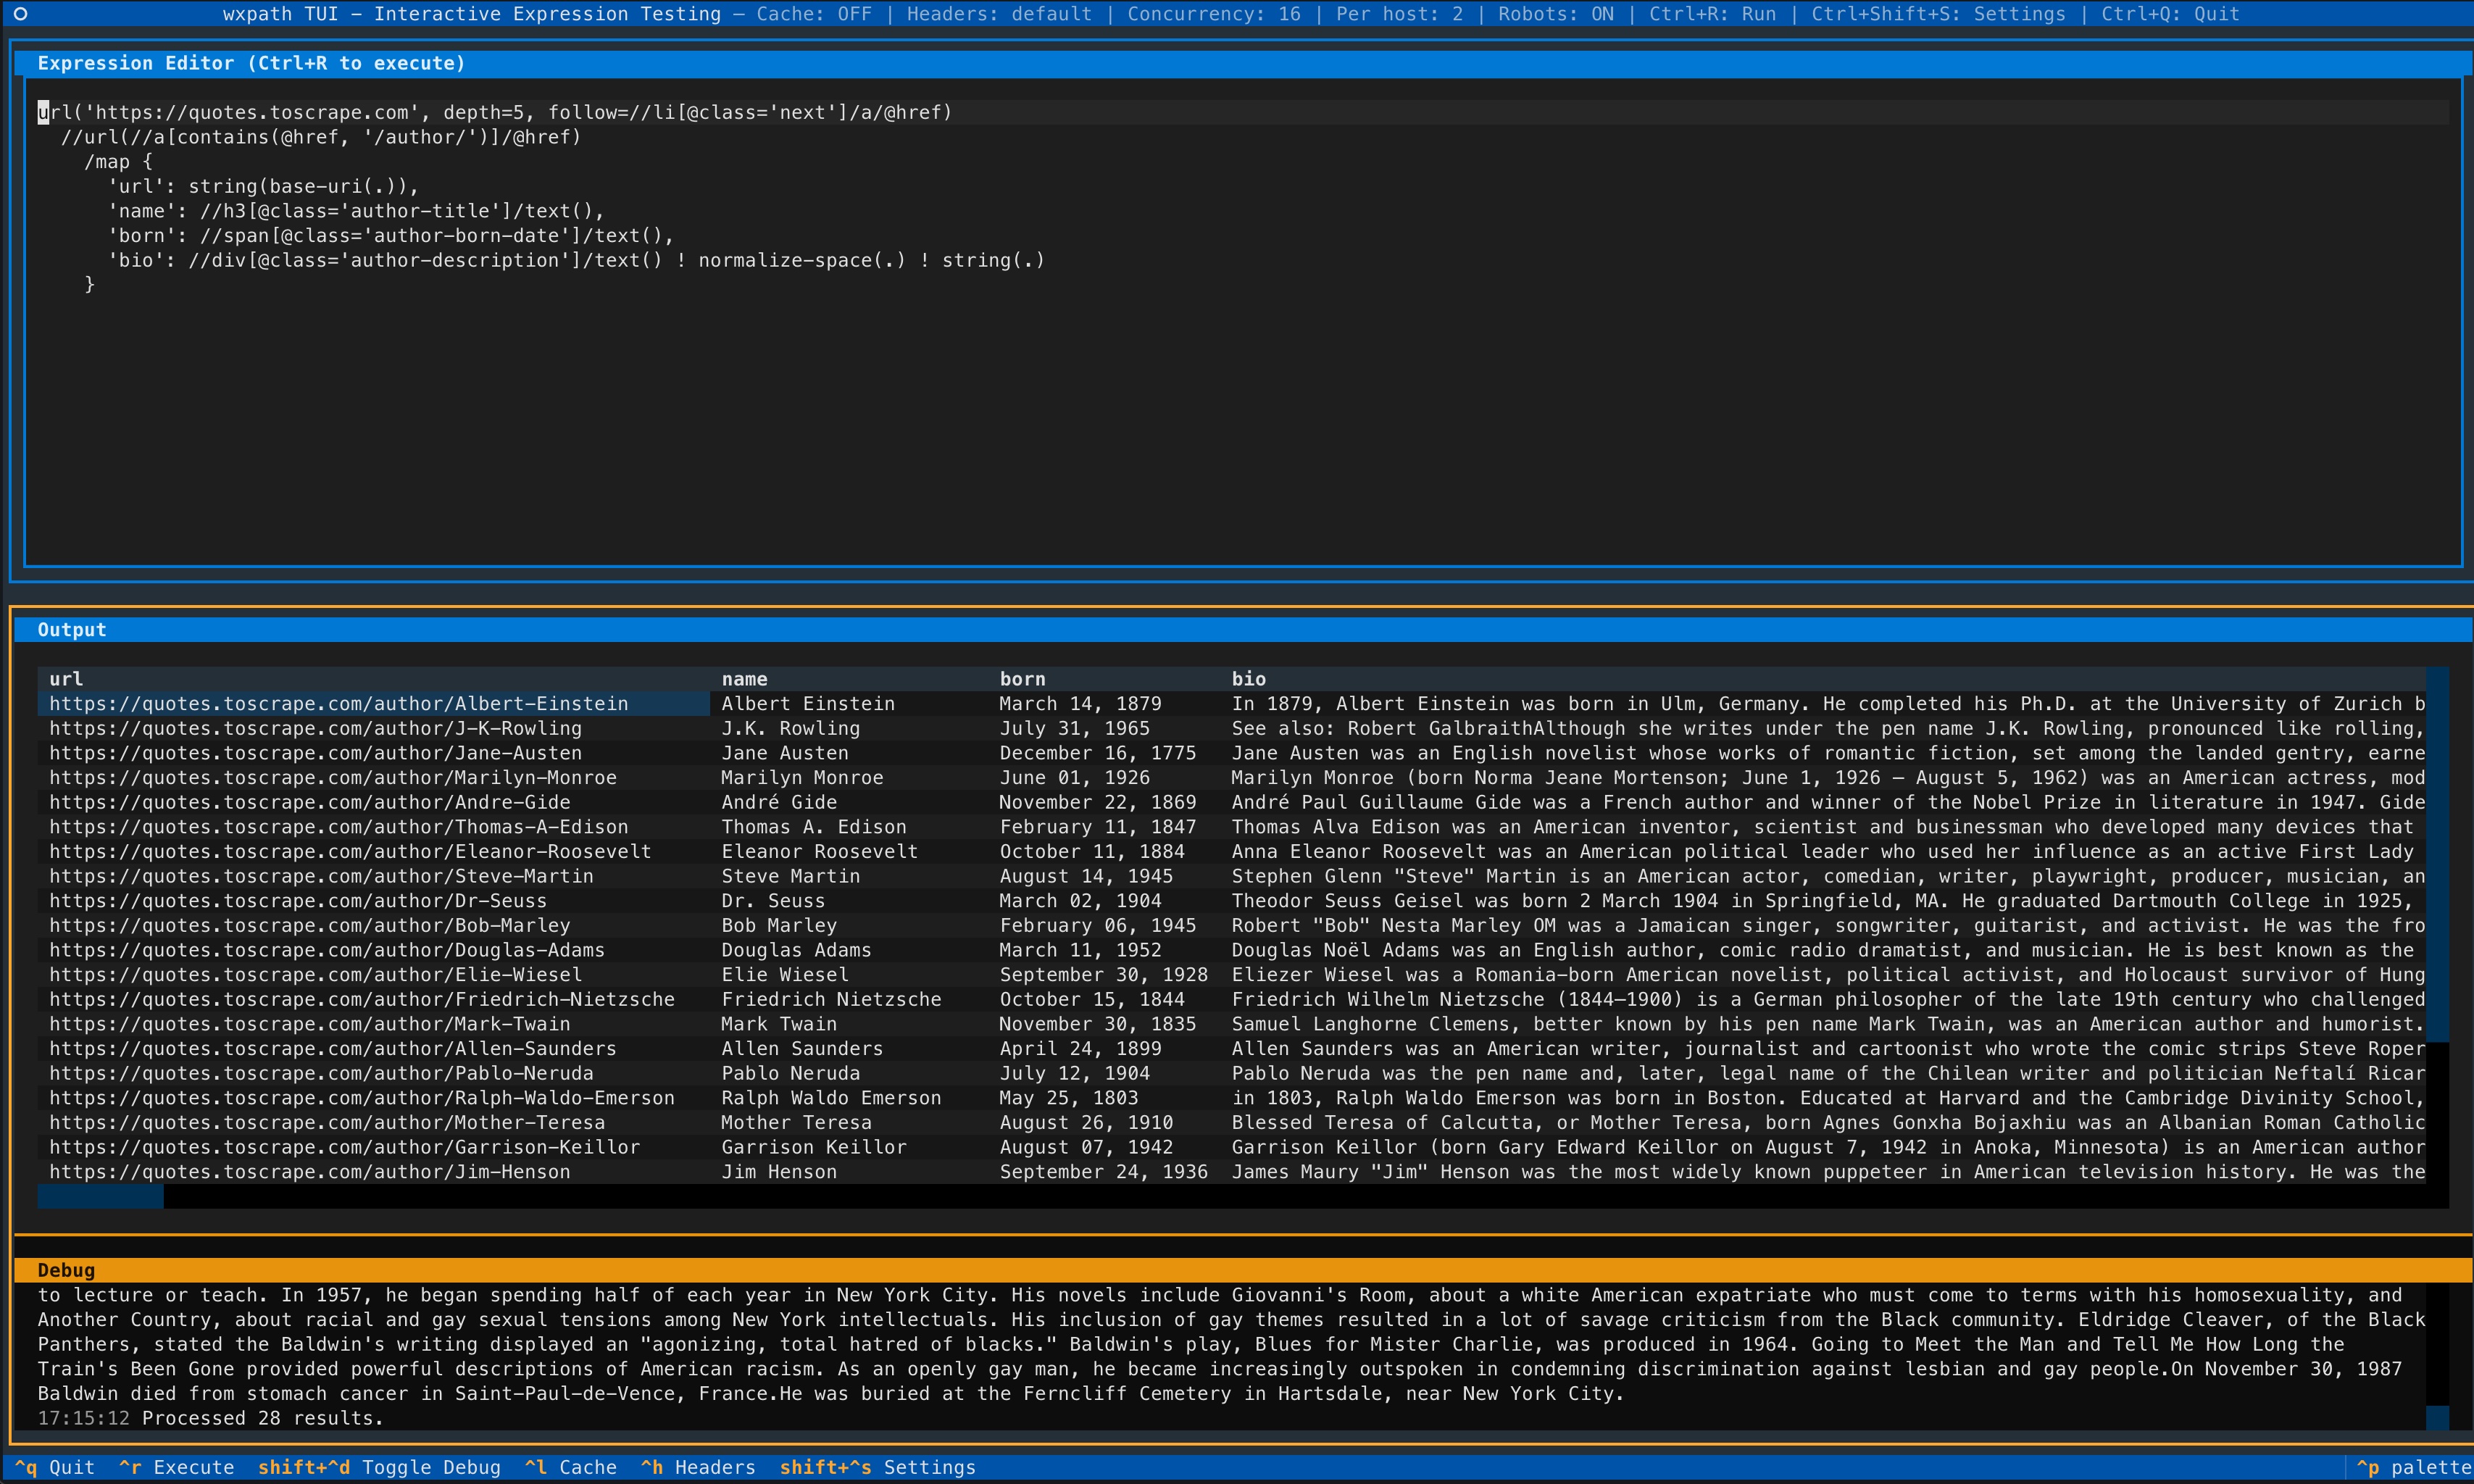
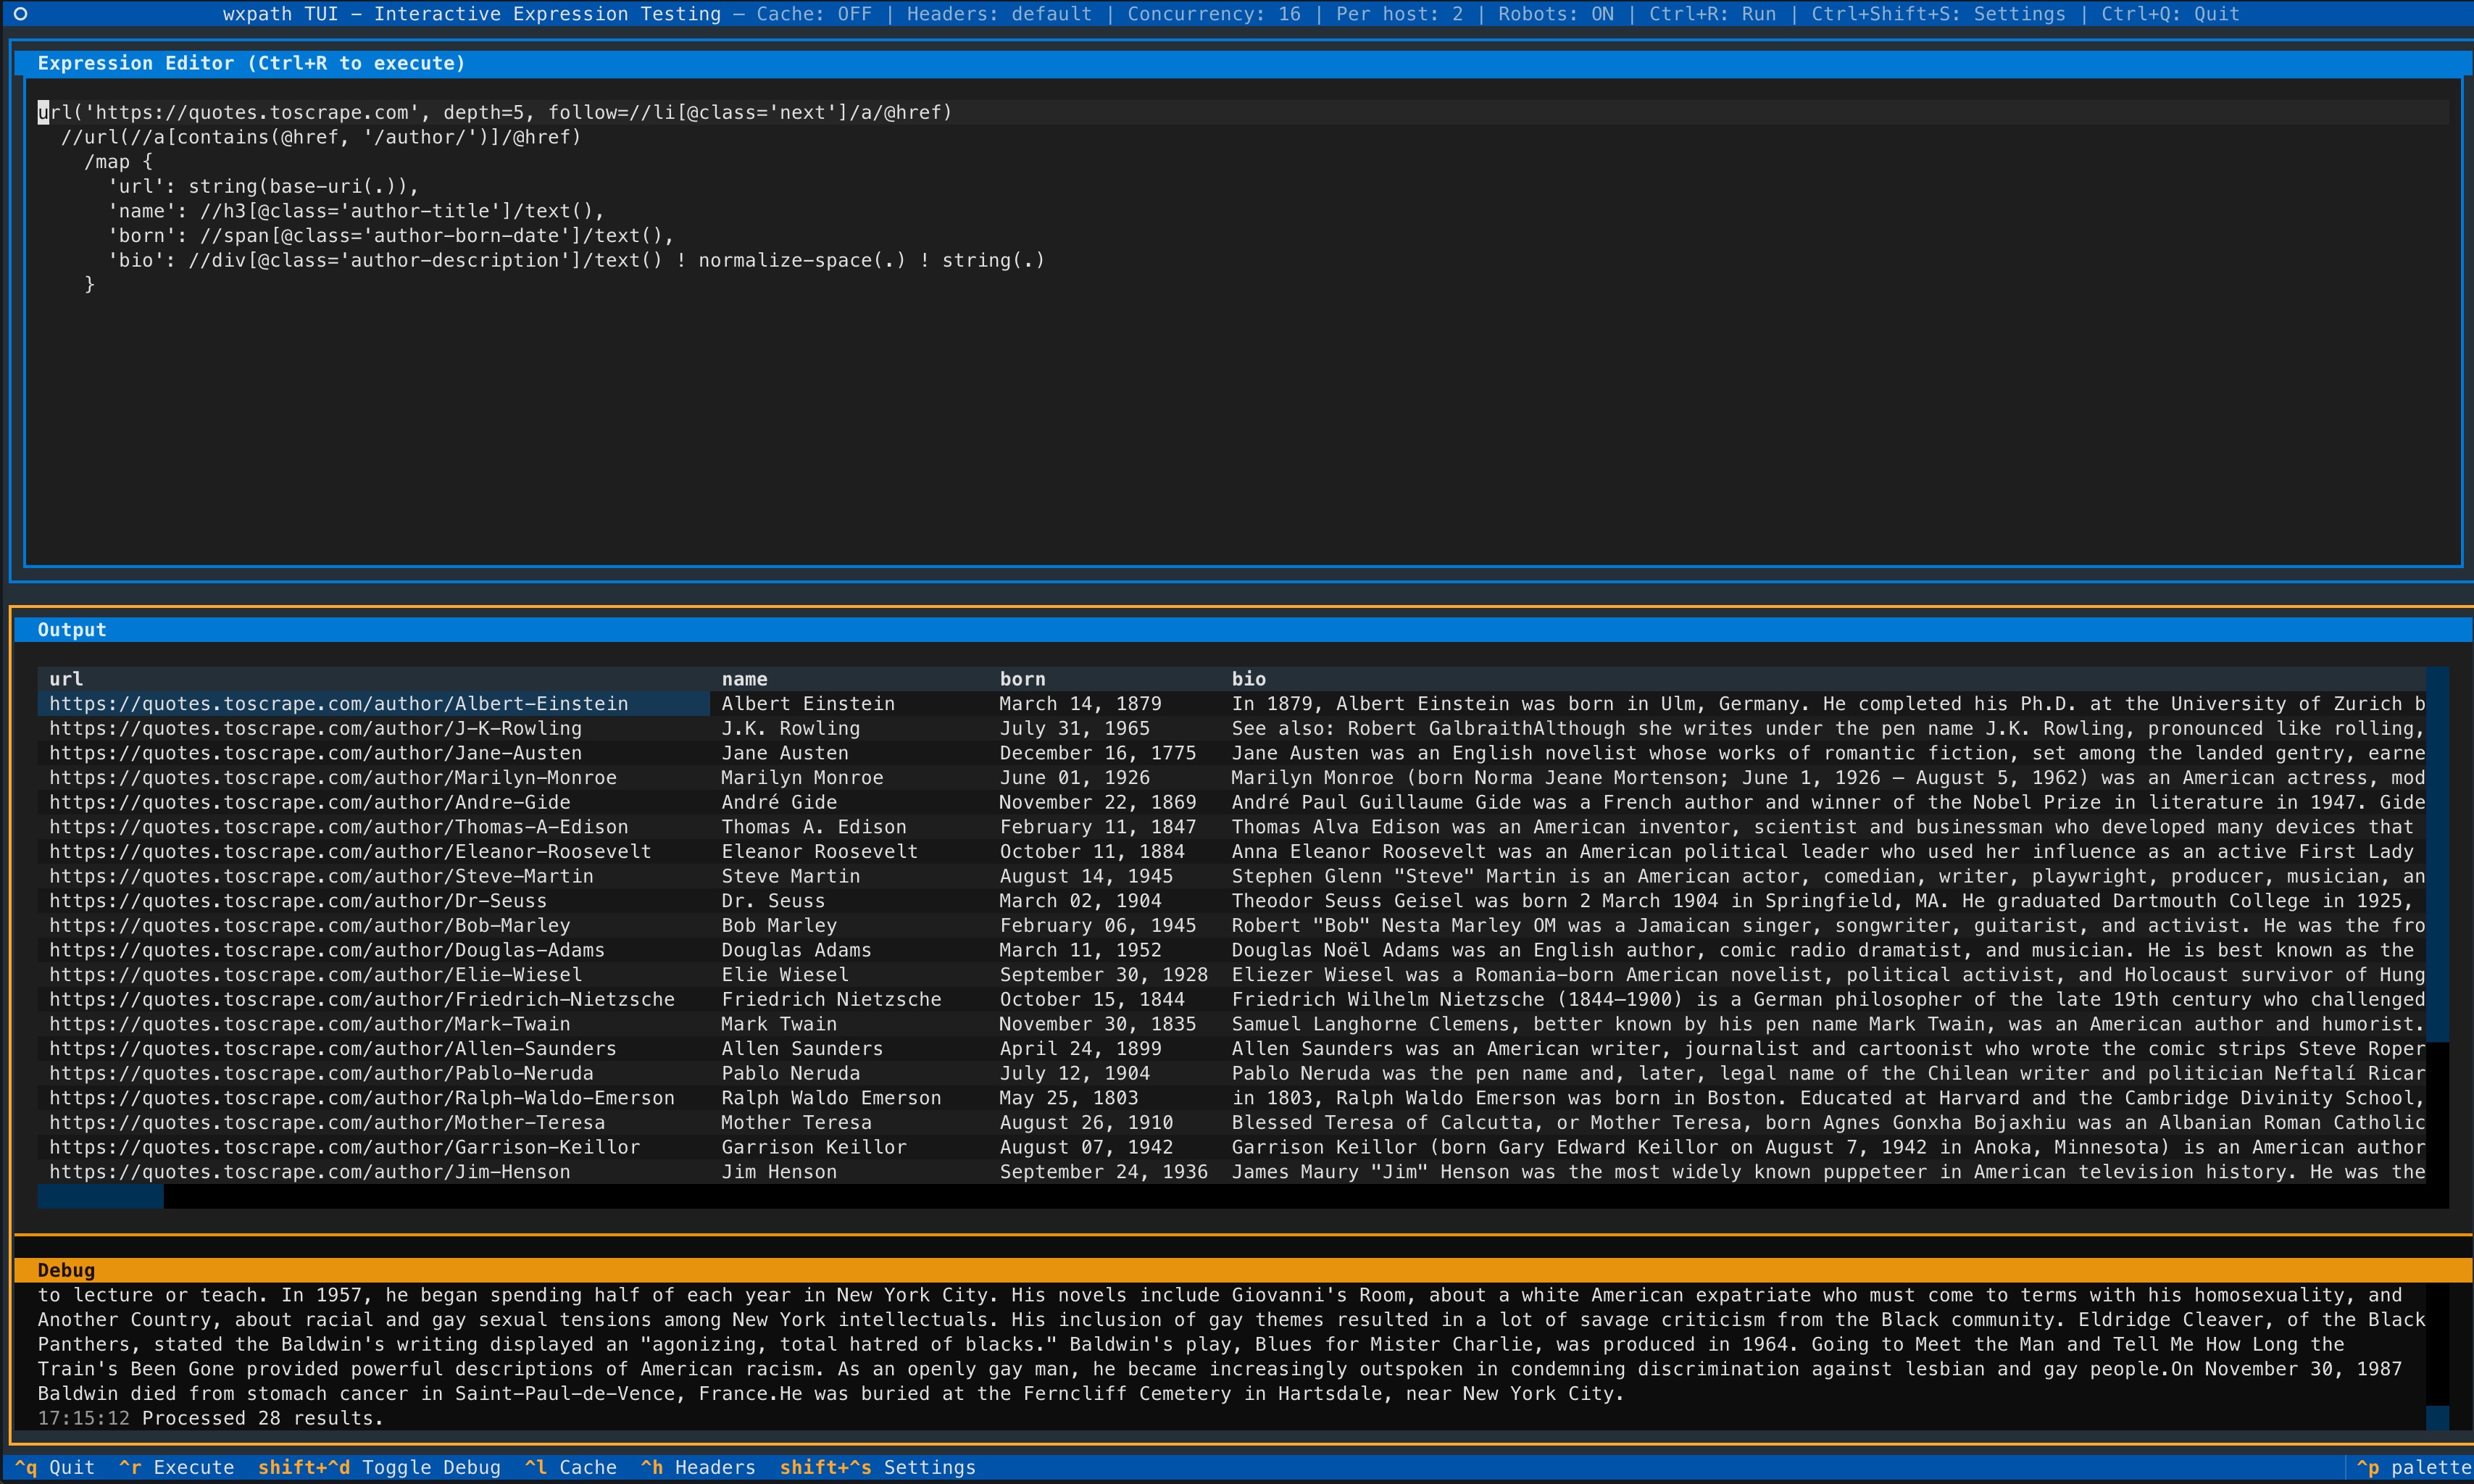
جديد: TUI - واجهة طرفية تفاعلية (مدعومة بـ Textual) لاختبار تعبيرات wxpath وتصدير البيانات.
يتطلب Python 3.10+.
pip install wxpath
# لدعم TUI:
pip install "wxpath[tui]"
# تشغيل TUI فورًا عبر uv:
uvx --from "wxpath[tui]" wxpath-tui
wxpath هو زاحف ويب تصريحي حيث يتم التعبير عن الاجتياز مباشرة في XPath. بدلاً من كتابة حلقات زحف أمرية، يتيح لك wxpath وصف ما يجب تتبعه وما يجب استخراجه في تعبير واحد. يقوم wxpath بتنفيذ ذلك التعبير بشكل متزامن، بطريقة عرضية أولى تقريبًا، ويبث النتائج فور اكتشافها.
يقوم هذا التعبير بجلب صفحة، واستخراج الروابط، وبثها بشكل متزامن - بدون الحاجة إلى حلقة زحف:
import wxpath

expr = "url('https://quotes.toscrape.com')//a/@href"

for link in wxpath.wxpath_async_blocking_iter(expr):
    print(link)
من خلال إدخال عامل url(...) وبناء ///، يمكن لمحرك wxpath إجراء زحف ويب متكرر (أو مقسم إلى صفحات) واستخراج:
import wxpath

path_expr = """
url('https://quotes.toscrape.com')
  ///url(//a/@href)
    //a/@href
"""

for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
    print(item)
معظم أدوات كشط الويب تجبرك على كتابة تدفق التحكم في الزحف أولاً، ثم الاستخراج ثانيًا.
wxpath يجمع هاتين الخطوتين في خطوة واحدة:
استخرج تسلسلات هرمية JSON نظيفة ومنظمة مباشرة من الرسم البياني - قم بتغذية نماذج LLM الخاصة بك بالإشارات، وليس بالضوضاء. راجع تكامل LangChain لمزيد من التفاصيل.
wxpath حتمي (أي: لا يعمل بواسطة نماذج LLM). بينما لا يمكننا ضمان استقرار الشبكة، يمكننا ضمان حتمية الاجتياز.
التوثيق متاح الآن هنا.
url(...) و ///url(...)import wxpath
from wxpath.settings import CRAWLER_SETTINGS
# رؤوس مخصصة للتهذيب؛ ضرورية لبعض المواقع (مثل ويكيبيديا)
CRAWLER_SETTINGS.headers = {'User-Agent': 'my-app/0.4.0 (contact: [email protected])'}
# ازحف، استخرج الحقول، ابنِ رسمًا بيانيًا معرفيًا
path_expr = """
url('https://en.wikipedia.org/wiki/Expression_language')
///url(
//main//a/@href[
starts-with(., '/wiki/') and not(contains(., ':'))
]
)
/map{
'title': (//span[contains(@class, "mw-page-title-main")]/text())[1] ! string(.),
'url': string(base-uri(.)),
'short_description': //div[contains(@class, 'shortdescription')]/text() ! string(.),
'forward_links': //div[@id="mw-content-text"]//a/@href ! string(.)
}
"""
for item in wxpath.wxpath_async_blocking_iter(path_expr, max_depth=1):
print(item)
ملاحظة: قد تمنع بعض المواقع (بما في ذلك ويكيبيديا) الطلبات بدون رؤوس مناسبة.
انظر متقدم: تكوين المحرك والزاحف لتعيين User-Agent مخصص.
يقوم التعبير أعلاه بما يلي:
https://en.wikipedia.org/wiki/Expression_language.<main> التي تبدأ بـ /wiki/ ولا تحتوي على نقطتين (:).url(...) و ///url(...)url(...) هو عامل مخصص يقوم بجلب محتوى عنوان URL المحدد من قبل المستخدم أو الذي تم إنشاؤه داخليًا ويعيده ككائن lxml.html.HtmlElement لمزيد من معالجة XPath.///url(...) يشير إلى زحف عميق. يخبر محرك وقت التشغيل بمتابعة تتبع الروابط حتى max_depth المحدد. على عكس القفزات المتكررة url()، يسمح تعبير واحد بوصف استكشاف رسم بياني أعمق. تحذير: استخدم بحذر ومع قيود (عبر max_depth أو مسندات XPath) لتجنب انفجار الاجتياز.انظر DESIGN.md للحصول على تفاصيل تصميم اللغة. سترى المفاهيم الأساسية وتصميم اللغة من الألف إلى الياء.
يقوم wxpath بتقييم تعبير كقائمة من خطوات الاجتياز والاستخراج (يشار إليها داخليًا باسم Segment).
url(...) ينشئ مهام زحف إما بشكل ثابت (عبر عنوان URL ثابت) أو ديناميكيًا (عبر عنوان URL مشتق من تعبير XPath). يتم إزالة تكرار عناوين URL عالميًا، على أساس أفضل جهد - وليس لكل عمق.
تعمل مقاطع XPath على المستندات التي تم جلبها (التي تم جلبها عبر عمليات url(...) السابقة مباشرة).
///url(...) يشير إلى الزحف العميق - يتقدم بطريقة عرضية أولى تقريبًا حتى max_depth.
يتم إرجاع النتائج بمجرد أن تصبح جاهزة.
wxpath يعتمد على asyncio/aiohttp في المقام الأول، ويوفر واجهة برمجة تطبيقات غير متزامنة للزحف واستخراج البيانات.
import asyncio
from wxpath import wxpath_async

items = []

async def main():
    path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
    async for item in wxpath_async(path_expr, max_depth=1):
        items.append(item)

asyncio.run(main())
يوفر wxpath أيضًا واجهة برمجة تطبيقات غير متزامنة ولكن في سياق متزامن، مما يسمح لك بزحف صفحات متعددة بشكل متزامن مع الحفاظ على بساطة الكود المتزامن. هذا مفيد بشكل خاص للزحف في بيئات تنفيذ متزامنة تمامًا (أي ليس داخل حلقة أحداث asyncio) حيث يكون الأداء مهمًا.
from wxpath import wxpath_async_blocking_iter

path_expr = "url('https://en.wikipedia.org/wiki/Expression_language')///url(//@href[starts-with(., '/wiki/')])//a/@href"
items = list(wxpath_async_blocking_iter(path_expr, max_depth=1))
wxpath يحترم robots.txt افتراضيًا عبر المُنشئ WXPathEngine(..., robotstxt=True).
تقوم واجهة برمجة تطبيقات wxpath في Python بإرجاع كائنات منظمة.
اعتمادًا على التعبير، قد تتضمن النتائج:
lxml.* و lxml.html.*elementpath.datatypes.* (لميزات XPath 3.1)WxStr (قيم نصية مع مصدر)تقوم CLI بتسطير هذه الكائنات إلى JSON عادي للعرض. تحتفظ واجهة برمجة تطبيقات Python بالبنية افتراضيًا.
يستخدم wxpath مكتبة elementpath لتوفير دعم XPath 3.1، مما يتيح ميزات XPath متقدمة مثل الخرائط و المصفوفات وغيرها. يتيح لك هذا كتابة استعلامات XPath أكثر قوة.
