 noahware/binprotect
أداة تعقيد bin2bin لملفات PE بمعمارية x64، لا تضيف قسمًا إلى الملف الثنائي.

انظر 4. البناء لتعليمات البناء.
أداة التعتيم هذه هي bin2bin، مما يعني أنها تأخذ ملفًا ثنائيًا قابلاً للتنفيذ تم تجميعه مسبقًا وتعيد إنتاجه مع تمريرات التعتيم المطبّقة. يمكن استخدام ذلك لحماية تطبيق دون الحاجة إلى الوصول إلى الكود المصدري الأصلي. يتم دعم ملفات x64 PE (الملفات القابلة للتنفيذ المحمولة) فقط حاليًا، لكن هناك خططًا لإضافة دعم لصيغ ثنائية أخرى (مثل ELF) في المستقبل.
حاليًا، تُدرج جميع أدوات التعتيم المعروفة من نوع bin2bin قسمًا في نهاية الملف الثنائي لوضع الكود أو البيانات المعتمة داخله. وذلك للحفاظ على التخطيط الأصلي للملف الثنائي دون الحاجة إلى تغيير محتويات الأقسام الموجودة مسبقًا. هذا أسهل بكثير في الإدارة لأنه يُبقي معظم RVAs (العناوين النسبية) صالحة.
يتخذ هذا المشروع نهجًا فريدًا في bin2bin، حيث يتم إدراج أي كود أو بيانات معتمة ضمن الأقسام الأصلية للملف الثنائي. يتطلب ذلك تتبع كل عنوان RVA في التطبيق. فوائد هذا النهج هي:
ستصف هذه الوثيقة كلاً من إعادة كتابة الملف الثنائي القابل للتنفيذ وتقنيات التعتيم المطبقة. تم تنفيذ تقنيات التعتيم التالية:
علاوة على ذلك، يدعم هذا المشروع الاستثناءات (استثناءات C++ وSEH) ويمكنه تعتيم الدوال التي تحتوي على معالجة استثناءات.
للمساعدة في التفكيك واكتشاف الكود في الملف الثنائي، يتم قبول ملفات الرموز (سواء PDB أو MAP) بشكل اختياري. توفير ملفات الرموز ليس ضروريًا ولكنه يساعد في التفكيك في الملفات الثنائية المعقدة. تتطلب بعض الميزات مثل دعم الاستثناءات وتسطيح تدفق التحكم توفير ملف رموز.
أداة إعادة كتابة الثنائيات تأخذ ملفًا ثنائيًا قابلاً للتنفيذ وتغيّر الكود أو البيانات بداخله لإنتاج ملف ثنائي ناتج مع تطبيق التغييرات.
بما أن الكود المعتم يُدرج مباشرة داخل الأقسام الأصلية للملف الثنائي، يجب تتبع العناوين النسبية في البرنامج بحيث يمكن تعديل جميع المراجع إليها. والهدف من ذلك أن تظل المراجع تشير إلى نفس الموقع بعد إدراج الكود والبيانات. وإلا فسيتم الوصول إلى البيانات أو الكود في موقع خاطئ، مما يغيّر سلوك الملف الثنائي الناتج ويسبب عدم استقرار شديد.
عندما يتم العثور على أي مرجع لعنوان نسبي (مثل تعليمة تحتوي على معاملات نسبية لـ rip أو أدلة بيانات PE)، يُضاف إلى قائمة تتبع ليتم تحديثه في نهاية إعادة الكتابة. يتم تتبع RVA حيث يقع المرجع (لمعرفة أين يتم تحديث المرجع) وكذلك RVA المُشار إليه (لمعرفة العنوان الذي سيتم تحديث المرجع به).
عندما يجد المفكك تعليمة نسبية لـ rip، سيضيفها إلى قائمة مراجع ليتم تحديثها في نهاية التعتيم. يضمن ذلك أن جميع هذه التعليمات لا تزال تشير إلى الموقع الذي كانت تشير إليه أصلاً. كما تُضاف حالات أخرى من التعليمات النسبية مثل جداول القفز كمراجع يجب تحديثها.
يجب تعديل جميع RVAs المتتبعة كلما تم إدراج أي بايتات أو إزالتها من الملف الثنائي. على سبيل المثال، هذا هو معالج إدراج البايتات:```cpp
void binwrite::binary_t::insert(const rva_t rva, const std::span data, const bool inclusive)
{
buffer_.insert_range(buffer_.begin() + rva.value(), data);
update_rvas(rva, static_cast<rva_t::size_type>(data.size()), inclusive);
}
`update_rvas` هو المكان الذي يتم فيه تحديث كل RVA مُتتبَّع ليعكس التغيير الذي حدث في الملف الثنائي. فيما يلي مخطط لهذه العملية:
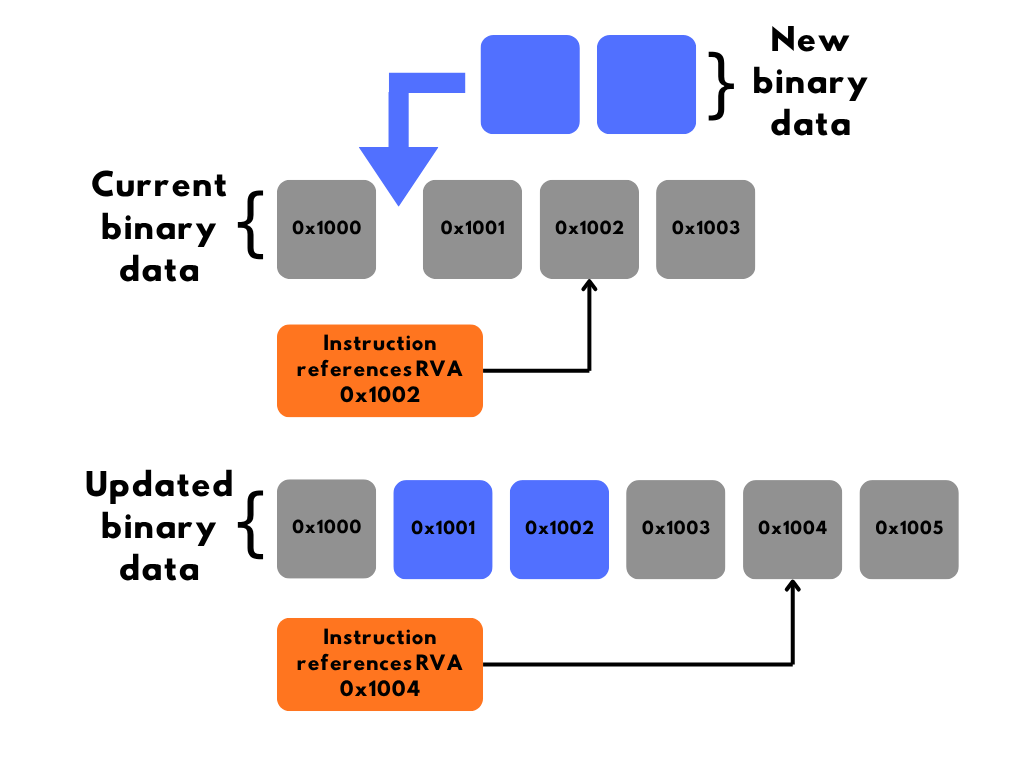
الشكل 1. تتبّع العناوين النسبية (Relative address tracking).
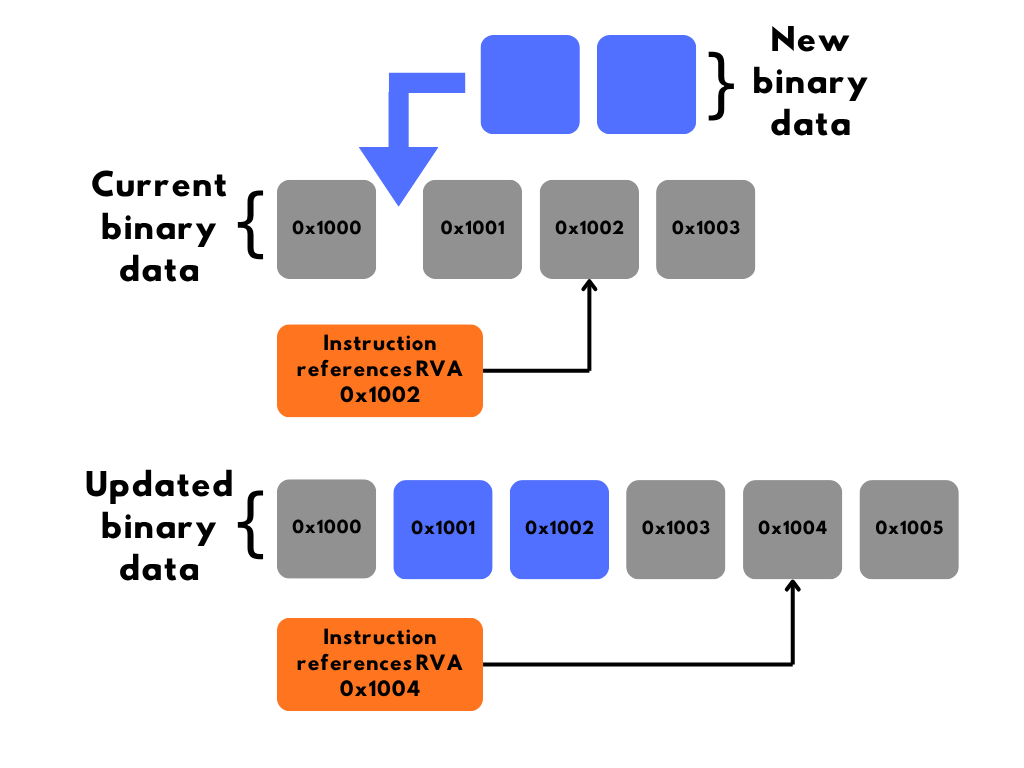
البيانات المُدرَجة (بالأزرق) تُزيح البيانات الحالية (بالرمادي). يتم تحديث RVA المُشار إليه في التعليمات (بالبرتقالي) ليشير إلى نفس الموقع في الذاكرة، مع احتساب البيانات المُدرَجة (بالأزرق).
## 2.2. التفكيك (Disassembly)
تتم إضافة جميع نقاط الدخول المحتملة للكود (الصادرات، نقطة الدخول، عمليات إعادة التوطين التي تشير إلى قسم الكود، إلخ) إلى قائمة انتظار التفكيك. إذا كان ملف الرموز (symbol file) موجودًا، تتم أيضًا إضافة جميع الدوال الموصوفة بواسطة ملف الرموز إلى قائمة انتظار التفكيك. يتم التعامل مع كل إدخال في قائمة الانتظار ككتلة أساسية (basic block) مستقلة.
الكتلة الأساسية هي مجموعة من التعليمات بدون فروع؛ وهذا يعني أنها تُنهى عند تعليمات التحكم في تدفق التنفيذ (مثل jump، ret، int). لا تنتهي الكتل الأساسية عند استدعاءات الدوال (calls) لأنه من المتوقع أن تعود الدالة في معظم الحالات. بعض الدوال لا تعود (مثل `_CxxThrowException`) وستُشار إليها من الآن فصاعدًا باسم استدعاءات 'noreturn'.
عند معالجة كتلة أساسية من قائمة انتظار التفكيك، يتم تفكيك كل تعليمة بدءًا من الأعلى حتى يحدث أحد الأمور التالية:
- الوصول إلى كتلة أساسية أخرى تم تحليلها بالفعل، مما يؤدي إلى تداخل. انظر "تقسيم الكتل الأساسية".
- العثور على تعليمة إنهاء (jump، return، int).
- فشل تفكيك التعليمات.
- العثور على حشوة كود (code padding).
فيما يلي مخطط لعملية التفكيك ودخول قائمة انتظار التفكيك (تم حذف فحص حشوة الكود في المخطط). تتكرر هذه العملية حتى تصبح قائمة انتظار التفكيك فارغة.
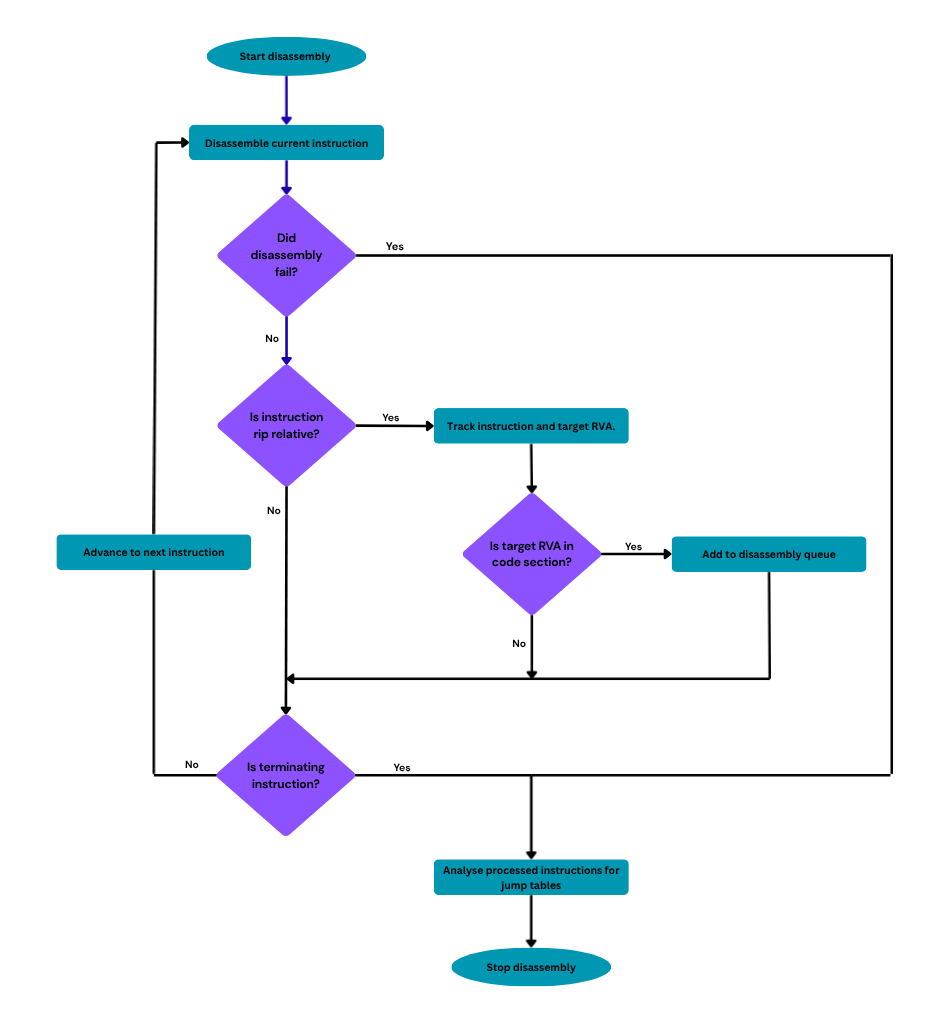
الشكل 2. معالجة التفكيك.
### 2.2.1 تقسيم الكتل الأساسية
إذا تداخلت كتلتان أساسيتان، فيجب تقسيم إحداهما. وهذا يمنع كتلتين من وصف نفس التعليمات. على سبيل المثال:```asm
wcslen proc
or rax, 0FFFFFFFFFFFFFFFFh
loc_140001078:
inc rax
cmp word ptr [rcx+rax*2], 0
jnz short loc_140001078
retn
wcslen endp
هذا هو تنفيذ wcslen، الذي يحصل على طول سلسلة عريضة. عندما يتم تفكيك التعليمات الأولى 'or rax, FFFFFFFFFFFFFFFF' كبداية لكتلة أساسية، فإنها ستستمر في التفكيك حتى 'retn'.
تقفز التعليمات 'jnz loc_140001078' إلى الأعلى لتشكيل حلقة. ستتم إضافة هذا كمرجع، وسيتم إضافة هدف jnz إلى قائمة انتظار التفكيك بالإضافة إلى فرع التتابع (التعليمة التالية). تقفز التعليمات في منتصف الكتلة التي تم تحليلها بالفعل، لذا لا يمكنها ببساطة تشكيل كتلة جديدة والتفكيك مرة أخرى حتى 'retn' لأن ذلك سيمثل تكرارًا.
ستأخذ 'jnz' (القفزة الشرطية) أيضًا فرع التتابع لإنشاء كتلة أساسية جديدة أيضًا. الآن سيكون هناك 4 كتل أساسية تبدو كالتالي:
