 jaidedai/easyocr
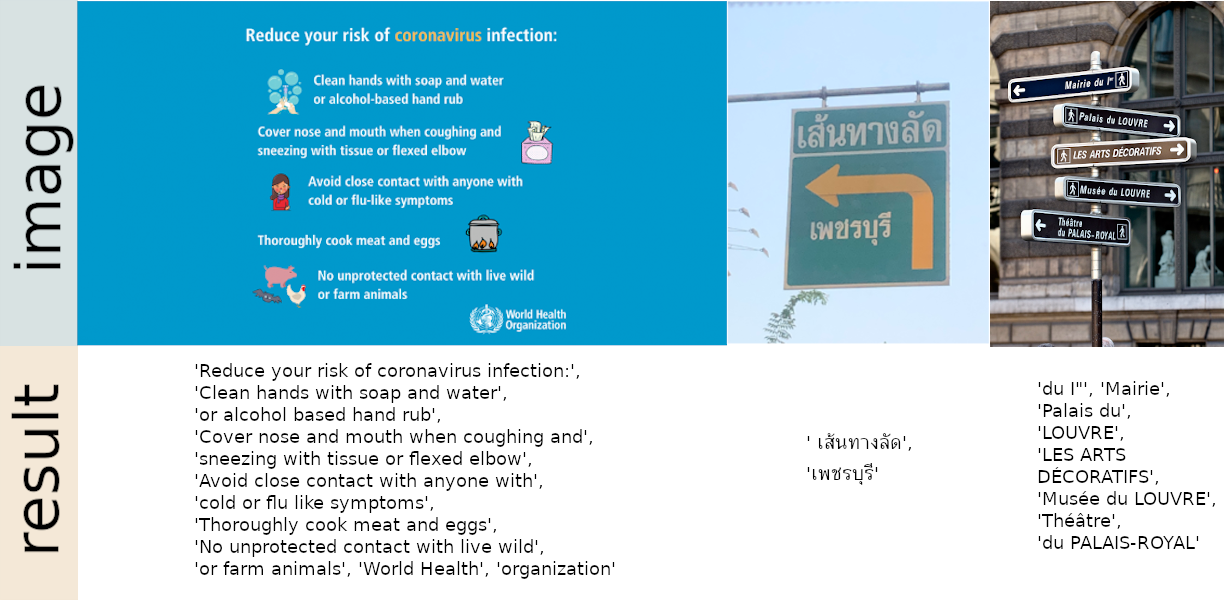
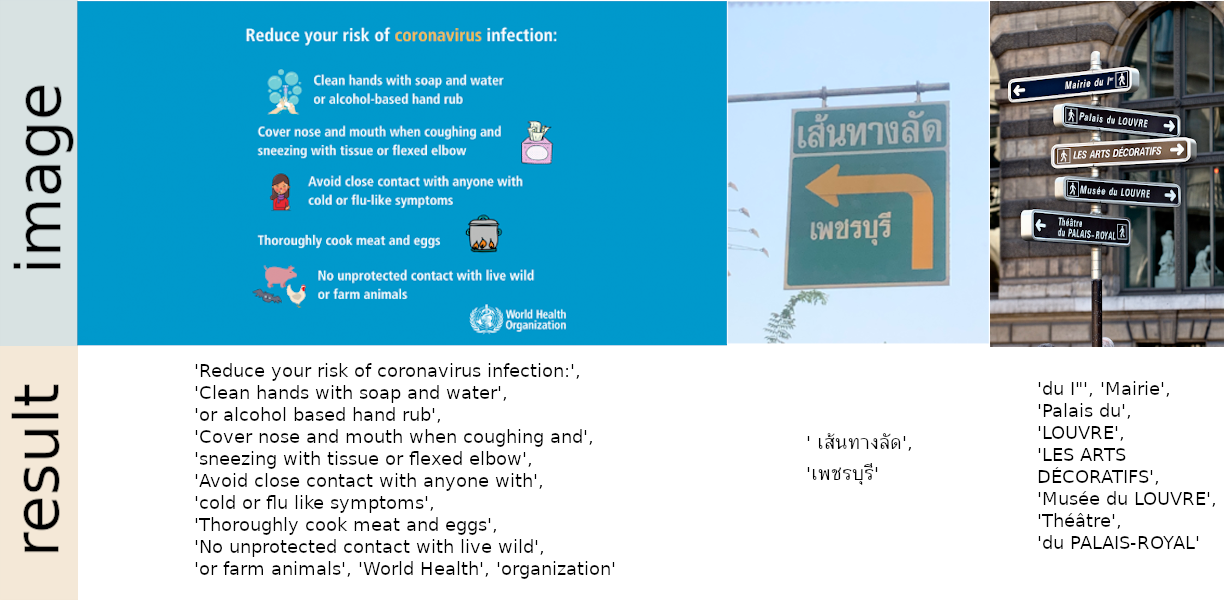
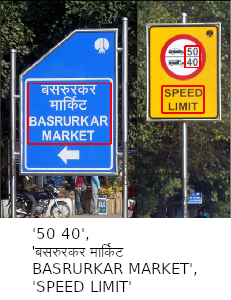
أداة OCR جاهزة للاستخدام تدعم أكثر من 80 لغة وجميع أنظمة الكتابة الشائعة بما في ذلك اللاتينية والصينية والعربية والديفاناغارية والسيريلية وغيرها.


أداة OCR جاهزة للاستخدام تدعم أكثر من 80 لغة مدعومة وجميع أنظمة الكتابة الشائعة بما في ذلك: اللاتينية، والصينية، والعربية، والديفاناغارية، والسيريلية، وغيرها.
جرّب العرض التوضيحي على موقعنا الإلكتروني
مدمجة في Huggingface Spaces 🤗 باستخدام Gradio. جرّب العرض التوضيحي على الويب:
24 سبتمبر 2024 - الإصدار 1.7.2
ثبّت باستخدام pip
للحصول على أحدث إصدار مستقر:
pip install easyocr
للحصول على أحدث إصدار تطويري:
pip install git+https://github.com/JaidedAI/EasyOCR.git
ملاحظة 1: بالنسبة لنظام Windows، يُرجى تثبيت torch وtorchvision أولاً باتباع التعليمات الرسمية هنا https://pytorch.org. في موقع pytorch، تأكد من اختيار إصدار CUDA الصحيح لديك. إذا كنت تنوي التشغيل في وضع CPU فقط، فاختر CUDA = None.
ملاحظة 2: نوفر أيضًا ملف Dockerfile هنا.
ملاحظة 3: يقوم كاشف DBNet الاختياري (detect_network='dbnet18') بترجمة عملياته C++/CUDA عند أول استخدام، وهو ما يتطلب أداة البناء Ninja. لتثبيته مع EasyOCR، استخدم pip install "easyocr[dbnet]".
import easyocr
reader = easyocr.Reader(['ch_sim','en']) # this needs to run only once to load the model into memory
result = reader.readtext('chinese.jpg')
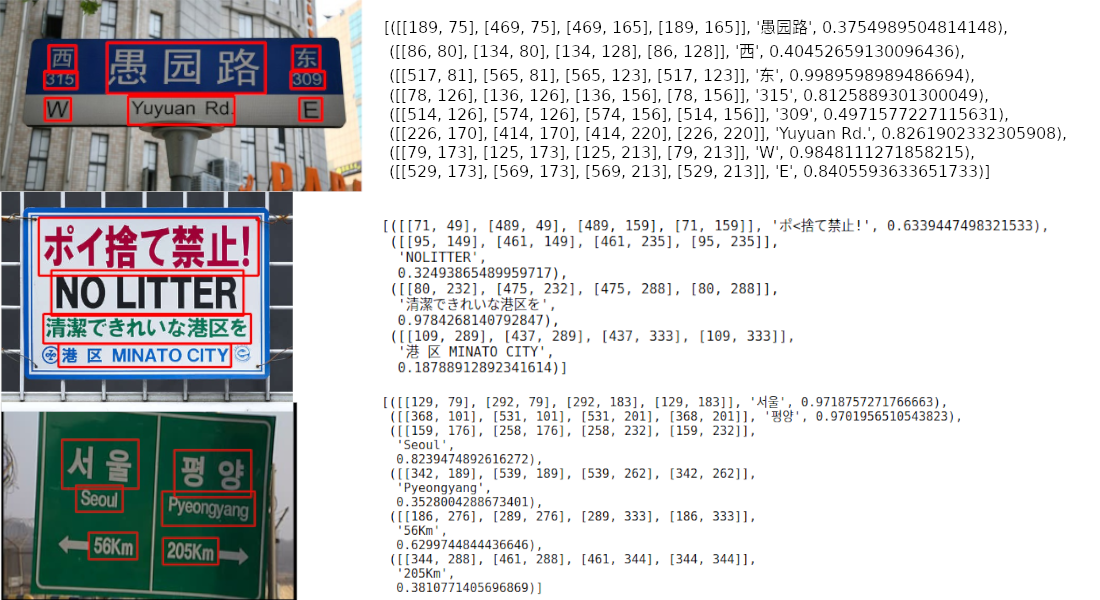
سيكون المخرجات بتنسيق قائمة، حيث يمثل كل عنصر مربع إحاطة، والنص المكتشف ومستوى الثقة، على الترتيب.
[([[189, 75], [469, 75], [469, 165], [189, 165]], '愚园路', 0.3754989504814148),
 ([[86, 80], [134, 80], [134, 128], [86, 128]], '西', 0.40452659130096436),
 ([[517, 81], [565, 81], [565, 123], [517, 123]], '东', 0.9989598989486694),
 ([[78, 126], [136, 126], [136, 156], [78, 156]], '315', 0.8125889301300049),
 ([[514, 126], [574, 126], [574, 156], [514, 156]], '309', 0.4971577227115631),
 ([[226, 170], [414, 170], [414, 220], [226, 220]], 'Yuyuan Rd.', 0.8261902332305908),
 ([[79, 173], [125, 173], [125, 213], [79, 213]], 'W', 0.9848111271858215),
 ([[529, 173], [569, 173], [569, 213], [529, 213]], 'E', 0.8405593633651733)]
ملاحظة 1: ['ch_sim','en'] هي قائمة اللغات التي تريد قراءتها. يمكنك تمرير عدة لغات في وقت واحد، لكن ليس كل اللغات يمكن استخدامها معًا. اللغة الإنجليزية متوافقة مع كل لغة، واللغات التي تشترك في أحرف مشتركة عادةً ما تكون متوافقة مع بعضها البعض.
ملاحظة 2: بدلاً من مسار الملف chinese.jpg، يمكنك أيضًا تمرير كائن صورة OpenCV (مصفوفة numpy) أو ملف صورة كبايتات. كما أن عنوان URL لصورة خام مقبول أيضًا.
ملاحظة 3: السطر reader = easyocr.Reader(['ch_sim','en']) مخصص لتحميل نموذج إلى الذاكرة. يستغرق بعض الوقت لكنه يحتاج إلى التشغيل مرة واحدة فقط.
يمكنك أيضًا تعيين detail=0 للحصول على مخرجات أبسط.
reader.readtext('chinese.jpg', detail = 0)
النتيجة:
['愚园路', '西', '东', '315', '309', 'Yuyuan Rd.', 'W', 'E']
سيتم تنزيل أوزان النموذج للغة المختارة تلقائيًا أو يمكنك تنزيلها يدويًا من مركز النماذج ووضعها في مجلد '~/.EasyOCR/model'
في حال لم يكن لديك GPU، أو كانت ذاكرة GPU لديك منخفضة، يمكنك تشغيل النموذج في وضع CPU فقط بإضافة gpu=False.
reader = easyocr.Reader(['ch_sim','en'], gpu=False)
لمزيد من المعلومات، اقرأ البرنامج التعليمي ووثائق API.
$ easyocr -l ch_sim en -f chinese.jpg --detail=1 --gpu=True
بالنسبة لنموذج التعرّف، اقرأ هنا.
بالنسبة لنموذج الكشف (CRAFT)، اقرأ هنا.
reader = easyocr.Reader(['en'], detection='DB', recognition = 'Transformer')
الفكرة هي أن تكون قادرًا على توصيل أي نموذج من أحدث الطرازات إلى EasyOCR. هناك الكثير من العباقرة الذين يحاولون صنع نماذج أفضل للكشف/التعرف، لكننا لا نحاول أن نكون عباقرة هنا. نحن فقط نريد جعل أعمالهم متاحة بسرعة للجمهور ... مجانًا. (حسنًا، نعتقد أن معظم العباقرة يريدون أن يُحدث عملهم تأثيرًا إيجابيًا بأسرع/أكبر قدر ممكن) يجب أن تكون خط الأنابيب شيئًا مثل المخطط أدناه. الخانات الرمادية هي عناصر نائبة لوحدات زرقاء فاتحة قابلة للتغيير.
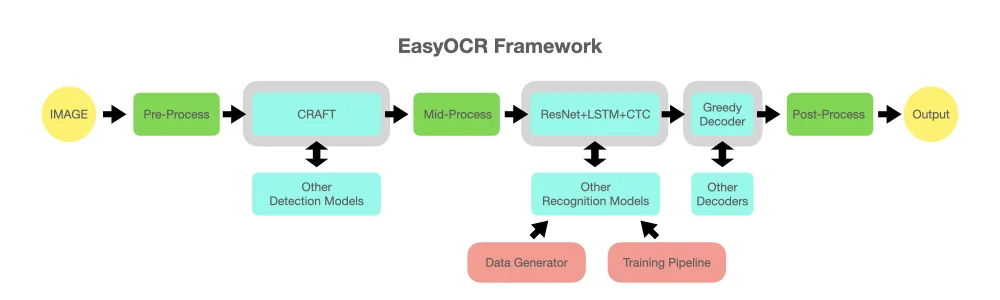
يعتمد هذا المشروع على أبحاث وشيفرة من عدة أوراق ومستودعات مفتوحة المصدر.
يعتمد تنفيذ جميع عمليات التعلم العميق على Pytorch. ❤️
يستخدم تنفيذ الكشف خوارزمية CRAFT من هذا المستودع الرسمي وورقتهم (شكرًا @YoungminBaek من @clovaai). نستخدم أيضًا نموذجهم المدرب مسبقًا. سكربت التدريب مقدم من @gmuffiness.
نموذج التعرف هو CRNN (الورقة). يتكون من 3 مكونات رئيسية: استخراج الميزات (نستخدم حاليًا Resnet) وVGG، ووسم التسلسل (LSTM) وفك الترميز (CTC). خط أنابيب التدريب لتنفيذ التعرف هو نسخة معدلة من إطار عمل deep-text-recognition-benchmark. (شكرًا @ku21fan من @clovaai) هذا المستودع جوهرة تستحق المزيد من التقدير.
تعتمد شيفرة البحث الشعاعي (beam search) على هذا المستودع ومدونته. (شكرًا @githubharald)
يعتمد تركيب البيانات على TextRecognitionDataGenerator. (شكرًا @Belval)
وقراءة جيدة عن CTC من distill.pub هنا.
لننهض بالبشرية معًا بجعل الذكاء الاصطناعي متاحًا للجميع!
3 طرق للمساهمة:

