 iqsec-lab/freemoca
إطار عمل تعلّم مستمر بدون حفظ للذاكرة لتصنيف البرمجيات الخبيثة باستخدام الاستيفاء القائم على اتصال الأنماط. يدعم سيناريوهات الزيادة الصفية والزيادة النطاقية على مجموعتي بيانات EMBER وAndrozoo.

[!NOTE] هذا هو التنفيذ الرسمي للورقة البحثية Continual Learning Trajectory as Memory for Replay-Free Consolidation in Malicious Code Analysis.
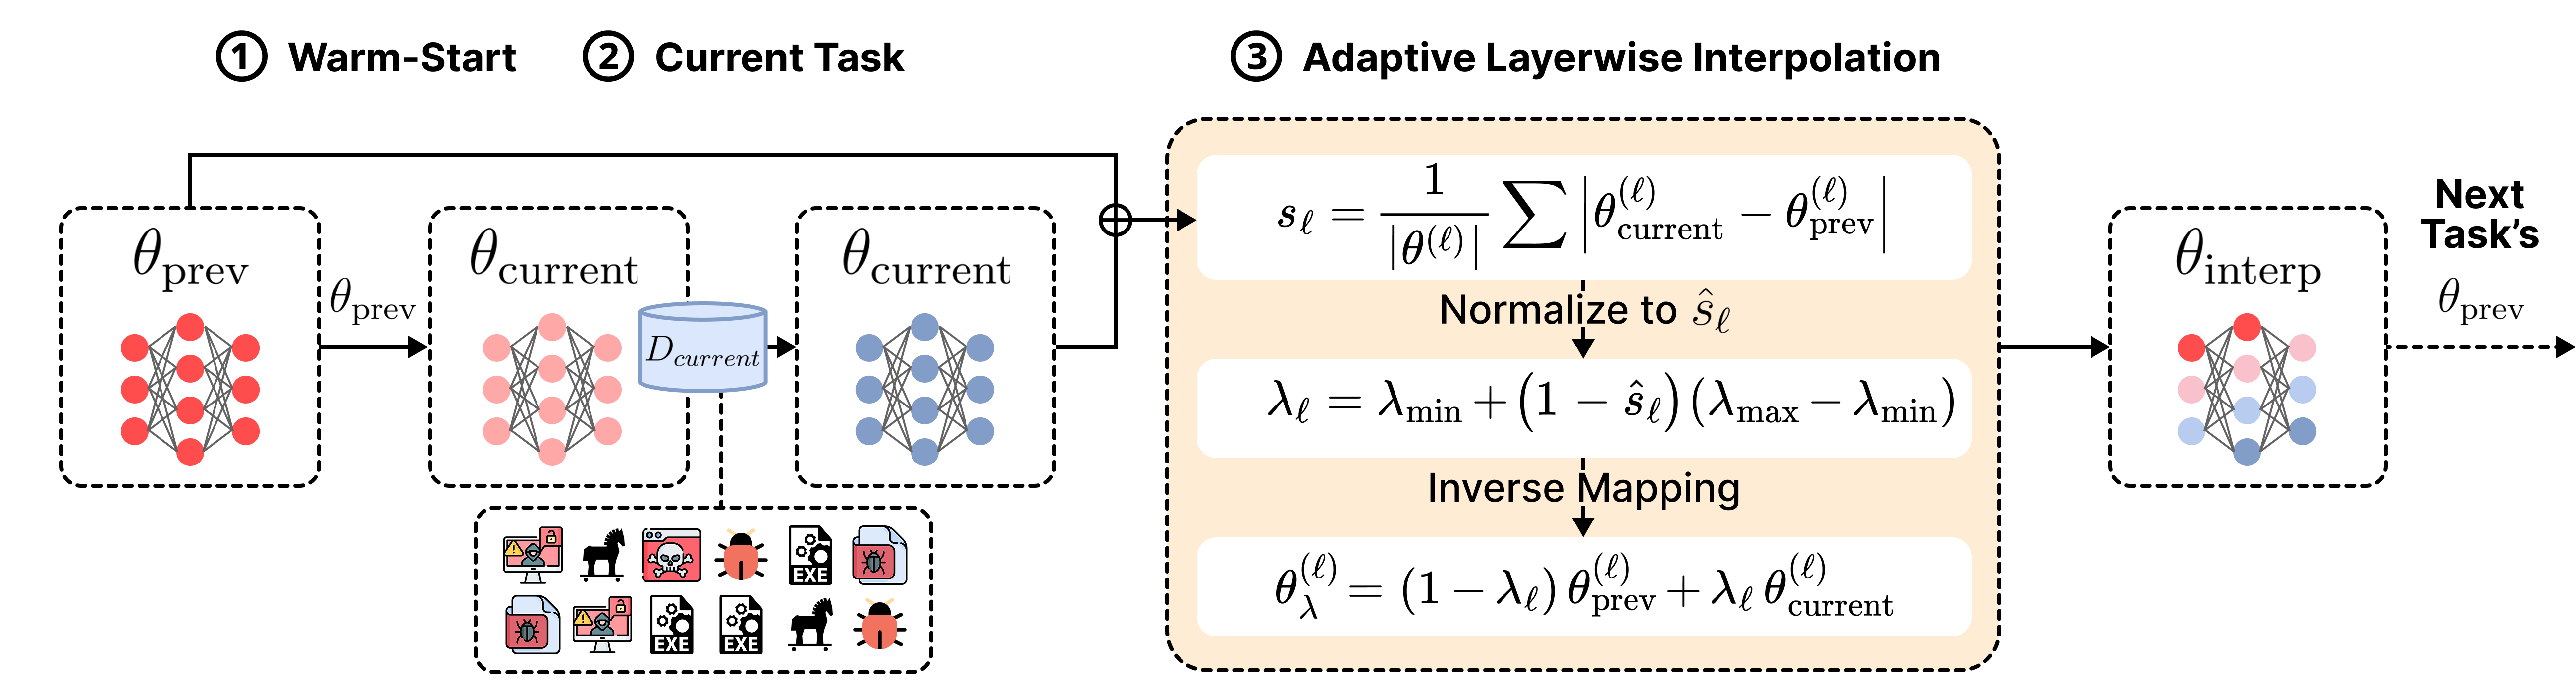
يعمل FreeMOCA وفق العملية التالية:
تبني العملية بأكملها سلسلة من الحلول المترابطة التي تقع على متعدد شعب منخفض الخسارة، مما يقلل بشكل كبير من النسيان الكارثي.
تم تقييم FreeMOCA باستخدام مجموعتي بيانات كبيرتين للبرمجيات الخبيثة، هما EMBER وAndrozoo. مصادر مجموعات البيانات:
قم بتنزيل مجموعة البيانات وإعدادها في الدليل التالي:
FreeMOCA/data/
├── AZ_Class
│   ├── AZ_Class_Test.npz
│   └── AZ_Class_Train.npz
│
├── AZ_Domain
│   ├── 2008_Domain_AZ_Test_Transfo...
│   ├── 2008_Domain_AZ_Train_Transfo...
│   ├── 2009_Domain_AZ_Test_Transfo...
│   └── ...
│
├── EMBER_Class
│   ├── XY_test.npz
│   └── XY_train.npz
│
└── EMBER_Domain
    ├── 2018-01
    ├── 2018-02
    ├── 2018-03
    └── ...
يدعم هذا المستودع سيناريوهين للتعلم المستمر:
قم بتشغيل الأمر التالي من أجل
conda create -n freemoca python=3.9
conda activate freemoca
pip install -r requirements.txt
# EMBER Class-IL
cd ./FreeMOCA_Class/EMBER_Class
CUDA_VISIBLE_DEVICES=0 python main.py --train_data /path/to/data --test_data /path/to/data
# AZ Class-IL
cd ./FreeMOCA_Class/AZ_Class
CUDA_VISIBLE_DEVICES=0 python main.py --train_data /path/to/data --test_data /path/to/data
# EMBER Domain-IL
cd ./FreeMOCA_Domain/EMBER_Domain
CUDA_VISIBLE_DEVICES=0 python main.py --data_root /path/to/data/directory
# AZ Domain-IL
cd ./FreeMOCA_Domain/AZ_Domain
CUDA_VISIBLE_DEVICES=0 python main.py --data_root /path/to/data/directory
للحصول على إعداد أكثر تفصيلاً للمعاملات الفائقة، راجع الملحق أ. الوسائط الشائعة لـ FreeMOCA.
لضبط المعاملات الفائقة أو الإعدادات التجريبية، استخدم الوسائط التالية:
| الوسيط | الوصف |
|---|---|
--init_classes | عدد الفئات في المهمة 0 |
--epochs | عدد الحقب لكل مهمة |
--batchsize | حجم الدفعة |
--lr | معدل التعلم |
--momentum | زخم SGD |
--weight_decay | تحلل الوزن |
--lambda_min | الحد الأدنى لوزن الاستيفاء |
--lambda_max | الحد الأقصى لوزن الاستيفاء |
لتغيير الإعداد الافتراضي للوسائط، راجع ملف arguments.py.
يدعم مستودعنا التجارب على خطوط الأساس القياسية التالية:
يمكنك تشغيله بالأمر التالي:
cd /path/to/experiment/directory
CUDA_VISIBLE_DEVICES=0 python none.py --arugment_you_want
CUDA_VISIBLE_DEVICES=0 python joint.py --arugment_you_want
وباتباع الأعمال السابقة:
يمكنك تشغيل خطوط الأساس بالأمر التالي:
# CLeWI for EMBER-Class
cd ./baselines/CLeWI
CUDA_VISIBLE_DEVICES=6 python main.py --model="clewi" \
  --dataset="seq_ember" --n_tasks=11 \
  --lr=0.001 --buffer_size=500 --n_epochs=50 \
  --seed=42 --optim_wd=0.0 --optim_mom=0.0 \
  --batch_size=512 --sub_dataset="ember"

# CLeWI for AZ-Class
cd ./baselines/CLeWI
CUDA_VISIBLE_DEVICES=6 python main.py --model="clewi" \
  --dataset="seq_ember" --n_tasks=11 \
  --lr=0.001 --buffer_size=500 --n_epochs=50 \
  --seed=42 --optim_wd=0.0 --optim_mom=0.0 \
  --batch_size=512 --sub_dataset="az"
# WSC for EMBER-Class
cd ./baselines/WSC
MODEL_NAME=wsc_20_ember
python main.py --config=./exps/wsc_memory/$MODEL_NAME.json
# WSC for AZ-Class
cd ./baselines/WSC
MODEL_NAME=wsc_20_az
python main.py --config=./exps/wsc_memory/$MODEL_NAME.json
# GR for EMBER-Class
cd ./baselines/GR_EWC_LwF_iCaRL_EMBER
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=EMBER --tasks=11 --replay=generative --metrics --logger_file gr --scenario=class

# GR for AZ-Class
cd ./baselines/GR_EWC_LwF_iCaRL_AZ
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=ANDROZOO --tasks=11 --replay=generative --metrics --logger_file gr --scenario=class
# EWC for EMBER-Class
cd ./baselines/GR_EWC_LwF_iCaRL_EMBER
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=EMBER --tasks=11 --ewc --lambda=50 --metrics --logger_file ewc --scenario=class

# EWC for AZ-Class
cd ./baselines/GR_EWC_LwF_iCaRL_AZ
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=ANDROZOO --tasks=11 --ewc --lambda=50 --metrics --logger_file ewc --scenario=class
# LwF for EMBER-Class
cd ./baselines/GR_EWC_LwF_iCaRL_EMBER
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=EMBER  --tasks=11 --replay=current --distill --metrics --logger_file lwf --scenario=class

# LwF for AZ-Class
cd ./baselines/GR_EWC_LwF_iCaRL_AZ
CUDA_VISIBLE_DEVICES=0 python main.py --data_set=AZ  --tasks=11 --replay=current --distill --metrics --logger_file lwf --scenario=class
# iCaRL for EMBER-Class
cd ./baselines/GR_EWC_LwF_iCaRL_EMBER
CUDA_VISIBLE_DEVICES=1 python main.py --data_set=EMBER --tasks=11 --icarl --budget=2000 --metrics --logger_file=icarl --scenario=class
