 bunelysiareact/scrapper
كشط الويب بطريقة سهلة

سكربّر ليس أداة كشط — إنه مراقب جلسة يلتقط بيانات متصفحك الحقيقية لاستخدامها في أي أداة أتمتة.
مبني على إطار عمل BertUI React
GitHub: BunElysiaReact/SCRAPY
لا نطاق. لا سحابة. كل شيء محلي. كل شيء لك.
كل أداة أتمتة ويب — Puppeteer، Playwright، Selenium، وحتى curl — تواجه نفس التحديات:
المشكلة الحقيقية: كل هذه الأدوات تحاول تقليد البشر. لكنها تخمّن كيف يبدو الإنسان الحقيقي.
سكربّر لا يقوم بالكشط. إنه يعطيك البيانات الحقيقية التي تحتاجها للكشط بنجاح.
أنت                                              سكربّر
  │                                                  │
  ├── افتح Brave/Chrome/Firefox مع الإضافة ──────►│
  │                                                  │
  ├── سجل الدخول إلى المواقع التي تريد أتمتتها ──────►│ يلتقط:
  │                                                  │  • كوكيز
  ├── تصفح بشكل طبيعي، انقر على الأزرار ────────────►│  • رموز
  │                                                  │  • بصمة
  └── انتهى التصفح ─────────────────────────────────►│  • طلبات API
                                                     │  • هيكل DOM
نصِّك البرمجي ──── GET /api/v1/session/all ────► API سكربّر (localhost:8080)
              ◄── { cookies, tokens, fingerprint } ────────────────────────┘
                │
                ▼
         Puppeteer / Playwright / Selenium / طلبات Python / curl
                │
                ▼
         ✅ طلبات مصادق عليها باستخدام جلستك الحقيقية
إضافة سكربّر
تسجيل الإضافة
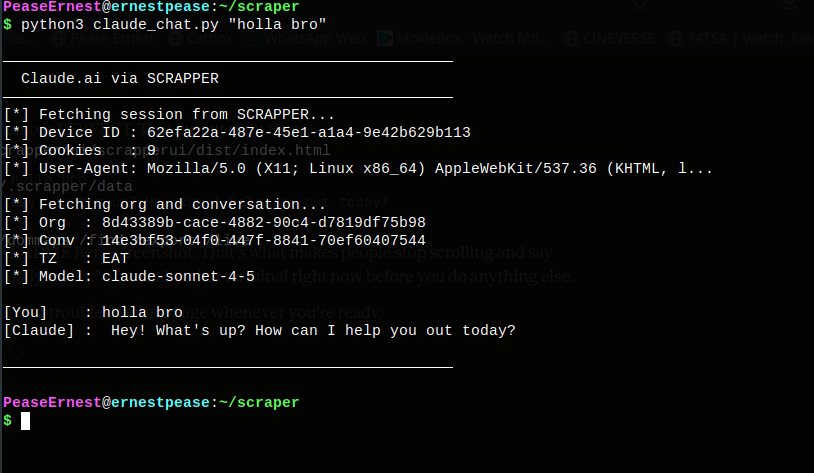
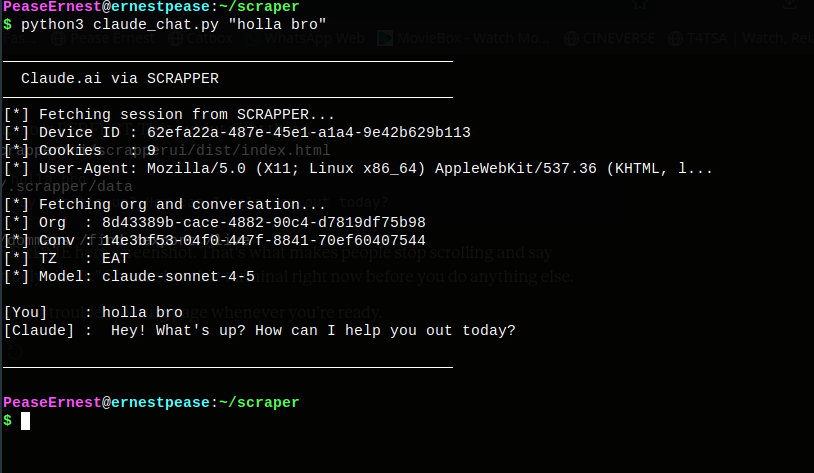
النص البرمجي أعلاه استخدم سكربّر لالتقاط جلسة حقيقية من claude.ai، ثم أرسل الرسائل مباشرة عبر API — بدون كود تسجيل دخول، بدون Puppeteer، بدون أتمتة متصفح.
📦 بيانات الجلسة
   ├── 🍪 كوكيز (بما في ذلك HttpOnly، Secure، جميع النطاقات)
   ├── 💾 التخزين المحلي وتخزين الجلسة
   ├── 🔑 رموز المصادقة (Bearer، JWT، CSRF، مخصصة)
   └── 📨 جميع رؤوس HTTP

🖥️ بصمة المتصفح
   ├── 📱 وكيل المستخدم
   ├── 🖼️ دقة الشاشة وعمق الألوان
   ├── 🌍 المنطقة الزمنية وإعدادات اللغة
   └── 📨 مجموعة الرؤوس الكاملة (Accept، Accept-Language، إلخ.)

📡 حركة الشبكة
   ├── 📤 جميع طلبات HTTP (عناوين URL، طرق، رؤوس، بيانات POST)
   ├── 📥 جميع استجابات HTTP (الحالة، الرؤوس، الأجسام)
   └── 🔄 إطارات WebSocket

🌳 حالة DOM
   ├── 📄 لقطات DOM
   ├── 🎯 اختبار المحددات الحية
   └── 🗺️ خرائط DOM (جميع العلامات، الفئات، المعرفات)
بمجرد الالتقاط، يخدم سكربّر كل شيء عبر REST API بسيط على http://localhost:8080.
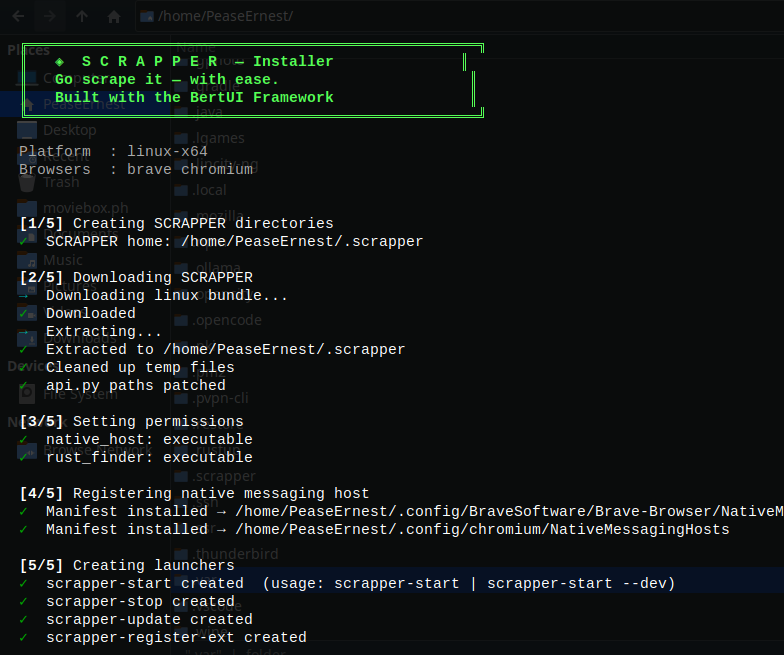
curl -fsSL https://raw.githubusercontent.com/BunElysiaReact/SCRAPY/main/install.sh | bash
# الخطوة 1 — تحميل الإضافة في Brave:
# brave://extensions → وضع المطور تشغيل → تحميل غير معبأ
# → اختر: ~/.scrapper/extension/brave/

# الخطوة 2 — تسجيل معرف الإضافة الخاص بك
scrapper-register-ext YOUR_EXTENSION_ID

# الخطوة 3 — تشغيل سكربّر
scrapper-start

# الخطوة 4 — افتح لوحة التحكم
# http://localhost:8080
# استنساخ المستودع
git clone https://github.com/BunElysiaReact/SCRAPY.git ~/scrapper
cd ~/scrapper

# بناء المضيف الأصلي C
gcc -O2 -o linux/c_core/native_host/debug_host linux/c_core/native_host/debug_host.c -lpthread

# بناء محرك المحددات Rust
cd linux/rust_finder && cargo build --release && cd ../..

# تشغيل خادم API
cd linux/python_api && python3 api.py
افتح http://localhost:8080 ← لوحة التحكم جاهزة.
irm https://raw.githubusercontent.com/BunElysiaReact/SCRAPY/main/install.ps1 | iex
⚠️ قم بتشغيل PowerShell كمسؤول لكي يعمل تسجيل المراسلة الأصلية بشكل صحيح.
%USERPROFILE%\.scrapper\
├── bin\
│   ├── debug_host.exe         ← مضيف المراسلة الأصلية C
│   ├── scraper_cli.exe        ← عميل CLI
│   ├── rust_finder.exe        ← محرك محددات HTML سريع
│   ├── scrapper-start.bat     ← تشغيل كل شيء
│   └── scrapper-stop.bat      ← إيقاف كل شيء
├── data\                      ← جميع بيانات الجلسة الملتقطة
├── logs\                      ← سجلات المضيف
├── python_api\
│   └── api.py                 ← خادم REST API
├── extension\
│   ├── brave\                 ← تحميل في Brave / Chrome / Edge
│   └── firefox\               ← تحميل في Firefox
└── ui\scrapperui\             ← مصدر لوحة التحكم
brave://extensions أو chrome://extensions~/.scrapper/extension/brave/scrapper-register-ext YOUR_IDنفس طريقة Brave/Chrome — Edge مبني على Chromium، استخدم مجلد extension/brave/.
about:debugging → Firefox هذا~/.scrapper/extension/firefox/manifest.json⚠️ Firefox يلتقط الكوكيز والرؤوس والتخزين المحلي — ولكن ليس أجسام الطلبات على مستوى CDP.
from curl_cffi import requests

API = "http://localhost:8080"
domain = "example.com"

cookies_raw = requests.get(f"{API}/api/v1/session/cookies?domain={domain}").json()
fp = requests.get(f"{API}/api/v1/fingerprint?domain={domain}").json()

session = requests.Session(impersonate="chrome120")
for c in cookies_raw:
    session.cookies.set(c["name"], c["value"], domain=c.get("domain", domain).lstrip("."))
session.headers.update({"User-Agent": fp.get("userAgent", "")})

response = session.get(f"https://{domain}/api/data")
print(response.json())
import requests

session_data = requests.get('http://localhost:8080/api/v1/session/all').json()

s = requests.Session()
s.cookies.update({c['name']: c['value'] for c in session_data['cookies']})
s.headers.update({'User-Agent': session_data['fingerprint']['userAgent']})

response = s.get('https://api.example.com/data')
source <(curl -s http://localhost:8080/api/v1/export/env)

curl -X POST "https://api.example.com/upload" \
  -H "Authorization: Bearer $SCRAPPER_BEARER_TOKEN" \
  -b "$SCRAPPER_COOKIES" \
  -F "[email protected]"
import requests
from playwright.async_api import async_playwright

session = requests.get('http://localhost:8080/api/v1/session/all').json()

async with async_playwright() as p:
    context = await p.chromium.launch_persistent_context(
        user_data_dir="./profile",
        user_agent=session['fingerprint']['userAgent'],
    )
    await context.add_cookies(session['cookies'])
    page = await context.new_page()
    await page.goto('https://example.com')
const session = await fetch('http://localhost:8080/api/v1/session/all').then(r => r.json());

const browser = await puppeteer.launch();
const page = await browser.newPage();
await page.setCookie(...session.cookies);
await page.setUserAgent(session.fingerprint.userAgent);
await page.goto('https://example.com/dashboard');
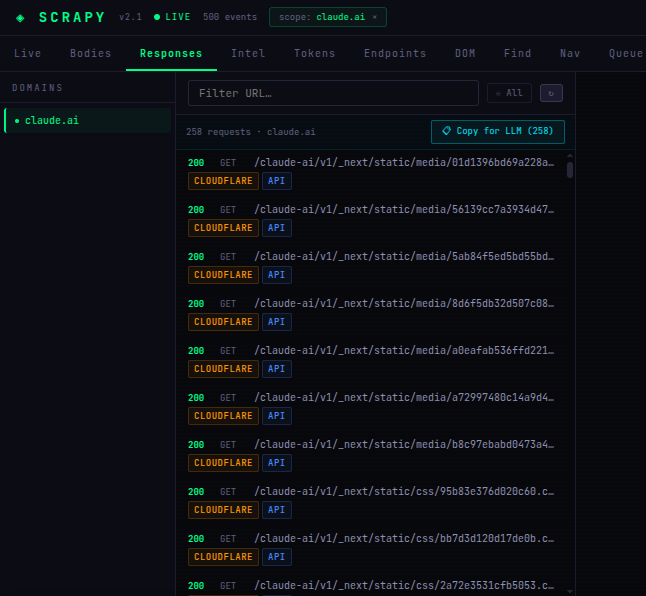
لوحة تحكم سكربّر المباشرة
افتح http://localhost:8080:
# تصدير أحدث بيانات الجلسة
curl -s "http://localhost:8080/api/v1/bulk/all?format=jsonl" > session.jsonl

# استخدمها في أداة الكشط الخاصة بك
python3 my-scraper.py --session session.jsonl
# session_refresh.py — خط أنابيب تحديث الجلسة الأسبوعي
import requests, schedule, time

def refresh_session():
    notify_user("يرجى تسجيل الدخول إلى المواقع المستهدفة في متصفحك")
    time.sleep(300)  # 5 دقائق ليتصفح المستخدم
    data = requests.get('http://localhost:8080/api/v1/bulk/all?format=json').json()
    with open(f'session_{int(time.time())}.json', 'w') as f:
        import json; json.dump(data, f)

schedule.every().monday.at("09:00").do(refresh_session)
while True:
    schedule.run_pending()
    time.sleep(60)
سكربّر من BertUI — مراقب الجلسة لأتمتة الويب
🔍 يراقب متصفحك حتى لا تضطر إلى ذلك
⭐ أعط نجمة للمستودع إذا ساعدك سكربّر — فهذا يساعد الآخرين في العثور عليه!
| التحدي | لماذا هو صعب |
|---|
| المصادقة | كتابة نصوص برمجية يدوية لتسجيل الدخول لكل موقع أمر ممل وهش |
| حالة الجلسة | تنتهي صلاحية الكوكيز، وتدور الرموز، ويتم مسح التخزين المحلي |
| الهندسة العكسية | ساعات تقضيها في DevTools لفهم أنماط API |
| كشف البوتات | بصمات TLS، إنتروبيا المتصفح، Cloudflare، hCaptcha |
| تعقيد الإعداد | صراع مع المتصفحات عديمة الرأس والبروكسيات والإضافات التخفيّة |
| سكربّر هو... | سكربّر ليس... |
|---|
| 🔍 مراقب جلسة يراقب متصفحك الحقيقي | ❌ بديلاً عن Puppeteer/Playwright/Selenium |
| 💾 أداة التقاط بيانات تحفظ جلستك الفعلية | ❌ أداة كشط مواقع ويب نيابة عنك |
| 📡 خادم API محلي يخدم بياناتك الملتقطة | ❌ خدمة مستضافة أو منصة سحابية |
| 🧠 مساعد هندسة عكسية يكشف APIs مخفية | ❌ زر سحري "اكشط أي شيء" |
| 🎯 مصحح بصري لفهم بنية الموقع | ❌ أداة أتمتة بدون كود |
| الميزة | لماذا تهم |
|---|
| تجاوز كشف البوتات المتقدم | يستخدم curl_cffi لتقمّص بصمة TLS لمتصفح حقيقي (مثل Chrome 120) — لا يتم وضع علامة عليه كآلي |
| معدل نجاح 97% | يستهدف مسارات API الداخلية، وليس واجهة المستخدم المرئية — محصن ضد تغييرات CSS، الأزرار المتحركة، أو تغييرات التخطيط |
| استخدام منخفض للموارد | ~20MB رام مقابل 500MB+ لـ Puppeteer/Selenium. لا يوجد محرك متصفح يعمل |
| مصادقة غير مرئية | يستغل جلستك الحالية التي تم التحقق منها بشريًا — بدون تدفق تسجيل دخول، بدون CAPTCHAs |
| مزامنة مع المتصفح الحقيقي | تظهر الرسائل / الإجراءات من النصوص البرمجية في علامة تبويب متصفحك الحقيقي عند التحديث |
| غير مرتبط بلغة برمجة | يعمل API الجلسة مع Python، Go، Rust، Node، curl — أي شيء يمكنه إجراء طلبات HTTP |
| العيب | ما يعنيه |
|---|
| عمر جلسة هش | يعتمد كليًا على جلسة متصفح نشطة — تنتهي إذا قمت بتسجيل الخروج |
| يعتمد على APIs داخلية | يستخدم نقاط نهاية غير موثقة يمكن أن تتغير دون إشعار |
| يتطلب بنية تحتية للإعداد | ليس مستقلاً — يتطلب تشغيل مضيف أصلي وإضافة متصفح في وقت واحد |
| خطر على الحساب | يستخدم هويتك الحقيقية. يمكن أن يؤدي الضرب بمعدل عدواني إلى حظر حسابك الحقيقي |
| منحنى تعلم | يجب قراءة حركة الشبكة لفهم حمولات API الصحيحة |
| ربط بجهاز واحد | device-id مرتبط بجلسة واحدة ملتقطة — لا يمكن مشاركته بسهولة عبر الأجهزة |
| نقطة النهاية | الوصف |
|---|
GET /api/v1/session/cookies?domain=example.com | جميع الكوكيز لنطاق |
GET /api/v1/session/localstorage?domain=example.com | بيانات التخزين المحلي |
GET /api/v1/session/all | تفريغ جلسة كامل |
GET /api/v1/fingerprint | بصمة المتصفح |
GET /api/v1/tokens/all | جميع الرموز المستخرجة |
GET /api/v1/requests/recent?limit=50 | طلبات الشبكة الأخيرة |
GET /api/v1/dom/snapshot?url=example.com | لقطة DOM |
GET /api/v1/export/env | صيغة متغيرات البيئة |
GET /api/v1/bulk/all?format=[json|jsonl|har|csv|txt] | كل شيء، الصيغة التي تريدها |
| التبويب | ما يفعله |
|---|
| مباشر | تدفق فوري لجميع أحداث الشبكة الملتقطة |
| الأجسام | أجسام استجابات HTTP — JSON، HTML، SVG، صور، مع معاينة |
| الاستجابات | جميع استجابات HTTP حسب النطاق، قابلة للتصفية بالعلامات |
| معلومات | ملخص لكل نطاق — رموز، كوكيز، نقاط نهاية، خريطة DOM |
| الرموز | رموز Bearer، رموز المهام، كوكيز المصادقة، مقتطفات curl |
| نقاط النهاية | جميع نقاط نهاية API المكتشفة مع "نسخ لـ LLM" |
| خريطة DOM | شجرة كاملة للعلامات/الفئات/المعرفات — انقر على أي عنصر للكشط التلقائي |
| بحث | اختبر محددات CSS مقابل HTML المقدم الفعلي |
| تنقل | تنقل + تتبع علامات التبويب، تفريغ الكوكيز، التقاط HTML |
| قائمة انتظار | معالجة دفعية لقوائم عناوين URL بتأخيرات قابلة للتكوين |
| المجال | ما هو مطلوب |
|---|
| الاختبار | جرب سكربّر على مواقع مختلفة، أبلغ عن الأخطاء |
| Firefox | ساعد في تحسين حلول CDP البديلة لإضافة Firefox |
| ويندوز | اختبر حالات الحافة لمثبّت ويندوز |
| التوثيق | اكتب دروسًا تعليمية لمواقع أو حالات استخدام محددة |
| الكود | مرحبًا بطلبات السحب — خاصة إصلاحات الأخطاء |
