 aloshdenny/claude-awm
يتجاوز العلامات المائية لنصوص LLM عن طريق حقن محددات الاختلاف في يونيكود؛ يشمل مولّد SynthID، وكاشف mean-g، ودفاعات التطبيع، وتجارب الإنتروبيا.

نعم، لكن عائلة واحدة فقط من الهجمات تنجح، وهي ليست العائلة التي يفترضها الجميع.
محدِّدات التنوّع في Unicode (الفئة Mn، من U+FE00 إلى U+FE0F ومن U+E0100 إلى U+E01EF) تدفع الكاشف إلى ما دون العتبة وتبقى هناك. كل هجوم آخر بأحرف غير مرئية جرّبته يُعاد بالكامل إلى حالته الأصلية بسطر واحد من تطبيع المدخلات. أما محدِّدات التنوّع فلا، لأنها نقاط ترميز ذات معنى (عرض الإيموجي، ومتغيّرات CJK) لا يقوم NFKC بطيّها ولا ينبغي له ذلك.
مُكرَّرة عبر نماذج ومجالات:
| النموذج | المجال | z الأساسي | بعد vs16_30 | معدل التحرير |
|---|---|---|---|---|
| gpt-oss-20b | نثر | 45.03 | 0.72 | 57% |
| gpt-oss-20b | شيفرة | 37.24 | 0.68 | 58% |
| Qwen3.8-27B | نثر | 35.50 | -0.67 | 57% |
العتبة هي z = 2.33. الثلاثة جميعًا تهبط دونها بعد الهجوم، وتبقى دونها بعد التطبيع (0.09 و0.45 و-0.78 على التوالي). يُعرض النص بشكل مطابق تمامًا للقارئ البشري.
الاكتشاف الحقيقي الثاني لا يحتاج إلى أي هجوم على الإطلاق: النص منخفض الإنتروبيا بالكاد يحمل علامة مائية من الأصل. مع تعطيل التفكير، يسجّل مخرَج الشيفرة الصرف من Qwen3.8-27B قيمة z = 4.31 دون هجوم، قريبة من عتبة 2.33 دون أي تدخّل. أعد تشغيل التفكير فيصل النموذج نفسه، في المجال نفسه وبالطول نفسه، إلى z = 25.53، لأن مقدمة الاستدلال نثر عادي ويحمل العلامة بشكل طبيعي.
كل ما في هذا المستودع قيس على هذه النماذج، ولا شيء غيرها:
| النموذج | المعاملات | المكان | ما شُغِّل |
|---|---|---|---|
| Qwen3.5-0.8B | 0.8B | Mac (MPS) | سلّم الهجوم الكامل، 1k-8k |
| Qwen3.5-4B | 4B | Mac / 4090 | سلّم الهجوم الكامل + تجربة الإنتروبيا + الإخفاء الخام/المطبَّع |
| DeepSeek-R1-Distill-Qwen-14B | 14B | Mac (MLX، 4-bit) | العلامة المائية + الكشف، آثار الاستدلال |
| gpt-oss-20b | 20B | 3090 / 4090 / RunPod | سلّم الهجوم الكامل حتى 32k، نثر + شيفرة، محدِّدات التنوّع، قانون قياس معدل الإدراج حتى 131k |
| Qwen3.8-27B | 27B | RunPod H100 / Modal H100 | نثر + شيفرة، محدِّدات التنوّع، مقارنة وضع التفكير |
| gpt-oss-120b | 120B | Modal H100 (MXFP4) / RunPod H100 | نثر + شيفرة + استدلال عند 2k / 8k / 32k، قياس جزئي لمعدل الإدراج حتى 65k |
| DeepSeek-V4-Flash | 284B MoE | RunPod 2x H200 (FP8) | نثر + شيفرة عند 2k / 8k |
لم تُجرَ كل تجربة على كل نموذج، والجداول أدناه تبيّن ما جرى وأين. أُضيفت النماذج الأكبر مع تضيُّق الأسئلة المثيرة للاهتمام، لذا فإن سلّم الهجوم واسع على النماذج الصغيرة، والعمل على الطول والمجال مركَّز على النماذج الكبيرة.
تضع Anthropic (وGoogle DeepMind قبلها، ورقة SynthID-Text) علامة مائية على النص المولَّد عبر ترجيح أخذ العينات الرمزية ببطولة مُفتاحية. الإشارة تكمن في الرموز التي وقع اختيارها، لا في أي حرف خفي. أردت أن أعرف مدى هشاشة ذلك أمام شخص متحفّز يملك أداة بحث واستبدال، فبنيت المولِّد مع كاشف g-mean غير مدرَّب وأطلقت عليه الهجمات.
عتبة الكاشف هي z = 2.33 (معدل إيجابيات كاذبة 1%). ما فوق ذلك = علامة مائية مكتشفة. ولّدت نصًا يحمل علامة مائية، وهاجمته، وأعدت ترميزه، وسجّلت النتيجة. كل جدول نتائج يحمل ضابط roundtrip (نص يحمل علامة مائية دون هجوم) لترى أن الكاشف يعمل فعلًا في ذلك الصف. مرّتين خلال هذه الدراسة جعل خطأ برمجي كل قيم z تنهار إلى الصفر، والضابط هو الشيء الوحيد الذي التقط ذلك.
سطح الهجوم ينقسم بوضوح حسب فئة Unicode، والتي تبيّن أنها القصة كاملة.
ينجح (الفئة Mn، علامات غير متباعدة):
| الهجوم | ما يفعله | معدل التحرير | ينجو من التطبيع؟ |
|---|---|---|---|
vs16_30 | محدِّد تنوّع بعد ~30% من الأحرف | 57% | نعم |
vs16 | محدِّد تنوّع بعد ~10% من الأحرف | 23% | نعم (z 3.46) |
vs_supp | محدِّدات المستوى التكميلي (U+E0100+) | 24% | نعم (z 3.40) |
homoglyph | حرف а السيريلي بدل a اللاتيني (الفئة Ll) | 9% | نعم، لكن التأثير ضعيف |
لا يعمل (الفئة Cf، محارف التنسيق):
| الهجوم | z الخام | z المُطبَّع | الحكم |
|---|---|---|---|
zwsp_30 | -0.09 | 35.68 | مُستعاد بالكامل |
combo | 0.92 | 35.68 | مُستعاد بالكامل |
bidi | 24.37 | 35.68 | مُستعاد بالكامل |
nbsp | 41.04 | 46.51 | بالكاد يحرّكه |
محارف Cf هي تنسيق خالص بلا محتوى دلالي، لذا يمكن للمُطبِّع أن يزيلها جملةً واحدة دون أن يفقد شيئًا. أما محدِّدات التغاير Mn فتحمل معنى حقيقيًا في الإيموجي والنصوص الصينية اليابانية الكورية (CJK)، لذا فإن إزالتها الشاملة ستُفسد مستندات مشروعة. هذا التفاوت هو سبب كون إحدى الفئتين قابلة للدفاع والأخرى غير قابلة لذلك.
النطاق العملي: يتطلب هذا لمس ما يقارب 20% أو أكثر من المحارف لدفع خط أساس قوي تحت العتبة، لكن المحارف المُدخلة غير مرئية، لذا يُقرأ النص بشكل طبيعي عند أي معدل تعديل. وقد تم التحقق من تطابقه البصري، انظر src/fidelity_check.py. أربع فئات تُدخل فقط محارف لا تُظهر شيئًا؛ أما المحارف المتشابهة (homoglyphs) فهي الاستثناء الصادق (تعتمد على الخط، وليست غير مرئية بشكل مضمون).
كان خوفي الأول هو الممل: أن الشرطات الطويلة (em-dashes) واستبدال "and" بـ "&" وإزالة تنسيق markdown ستنجح ببساطة، وأن العلامة المائية ستتبين أنها مسرح أمني. كثيرون على الإنترنت يفترضون ذلك بالضبط.
إنه لا يعمل. سلّم التعديلات السطحية بأكمله على gpt-oss-20b، حتى 32k رمز:
| الهجوم | معدل التعديل | z عند 1k | z عند 32k |
|---|---|---|---|
| roundtrip (تحكّم) | 0% | 25.7 | 104.3 |
| شرطة طويلة إلى شرطة قصيرة | ~0% | 26.4 | 113.7 |
| إزالة كل تنسيق markdown | 13.6% | 27.2 | 103.3 |
| AmE إلى BrE + اختصارات | 1.3% | ~28 | ~100 |
| حذف 40% من كل كلمة | 38% | 4.9 | 25.4 |
عبر النماذج الثلاثة التي جرى عليها هذا السلّم (0.8B، 4B، 20B = 294 خلية)، تجاوزت العتبة خلية واحدة بالضبط: حذف 39% من كل كلمة عند أقصر طول على النموذج 4B. هذا ليس هجومًا، بل تمزيق للمستند.
إجمالي الخلايا المقيسة عبر الدراسة بأكملها: 440 (294 من سلّم الهجوم أعلاه، بالإضافة إلى 146 من مسح قانون القياس أدناه الذي يمدّ النثر حتى 131072 رمزًا).
أمران فاجآني:
الآلية الكاملة وجداول كل هجوم في docs/FINDINGS.md.
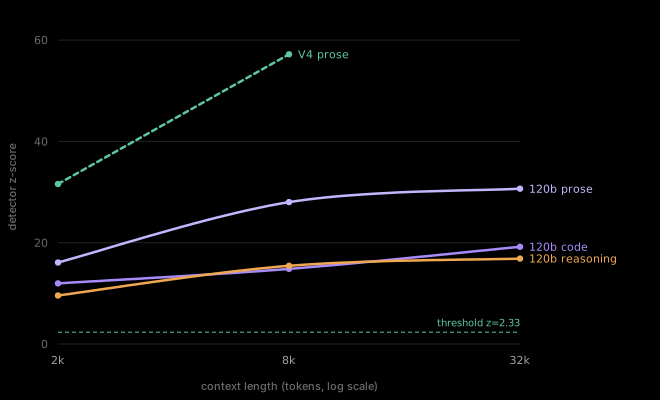
تنمو ثقة العلامة المائية مع السياق بينما تبقى الإشارة لكل رمز ثابتة، لذا فإن المستند الأطول أصعب في مهاجمته، لا أسهل. يحمل النثر أقوى علامة عند كل طول؛ ويعيد DeepSeek-V4-Flash (الخط المتقطع) إنتاج الصعود نفسه على MoE بحجم 284B.
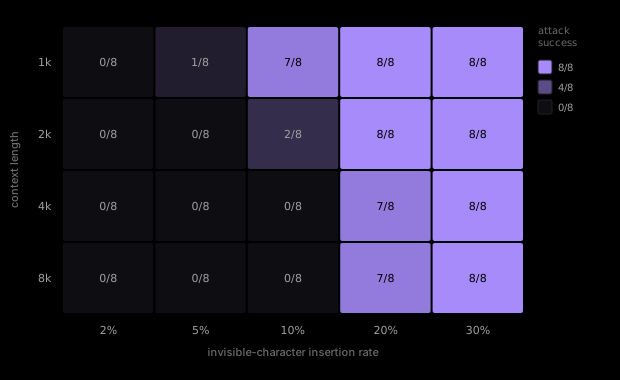
وعلى الهجوم أن يواكب ذلك. كل خلية تمثل عدد البذور العشوائية من أصل 8 التي تغلبت على الكاشف. إدخال 10% يتجاوز 1k رمز لكنه يفشل تمامًا عند 4k. معدل الإدخال المطلوب يرتفع مع طول السياق، ولهذا فإن الهجوم ليس مستقلًا عن السياق.
يثبّت مسح متابعة مخصص هذه النقطة: على gpt-oss-20b، من 1024 رمزًا إلى 131072 (أقصى سياق للنموذج)، يتبع المعدل المطلوب p*(L) ≈ 2.37·log2(L) − 14.6 -- صاعدًا من 9.3% عند 1k رمز إلى 25.0% عند 131k.
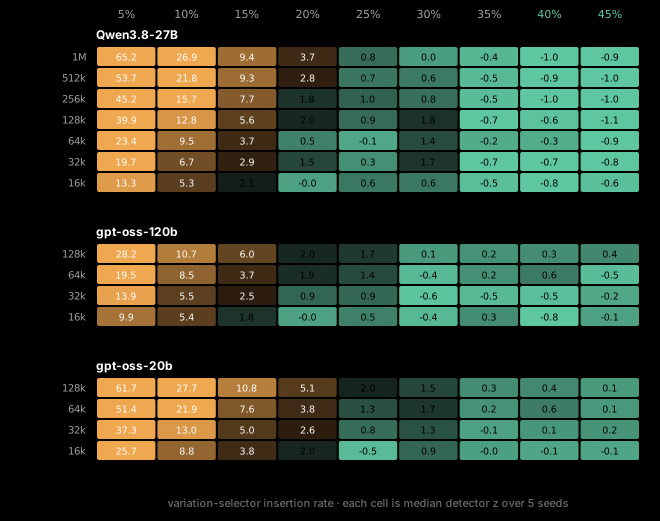
إذن السؤال التالي البديهي: هل ينتصر الكاشف في النهاية انتصارًا كاملًا إذا جعلت المستند طويلًا بما يكفي فحسب؟ أخذنا المسح إلى 1,048,576 رمزًا لنكتشف ذلك. ثلاثة نماذج × كل طول سياق × معدل إدراج؛ كل خلية أعلاه هي وسيط z للكاشف عبر 5 بذور، باللون الفيروزي حيث انتصر الهجوم (z < 2.33)، وبالبرتقالي حيث نجا العلامة المائية.
