
Skip to content
KitploitKITPLOIT
أدواتعمليات الاستغلالالمدونة
Log in
إرسال
أدواتعمليات الاستغلالالمدونة
إرسال

أدوات الاختراق واختبار الاختراق والأمن السيبراني لترسانتك الأمنية!

Kitploit هو دليل لأدوات الاختراق والأمن السيبراني واختبار الاختراق. اكتشف آخر تحديثات المشاريع للعثور على الثغرات وتحليل الأنظمة وأتمتة الاختبارات وتعزيز أمنك.

··الخلاصات·اتصال·الخصوصية·© 2026 Kitploit

دليل الأدوات

الفئات

عرض جميع الفئات
Loading categories
Iran-War-Media — مراقب وسائل الإعلام لحرب إيران يجمع المقالات الإخبارية التي تغطي الحرب الأمريكية الإسرائيلية على إيران ويطبق تحليل المشاعر لكشف من يدعم ويعارض الحرب. | Kitploit
أدوات/GitHubGitHub/albintouma/iran-war-media
الاستخبارات مفتوحة المصدر (OSINT)جمع المعلوماتاستخبارات التهديداتالأوراق والأبحاثالتعلم والتعليمزاحف الويب
GitHubalbintouma/iran-war-media

Iran-War-Media

مراقب وسائل الإعلام لحرب إيران يجمع المقالات الإخبارية التي تغطي الحرب الأمريكية الإسرائيلية على إيران ويطبق تحليل المشاعر لكشف من يدعم ويعارض الحرب.

عرض المستودع
1914منذ 2 أشهرلم تتم المراجعة بعد

الأكثر شعبية

عرض الكل →

اكتشف الأدوات الأكثر استخدامًا من قبل مجتمعنا.

استكشف جميع الأدوات

تصفح مجموعتنا من الأدوات

عرض جميع الأدوات →
مشاركة

مراقب وسائل الإعلام لحرب إيران

Subscribe to newsletter

اقرأ الغوص العميق الكامل

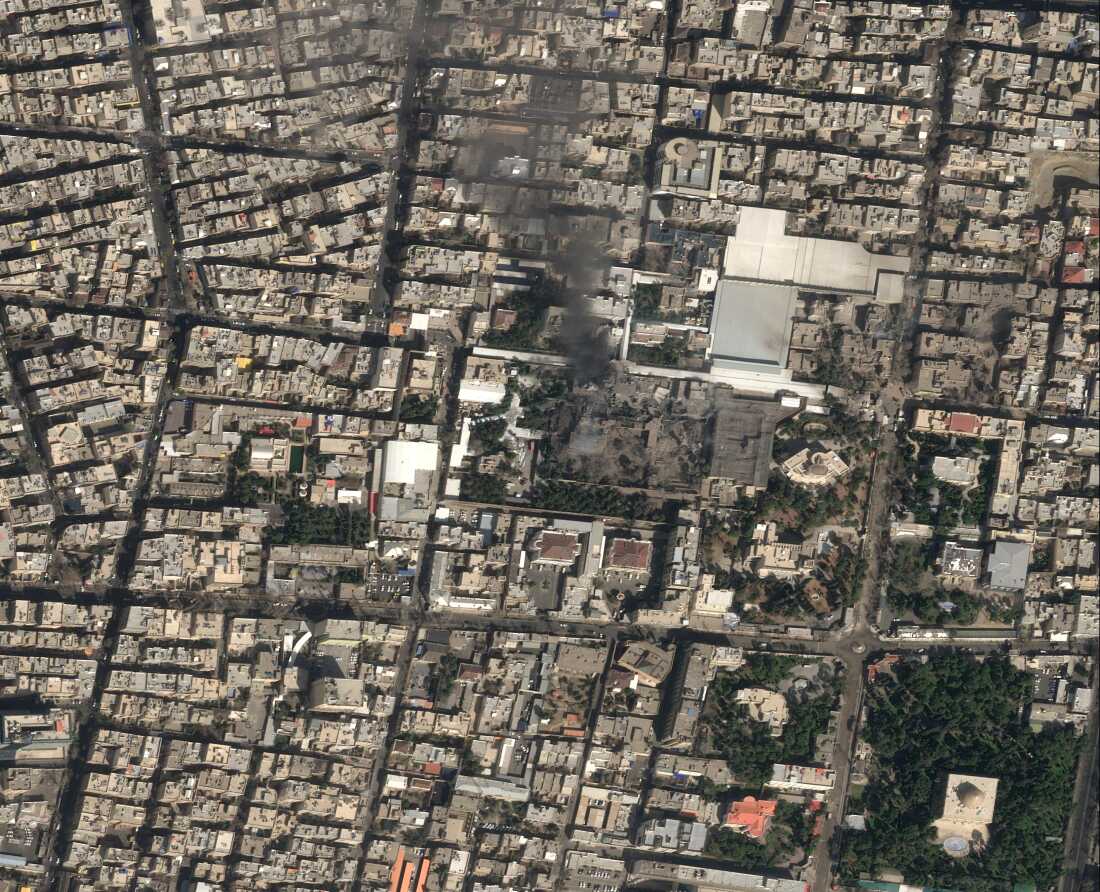
قصر خامنئي المدمر مصدر من NPR

مقدمة

يراقب هذا المشروع التغطية الإخبارية للحرب بين إيران وإسرائيل والولايات المتحدة.

يمكنك استخدام هذا المستودع من أجل:

  1. إنشاء مجموعة من المقالات الإعلامية باللغة الإنجليزية
  2. تحديد المؤلفين ووسائل الإعلام لتتبع من يقول ماذا ومتى
  3. تحليل المشاعر للمقالات لتحديد ما إذا كانت المقالة تدعم الحرب، أم واقعية ومحايدة، أم تعارض الحرب.

المنهجية

يمكنك قراءة الغوص التقني الكامل هنا. باختصار، ينفذ مراقب وسائل الإعلام الإيرانية سيرتي عمل.

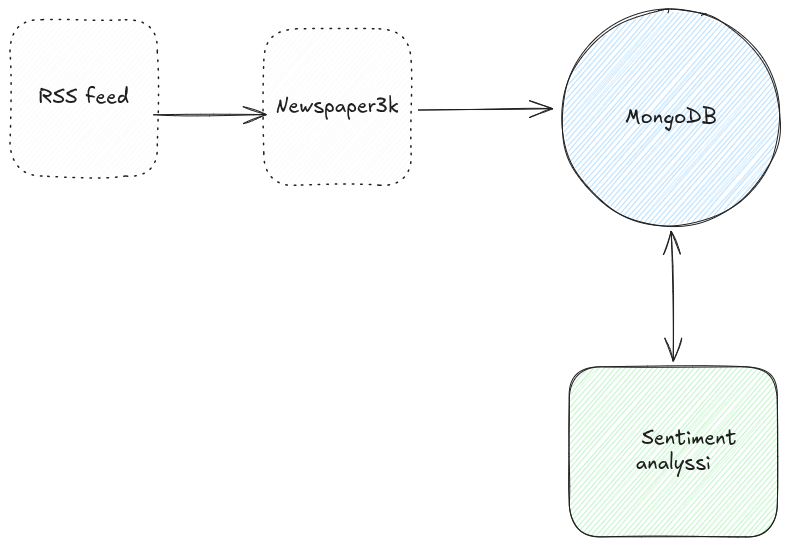
سير العمل الأولى تشغّل الماسح الذي يجمع البيانات الوصفية والمقالات الإخبارية من خلاصات RSS. الخلاصة مضبوطة على Google RSS لكن يمكنك تغيير الخلاصة في rss.py.

سير العمل الثانية تجري تحليل المشاعر على المقالات المجمعة وتقوم بتحديث أو إدراج المقالات.
نص بديل

يستخدم المشروع MongoDB لتخزين المقالات. استخدم Docker لإنشاء نسخة من MongoDB.

البيانات

يتم جمع نقاط البيانات التالية:

        {
                "collectionDate": str(datetime.now(timezone.utc).strftime("%Y-%m-%d %H:%M:%S")),
                "processed": False,
                "title": article.title,
                "author": article.authors,
                "publishedAt": str(article.publish_date),
                "publisher": publisher, 
                "language": article.meta_lang,
                "sourceUrl":article.source_url,
                "summary":article.summary,
                "keywords": article.keywords,
                "description": article.meta_description,
                "bodyText":article.text,
                }


النصوص البرمجية:

شغّل rss.py للحصول على قائمة بأحدث المقالات من خلاصة RSS.

شغّل scraper.py للحصول على عناوين URL من Google RSS وجمع المقالات.

استخدم sentiment.py لإجراء تحليل المشاعر على المقالات غير المعالجة. يتم تعيين حقل process على True عندما يتلقى المستند درجة مشاعر.

التحسينات المستقبلية

  1. إضافة القدرة على جمع المزيد من خلاصات RSS
  2. نموذج مخصص لتحديد مدى صلة المقالات الإخبارية لأغراض التصفية
  3. نموذج مخصص للتنبؤ بشكل أفضل بنبرة المقالات (مؤيد، معارض، واقعي)
  4. استخراج الكيانات والعلاقات ومن فعل ماذا ومتى وأين ولمن.
  5. تحليلات الذكاء الاصطناعي التوليدي للمقالات (سواء بشكل منفصل أو لكامل المجموعة).
تنزيل الأداة