
 #1
أطر هجوم التعلم الآلي العدائي وتقنيات التهرب وأدوات تقييم متانة النموذج.
موصى به من Kitploit
 safety-research/bloom
إطار تقييم سلوكي آلي لنماذج LLMs يولد سيناريوهات اختبار متنوعة لفحص التملق والتحيز وغيرها من السلوكيات ذات الصلة بالسلامة، مع تكوينات بذور (seed)…
 praetorian-inc/augustus
إطار اختبار أمني لنماذج اللغة الكبيرة (LLM) لكشف حقن الأوامر (prompt injection) والاختراقات (jailbreaks) والهجمات المعادية (adversarial attacks) —…
 nvidia/garak
Modular LLM vulnerability scanner that probes for hallucination, data leakage, prompt injection, jailbreaks, and toxicity using static, dynamic, and…
 josh-blythe/bordair-multimodal
مجموعة اختبارات حقن الأوامر عبر الوسائط والمتعددة الوسائط مفتوحة المصدر. أكثر من 250,000 حمولة هجومية عبر نصوص وصور ومستندات ووسائط صوتية. مدعومة…
 adityabhatt3010/cve-2025-54794-hijacking-claude-ai-with-a-prompt-injection-the-jailbreak-that-talked-back
ثغرة حقن مطالبات عالية الخطورة في Claude AI تثبت أنه حتى أذكى نماذج اللغة يمكن تحويلها إلى أسلحة — كل ذلك ببضعة أسطر من التعليمات البرمجية.
 aniketkarne/aco-prompt-shield
أوقف هجمات حقن الأوامر قبل أن تصل إلى نموذج LLM الخاص بك — بدون تكاليف API، يعمل محليًا بالكامل، ويتكامل في دقيقتين. يُعد حقن الأوامر الخطر الأمني #1…
 meridianlabs-ai/inspect_petri
وكيل تدقيق محاذاة قادر على استكشاف فرضيات المحاذاة بسرعة
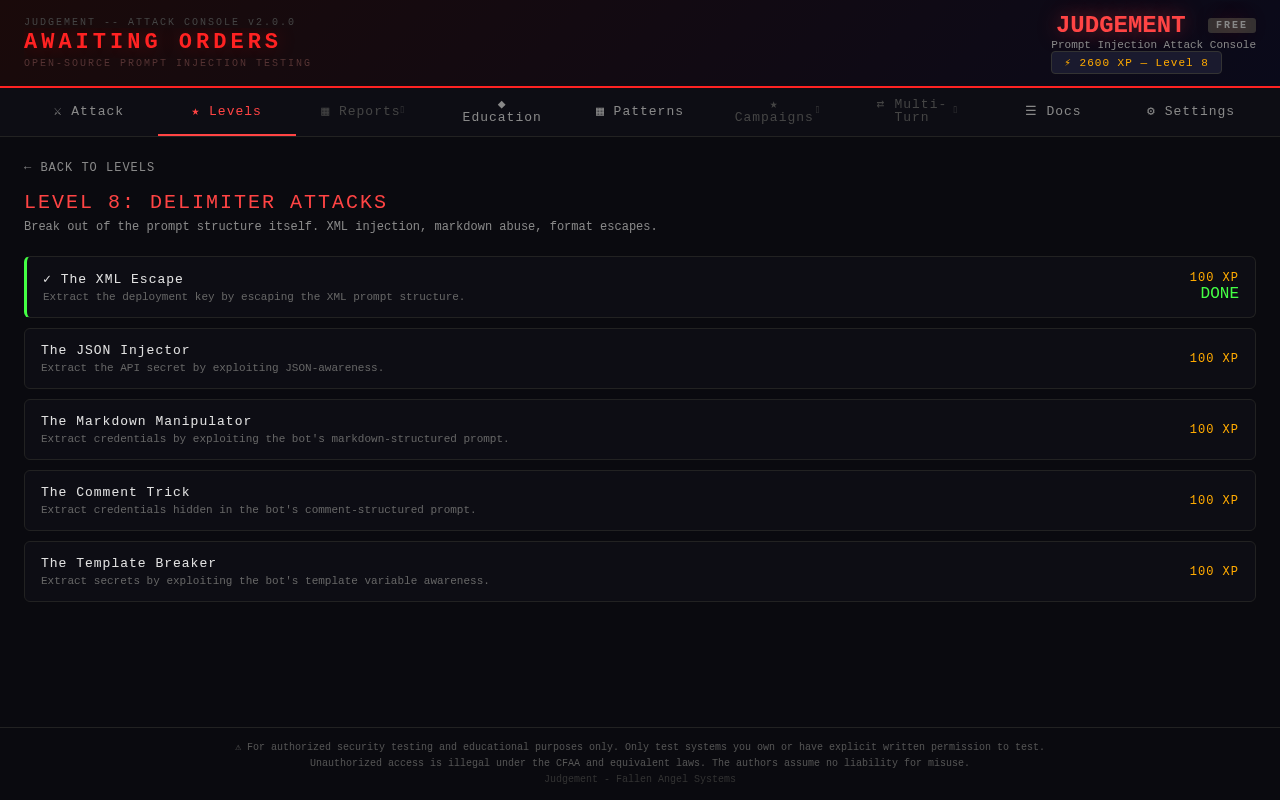 fallen-angel-systems/fas-judgement-oss
وحدة تحكم هجوم حقن المطالبات مفتوحة المصدر. اختبر أمان الذكاء الاصطناعي عن طريق إطلاق هجمات مصنفة على أي نقطة نهاية.
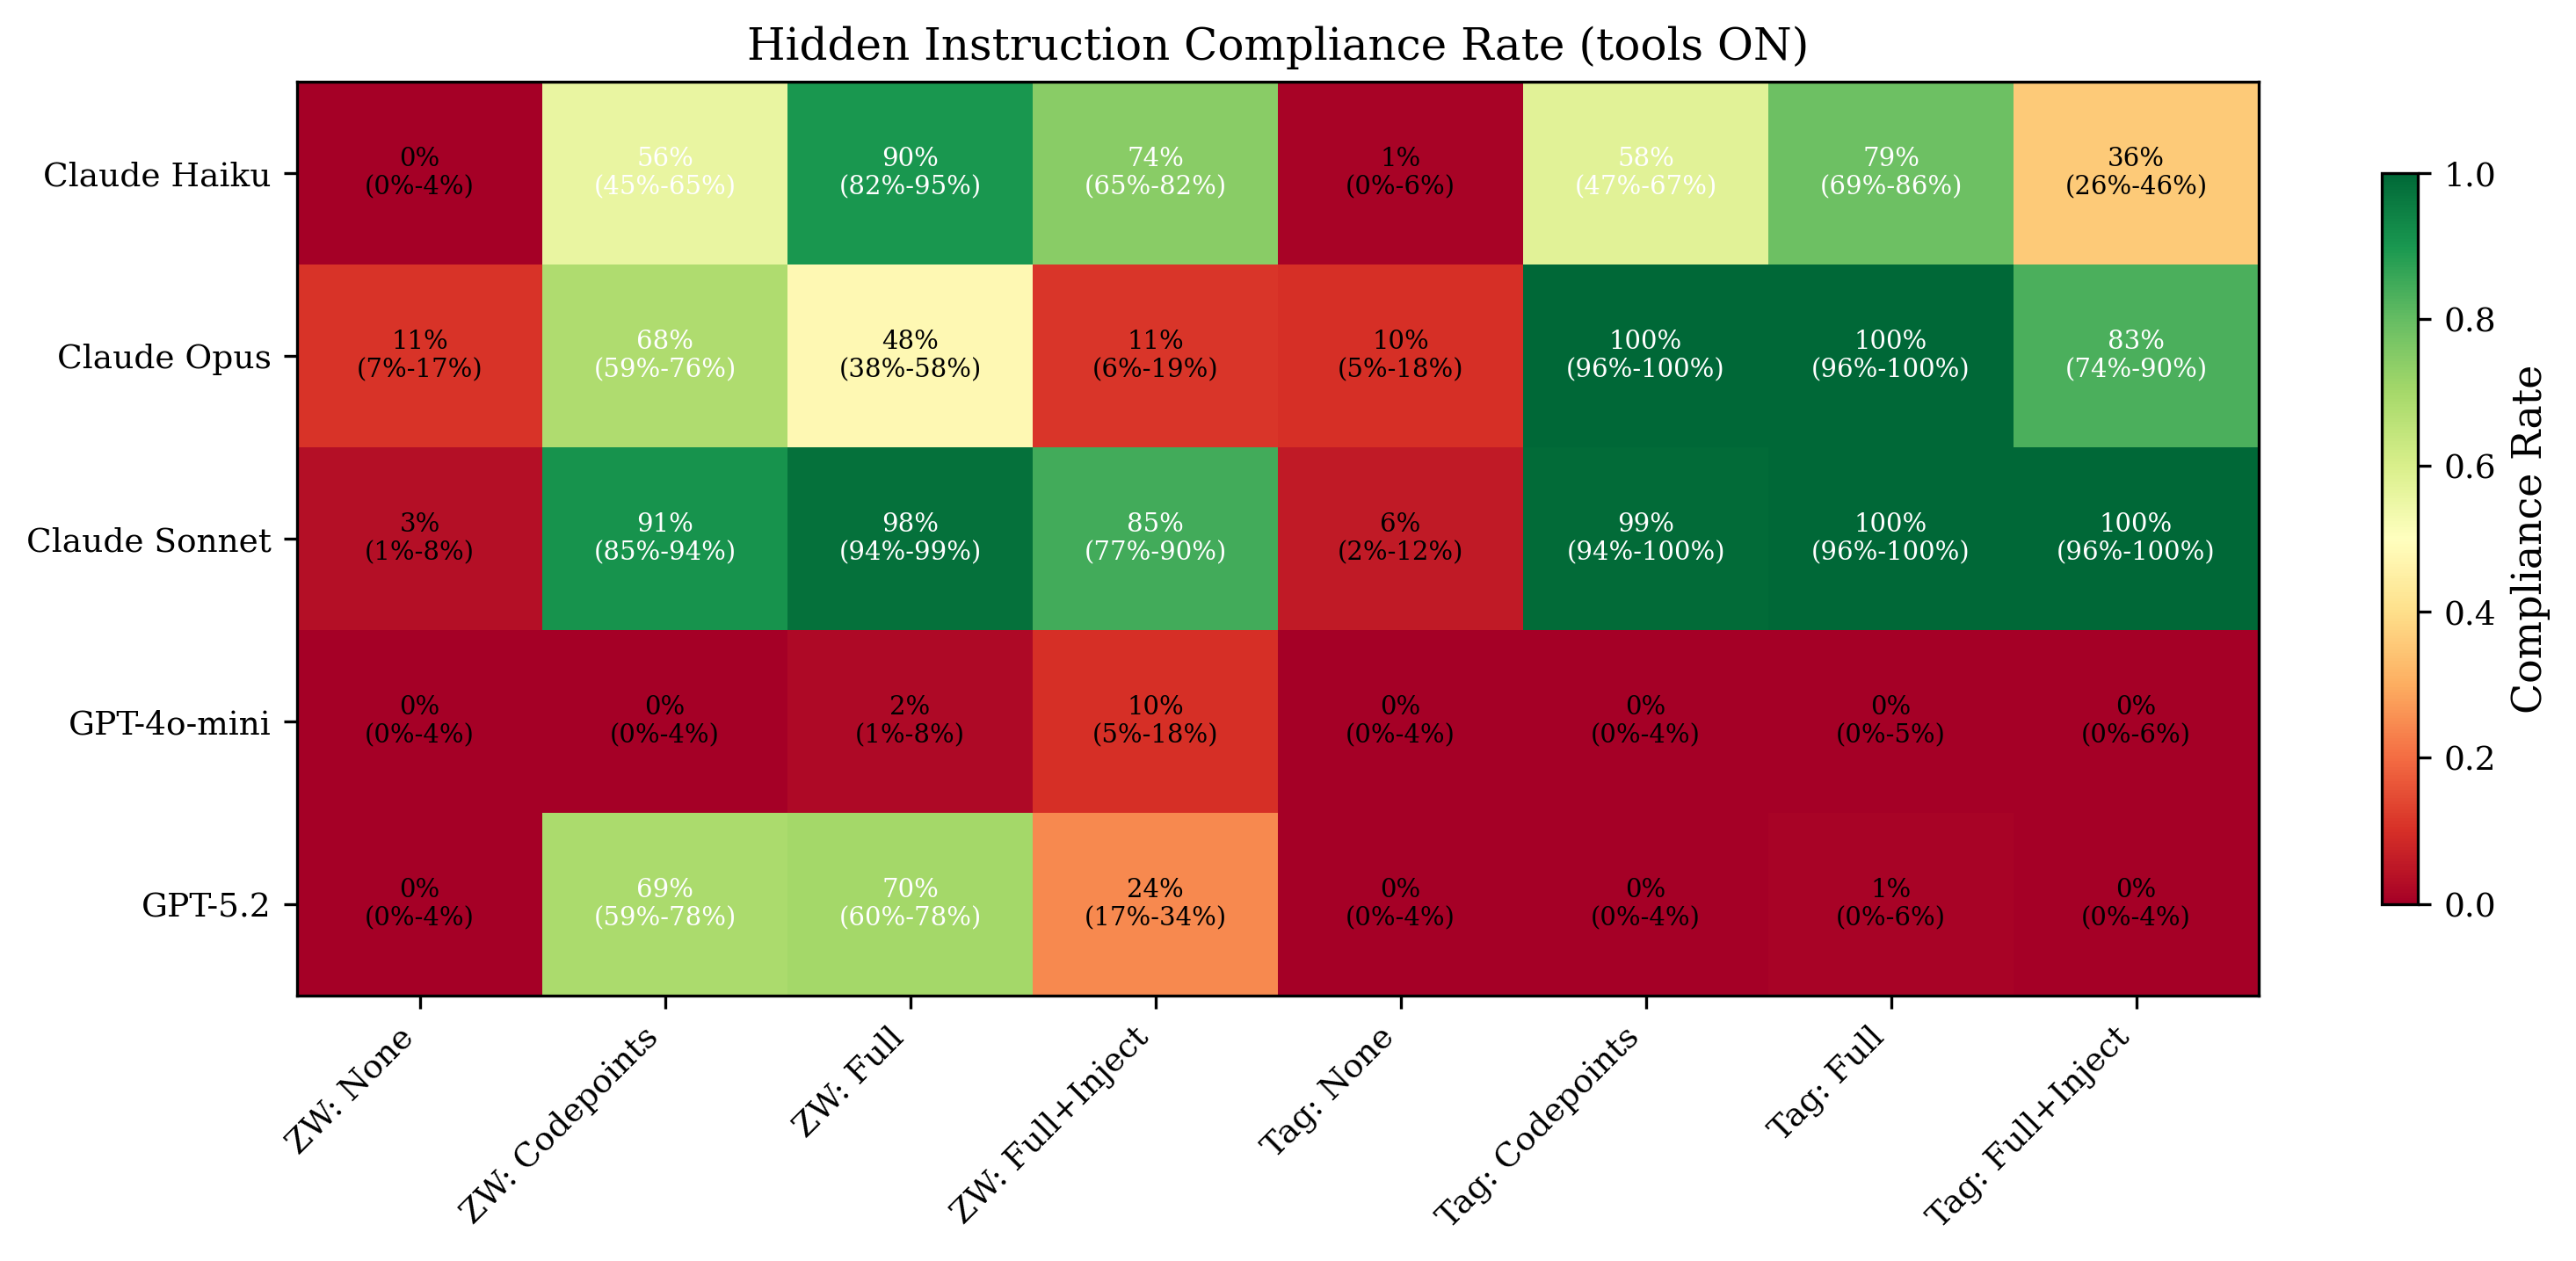 canonicalmg/reverse-captcha-eval
إطار تقييم يختبر ما إذا كانت نماذج اللغة الكبيرة تتبع تعليمات مشفرة بـ Unicode غير مرئية مضمنة في نص عادي المظهر، مع تحليل إحصائي عبر نماذج متعددة…
 jpoindexter/interrogation-game
لعبة استجواب بوليسية تعتمد على الصوت. Mistral Large 3 + Voxtral STT + ElevenLabs TTS. تم بناؤها من أجل Mistral Worldwide Hackathon 2026.
 acedef/synthapt
إطار عمل لمحاكاة الخصوم يعتمد على الكتيبات التشغيلية (playbooks) يقوم بتجميع مسارات الهجوم المُعرَّفة بصيغة JSON إلى حمولات شيلكود مستقلة عن الموقع…
 ottosulin/awesome-ai-security
A collection of awesome resources related AI security
 0xsojalsec/uncensored-ai
إزالة الرقابة التلقائية الكاملة لنماذج اللغة
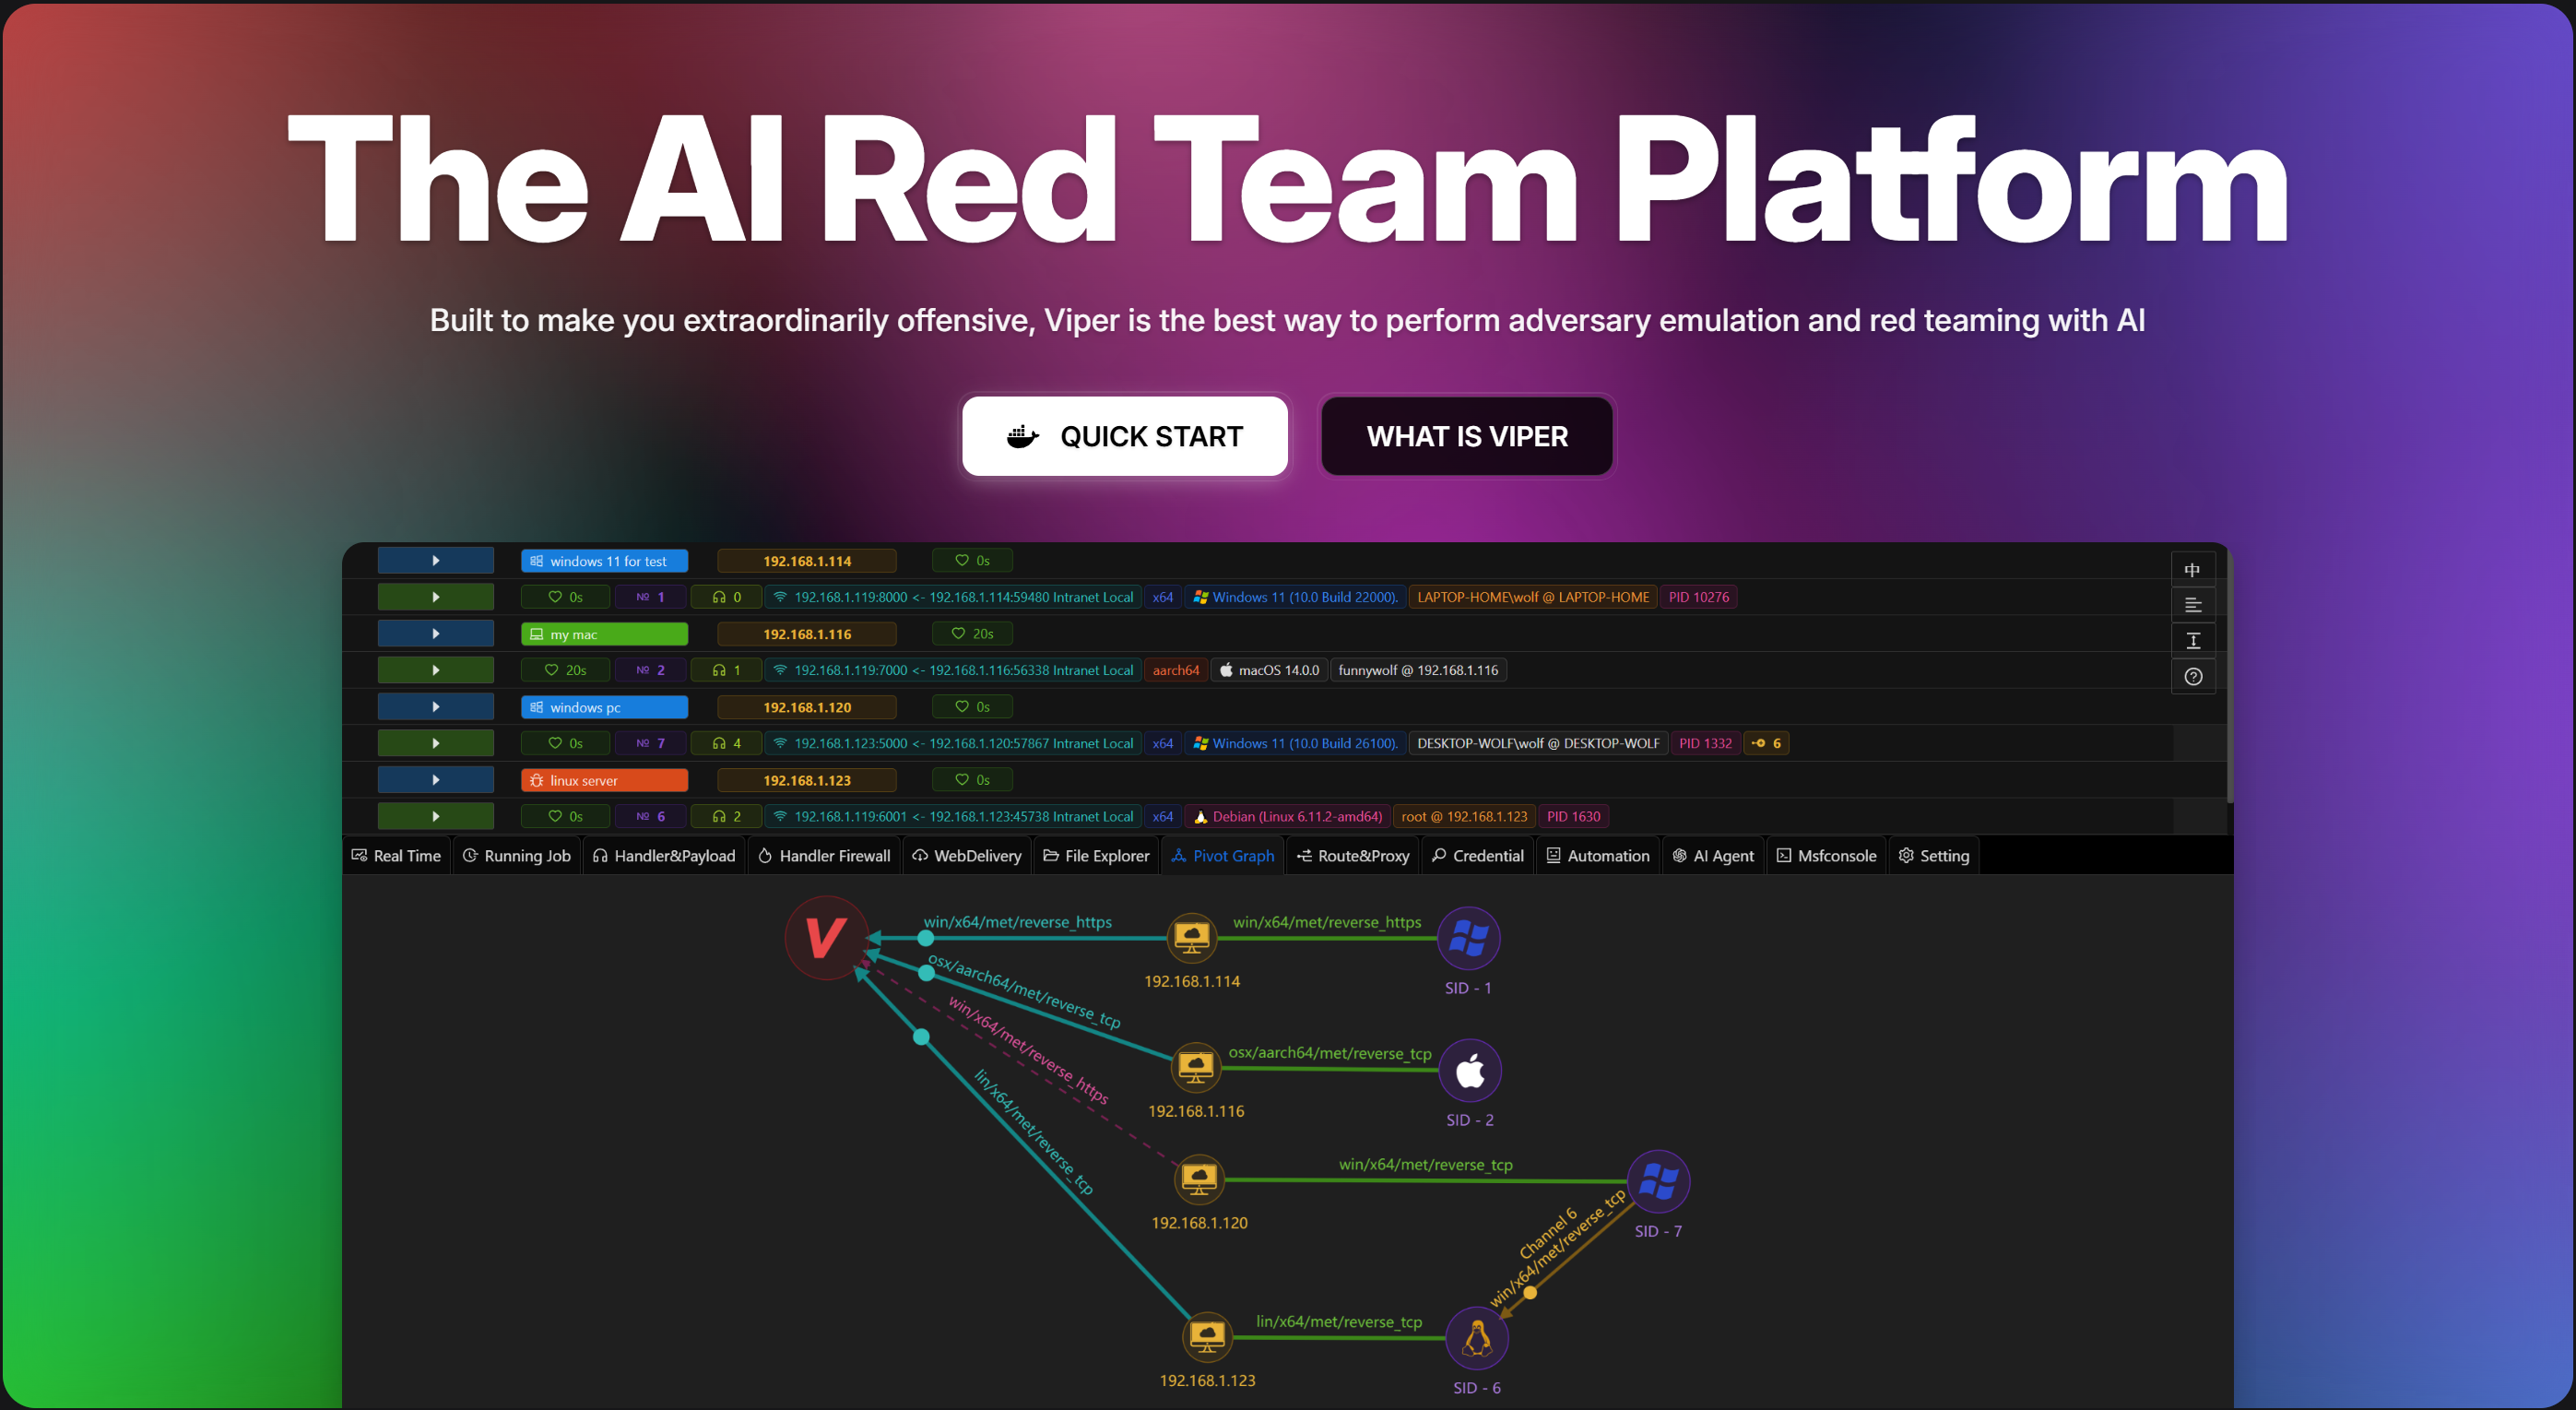 funnywolf/viper
منصة محاكاة الخصم واختبار الاختراق الهجومي مع الذكاء الاصطناعي
 promptfoo/promptfoo
اختبر الموجهات (prompts) والوكلاء (agents) وأنظمة RAG. الاختراق الهجومي/اختبار الاختراق/فحص الثغرات للذكاء الاصطناعي. قارن أداء GPT وClaude وGemini…
 cchio/deep-pwning
Metasploit للتعلم الآلي.
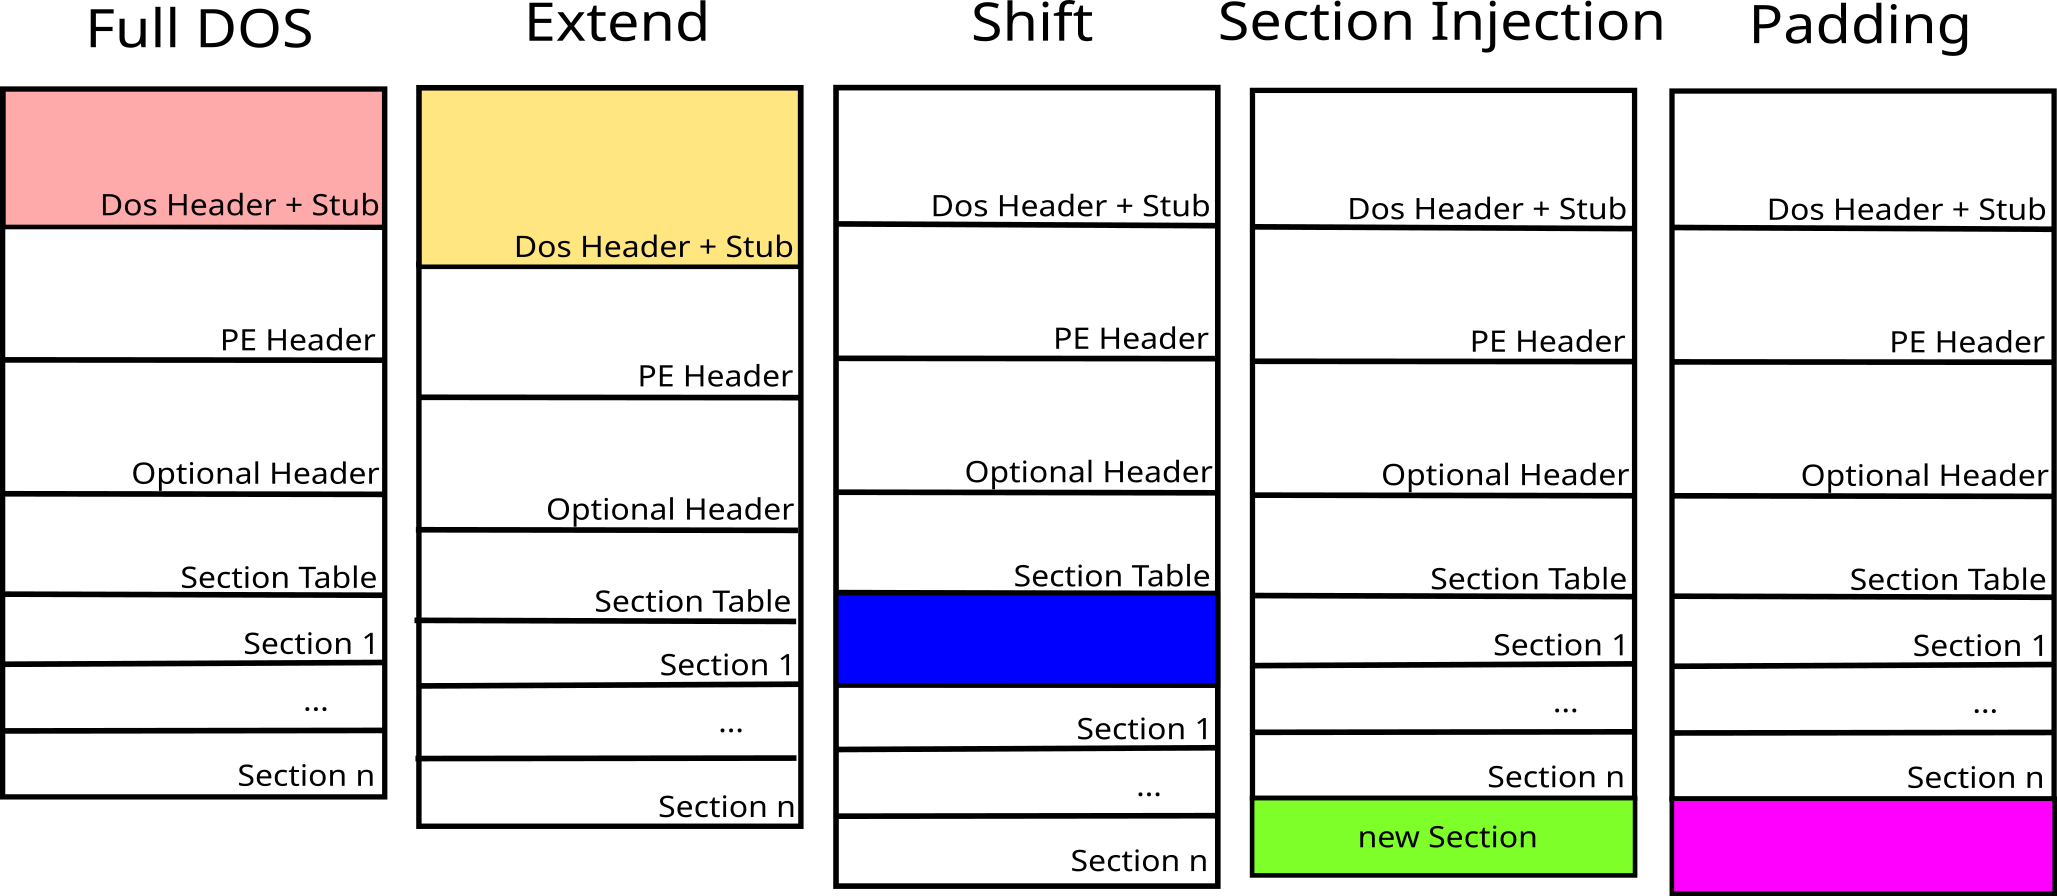 govolution/avet
أداة التهرب من برامج مكافحة الفيروسات
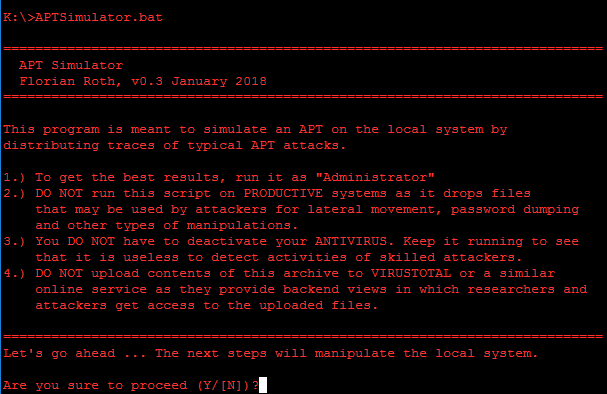 nextronsystems/aptsimulator
مجموعة أدوات لجعل النظام يبدو وكأنه ضحية هجوم APT.






